
TL;DR
Claude Fable 5.1 қиын автономды код жазу мен ұзақ көкжиекті жұмыстар үшін бенчмарк дәлелі жағынан күшті. GPT-5.6 Sol қалыпты токен құны төмен, кең табиғи құралдар жинағы бар және тәуелсіз максималды-әрекет салыстыруында алғашқы токенге дейінгі уақыт қысқа. Дұрыс әдепкі таңдау тек ең жоғары бенчмарк ұпайына емес, сәтсіз тапсырманың құнына да тәуелді.
2026 жылғы 8 қыркүйектегі Intelligence Index snapshot бойынша, Fable 5.1 — 53, GPT-5.6 Sol — 47 ұпай жинады. Шығыс өткізгіштігі іс жүзінде тең: 69.9 және 69.8 токен/с. Бұл нәтижелер сапа мен құн арасындағы шешімді қолдайды; олар әмбебап жылдамдық жеңімпазын анықтамайды.
Негізгі тұжырымдар
- Ең күрделі автономды тапсырмалар үшін, жоғары бағаңызды ақтайтын болса, Fable 5.1 таңдаңыз.
- Құнға сезімтал алдыңғы қатарлы инференс және біріктірілген құралдардан пайда алатын қолданбалар үшін GPT-5.6 Sol-дан бастаңыз.
- Іске қосу кідірісін шығыс жылдамдығынан бөлек салыстырыңыз: GPT-5.6 Sol-де алғашқы токенге дейінгі уақыт төмен, ал өткізгіштік дерлік тең.
- Модель кэшіне жазу, оқу, сақтау және ұзын контекст тарифтерін бөлек есептеңіз. Тақырыптық енгізу/шығыс бағалары агенттің барлық жұмыстарына тән емес.
Деректер 2026 жылғы 8 қыркүйекте тексерілді. Тәуелсіз нәтижелерде GPT-5.6 Sol max effort режимінде және Fable 5.1 Adaptive Reasoning, Max Effort, Default Fallback конфигурациясымен пайдаланылды. Вендор және тәуелсіз бенчмарктер түрлі бағалау орнатылымдарын қолданады. Бағалар АҚШ доллары/миллион токен (MTok), егер басқаша көрсетілмесе.
GPT-5.6 Sol vs Fable 5.1: жылдам қорытынды
| Өлшем | GPT-5.6 Sol | Claude Fable 5.1 | Үздік таңдау |
|---|---|---|---|
| Тәуелсіз Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable 5.1 |
| Тәуелсіз Terminal-Bench 4.0 (Sep 7) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic жүргізген Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Контекст терезесі | 1.05M | 1M | Практикалық тең |
| Максималды шығыс | 128K | 128K | Тең |
| Мәтін/сурет енгізу | Yes | Yes | Тең |
| Ресми енгізу бағасы / MTok | $4 | $10 | Sol |
| Ресми шығыс бағасы / MTok | $20 | $50 | Sol |
| Ресми кэш оқу / MTok | $0.40 | $0.25 | Fable 5.1 |
| Тәуелсіз шығыс жылдамдығы (Sep 8) | 69.8 tok/s | 69.9 tok/s | Практикалық тең |
| API құралдарының қамтылуы | Өте кең | Күшті | Sol |
| Ұзақ уақыт автономды жұмыс | Өте жақсы | Негізгі күш | Fable 5.1 |
| Құнға сезімтал өндіріс | Жақсы әдепкі | Премиум эскалация | Sol |
Пайдалы бастапқы саясат — кәдімгі алдыңғы қатарлы жұмыс үшін Sol-ды пайдаланып, сіздің сапа немесе автономия шегіңізден өтпеген кезде Fable 5.1-ға эскалациялау. Бұл саясатты сәтті тапсырмаға шаққандағы құнмен тексеріңіз.
GPT-5.6 Sol алты reasoning effort деңгейін ұсынады: none-нан max-қа дейін, әдепкі — medium. Fable 5.1 әрқашан қосулы adaptive thinking қолданады; effort ойлау тереңдігін басқарады, әдепкі — high.
GPT-5.6 Sol контекстіндегі қосымша 50 000 токен көпшілігіне әсер етпейді. Сұрау бір миллион токенге жақындаған сайын биллинг және кэшті қайта пайдалану маңыздырақ болады; төмендегі ұзын контекст бөлімі неге екенін көрсетеді.
GPT-5.6 Sol деген не?
GPT-5.6 Sol — OpenAI-дың GPT-5.6 отбасындағы жоғары қабілетті деңгей, күрделі код жазу, зерттеу, жоспарлау және агенттік жұмыс процестері үшін. Бұл салыстырудағы басты артықшылығы — reasoning басқарулары мен айналадағы орындалу ортасының үйлесімі.
Responses API арқылы GPT-5.6 Sol кең табиғи құралдар портфелін қолдайды: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills және tool search. Бұл қолданбаңыз біріктіруі тиіс бөлек рантайм компоненттерінің санын азайтуы мүмкін.
OpenAI сондай-ақ бағдарламалық құрал шақыруды және көп агентті орындалуды сипаттайды. Бұл платформа мүмкіндіктері модель бір ғана жауап қайтарудан гөрі, құралдар арасында жұмысты үйлестіруі қажет болғанда маңызды.
Claude Fable 5.1 деген не?
Claude Fable 5.1 күрделі код жазу, кәсіби білім еңбегі, зерттеу және ұзақ уақыт жұмыс істейтін агенттерге бағытталған. Тікелей бенчмарк нәтижелері қысқа жауаптан гөрі қалпына келтіру, табандылық және сәтті аяқтау маңызды болатын тапсырмаларға оны күшті кандидат етеді.
Anthropic ұзақ мерзімді автономды орындалуды қолданбалар арасында, соның ішінде жоспарлау, қателескен қадамдардан қалпына келу және прогресті хабарлау ретінде атап өтеді. Бұл позицияны әрбір жұмыс ағынының дұрыс аяқталуына кепілдік ретінде емес, ұзақ тапсырмаларды сынау себебі ретінде қарастырыңыз.
Fable 5.1 API мінез-құлқымен GPT-5.6 Sol-дан өзгеше: оның міндетті құрал таңдау шектеулері нақты құралды шақыруды қажет ететін жұмыс ағындары үшін маңызды. Детерминирленген агент циклін көшіру кезінде қолдау көрсетілетін tool_choice режимдерін тексеріңіз.
Интеграция мәселесі практикалық: сіздің қолданбаңыз автономды reasoning циклін көтере ала ма, әлде әр қадамды нәзік басқару қажет пе? Бағытты таңдаудан бұрын нақты құрал мінез-құлқын тексеріңіз.
Бенчмарк салыстыруы: Fable 5.1 тікелей дәлелдерде күшті
Бәсекелес вендорлар арасындағы бенчмарк салыстыруларын оңай қате түсіндіруге болады. OpenAI-дың бастапқы GPT-5.6 іске қосу бағалаулары Fable 5.1-ден бұрын, ал Anthropic-тің Fable 5.1 релизі жаңа тікелей GPT-5.6 Sol салыстыруларын қамтиды.
Дәлелдерді оқудың ең таза жолы — үш қабат: Anthropic-тің тікелей салыстыруы, ағымдағы тәуелсіз тестілеу және OpenAI-дың GPT-5.6 Sol мүмкіндіктер профилі.
Anthropic-тің тікелей Fable 5.1 vs GPT-5.6 Sol нәтижелері
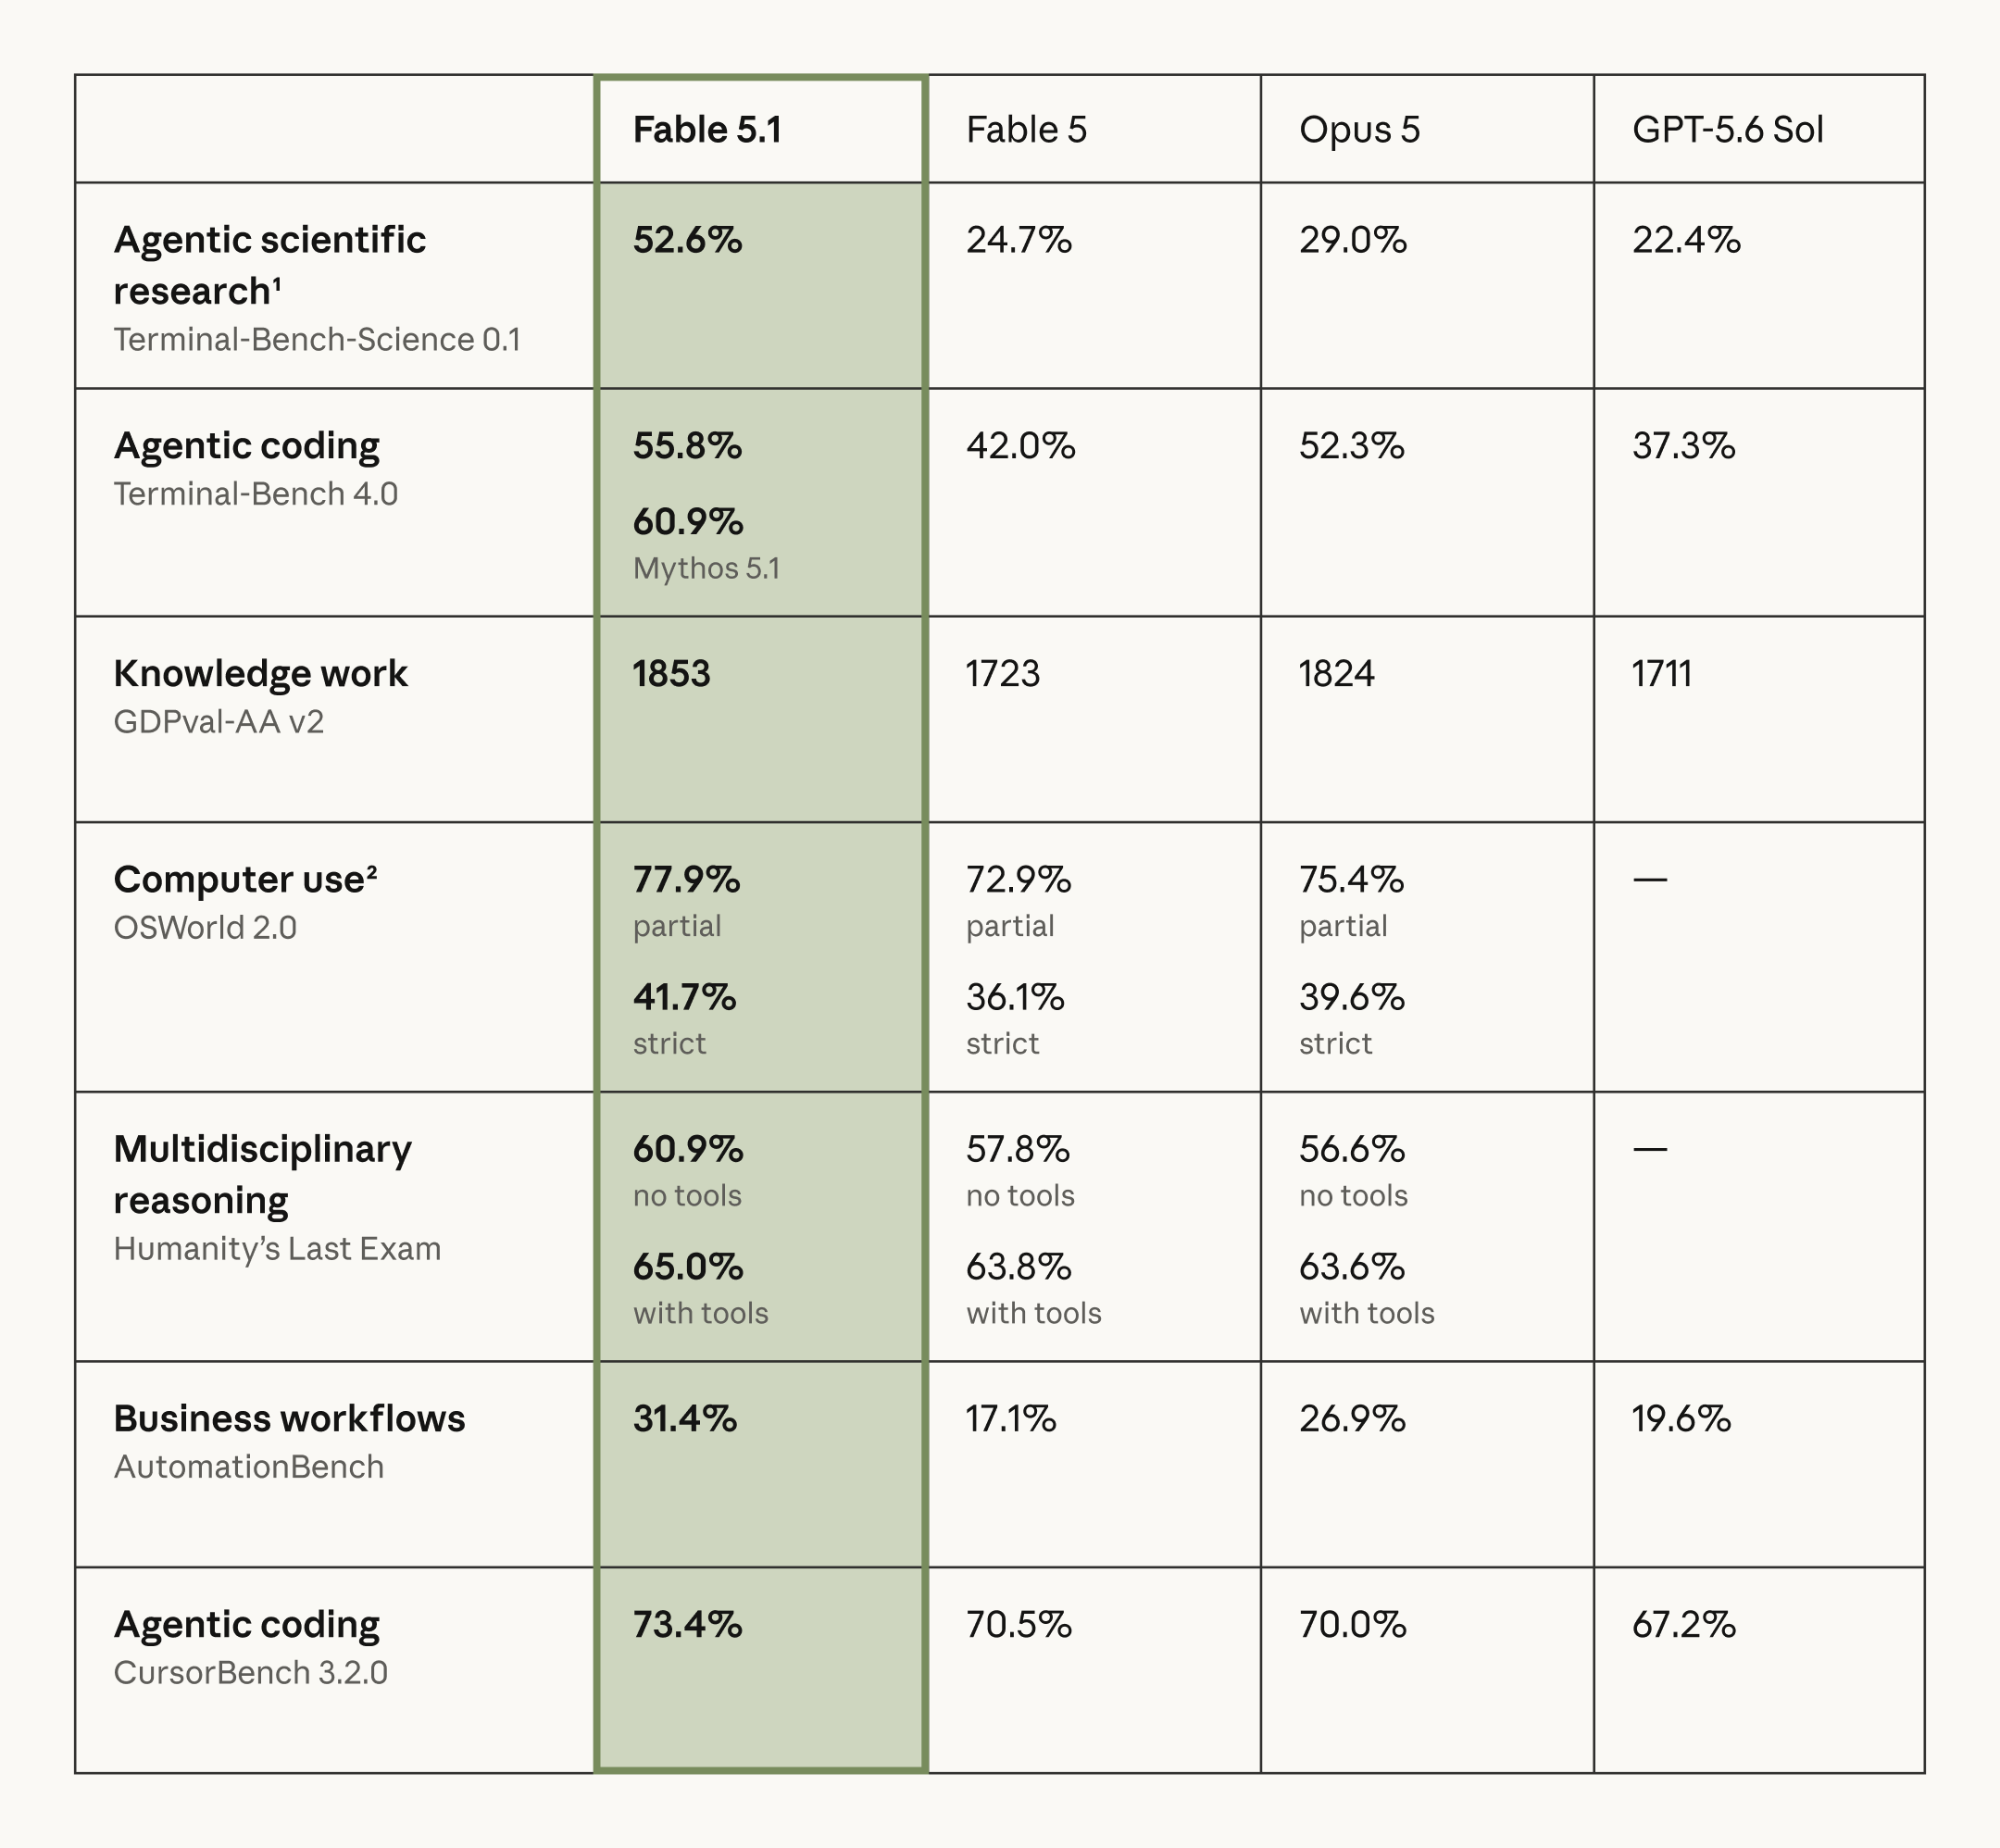
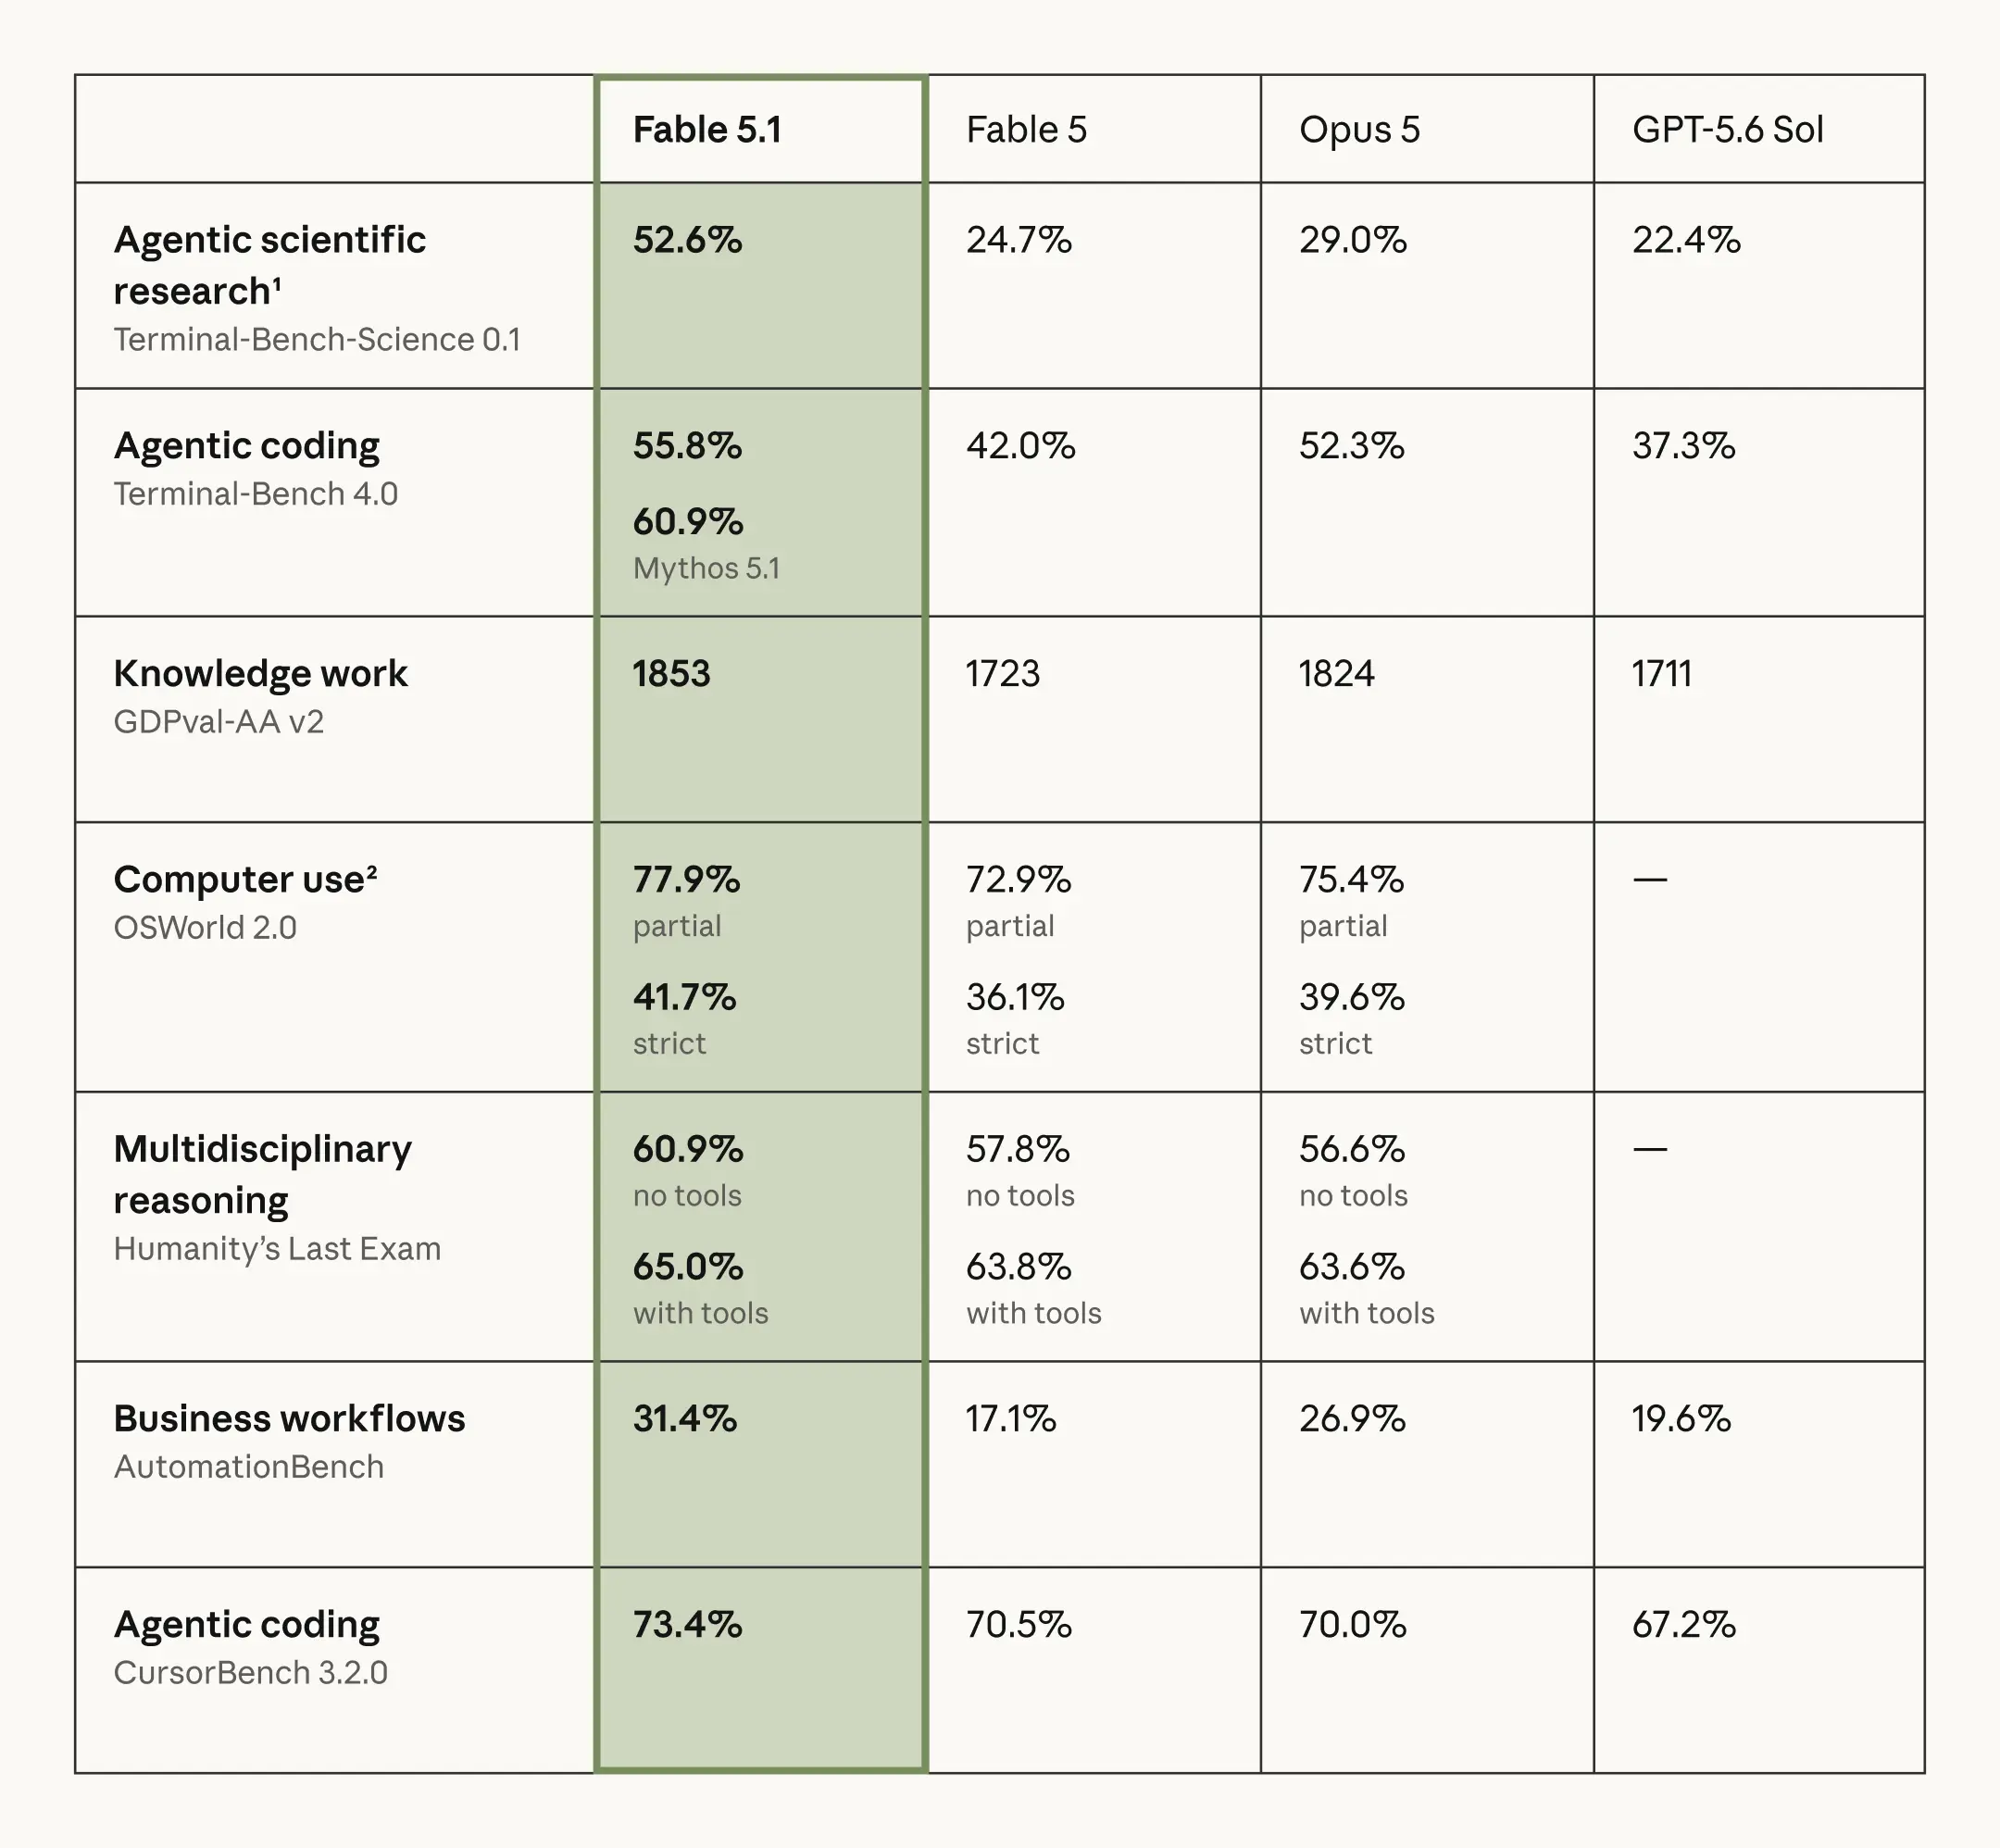
Ресми бенчмарк нәтижелерінде екі модель үшін де бес тапсырмада есепті балдар бар. Төмендегі пайыздық нүкте және Elo айырмашылықтары сол жарияланған мәндерден есептелген.
| Бенчмарк | GPT-5.6 Sol | Claude Fable 5.1 | Fable 5.1 артық |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 пункт |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 пункт |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 пункт |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 пункт |
Нәтиже әдеттегіден тұрақты: Anthropic жариялаған әрбір жолда Fable 5.1 GPT-5.6 Sol-дан озады. Ең үлкен айырмашылықтар агенттік ғылыми зерттеулерде және терминалға негізделген код жазуда байқалады, ал қарапайым қысқа reasoning-де емес.
Дереккөз: Anthropic — түпнұсқа бенчмарк графикасы.
Бұлар вендор жүргізген бағалаулар: Anthropic өз моделін де, бәсекелес модельді де тестілеген. Олар тікелей салыстырмалы дәлел береді, бірақ тәуелсіз тест емес. Anthropic Terminal-Bench-Science үшін модель басына ±3.5–4.5 пайыздық пункт стандарттық қателік туралы хабарлайды; жоғарыдағы кесте нүктелік бағаларды көрсетеді, сенім аралықтарын емес.
Вендор нәтижелері Fable 5.1 пайдасына, алайда тәуелсіз дәлелдер өз күндері мен конфигурацияларына мұқтаж.
Тәуелсіз бенчмарктер: күндерді бөлектеңіз және тікелей өлшемдерден ажыратыңыз
Artificial Analysis 7 қыркүйекте Intelligence Index v4.3 ұсынды, Terminal-Bench 2.1-ді Terminal-Bench 4.0-мен ауыстырып және AutomationBench-AA қосты. Релиз Fable 5.1 үшін 53 және GPT-5.6 Sol үшін 47 ұпай хабарлады, бұл 8 қыркүйектегі салыстырудағы дөңгелектелген ұпайлармен сәйкес келеді. Кесте релиздің терминал нәтижелерін кейінгі өнімділік snapshot-ынан ажыратады.
| Тәуелсіз AA метрикасы / v4.3 релизі | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Нәтиже |
|---|---|---|---|
| Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (Sep 7 release) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Шығыс жылдамдығы (Sep 8) | 69.8 tok/s | 69.9 tok/s | Практикалық тең |
| Алғашқы токенге дейінгі уақыт (Sep 8) | 132.10 s | 277.47 s | Sol |
| AA нормаланған токен-микс бағасы / MTok | $3.08 | $7.175 | Sol |
Snapshot: 2026 жылғы 8 қыркүйек, арнайы 7 қыркүйек деп белгіленген Terminal-Bench жолынан басқа. Fable 5.1 Adaptive Reasoning, Max Effort, Default Fallback; Sol — max. Тікелей өлшемдер өзгеруі мүмкін. AA нормаланған токен-микс бағасы 7:2:1 кэш-хит/енгізу/шығыс қатынасын қолданады; бұл әр API сұрауының құны емес.
OSWorld 2.0 — осы салыстыруда Sol үшін ең үлкен хабарланған артықшылық: Fable 5.1 үшін 41.7%-ға қарсы 62.6%, яғни 20.9 пункт артық. Бұл Intelligence Index және Terminal-Bench бойынша күшті Fable нәтижелерін теңестіреді.
Дәлелдер нақты айырбасқа қолдайды: Fable 5.1 Intelligence Index бойынша жоғары, ал Sol алғашқы токенге дейінгі уақыты төмен және нормаланған бағасы төмен. Шығыс өткізгіштігі іс жүзінде тең. Бұл өлшемдер сапаға сезімтал топтық жұмыс пен интерактивті қолданбалар үшін әртүрлі таңдауларды қолдайды.
Күні көрсетілген тәуелсіз Terminal-Bench салыстыруы Anthropic тесті сияқты бағытты нұсқайды: 52.0% және 39.9%, вендор нәтижелеріндегі 55.8% және 37.3%-пен салыстырғанда. Екі алшақтықты өзара алмастыруға болмайды, өйткені бағалау орнатылымдары әртүрлі.
OpenAI бенчмарктері GPT-5.6 Sol туралы не айтады
OpenAI-дың іске қосу бағалаулары GPT-5.6 Sol қабілеттері туралы қосымша контекст береді. Олар жоғарыда талқыланған жаңа тікелей салыстырулардан бұрын, сондықтан оларды Fable 5.1-мен тікелей салыстыру үшін пайдаланбау керек.
OpenAI GPT-5.6 Sol үшін Terminal-Bench 2.1-де 88.8% хабарлайды. Бұл іске қосу орнатылымы аясында күшті агенттік код жазу қабілетінің дәлелі; ескі бенчмарк нұсқасын Terminal-Bench 4.0 ұпайларымен сандық салыстыруға болмайды.
Код үшін GPT-5.6 Sol vs Fable 5.1
Қарапайым код генерациясы үшін екі модель де көптеген өндірістік жүктемелерге артық. Айырмашылық код жазу агенттік бағдарламалық инженерияға айналғанда айқынырақ: үлкен репозиторийді тексеру, бірнеше файлды өңдеу, командаларды іске қосу, сәтсіздіктерді диагностикалау, тесттер жазу және тапсырма өткенше итерациялау.
Мұнда Claude Fable 5.1 қазіргі бенчмарктерде күшті дәлелге ие. Ол Terminal-Bench 4.0 бойынша да, тәуелсіз салыстыру бойынша да алда, және Anthropic-тің CursorBench нәтижесі де 73.4% пен 67.2% аралығында оны қолдайды.
Практикалық код бағалауы үшін репозиторий деңгейіндегі өзгерістерді, тесттерді, шолуды және өнімділікті қосыңыз. Қысқа код үзіндісінің сәттілігі бірнеше файл мен сәтсіз әрекеттерге созылатын тапсырманы аяқтаудың әлсіз проксиі.
Айналадағы орындалу ортасы шикі модель сапасымен бірдей маңызды болғанда GPT-5.6 Sol тартымды болып қалады. Shell execution, apply-patch, code interpreter, file search, computer use және MCP үшін жергілікті қолдау жасауға тиіс оркестрация инфрақұрылымының көлемін азайта алады.
Код жазу қорытындысы: ең күрделі автономды репозиторий жұмыстарына басымдық беретін бағалауларыңызда Fable 5.1 таңдаңыз. Бенчмарк қабілеті сәл төмен болса да, төмен құн және кең интеграцияланған орындалу стегі үшін GPT-5.6 Sol таңдаңыз.
Reasoning басқарулары және әзірлеуші тәжірибесі
Екі API интелектті әртүрлі ашады.
Sol-дың none-нан max-қа дейінгі reasoning диапазоны командаға бірнеше орнатылымда сапа мен кідірісті тестілеуге мүмкіндік береді. Төменгі effort reasoning жұмысын азайтуы мүмкін, бірақ дұрыс орнатылым тапсырма сәтсіздігінің құнына тәуелді.
Fable-дың әрқашан қосулы adaptive thinking-і effort тюнингін басқа жаттығу етеді. Бірдей effort белгілерін бірдей есептеу бюджеті ретінде емес, қолданбаңызда іске қосылатын орнатылымдарды салыстырыңыз.
Сәйкесінше, “әдепкі Sol” мен “әдепкі Fable” арасында әмбебап әділ салыстыру жоқ. Олардың әдепкі reasoning конфигурациялары әртүрлі. Өндірістік бағалаулар бірдей есептеу бюджеттерін немесе қолданбаңыз нақты қолданатын орнатылымдарды салыстыруы тиіс.
GPT-5.6 Sol vs Fable 5.1: Қайсысы AI агенттері үшін жақсы?
Таңдау тар жолдаудың қиын reasoning екеніне ме, әлде оны қоршап тұрған рантайм екеніне ме байланысты.
Терминал, автоматтандыру және кәсіби жұмыс бенчмарктеріндегі Fable басымдығы ең күрделі тапсырмаларға орынды кандидат етеді. Бұл басымдықты агентіңізге жалпылаудан бұрын аяқталу қарқынын және сәтсіз қадамдардан қалпына келуді өлшеңіз.
GPT-5.6 Sol құжатталған Responses құрал портфелі іздеу, файлдар, shell орындалуы және patch-терге негізделген қолданбалар үшін тартымды. Бұл — тапсырма дәлдігімен қатар бағаланатын интеграция артықшылығы, оны алмастырмайды.
| Агент талабы | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Қиын ұзын-көкжиекті reasoning | Өте жақсы | Үздік сәйкестік |
| Терминал/репозиторий автономиясы | Өте жақсы | Күшті дәлел |
| Табиғи интеграцияланған құралдар | Күшті | Күшті |
| Міндетті құрал таңдау | Қолдау бар; API тексеріңіз | Шектеулі; tool_choice режимдерін тексеріңіз |
| Көп агентті платформа интеграциясы | Күшті артықшылық | Агент архитектурасы арқылы қолжетімді |
| Ұзын жұмыс барысында прогресс | Жақсы | Негізгі мінез-құлық |
| Құнға сезімтал жоғары көлемді агенттер | Жақсы | Премиум |
| Қайталанатын массивті кэшті контекст | Жақсы | Әсіресе тартымды болуы мүмкін |
Екісін де пайдалану үнемді болуы мүмкін, егер тапсырмалардың аз бөлігі ғана эскалацияны қажет етсе. Қосымша сәтті аяқталулар екінші модельдің жоғары бағасы мен іске қосу кідірісін өтей ме — соны өлшеңіз.
Ұзын контекст: 1.05M vs 1M — маңызды айырмашылық емес
Тақырыптық сандар дерлік бірдей: GPT-5.6 Sol — 1.05M, Fable — 1M. 5% сыйымдылық айырмасы үлкен репозиторийді, құқықтық корпус, зерттеу мұрағатын немесе көп сағаттық агент тарихын талдай аласыз ба, жоқ па, соны анықтамайды. Екеуі де миллион-токен класында.
GPT-5.6 Sol үшін 272K-тан жоғары енгізу жоғары ұзын-контекст тарифтерін қосады: $8/MTok енгізу, $0.80/MTok кэштен оқу және $30/MTok шығыс. Кэш жазулары да $5-тен $10/MTok-қа дейін көтеріледі.
Fable 5.1 стандартты 1M-контекст тарифтерін сақтайды: $10/MTok енгізу, $50/MTok шығыс және $0.25/MTok кэш оқу. Бұл құжатталған конфигурацияда 272K-тан жоғары жеке премиум жоқ.
100K кэштен тыс енгізу токені, 900K кэш-оқу токені және 20K жалпы биллингтелетін шығыс токені бар бір айналымды қарастырыңыз. GPT-5.6 Sol құны: 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 құны: 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Бұл кэшке сүйенетін айналым Fable-дың кэш оқуы арзан болғандықтан баға алшақтығын дерлік жабады. Нәтиже жүктеменің токен-миксіне тәуелді; бұл екі модель толық агент сессиясы үшін бірдей құнға түседі дегенді білдірмейді.
Құн болжамдары: 900K токен префиксі бұрыннан кэште, ал 100K жаңа енгізу жаңа кэш жазуы ретінде биллингтелмейді. Бағалау бастапқы кэш жазуын және құрал төлемдерін қамтымайды. 20K шығыс лимиті барлық биллингтелетін шығысты, оның ішінде биллингтелетін reasoning токендерін де қамтиды.
Баға: кәдімгі жүктемелерде Sol жеңеді, Fable бір маңызды кэш метрикасында ұтады
Тексерілген тарифтерде Sol $4 енгізу / $20 шығыс per MTok, кэш оқуы $0.40. Fable 5.1 — $10 енгізу, $50 шығыс және $0.25 кэш оқуы. Кесте провайдер бағаларын CometAPI-дағы GPT-5.6 Sol API және Claude Fable 5.1 API бағаларынан бөлек көрсетеді.
| Баға компоненті | GPT-5.6 Sol Ресми бағалар | Claude Fable 5.1 Ресми бағалар |
|---|---|---|
| Ресми енгізу / MTok | $4.00 | $10.00 |
| Ресми шығыс / MTok | $20.00 | $50.00 |
| Ресми кэш оқу / MTok | $0.40 | $0.25 |
| Ресми кэш жазу / MTok | $5.00 (30 минут) | $12.50 (5 минут) |
| 272K-тен жоғары: енгізу / кэш оқу / кэш жазу / шығыс | $8 / $0.80 / $10 / $30 | Сол құжатталған базалық тарифтер |
| CometAPI енгізу / MTok | $3.20 | $8.00 |
| CometAPI шығыс / MTok | $16.00 | $40.00 |
Кэш жазу ұзақтығы әртүрлі: Sol әдепкі 30 минут сақтау мерзімін қолданады, ал Fable 5.1 үшін көрсетілген тариф — 5 минуттық жазу. Пайдаланатын провайдер және маршрут үшін кэш құру, жаңарту және аяқталу мінез-құлқын тексеріңіз.
Тікелей провайдер бағаларында Fable 5.1 кэштен тыс енгізу үшін де ($10 vs $4/MTok), шығыс үшін де ($50 vs $20/MTok) Sol-дан 2.5× қымбат. Бұл салыстыруды даталанған ретінде қарастырыңыз, себебі провайдер акциялары және гейтвей бағалары өзгеруі мүмкін.
Қысқа контекст сұрауында 100K енгізу және 10K жалпы биллингтелетін шығыс үшін Sol шамамен $0.60, ал Fable — $1.50 тұрады. Жоғарыдағы CometAPI бағаларында, сол микс $0.48 және $1.20. Бұл мысалдар кэш жазуларын және құрал төлемдерін қамтымайды.
Fable-дың қысқа контекст кэш оқу тарифі 37.5% төмен: ($0.40 − $0.25) ÷ $0.40. Бұл үлкен тұрақты префиксті қайта пайдаланатын агенттер үшін маңызды болуы мүмкін, бірақ жалпы үнем жаңа енгізуге, жазу жиілігіне және шығыс көлеміне тәуелді.
Баға қорытындысы: жаңа контекст трафигі үшін Sol арзан бастау. Кэш оқудың үлесі өскен сайын Fable бәсекеге қабілетті бола түседі; кэш құру және жаңартуды қоса, толық сессия құнын салыстырыңыз.
Жылдамдық және latency
Максималды effort тесттері алғашқы көрінетін токенге дейін айтарлықтай reasoning уақытын жұмсай алады.
8 қыркүйектегі өткізу және latency өлшемдері Fable үшін 69.9 токен/с және Sol үшін 69.8 токен/с көрсетеді. Алғашқы токенге дейінгі уақыт — 277.47 секунд және 132.10 секунд. Шығыс өткізгіштігі практикалық түрде тең; осы конфигурацияда Sol көрінетін шығуды ертерек бастайды.
Бұл — максималды effort бенчмарк өлшемдері, әр API шақыруы үшін уәде етілген latency емес. Промпт ұзындығы, reasoning конфигурациясы, провайдер жүктемесі, құралдар және кэш күйі нәтижені өзгерте алады. Алғашқы токенге дейінгі уақыт пен толық жауап уақыты — әртүрлі метрикалар.
Интерактивті жұмыс үшін, төмен байқалған іске қосу кідірісі Sol-дың пайдасына болуы мүмкін. Асинхронды зерттеу немесе түнгі репозиторий жұмысы үшін, алғашқы токенді күткеннен гөрі сәтті аяқталу маңызды болуы мүмкін. Қолданбалы орнатылымдарда және қажетті concurrency-де екі модельді де бенчмарктаңыз.
Қауіпсіздік шаралары — өндірістік айырмашылық
Екі модель де қабілеттері сезімтал киберқауіпсіздік және ғылыми домендерге таралғандықтан, күштірек қорғаныс қолданады, бірақ оларды әртүрлі жүзеге асырады.
OpenAI GPT-5.6 отбасы үшін қабатты қорғаныс және мониторингті сипаттайды. Сезімтал домендердегі қолданбалар тиісті қауіпсіздік шараларын орналастыру мінез-құлқының бір бөлігі ретінде бағалауы керек.
Anthropic-тің қайта бағыттау және сақтау шарттары кейбір сезімтал киберқауіпсіздік немесе биология сұрауларын аз қабілетті модельдерге бағыттайтынын сипаттайды, және сол қайта бағытталған сұраулар үшін Fable тарифін алмайды. Әдепкі дерек сақтау кезеңі — 30 күн, белгілі enterprise келісімдері үшін ерекшеліктер бар.
Кәдімгі код жазу және білім жұмысы үшін бұл айырмашылықтар пайда болмауы мүмкін. Қауіпсіздік өнімдері, реттелетін жүктемелер немесе құпиялылыққа сезімтал орналастырулар үшін олар бенчмарк сапасы және баға қатарындағы тексеру тізіміне кіреді.
Қай модельді таңдау керек?
Жалпы салыстыру жұмыс жүктемесінің пішініне дейін азаяды.
| Жүктеме | GPT-5.6 Sol | Claude Fable 5.1 | Ұсыныс |
|---|---|---|---|
| Қиын автономды код жазу | Өте жақсы | Күшті ағымдағы бенчмарктер | Fable 5.1 |
| Ұзақ көкжиекті зерттеу | Өте жақсы | Негізгі күш | Fable 5.1 |
| Жоғары көлемді алдыңғы қатарлы API | Едәуір арзан | Қымбат | Sol |
| Интерактивті код көмекшісі | Макс-әрекет TTFT төмен | Макс-әрекет TTFT жоғары | Іске қосылған орнатылымды тесттеңіз |
| Құралға бай API агент | Кең табиғи құралдар стегі | Күшті | Sol |
| Миллион-токен кэшті агент | Бәсекеге қабілетті | Өте төмен кэш оқу бағасы | Екеуін де тесттеңіз |
| Максималды reasoning сапасы | Өте жақсы | Тәуелсіз артық | Fable 5.1 |
| Кәдімгі сұрау бағасы | Айқын артықшылық | Премиум | Sol |
| Сурет/құжат reasoning | Күшті | Күшті | Жүктемеде тесттеңіз |
| Бір провайдер OpenAI стегі | Табиғи сәйкестік | Көшу/гейтвей қажет | Sol |
| Модель-тәуелсіз роутинг | Күшті | Күшті | CometAPI арқылы екеуі де |
Маршрут саясаты өз күрделілігін ақтауы тиіс. Бір модельді базалық нұсқамен Sol-first саясатын салыстырыңыз, қиын тапсырмаларды Fable 5.1-ге эскалациялайды, және тек сапа немесе сәтті тапсырмаға шаққандағы құн жақсарса ғана роутерді сақтаңыз.
GPT-5.6 Sol және Fable 5.1-ді CometAPI арқылы қалай салыстыруға болады
CometAPI GPT-5.6 Sol және Claude Fable 5.1-ді әлдеқашан біріктірген. Екі модельге де олардың табиғи сұрау форматтарымен қол жеткізіңіз, бірдей бағалау жиынтығын жіберіңіз және қайтарылған нәтижелерді сәйкес орнатылымдарда салыстырыңыз.
Әр модель үшін табиғи форматтағы сұрауларды пайдаланыңыз және промпттар, держинақтар, effort орнатылымдары, concurrency және бағалау ережелерін тұрақты ұстаңыз. Жүгірістерді қайталаңыз; әр модель үшін бір реттік тізбекті сұрау latency не сапаны сенімді бағалауға жеткіліксіз.
Өндірістік бағалау үшін, бекітілген промпт жиынын пайдаланыңыз, жүгірістерді алма-кезек ретпен қайталаңыз, effort орнатылымын тіркеңіз және дұрыстық, тест өту қарқыны, құрал сәттілігі, қайта тырысулар, токен қолдану, өткен уақыт және сәтті тапсырмаға шаққандағы жалпы құн метрикаларын бағалаңыз. Ортақ базалықтан кейін әр модельді бөлек тюнингтеңіз.
Қорытынды шешім: GPT-5.6 Sol немесе Claude Fable 5.1?
Fable 5.1 ең күрделі автономды код жазу және ұзақ көкжиекті жұмыстар үшін тікелей дәлелдерде күшті. Ол бес ортақ вендор бенчмарк жолында және күнтелінген тәуелсіз терминал салыстыруында алда. Бұл оны өз тапсырмаларыңызда валидацияға бағынатын күшті эскалация кандидаты етеді.
Sol-дың кәдімгі токен бағалары төмен, reasoning басқарулары нәзік және кең табиғи құралдар стегі бар. Тексерілген тәуелсіз максималды-әрекет конфигурациясында оның алғашқы токенге дейінгі уақыты да төмен; шығыс өткізгіштігі дерлік тең.
Ең күрделі автономды тапсырмалар сәттілік қарқыныңызды айқындаса, Fable 5.1-ге басымдық беріңіз. Құнға сезімтал алдыңғы қатарлы инференс немесе құралға бай қолданбалар үшін Sol-дан бастаңыз. Интерактивті жүктемелер үшін, байқалған іске қосу кідірісі артықшылығы сақталатынын растау үшін орналастырылған effort орнатылымдарын тесттеңіз.
Талаптарыңызды қарапайым түрде қанағаттандыратын бір модельді таңдаңыз. Бағалау нәтижелері екеуінің арасында ауысу сәтті тапсырмаға шаққандағы сапаны немесе құнды жақсартатынын көрсеткенде ғана маршруттауды қосыңыз.
Жиі қойылатын сұрақтар
Claude Fable 5.1 GPT-5.6 Sol-дан жақсы ма?
8 қыркүйектегі snapshot-та тәуелсіз Intelligence Index жоғары: 53, Sol үшін 47. Сондай-ақ күнтелінген тәуелсіз терминал тестінде алда. Бұл осы бағалауларда сапа артықшылығын қолдайды, әр жүктеме үшін жақсы дегенді білдірмейді.
GPT-5.6 Sol Claude Fable 5.1-ден арзан ба?
Кәдімгі кэштен тыс API трафигі үшін — иә: тікелей провайдер енгізу/шығыс тарифтері Sol үшін $4/$20 per MTok, Fable 5.1 үшін $10/$50. Кэшке сүйенетін жүктемелерде Fable-дың кэш оқу тарифі төмен болғандықтан алшақтық тарылады. Бағаға жазу және аяқталу мінез-құлқын қосыңыз.
Қай модель код жазуға жақсы?
Осы салыстыруда Fable 5.1 автономды код жазу бенчмарк дәлелдерінде күшті. Сол уақытта Sol төмен құнды жұмыс ағындары және интеграцияланған орындалу құралдары үшін тартымды. Репозиторий тапсырмаларын орындалатын тесттермен қолданыңыз, өлшенген қабілет алшақтығы қолданбаңыз үшін маңызды ма — соны шешу үшін.
Қай модельде контекст терезесі үлкен?
Техникалық тұрғыда Sol — 1.05M, Fable 5.1 — 1M токен, ал екеуі де 128K шығысқа дейін рұқсат етеді. Практикада, Sol-дың >272K баға шегі және Fable-дың арзан кэш оқуы 50K токен сыйымдылық айырмашылығынан жиі маңызды.
CometAPI арқылы екі модельге де қол жеткізе аламын ба?
Иә. CometAPI-дегі GPT-5.6 Sol API және Claude Fable 5.1 API мәтіндік бағалаулар үшін ортақ бастапқы нүктені қолдайды. Базалықты өндірістік агентке кеңейтпес бұрын маршрутқа тән reasoning, кэштеу және құрал қолдауын тексеріңіз.