CometAPI-мен құрастырыңызБірнеше модель үшін бір API керек пе?Жұмыс ағынын Playground-та сынап көріңіз, содан кейін модель мен құн сіздің use case-іңізге сай болса, API key жасаңыз.
Жиі орындалатын, тексеруге болатын және шығынға сезімтал тапсырмалар үшін GPT-6.1 Terra-дан бастау алыңыз. Күрделі кодтау, көпқадамды құрал пайдалану және сәтсіздік құны жоғары жұмыс ағымдары үшін GPT-6.1 Sol-ды бағалаңыз. Прагматикалық әдепкі тәсіл — алдымен Terra-ны қолданып, алдын ала анықталған тесттер немесе валидация тексерістері сәтсіз болғанда Sol-ға эскалациялау.
Негізгі түйіндер
Стандартты токен бағасы: OpenAI Standard-та Terra үшін енгізу $1 млн токенге $1, ал шығару — $5; Sol үшін сәйкесінше $2 және $10.
Тапсырмаға тән өнімділік: Ең жоғары пайымдау күш-жігерінде Terra Agents’ Last Exam v1 және Terminal-Bench-Science 0.1 бойынша аздап алда, ал Sol Terminal-Bench 4.0 және OSWorld 2.1 бойынша алда.
Екі модель де 1.05 миллион токендік контекст терезесін ұсынады және мәтін мен кескін кірістерін қабылдайды.
Түсініктілік, дереккөзге сілтеме және ағымдағы API терминологиясы бойынша тексерілді.
Ортақ контекст сыйымдылығы:
Пайымдауды басқарудың әртүрлілігі: Terra-да пайымдауды none етіп өшіруге болады; Sol кемінде low пайымдау күш-жігерін талап етеді.
Операциялық шығын маңызды: Қайта әрекеттер мен құрал қоңырауларын қоса алғанда, сәтті аяқталған тапсырмаға жұмсалған шығынды салыстырыңыз және адамдық шолу шығындарын бөлек қадағалаңыз.
GPT-6.1 Terra және GPT-6.1 Sol: Шолу және сипаттамалар
Төмендегі шолу айырбас негіздерін қорытындылайды. Толық бөлімдер әр таңдаудың дәлелі, биллинг жорамалдары және шектеулерін түсіндіреді.
Шешім факторы
GPT-6.1 Terra
GPT-6.1 Sol
Бастапқы жүктеме
Кәдімгі визуалды жұмыс және қайталанатын агенттер
Күрделі кодтау және тұрақты кәсіби пайымдау
Контекст және модальдар
Сол контекст сыйымдылығы; мәтін және кескін кірісі
Сол контекст сыйымдылығы; мәтін және кескін кірісі
Пайымдауды бақылау
Пайымдауды өшіру опциясы бар
Кемінде төмен пайымдау күш-жігерін талап етеді
Жария өнімділік үлгісі
Қайталанатын агент тапсырмаларында төмен шығынмен
Қиын кодтау және десктоп тесттерінде мықты
API қолжетімділігі
OpenAI және CometAPI
OpenAI және CometAPI
GPT-6.1 Terra: Тиімді визуал және агент жұмыс ағымдары
OpenAI 2026 жылғы 26 қазанда GPT-6.1 Terra-ны таныстырды. Ол визуалды пайымдауды, компьютерді пайдалануды және кәсіби күнделікті жұмыс ағымдары үшін жалпымақсатты мәтін генерациясын біріктіреді. Оның төмен токен тарифтері тапсырмалар жиі қайталанып, нәтижелерді тексеруге болатын жағдайда пайдалы бастапқы нүкте етеді.
GPT-6.1 Sol: Күрделі кодтау және кәсіби пайымдау
GPT-6.1 Sol 2026 жылғы 29 қыркүйекте іске қосылды. Ол талап деңгейі жоғары кодтау мен кәсіби жұмысқа бағытталған. Бейтаныс репозиторий, бір-біріне тәуелді әрекеттердің ұзын тізбегі немесе түзетулердің қымбаттылығы қосымша пайымдау қабілетін құнды ететін жағдайда оны бағалаңыз.
Контекст, пайымдау және API сипаттамалары
Сипаттама
GPT-6.1 Terra
GPT-6.1 Sol
Ресми шығу күні
2026 жылғы 26 қазан
2026 жылғы 29 қыркүйек
API model ID
gpt-6.1-terra
gpt-6.1-sol
Контекст терезесі
1,050,000 токен
1,050,000 токен
Білім қырқу күні
2026 жылғы 1 маусым
2026 жылғы 30 сәуір
Енгізу / шығару
Мәтін және кескін / мәтін
Мәтін және кескін / мәтін
Пайымдау күш-жігері
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Әдепкі пайымдау күш-жігері
medium
medium
API мүмкіндіктері: Екі модель де Structured Outputs, streaming және Batch API-ды қолдайды. Құрал қоңыраулары Responses API арқылы орындалады, ал fine-tuning қолдау көрсетілмейді. Таңдалған провайдер мен соңғы нүкте қолданбаңызға қажет мүмкіндіктерді ұсынатынын тексеріңіз.
Екі модель де 1,050,000 токендік контекст терезесінде 128,000 дейін шығару токендерін рұқсат етеді. Толық шығару лимитін резервтеу қалған алмасуға — енгізуіңізді, жүйелік нұсқауларды және құрал тарихын қоса — 922,000 токен қалдырады. Бұл — жоспарлау есебі, бөлек бекітілген енгізу шектеуі емес.
Архитектураны ашу: Сілтемеленген ашық модель спецификациялары сенімді салыстыруға жеткілікті ішкі архитектура бөлшектерін бермейді. Контекст сыйымдылығы мен пайымдау параметрлерін параметр саны немесе архитектура дәлелі ретінде қарастырмаңыз.
Пайымдауды басқару: Terra-ның none параметрі қарапайым түрлендірулер мен шығаруды орындауға ыңғайлы. Алғашқы салыстыруда екі модельде де бірдей қолдау етілген пайымдау параметрін қолданыңыз, содан соң әр модельді жұмысыңыздың сапасы мен кідіріс талаптарына қарай баптаңыз.
Екі модельдің жарияланған контекст сыйымдылығы бірдей, бірақ бұл ұзын контекстте іздеу дәлдігі немесе пайымдау сапасы бірдей дегенді білдірмейді. Сондықтан модель таңдауы пайымдау сапасын, жұмыс ағымының тиімділігін, құнын және тапсырмаға тән іздеу өнімділігін ескеруі тиіс.
GPT-6.1 Terra және GPT-6.1 Sol: Өнімділік
Есептелген нәтижелер аралас көрініс береді: Terra кейбір агент және ғылыми-кодтау бағалауларында аздап алда, ал Sol жалпы терминал кодтауында, десктоп автоматтандыруында және көру қабілетінде жоғары ұпай жинайды. Төмендегі салыстырулар OpenAI-дың іске қосу нәтижелерін тәуелсіз бағалаулардан ажыратады және әрқайсысы өндірістегі өнімділік туралы нені — және нені айта алмайтынын — түсіндіреді.
Ресми бенчмарк нәтижелері және тест шарттары
Төмендегі нәтижелер OpenAI-дың Terra іске қосу бағалауларынан алынған. Terra medium және maximum пайымдау күш-жігерінде, ал Sol maximum күш-жігерінде көрсетілген. Соңғы баған тек maximum-конфигурацияларды салыстырады.
OSWorld офлайн 2.1 бағалауын қолданады. Фактілік қате тесті әдейі қателерді тудыратын OpenAI ішкі промпттарына негізделген. Бұлар — жеткізуші хабарлаған, нақты бағалау конфигурацияларынан алынған нәтижелер, өндірістегі жұмыс жүктемеңізді тікелей өлшемейді.
Бенчмарк
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Ең жоғары деңгейдегі салыстыру
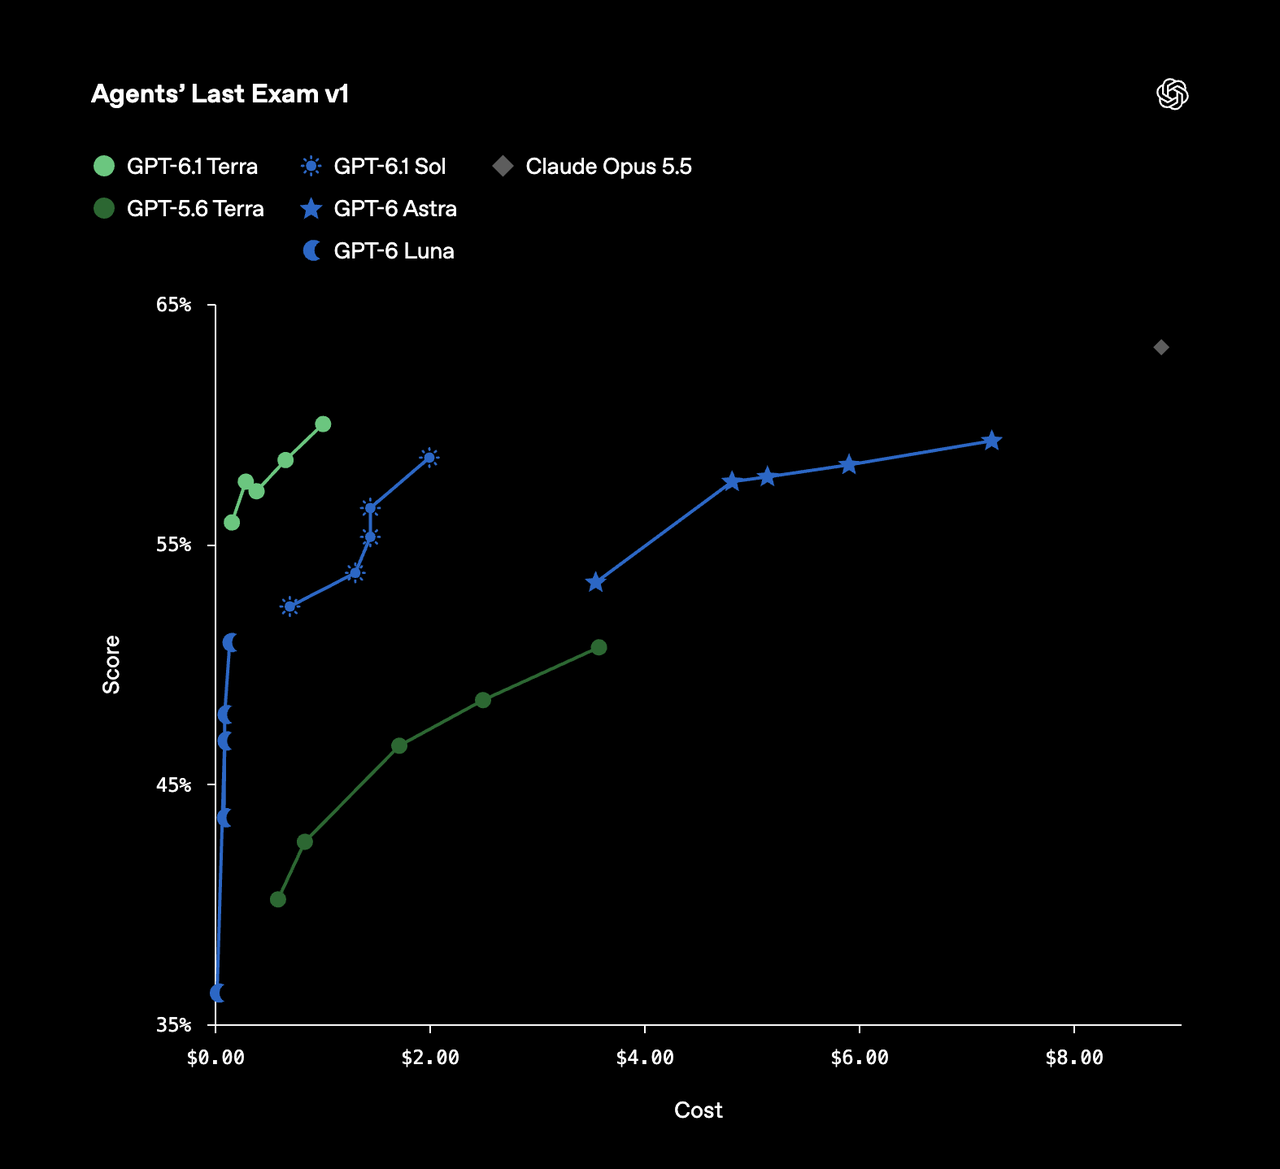
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 пп
MMMU-Pro (Көру)
84.60%
85.50%
86.30%
Sol +0.8 пп
OSWorld 2.1, офлайн
66.70%
74.20%
78.00%
Sol +3.8 пп
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 пп
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 пп
Қиын промпттардағы фактілік қате деңгейі
10.10%
4.30%
4.40%
Terra 0.1 пп төмен
Барлық ұпайлар — пайыздар; айырмашылықтар пайыздық пункттермен (пп) көрсетілген. Төмен болғаны жақсы тек фактілік қате деңгейі үшін. Тек 0.1 пункттік қате айырмасы өзі бойынша мәнді сенімділік артықшылығын орнатпайды.
Бағдарламалық инженерия үшін Sol-дың Terminal-Bench-тегі басымдығы және Terra-ның Terminal-Bench-Science-тағы азғана басымдығы нәтиженің кодтау тапсырмасының түріне тәуелді екендігін көрсетеді. Қолданба жұмыс ағымдары үшін Sol-дың жоғары OSWorld ұпайы оны десктоп автоматтандыруға бағалауды қолдайды, ал Terra-ның Agents’ Last Exam нәтижесі оны кәсіби агент тапсырмаларына кандидат етеді. Екеуінің ешқайсысы әмбебап жеңімпазды орнатпайды.
Агент қаңқасы, құралдарға қолжетімділік және орта конфигурациясы бұл нәтижелерге әсер етуі мүмкін. Бұл сандарды тестке кандидаттарды анықтау үшін қолданыңыз, содан соң нақты аяқтауыңыз қажет репозиторий өзгерістері мен қолданба жұмыс ағымдарына қарсы валидация жасаңыз.
OpenAI-дың Agents’ Last Exam v1 диаграммасы модель конфигурациялары бойынша ұпайларды тапсырма құнының бағасымен салыстырады. Ол жоғарыдағы кестеге құн- тиімділік перспективасын қосады; диаграммадағы құндар бағалау орнатылымына тән.
Тәуелсіз интеллект және кодтау бағалаулары
Artificial Analysis-тің 26 қазандағы бағалауы Terra-ны ең жоғары пайымдау күш-жігерінде өзінің Intelligence Index шкаласында Sol-дан төрт ұпай төмен қояды. Оның Coding Agent Index v2.0 шкаласында Terra — 48, ал Sol — 54. Бұлар өз әдістері мен ұпай шкалалары бар бөлек бағалаулар; оларды OpenAI бенчмарктерімен сандық түрде біріктіруге болмайды.
Сол талдау Terra-ның low және medium пайымдау параметрлерін интеллект бағалауында ерекше құн- тиімді деп көрсетеді. Бұл практикалық конфигурацияларды максимум күш-жігерімен қатар сынауды қолдайды. Бағалау құндары тест орнатылымына тән болып қалады және қолданбаңыздың шығынының бағасы ретінде қабылданбауы тиіс.
Жылдамдық және кідіріс: Тапсырманы аяқтау мен токен генерациясын ажырату
OpenAI Terra-ның Agents’ Last Exam бағалауындағы тапсырмаларды Sol-ға қарағанда үш еседен астам жылдам аяқтайтынын хабарлайды. Бұл — пайымдау мен бағдарламалық әрекеттерді қоса есептегендегі ұштан-ұшқа өлшем. Ол шығарылатын токендердің өткізу қабілеті үш есе жоғары дегенді немесе әр API сұрауы үшін дәл осындай жылдамдық артуын білдірмейді.
Интерактивті қолданбалар үшін, жауап басталғанға дейінгі күтуді өлшейтін алғашқы токенге дейінгі уақытты және жауаптың жалғасу жылдамдығын өлшейтін секунд сайынғы шығару токендерін ажыратыңыз. Агенттер үшін, құрал қоңыраулары, қайта әрекеттер және қалпына келтіруді қоса, ұштан-ұшқа аяқтау уақытына басымдық беріңіз.
Екі модельді де бірдей промпттармен, құралдармен, қолдау етілген бірдей пайымдау параметрлерімен және қабылдау критерийлерімен салыстырыңыз. Кідірісті тапсырманың сәттілігімен бірге жазыңыз: егер жауапты түзету көп қажет болса немесе жұмыс ағымын аяқтамаса, жылдамырақ жауаптың құны шектеулі.
Көру және ұзын контекст: Нәтижелер нені дәлелдейді
Sol-дың MMMU-Pro-да ең жоғары күш-жігерінде 0.8 пайыздық пункт артықшылығы — визуал бойынша бір ғана есептелген нәтиже, әрбір визуалды жұмыс ағымында жақсырақ өнімділіктің кепілі емес. Ұсақ жапсырмалар, нашар скан көшірмелер, тығыз диаграммалар және бейтаныс макеттермен өкілді кірістерді сынаңыз.
Жоғарыдағы бағалаулар ұзын контекстті іздеу немесе пайымдау бойынша қай модель жақсы екенін орнатпайды. Жарияланған контекст сыйымдылығы бірдей болғанымен, сыйымдылықтың өзі іздеу дәлдігін немесе сессиялар арасындағы жадты көрсете алмайды. Әр модельдің құжаттарыңыздан тиісті дәлелдерді таба алатынын және қолдана алатынын тексеріңіз, ал қолданба күйін сұраулар арасында айқын түрде сақтаңыз.
GPT-6.1 Terra және GPT-6.1 Sol: Құны
Токен бағалары шығындарды салыстырудың бастапқы нүктесі. Қайта әрекеттер, пайымдау токендері, құрал қоңыраулары және адамдық шолу да тапсырманы сәтті аяқтауға жұмсалатын шығынға әсер етеді.
Төмендегі ставкалар — млн токенге АҚШ доллары және баға.
Провайдер және токен санаты
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — енгізу
$1.00
$2.00
OpenAI Standard — кэштенген енгізу
$0.05
$0.10
OpenAI Standard — шығару
$5.00
$10.00
OpenAI Standard — 30 минуттық кэш жазу
$1.25
$2.50
OpenAI Standard — 12 сағаттық кэш жазу
$2.50
$5.00
CometAPI әдеттегі енгізу
$0.80
$1.60
CometAPI әдеттегі шығару
$4.00
$8.00
OpenAI API бағасы
Terra-ның көрсетілген Standard ставкалары осы санаттар бойынша Sol-дың жартысы. Нақты ақы сұрау конфигурациясына байланысты: ұзын контекст сұраулары, өңдеу деңгейлері, аймақтық өңдеу және құрал қолдану басқа шарттарға ие болуы мүмкін. Өндірістік шығынды бағаламас бұрын қолданыстағы OpenAI баға құжаттамасын тексеріңіз.
CometAPI бағасы
CometAPI — жеке баға және мүмкіндіктері бар үшінші тарап қолжетімділік маршруты. Оның көрсетілген әдеттегі енгізу және шығару ставкалары төменде бөлек көрсетілген.
Осы ставкаларда CometAPI-дың әдеттегі енгізу және шығару бағалары жоғарыдағы OpenAI Standard ставкаларынан 20% төмен. Есептік жазбаңыз үшін ағымдағы бағаларды, ұзын контекст үшін ақы, кэш қолдауын және құрал қолжетімділігін орналастырмас бұрын растаңыз.
1,000 сұрауға арналған мысал шығын
Айталық, қолданба 1,000 сұрау жасайды, әрқайсысында 2,000 кэштенбеген енгізу токені және 500 төленетін шығару токені бар. Бұл барлығы 2 млн енгізу токені және 500,000 шығару токенін береді.
1,000 сұрауға, әрқайсысы 2,000 кэштенбеген енгізу токені және 500 төленетін шығару токені пайдаланылған жағдайда, болжамды шығындар:
OpenAI арқылы Terra: енгізу үшін $2.00 және шығару үшін $2.50, барлығы $4.50.
OpenAI арқылы Sol: енгізу үшін $4.00 және шығару үшін $5.00, барлығы $9.00.
CometAPI арқылы Terra: енгізу үшін $1.60 және шығару үшін $2.00, барлығы $3.60.
CometAPI арқылы Sol: енгізу үшін $3.20 және шығару үшін $4.00, барлығы $7.20.
Бұл есептер жоғарыдағы әдеттегі ставкаларды қолданады, Batch API жеңілдігі жоқ. Олар кэш жазуларын, жеке құрал ақысы мен қайта әрекеттерді қамтымайды. Шығаруға жазылатын кез келген пайымдау токендері шығару жалпы санына қосылуы тиіс.
Сәтті тапсырмаға шаққандағы тиімді құн
Бұл мақалада сәтті тапсырма — алдын ала анықталған сапа, қолданылса схема және аяқтау тексерістерінен қосымша адам түзетусіз өтетін тапсырма.
Төмен токен бағалары әрқашан төмен операциялық шығын әкелмейді. Егер Terra-ға көбірек әрекет, пайымдау токендері немесе адам араласуы қажет болса, оның үнемі азаюы мүмкін. Егер Sol алғашқы әрекетте көбірек тапсырманы сәтті аяқтаса, оның жоғары тарифтері өзін-өзі ақтайды.
Effective model-and-tool cost per successful task = total model and tool spending across all attempts ÷ number of successful tasks.
Адамдық шолу және түзету шығындарын бөлек қадағалаңыз. Тек токен бағаларын ғана емес, сапа мақсатыңызға ең төмен біріктірілген құнмен жететін модельді таңдаңыз.
Қай модельді таңдау керек: GPT-6.1 Terra немесе GPT-6.1 Sol?
Таңдауды тапсырма күрделілігіне, тексерілетін нәтиже сапасына және толық аяқтау құнына негіздеңіз. Terra — күнделікті жұмыс ағымдары үшін пайдалы бастапқы нүкте; Sol — қиын пайымдау немесе сәтсіздік құны жоғары болғанда қосымша шығынды ақтайды.
GPT-6.1 Terra-ны қашан таңдау керек
Terra-дан жоғары көлемді шығару/экстракция, құжат жобалау, каталог сәйкестендіру және болжамды қолданба жұмыс ағымдары үшін бастаңыз. Нәтижелер бастапқы құжаттарға, міндетті өрістерге немесе автоматтандырылған валидация ережелеріне қарсы тексеріле алатын тапсырмалар — жақсы кандидаттар.
Terra рұқсат етілген қайта әрекет пен адамдық шолу бюджеті шегінде дәлдік және аяқтау мақсаттарын қанағаттандырғанда таңдаңыз. Қайталап сәтсіздік үнемді жоя алатын болса, төмен токен тарифтерінің пайдасы аз.
GPT-6.1 Sol-ды қашан таңдау керек
Күрделі дебаг, көптеген тәуелділіктері бар репозиторий өзгерістері және тәуелді әрекеттердің ұзын тізбегі бар десктоп жұмыс ағымдары үшін Sol-ды бағалаңыз.
Тестілеу көбірек қабылданған патчтар беретінін, көбірек тесттен өтетінін немесе аз қолмен түзетуді қажет ететінін көрсеткенде Sol-ды таңдаңыз. Мұндай жетілдірулер жұмысты аяқтау құнын төмендеткенде, жоғары токен құны ақталады.
Алдымен Terra-ны пайдаланып, кейін Sol-ға эскалациялауды қашан қолдану керек
Гибридті жұмыс ағымы бастапқы әрекет үшін Terra-ны пайдаланып, алдын ала анықталған тексерістер сәтсіз болғанда Sol-ға эскалациялауы мүмкін. Эскалацияны модельдің сенімділігіне емес, бақыланатын нәтижелерге негіздеңіз.
Мысалы, код генерациясы жұмыс ағымы мынадай болуы мүмкін:
Terra-дан сұралған өзгерісті жасауын өтініңіз.
Тиісті тесттер мен валидация тексерістерін іске қосыңыз.
Өзгеріс осы тексерістерден өтпесе немесе Terra-ның тексерілген мүмкіндігінен тыс болса, Sol-ға эскалациялаңыз.
Қайта әрекет бюджеті таусылғаннан кейін шешілмеген жағдайларды адамдық шолуға жіберіңіз.
Эскалациялағанда бастапқы сұрауды, тиісті контексті, сәтсіз шыққан нәтижені және валидация нәтижелерін сақтаңыз. Құн салыстыруы толық жұмыс ағымын қамтуы үшін екі модельдің де пайдаланылуын тіркеңіз.
Өндірістік бағалау тізімдемесі
Орнатылатын әдепкі модельді таңдаудан немесе эскалациялау жұмыс ағымын енгізуден бұрын:
Өкілді тапсырмаларды пайдаланыңыз: Кәдімгі сұрауларды және сәтсіздік құны жоғары жағдайларды қосыңыз.
Бақыланатын салыстыруды сақтаңыз: Ұқсас нұсқаулар, дәлелдер, құралдар және қабылдау критерийлерін пайдаланыңыз. Модель ID-ларын, соңғы нүктелерді, пайымдау параметрлерін және тест даталарын жазыңыз.
Қабылданған нәтижелерді өлшеңіз: Дәлдік, қажет болғанда схема валидтілігі, тест нәтижелері және қолмен түзетусіз аяқталуын тексеріңіз.
Уақыт пен шығынды өлшеңіз: Медианалық және шеткі кідірістерді, төленген токендерді, құрал қоңырауларын, қайта әрекеттерді және адамдық шолу күшін қадағалаңыз.
Салыстыруды қайталаңыз: Тапсырмаларды бірнеше рет іске қосып, модель ретін алмастырыңыз, бір жолғы нәтижелердің ықпалын азайту үшін.
Операциялық шектерді анықтаңыз: Қайта әрекет бюджеттерін, эскалация триггерлерін және адам мақұлдау талаптарын алдын ала қойыңыз.
Толық жұмыс ағымын салыстырыңыз: Сәтсіз әрекеттер мен эскалация шығындарын қоса, сәтті тапсырмаға жұмсалған жалпы шығынмен салыстырыңыз.
GPT-6.1 Terra және GPT-6.1 Sol қайдан қолжетімді?
Ресми провайдер арқылы қолжетімділік
Екі модель де OpenAI API арқылы қолжетімді. Мәтіндік сұраулар үшін Chat Completions қолдау етіледі; құрал қоңыраулары үшін Responses API қажет. Модельдің қолдау параметрлерін, есептік жазбаңыздың шектеулерін және таңдаған маршрутыңыздағы құралдарды растаңыз.
CometAPI арқылы қолжетімділік
Кез келген модельді CometAPI арқылы пайдалану үшін оның quickstart guide нұсқаулығын орындап, OpenAI-ға үйлесімді SDK орнатыңыз. CometAPI кілтіңізді қауіпсіз түрде COMETAPI_KEY орта айнымалысы арқылы беріңіз және base URL ретінде https://api.cometapi.com/v1 орнатыңыз. Модель идентификаторы ретінде gpt-6.1-terra немесе gpt-6.1-sol таңдаңыз және бұл маршруттың есептік жазбаңыз үшін қосылғанын растаңыз.
Алғашқы салыстыру үшін екі модельге де бірдей өкілді тапсырмалар беріп, medium пайымдау күш-жігерін қолданыңыз. Нұсқаулар мен қабылдау критерийлерін бірдей ұстаңыз, әр тапсырманы қайталаңыз және модель ретін алмастырыңыз. Бір ғана жауапқа сүйенбей, сәтті нәтижелер, өткен уақыт, төленген токендер және қайта әрекеттер бойынша салыстырыңыз.
Қорытынды
Жиі орындалатын, тексерілетін жұмыс ағымдары үшін, төмен токен бағасы мен жылдамырақ аяқтау маңызды болғанда GPT-6.1 Terra-дан бастаңыз. Қиын кодтау, көпқадамды құрал пайдалану немесе сәтсіздіктің қымбаттығы жоғары пайымдау қабілетін құнды еткенде GPT-6.1 Sol-ды бағалаңыз. Соңғы таңдау бағаға немесе бір ғана бенчмаркке емес, өкілді бағалау жиынында қабылданған тапсырмаға шаққандағы шығынға негізделуі тиіс.
Көптеген қолданбалар үшін пайдалы келесі қадам — анық өту шарттары және шектелген эскалация маршруты бар шағын, өкілді сынақ. Модельді бағаға немесе бір бенчмаркке сүйенбей, өлшенген нәтиже таңдасын.