
Қысқаша
Kimi K3 ашық салмақты, бірақ жұмыс станциясы деңгейінде емес: нативті модельді қызмет көрсету үшін деректер орталығы деңгейіндегі GPU-лар және таратылған жад қажет. Өндірістік іске қосудың ең тікелей жолы ретінде vLLM қолданыңыз, ал топология, сарапшылар параллелизмі және кэш басқаруы маңызды болғанда SGLang таңдаңыз. Қауымдастықтың GGUF құрастырмалары аппараттық талапты төмендетеді, бірақ шамамен 500 ГБ-тан 1 ТБ-тан да көп адрестелетін жадты қажет етеді және іске асыру мүмкіндігі үшін жылдамдықты немесе сапаны құрбан етеді. Қарапайым ПК мен Mac үшін алдымен хостингтегі API арқылы сынап көру, ал құпиялылық, тұрақты жүктеме немесе инфрақұрылымды басқару шығынды ақтағанда ғана өзін-өзі хостинг ету орынды.
Kimi K3 деген не?
Kimi K3 — Moonshot AI-дың ұзақ көкжиекті кодтау, агенттік білім жұмысы, пайымдау және визуалды түсіну үшін нативті мультимодальды флагмандық ашық салмақты моделі.
Moonshot оны әлемдегі алғашқы ашық 3T класты модель ретінде сипаттайды. Оның архитектурасы Kimi Delta Attention және Attention Residuals элементтерін әр токен үшін сарапшылардың тек бір бөлігін таңдайтын сирек MoE дизайнымен біріктіреді.
Масштабы тіпті фронтир-модельдер үшін де әдеттен тыс. Барлық 2.8T параметр әр токен үшін белсендірілудің орнына, K3 896 маршрутталған сарапшының ішінен 16-сын және ортақ сарапшыларды таңдайды. Бұл токенге шаққандағы есептеуді едәуір азайтады, дегенмен барлық модель салмақтары бәрібір инференс жүйесінде бір жерде қолжетімді болуы тиіс.
| Спецификация | Kimi K3 — ресми модель сипаттамалары |
|---|---|
| Архитектура | Mixture-of-Experts |
| Жалпы параметрлер | 2.8T |
| Белсендірілетін параметрлер | 104B |
| Сарапшылар | 896 |
| Токенге таңдалатын сарапшылар | 16 |
| Контекст ұзындығы | 1,048,576 токен |
| Көру энкодері | MoonViT-V2 |
| Нативті кванттау | MXFP4 weights / MXFP8 activations |
| Ресми модель-карт модальділігі | Мәтін + сурет |
K3 төмен дәлдіктегі қызмет көрсетуді тек оқытудан кейінгі қысу қадамы ретінде емес, SFT кезеңінен бастап кванттаудан хабардар оқытуды қолданады.
Оның архитектурасы өте ауқымды қызмет көрсетуге оңтайландырылған — бірақ “сирек есептеуді” “шағын жад ізімен” шатастырмаңыз. Әр токен үшін желінің тек бір бөлігі есептейді, алайда толық сарапшылар пулы бәрібір қолжетімді болуы керек.
Kimi K3 қалай жұмыс істейді?
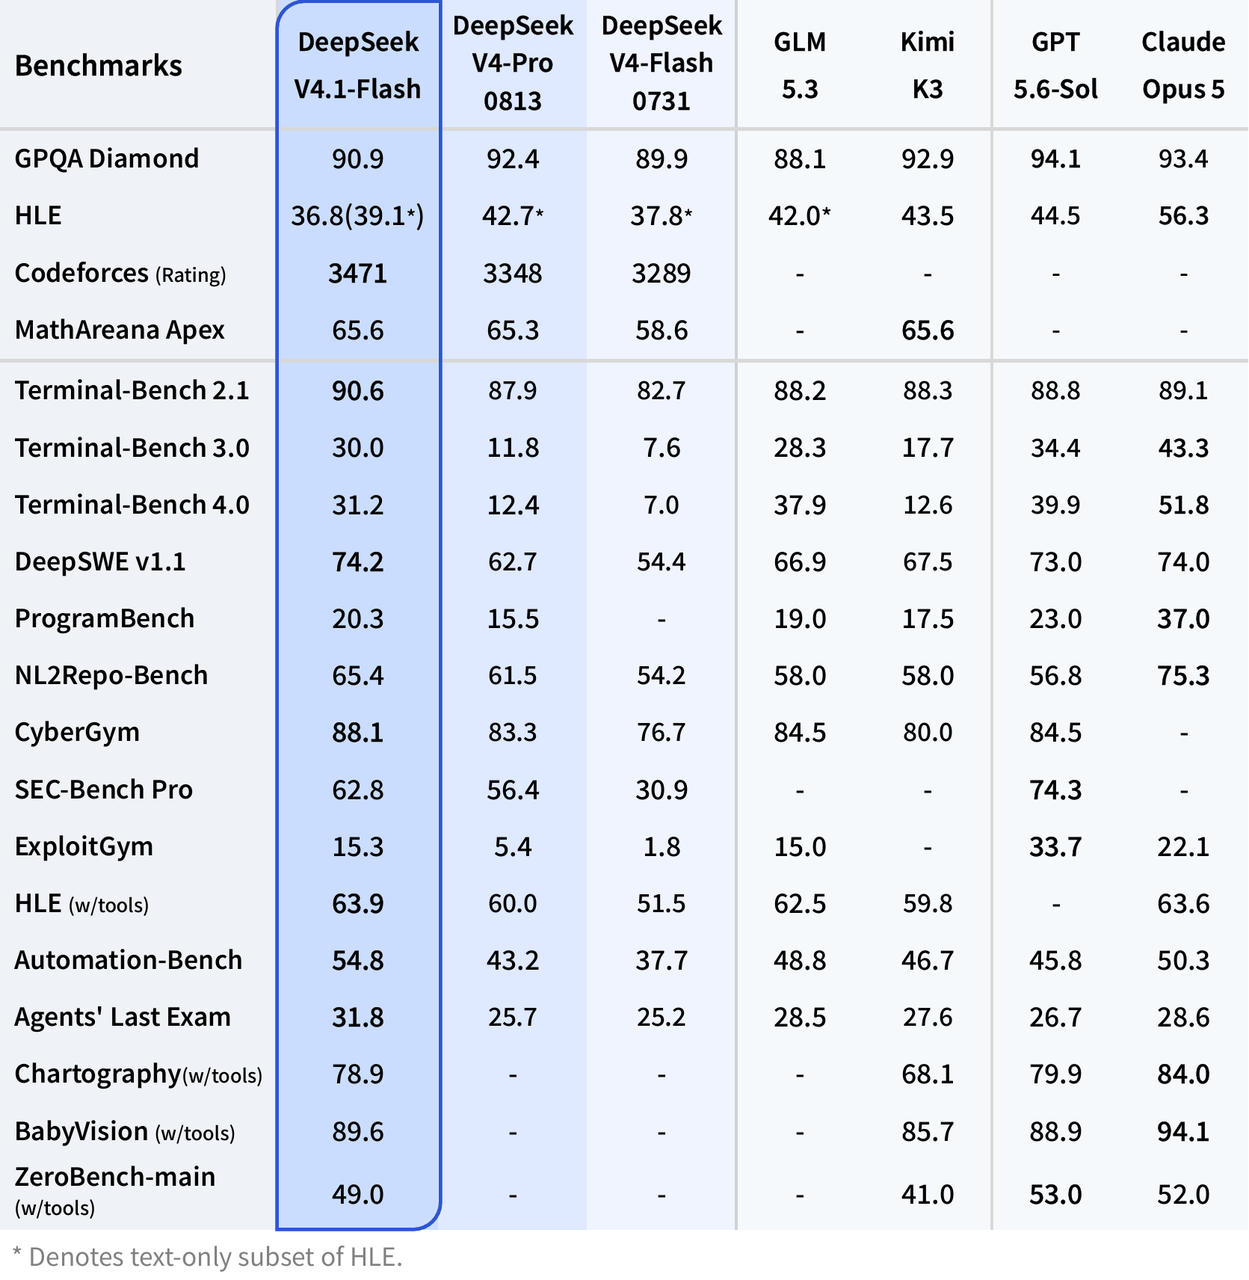
Moonshot-тың ресми Kimi K3 бенчмарк жинағы модельді, әсіресе ұзақ көкжиекті бағдарламалық инженерия және агенттік жұмыс жүктемелерінде, жетекші меншікті фронтир-модельдерге жақын орналастырады.
Төмендегі таңдау пайымдау, кодтау, агенттер және көру салаларын қамтиды. Барлық көрсеткіштер үшін жоғарырақ — жақсырақ.
| Бенчмарк — Moonshot ресми нәтижелері | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 | 91.0 |
| ProgramBench | 77.8 | 77.6 | 76.8 | 71.9 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 | 84.6 |
| FrontierSWE | 81.2 | 71.3 | 86.6 | 66.7 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 | 40.0 |
| BrowseComp | 91.2 | 90.4 | 88.0 | 84.3 |
| OmniDocBench | 91.1 | 85.8 | 89.8 | 87.9 |
| PerceptionBench | 58.5 | 59.7 | 57.2 | 47.2 |
Ресми көрсеткіштер Kimi K3-ті пайымдау, кодтау, агент және көру тапсырмаларында GPT-5.6 Sol, Claude Fable 5 және Claude Opus 4.8 модельдеріне жақын қояды. Бұл провайдер жариялаған нәтижелерді әмбебап рейтинг емес, қабілет контексті ретінде қарастырыңыз; егжей-тегжейлі бенчмарк талдауы бөлек қамтылады. Бұл нұсқаулық үшін операциялық түйін — өзін-өзі хостинг фронтир деңгейіндегі қабілет пен инфрақұрылымды бақылау береді, бірақ ол арзан үстелдік қысқа жол емес.
Kimi K3-ті шынымен локалды іске қосуға болады ма?
Иә, бірақ “локалды” дегеннің екі өте әртүрлі анықтамасы бар.
Жергілікті сервер / жеке деректер орталығы: шынайы.
Қалыпты үстелдік немесе ноутбук: қауымдастықтың агрессивті квантталған құрастырмаларымен техникалық тұрғыдан тәжірибе жасауға болады, бірақ интерактивті пайдалану үшін әдетте практикалық емес.
Ағымдағы vLLM Kimi K3 рецепті өте жоғары базаны қояды:
- NVIDIA: кемінде 8× GB300
- AMD ROCm: кемінде 8× MI355X немесе MI350X
- NVIDIA драйвері: ағымдағы CUDA 13 K3 бейнесі үшін R580+
- Нақты өндірістік трафик үшін көптүйінді инфрақұрылым ұсынылады
Бастапқы vLLM day-0 нұсқаулығы да 8-GPU B300 немесе 8-GPU MI355X жедел бастау жолын көрсетті. Жаңа өндірістік развертывание үшін жаңа рецепті ұстаныңыз, өйткені ол іске қосу күнінен кейінгі қызмет көрсету стек оптимизацияларын көрсетеді.
Негізгі ой: K3 ашық салмақты, бірақ тұтынушылық деңгейдегі ашық модель емес.
Ресми салмақтар vs қауымдастық GGUF кванттаулары
Аппараттық шекті төмендетудің тағы бір жолы бар: қауымдастық кванттауы.
Ағымдағы Unsloth K3 репозиториясы llama.cpp-мен үйлесімді бірнеше GGUF нұсқаларын ұсынады.
Консолидацияланған салыстыру. Адрестелетін жад көрсеткіштері — жоспарлау бағалаулары (жүктеу өлшемі плюс шамамен 10–15% орындау уақыты қоры), кепілдік емес; контекст, кэш, көру және оффлоад параметрлері көбірек қажет етуі мүмкін.
| Нұсқа | Жүктеу | Ұсынылатын адрестелетін жад | Көру қолдауы | Құжатталған орындау уақыты | Мақсаты / сапа дәлелі |
|---|---|---|---|---|---|
| UD-Q1_0 | 466 ГБ | ≥520 ГБ | Репозиторий көру қолдауын мәлімдейді; сәйкес рантайм жолын тексеріңіз. | Unsloth llama.cpp PR fork; Ollama бағыты құжатталған, нұсқа бекітілмеген. | Дәлел-ұғым; нұсқаға тән тәуелсіз сапа сынағы келтірілмеген. |
| UD-TQ1_0 | 509 ГБ | ≥570 ГБ | Сол репозиторий деңгейіндегі көру caveat. | Сол құжатталған рантайм бағыты. | Агрессивті 1-бит класты эксперимент; нұсқаға тән тәуелсіз сынақ жоқ. |
| UD-IQ1_S | 594 ГБ | ≥665 ГБ | Сол репозиторий деңгейіндегі көру caveat. | Сол құжатталған рантайм бағыты. | Экстремалды локалды эксперимент; нұсқаға тән тәуелсіз сынақ жоқ. |
| UD-IQ1_M | 649 ГБ | ≥730 ГБ | Сол репозиторий деңгейіндегі көру caveat. | Сол құжатталған рантайм бағыты. | Жоғарырақ сапалы 1-бит компромисс; тәуелсіз сынақ жоқ. |
| UD-IQ2_XXS | 711 ГБ | ≥800 ГБ | Сол репозиторий деңгейіндегі көру caveat. | Сол құжатталған рантайм бағыты. | 2-бит класты эксперимент; тәуелсіз сынақ жоқ. |
| UD-Q2_K_XL | 861 ГБ | ≥970 ГБ | Сол репозиторий деңгейіндегі көру caveat. | Сол құжатталған рантайм бағыты. | Үлкен CPU/GPU сервер; тәуелсіз сынақ жоқ. |
| UD-Q4_K_XL | 1.51 ТБ | ≥1.7 ТБ | Сол репозиторий деңгейіндегі көру caveat. | Бұл нұсқа үшін тікелей llama.cpp және Ollama мысалдары құжатталған. | Сапарға бағытталған GGUF қызмет көрсету; тәуелсіз K3 кванттау бенчмаркі жоқ. |
| UD-Q8_K_XL | 1.56 ТБ | ≥1.75 ТБ | Сол репозиторий деңгейіндегі көру caveat. | Сол құжатталған рантайм бағыты. | Жақын шығынсыз қауымдастық құрастырмасы; Q4-ке қарағанда сақтау артықшылығы аз. |
Бұл айырмашылық кейбір ерте локалды развертывание мақалаларының 594 ГБ көрсетуін де түсіндіреді: 594 ГБ қазір қауымдастықтың UD-IQ1_S GGUF құрастырмасына сәйкес келеді, ол ағымдағы нативті чекпоинттің толық сипаттамасы емес.
466–649 ГБ модель бастапқы орналастыру ізінен айтарлықтай кіші, бірақ ол жұмыс станциялары үшін бәрібір орасан. Сонымен қатар іске қосу күйі, контекст, кэштер, көру проекторы, операциялық жүйе процесдері және басқа үстеме шығындар үшін жад қалдыру қажет.
Дискі сыйымдылығы инференс жадымен бірдей емес. 1 ТБ SSD болуы 64 ГБ RAM-ы бар машинада 600 ГБ модель жылдам жұмыс істейді дегенді білдірмейді. SSD-ге оффлоад экстремалды экспериментті техникалық түрде мүмкін ете алады, бірақ токен генерациясы өте баяу болуы мүмкін.
Kimi K3-ті vLLM арқылы қалай развертывание жасауға болады
Салмақты өзін-өзі хостинг үшін vLLM — ең тікелей бастау нүктесі.
Moonshot қазіргі уақытта vLLM-ды K3 инференс қозғалтқыштарының бірі ретінде ұсынады, және vLLM KDA, MXFP4 MoE, reasoning парсингі, құрал шақыру, префикс кэштеу және таратылған развертывание үшін модельге тән қолдау береді.
Алғышарттарды тексеріңіз
NVIDIA өндірістік развертывание үшін ағымдағы тексерілген рецепт vllm/vllm-openai:kimi-k3 контейнерін пайдаланады.
GPU-ларды тексеріңіз:
nvidia-smi
Docker-ды растаңыз:
docker --version
NVIDIA Container Toolkit үдеткіштерді көретінін растаңыз:
docker run --rm --gpus all nvidia/cuda:13.0.0-base-ubuntu24.04 nvidia-smi
Егер соңғы команда барлық GPU-ларды көрмесе, көп терабайттық модельді жүктемес бұрын хост/контейнер GPU рантаймын жөндеңіз.
Hugging Face токенін орнатыңыз
Егер модель репозиториясына аутентификация қажет болса, токенді скрипттерге қатты кодтаудың орнына оны орта айнымалысына сақтаңыз.
export HF_TOKEN="YOUR_HUGGING_FACE_TOKEN"
K3 vLLM контейнерін тартыңыз
docker pull vllm/vllm-openai:kimi-k3
Ағымдағы рецепт CUDA 13 құрастырмасын және R580 немесе жаңарақ NVIDIA драйверін көрсетеді.
Kimi K3-ті іске қосыңыз
Ағымдағы Blackwell TP8 бастапқы шаблоны (vLLM рецепті 2026-09-10 жаңартылды): мұны базалық ретінде қолданыңыз, содан кейін дәл сіздің аппараттық құралдарыңыз және трафигіңіз үшін профильді қайта жасаңыз немесе бенчмарк жасаңыз.
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  vllm/vllm-openai:kimi-k3 \
  --model moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --gpu-memory-utilization 0.95 \
  --kv-cache-dtype fp8 \
  --attention-backend TOKENSPEED_MLA \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --prefix-match-unit 128 \
  --enable-prefix-caching \
  --max-model-len 131072 \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Ағымдағы рецепт K3 CUDA 13 бейнесін және R580 немесе жаңарақ NVIDIA драйверін талап етеді. FP8 KV кэші үйлесімді MLA prefill/decode бэкендімен жұпталуы тиіс; назар конфигурациясын өзгертпес бұрын баламаларды бенчмарк жасаңыз.
Дереккөз: vLLM Kimi K3 рецепті. Бұл бұрынғы day-0 команданың орнын басады және оны ағымдағы өндірістік рецепт ретінде ұсынады.
Алғашқы валидация үшін максималды модель ұзындығын бірден толық 1,048,576-токен мүмкіндігіне бөлмей шектеуді қарастырыңыз. Ағымдағы vLLM рецепті max-model-len параметрін жұмыс жүктемесіне бейімдеуді нақты ұсынады.
Мысалы:
--max-model-len 131072
Бұл K3-тің архитектуралық контекст шегін өзгертпейді. Бұл тек қызмет көрсету қозғалтқышына бастапқы сынақтарыңыз үшін басқарылатын жұмыс аясын береді.
Локалды эндпойнтты тексеріңіз
vLLM 8000 портына OpenAI-мен үйлесімді API жариялайды.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [
      {
        "role": "user",
        "content": "Explain the difference between tensor parallelism and expert parallelism."
      }
    ],
    "max_tokens": 512
  }'
Немесе OpenAI Python SDK қолданыңыз:
python
from openai import OpenAI

 client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY",
    timeout=3600,
 )

response = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=[
        {
            "role": "user",
            "content": "Write a Python function that validates a JSON schema.",
        }
    ],
    max_tokens=1024,
 )

print(response.choices[0].message.content)
Ресми vLLM рецепті localhost OpenAI-мен үйлесімді үлгіні қолданады, бұл қосымшаны локалды және хостингтегі инференс арасында салыстырмалы түрде оңай ауыстыруға мүмкіндік береді.
Kimi K3-ті SGLang арқылы қалай развертывание жасауға болады
SGLang — Moonshot ресми ұсынатын тағы бір негізгі развертывание маршруты.
Бұл әсіресе таратылған қызмет көрсетуді тереңірек басқару, сарапшылар параллелизмі, аппаратқа тән ядролар немесе күрделі өндірістік топология қажет болғанда маңызды.
Арналған SGLang Kimi K3 Cookbook пайдаланып, аппаратқа тән топологияны таңдаңыз. Төменде cookbook-тен тексерілген біртүйінді 8×B300 Unified/Balanced профилі келтірілген; ол SGLang v0.5.18 және 71de97b2 коммитімен өлшенген.
K3-ті қолдайтын құрастырманы орнатыңыз:
pip install --upgrade pip
pip install uv
uv pip install --prerelease=allow sglang
Тексерілген B300 TP8/DCP8 профилін іске қосыңыз:
sglang serve \
  --trust-remote-code \
  --model-path moonshotai/Kimi-K3 \
  --tp-size 8 \
  --dcp-size 8 \
  --mem-fraction-static 0.85 \
  --mamba-full-memory-ratio <value-from-official-calculator> \
  --reasoning-parser kimi_k3 \
  --tool-call-parser kimi_k3 \
  --host 0.0.0.0 \
  --port 30000
--mamba-full-memory-ratio жұмыс жүктемесіне тәуелді: орташа енгізу плюс шығару ұзындығынан оны ресми cookbook арқылы есептеңіз. Бұл B300 топологиясын H100/H200, GB200/GB300, AMD немесе көптүйінді развертывание үшін көшірмеңіз; ол үшін басқа TP/PP/DCP/EP орналасулары қолданылады.
Серверді тексеріңіз:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [{"role": "user", "content": "Give me a five-step debugging plan for a distributed Python application."}]
  }'
Шынайы развертывание үшін дәл SGLang нұсқасында, топологияда, контекст ұзындығында және жоспарланған трафик қоспасында сыйымдылықты, шығыс сапасын және ақаудан қалпына келуді тексеріңіз.
vLLM vs SGLang vs llama.cpp
Инференс қозғалтқышын таңдау негізінен сіздің аппараттық құралдарыңызға және развертывание мақсатына байланысты.
| Развертывание әдісі | Аппараттық класс | Ресми нативті салмақтар | OpenAI-мен үйлесімді API | Таратылған өндірістік қолдау | Орнату жеңілдігі | Ең қолайлы |
|---|---|---|---|---|---|---|
| vLLM | Деректер орталығы GPU кластері | Иә | Иә | Өте жақсы | Орташа | Әдепкі өндірістік таңдау |
| SGLang | Деректер орталығы GPU кластері | Иә | Иә | Өте жақсы | Орташа–Жоғары | Жетілдірілген таратылған қызмет көрсету |
| llama.cpp + GGUF | Үлкен-жадты жұмыс ст./сервер | Қауымдастық кванттау | Иә | vLLM/SGLang-пен салыстырғанда шектеулі | Төмен–Орташа | Локалды эксперименттер |
| Ollama + GGUF | Үлкен-жадты жұмыс ст./сервер | Қауымдастық кванттау | Иә | Негізгі нысана емес | Оңай | Ыңғайлылыққа басымдық беретін сынақ |
| CometAPI | Локалды GPU қажет емес | Хостинг | Иә | Басқарылатын | Өте оңай | K3-классты аппаратсыз әзірлеушілер |
Егер сізде 8-GPU Blackwell/MI35x-классты сервер болса, vLLM-нан бастаңыз.
Егер сіз мамандандырылған таратылған инференс кластерін жобалап, қызмет көрсетуді төмен деңгейде басқарғыңыз келсе, SGLang-ты да бағалаңыз.assistant_message
Егер мақсатыңыз “K3-тің менің аппараттық құралымда орындалатынын дәлелдеу” болса, GGUF плюс llama.cpp әлдеқайда қолжетімді — машинаңызда шынымен ерекше көлемдегі жад болған жағдайда.
Квантталған Kimi K3-ті llama.cpp немесе Ollama арқылы қалай іске қосу керек
Қауымдастықтың Kimi K3 GGUF репозиториясы енді llama.cpp-мен үйлесімді нұсқаларды ұсынады.
Бұл жол нативті салмақты деректер орталығы развертываниесіне қарағанда кіру шегін айтарлықтай төмендетеді, бірақ “айтарлықтай” салыстырмалы: тіпті кіші құрастырмалар жүздеген гигабайт.
macOS немесе Linux жүйесінде llama.cpp орнатыңыз
Ағымдағы GGUF модель картасы келесіні ұсынады:
curl -LsSf https://llama.app/install.sh | sh
Windows-та:
winget install llama.cpp
OpenAI-мен үйлесімді серверді іске қосыңыз
Репозиторий қазір UD-Q4_K_XL-ды мысал ретінде құжаттайды:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
CLI-ді тікелей де іске қосуға болады:
llama cli \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Бұл командалар тікелей ағымдағы Kimi K3 GGUF модель картасынан алынған.
Алайда UD-Q4_K_XL шамамен 1.51 ТБ, сондықтан бұл жұмыс станциясы пайдаланушыларының көбісі бастайтын нұсқа емес. Егер сіздің басымдығыңыз — мүмкіндігінше көп сапаны сақтау емес, жад талаптарын азайту болса, алдымен кіші 1-бит және 2-бит нұсқаларын қарастырыңыз.
Мысалы:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-IQ1_M
Ағымдағы UD-IQ1_M каталогы шамамен 649 ГБ.
649 ГБ модель — бәрібір кәдімгі ноутбук үлгісі емес. Идеалды жағдайда жиі қолжететін модель күйі жылдам жадта болуы керек. SSD-ге ауыр оффлоад экстремалды экспериментті техникалық мүмкін еткенімен, интерактивті жұмыс үшін пайдалы етпеуі мүмкін.
Сол GGUF құрастырмасын Ollama арқылы іске қосыңыз
Ollama — сол GGUF развертывание жолы үшін ыңғайлылық қабаты, дербес төртінші өзін-өзі хостинг әдісі емес.
K3 GGUF репозиториясы Ollama бағытын да ұсынады.
Мысалы:
bash
ollama run hf.co/unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Ollama модельді басқаруды және API тәжірибесін жеңілдетеді, бірақ ол K3-тің жад талаптарын өзгертпейді.
Жүктеушіні llama.cpp-тен Ollama-ға ауыстыру бірнеше жүз гигабайттық кванттауды 24 ГБ GPU моделіне айналдырмайды. Негізгі модель деректері бәрібір сақталуы және қолжетімді болуы тиіс.
Сондықтан Ollama-ны аппараттық айналып өтуден гөрі ыңғайлы рантайм орағышы ретінде қарастыру дұрыс.
Қай Kimi K3 кванттауын таңдау керек?
Эксперименттер үшін таңдау негізінен модель өлшемі мен дәлдігі арасындағы компромисс.
| GGUF кванттау таңдауы | Өлшем | Салыстырмалы жад қысымы | Сапа күтімі | Ұсынылатын қолдану |
|---|---|---|---|---|
| UD-Q1_0 | 466 ГБ | Ең төмен | Ең агрессивті деградация қаупі | Дәлел-ұғым |
| UD-IQ1_S | 594 ГБ | Өте жоғары | Агрессивті | Экстремалды локалды эксперимент |
| UD-IQ1_M | 649 ГБ | Өте жоғары | Жақсырақ 1-бит компромисс | Үлкен-жадты эксперименттік сервер |
| UD-Q2_K_XL | 861 ГБ | Экстремалды | Жақсырақ дәлдік | Үлкен CPU/GPU сервер |
| UD-Q4_K_XL | 1.51 ТБ | Деректер орталығы класы | Жоғарырақ дәлдік | Сапаға бағытталған өзін-өзі хостинг |
| Нативті K3 қызметі | Деректер орталығы класы | Деректер орталығы класы | Көзделген модель мінез-құлқы | Өндіріс |
Маңызды Kimi K3 қызмет көрсету мінез-құлқы
Есте қалдыру оңай K3-ке тән бір іске асыру бөлшегі бар.
K3 сақталған ойлау тарихын қолданады. Moonshot көпбұраңды әңгімелер мен құрал шақыру жұмыс ағындары алдыңғы ассистент хабарламасын толық, reasoning_content және tool_calls қоса, тек көрінетін мазмұнды емес, модельге қайта жіберуі тиіс екенін айтады.
Қарапайым қолданба үлгісі мынадай:
messages = [
    {
        "role": "user",
        "content": "Inspect this project and propose a migration plan.",
    }
 ]

first = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )

assistant_message = first.choices[0].message

 # Preserve the whole message object, not just assistant_message.content.
 messages.append(
    assistant_message.model_dump(exclude_none=True)
 )

messages.append(
    {
        "role": "user",
        "content": "Now identify the riskiest part of that plan.",
    }
 )

second = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )
Бұл әсіресе кодтау агенттері, құрал циклдары және ұзақ автономды сессиялар үшін маңызды.
K3 reasoning-ті қосулы күйде ұстайды және төмен, жоғары және max reasoning effort қолдайды. Қызмет көрсету қабаты осы параметрлерді ашқанда, reasoning effort-ті әрқашан максимумға қоюдың орнына, тағы бір латенттілік/сапа басқаруы ретінде қарастырыңыз.
Локалды Kimi K3 развертываниеын қалай оңтайландыруға болады
1M контекстті бірден бөлмеңіз
K3 1,048,576 токенді қолдайды, бірақ максималды модель мүмкіндігі мен ақылға қонымды сервер конфигурациясы — бөлек нәрселер.
Әзірлеу үшін, мысалы, мынадан бастаңыз:
--max-model-len 131072
Содан кейін тек қолжетімді жадты, бірінші токенге дейінгі уақытты, өткізу қабілетін және күтілетін қатарластықты өлшегеннен кейін контекстті ұлғайтыңыз.
Префикс кэштеуді қосыңыз
Кодтау агенттері жиі репозиторий нұсқаулықтарын, құрал схемаларын, жүйелік промпттарды және ұзын префикстерді қайта қолданады.
vLLM-де:
--enable-prefix-caching
K3-тің гибридті назар архитектурасы префикс кэштеуге арналған арнайы өңдеуді талап етті, ал vLLM оған модельге тән қолдау қосты.
K3 парсерлерін қолданыңыз
Агент жұмыс жүктемелері үшін мына параметрлерді қосыңыз:
--tool-call-parser kimi_k3 \
--reasoning-parser kimi_k3
Бұл құрал шақырулары мен reasoning шығысын K3 қызмет көрсету форматына сәйкестендіріп ұстайды.
Сақтауды жылдам ұстаңыз
Бұл масштабтағы модель бірінші жүктеу, чекпоинт жүктеу, жаңартулар және қалпына келтіру кезінде локалды сақтауға әдеттен тыс қысым жасайды.
NVMe сақтау желіге қосылған баяу дискілерге қарағанда артық. Егер бірнеше машина модель файлдарын бөліссе, модель-кэш топологиясы және желілік өткізу қабілеті инференс архитектурасының бөлігіне айналады.
Тек GPU пайдаланылуын ғана емес, көбірек көрсеткіштерді бақылаңыз
Қадағалаңыз:
- HBM/VRAM пайдаланылуы
- CPU RAM
- кэш хит коэффициенті
- бірінші токенге дейінгі уақыт
- декод токен/секунды
- сұрау кезегі тереңдігі
- GPU-лар арасындағы байланыс
- түйіндер арасындағы өткізу қабілеті
- құрал шақыру парсингінің сәтсіздіктері
- модель жүктеу уақыты
K3 масштабында көрінген “жақсы” GPU пайдаланылуы қызмет көрсету топологиясының тиімділігін көрсетпеуі мүмкін.
Локалды Kimi K3 vs хостингтегі Kimi K3
Өзін-өзі хостинг командаларға деректер жолын, рантаймды және модель салмақтарын барынша бақылауды береді, сонымен бірге GPU сыйымдылығы, масштабтау, жаңартулар, мониторинг және қалпына келтіру үшін жауапкершілікті жүктейді. Хостинг қолжеткізу инфрақұрылыс жұмысының көп бөлігін алып тастайды және әдетте бағалау немесе өзгермелі сұраныс үшін жылдамырақ жол.
Толық аппараттық және өзін-өзі ақтау талдауы үшін Kimi K3 Self-Hosting vs API оқыңыз. Токен бағалары, кэштеу және K2.7 салыстырулары үшін Kimi K3 бағалау нұсқаулығын пайдаланыңыз. Бұл мақала сондықтан салыстыруды қысқа ұстап, развертывание командаларына, конфигурацияға және ақау жоюға шоғырланады.
Жиі кездесетін Kimi K3 локалды развертывание мәселелері
Модель GPU жадына сыймайды
Бұл ең болжамды сәтсіздік.
Жадты 104B белсендірілетін параметрлерден есептемеңіз. Бұл көрсеткіш токенге шаққандағы есептеуді сипаттайды, қызмет көрсету жүйесі қолжетімді етуі тиіс сарапшы салмақтарының көлемін емес.
Қолдау көрсетілетін таратылған топологияны, кіші GGUF кванттауын немесе хостингтегі сервисті пайдаланыңыз.
CUDA немесе NVIDIA драйвер қателері
Ағымдағы vLLM K3 бейнесі CUDA 13-ке негізделген және хостта R580+ драйверін талап етеді.
Егер хост әлі R575/CUDA 12.9 стекинде болса, оны жаңартыңыз немесе контейнер хост драйверінің сәйкессіздігін түзетеді деп болжамай, vLLM сипаттаған бастапқыдан құрастыру жолын ұстаныңыз.
Алғашқы сұрау өте баяу
Чекпоинт әлі жүктеліп жатқанын, ядролар компиляцияланып жатқанын, кэштер жылынып жатқанын немесе файлдар тартылып жатқанын тексеріңіз.
Көп терабайттық активтерде “сервер процесі басталды” және “модель өндірістік трафикке дайын” бірдей күй емес.
Құрал шақырулары кейде сәтсіз
Ағымдағы vLLM рецепті K3 кейде парсер күтпейтін құрал шақыру формасын шығара алатынын атап өтеді. Өндірістік жүйелер сондықтан құрал шақыру схемаларын валидациялап, барлық генерацияланған шақыруларға соқыр сенудің орнына қайта тырысу логикасын енгізуі тиіс.
Ұзақ әңгімелер тұрақсызданады
Келесі K3 бұрылыстарына толық ассистент хабарламасын — reasoning және құрал ақпаратын қоса — қайтарып отырғаныңызға көз жеткізіңіз.
Жасырын reasoning күйі өрістерін тастау K3 үйренген сақталған-ойлау-тарихы үлгісін бұзуы мүмкін.
Сонымен, Kimi K3-ті локалды түрде орналастырудың ең жақсы жолы қандай?
Тиісті аппараттық құралдары бар ұйымдардың көпшілігі үшін vLLM — ең жақсы алғашқы развертывание жолы. Оның K3-ке арналған арнайы қолдауы, OpenAI-мен үйлесімді API-ы, модельге тән парсерлері, префикс кэштеуі, спекулятивті декодтау қолдауы және ағымдағы аппараттық рецептері бар.
Таратылған инференс инженериясы мен қызмет көрсетуді нақтылы басқару ең маңызды болғанда SGLang таңдаңыз.
llama.cpp плюс қауымдастық GGUF кванттауын тек мақсатыңыз жұмыс станциясы/серверлік эксперименттер болғанда және тіпті 1-бит нұсқалары жүздеген гигабайт болып қалатынын түсінгенде ғана таңдаңыз.
Қалыпты әзірлеуші жұмыс станциясы үшін практикалық қорытынды басқаша: K3-ті үстелге зорлап отырғызу үшін жүздеген гигабайт RAM сатып алмаңыз. Алдымен CometAPI арқылы Kimi K3-ті сынаңыз, өз тапсырмаларыңыздағы пайдасын сандық бағалаңыз және тек құпиялылық, тұрақты пайдалану немесе инфрақұрылымды бақылау экономиканы ақтағанда өзін-өзі хостингке көшіңіз.
ЖҚС
Kimi K3 бір тұтынушылық GPU-да жұмыс істей ала ма?
Шынайы емес. Модель тұтынушылық GPU-лардың VRAM сыйымдылығынан әлдеқайда жоғары. Қауымдастықтың төмен-бит GGUF кванттаулары ізіді айтарлықтай азайтады, бірақ ағымдағы ең кіші нұсқалардың өзі жүздеген гигабайт.
Kimi K3-ті Mac-та іске қоса аламын ба?
GGUF және сақтау оффлоадымен CPU/Apple-Silicon үстінде эксперименттік орындау принципті мүмкін, бірақ интерактивті өнімділік пен жад сыйымдылығы шектеуші факторлар. Әдеттегі MacBook практикалық K3 қызмет көрсету платформасы ретінде қарастырылмауы тиіс.
Kimi K3 Ollama-ны қолдай ма?
Қауымдастық GGUF құрастырмалары Ollama арқылы іске қосылуы мүмкін. Рантайм орнатуды жеңілдетеді, бірақ негізгі жад талаптарын өзгертпейді.
Kimi K3 үшін vLLM немесе SGLang қайсысы жақсы?
Жаңа өндірістік развертывание үшін vLLM оңайырақ. Күрделі таратылған қызмет көрсету топологияларын құратын командалар үшін SGLang тартымды. Екеуі де Moonshot-тың K3 инференс қозғалтқыштары ретінде ұсынылған.
Kimi K3 қанша контекстті қолдайды?
Ресми модель сипаттамасы 1,048,576 токенді қолдайды. Локалды сервер толық контекст терезесін міндетті түрде ашпауы керек; max-model-len төмен орнату бастапқы развертывание және жоғары қатарластық үшін практикалық болуы мүмкін.
Kimi K3 ашық бастапқы ма?
Нақтырақ сипаттама — ашық салмақты. Moonshot модель салмақтарын Kimi K3 лицензиясымен шығарды. Коммерциялық қайта тарату немесе лицензия шарттары маңызды қолданулар алдында лицензияны тікелей қарап шығыңыз.
Локалды GPU-сыз Kimi K3-ті пайдаланудың ең оңай жолы қандай?
Хостингтегі API — ең қарапайым жол. Kimi K3 CometAPI арқылы қолжетімді және OpenAI-мен үйлесімді chat-completions интерфейсін ұсынады, сондықтан қосымша кодыңызды локалды vLLM немесе SGLang серверіне қарсы қолданылатынға жақын ұстай аласыз.