
Жергілікті түрде Qwen3.8-Max іске қосу енді мүмкін, бірақ “Qwen 3.8 Max locally” тіркесіне бір маңызды нақтылау қажет. Alibaba-ның орналастырылған Max өнімі мен жүктеп алынатын checkpoint өзара тығыз байланысты, алайда бірдей өнімдер емес.
Qwen алғаш рет орналастырылған Max қызметін 2026 жылғы тамыз айының басында іске қосты және 2026 жылғы тамыздың 12-інде Qwen3.8-2.4T-A95B-ті ашық салмақтар ретінде шығарды. Дәл осы checkpoint — сіз өз инфрақұрылымыңызда нақты орналастыратын модель.
Бұл кәдімгі “ойын компьютеріндегі Ollama” нұсқаулығы емес. Квантталмаған checkpoint — 2.4 триллион параметрлі Мамандар қоспасы (MoE) моделі, ал ағымдағы vLLM рецепті оның BF16 салмақтарының көлемін 4.45 TiB деп есептейді. Тіпті өндіріске бағытталған 4-биттік қалқымалы нүктелік нұсқалар да шамамен 1.3–1.5 TiB салмақ алады.
Қысқа жауап: толық Qwen 3.8 Max класты өзіндік хостинг — деректер орталығы деңгейіндегі орналастыру. Ықтималды өндірістік бастау нүктесі — 8× B300 немесе 8× MI355X GPU-ларындағы FP4 checkpoint; H200 орналастыруларына көбірек GPU қажет. Қалыпты жұмыс станциясы үшін Qwen3.8-27B пайдаланыңыз.
Сіз нақты орналастыратын ашық модель мен Qwen 3.8 Max салыстыруы
Жүктеп алынатын Qwen3.8-2.4T-A95B checkpoint ресми түрде 2.4T параметрлі каузалды тілдік модель ретінде сипатталады, токен сайын шамамен 95B параметр белсендіріледі. Орналастырылған Max қызметі ағымдағы ашық checkpoint-те жоқ өнімдік деңгейдегі мүмкіндіктерді қосады.
| Спецификация | Qwen3.8-Max орналастырылған қызметі | Qwen3.8-2.4T-A95B ашық checkpoint-і |
|---|---|---|
| Жалпы параметрлер | 2.4T | 2.4T |
| Белсенді параметрлер | ~95B | ~95B |
| Архитектура | Sparse MoE | Sparse MoE |
| Енгізу | Мәтін, кескін, бейне | Мәтін |
| Контекст | 1M басқарылатын контекст | 262,144 табиғи; ~1.01M дейін кеңейтіледі |
| Ойлау режимі | Басқарылатын ойлау / ойлаусыз опциялар | Ойлау міндетті; пайымдау күшін баптауға болады |
| Кіріктірілген құралдар | Басқарылатын қызметте қолжетімді | Құралдарды қолданба өзі ұсынуы тиіс |
| Өзіндік орналастыру | Салмақтарды басқару қажет емес | Иә; ашық checkpoint |
Орналастырылған өнім 1,000,000 токендік контекстпен мәтін, кескін және бейне енгізуді ұсынады. Ал ашық checkpoint тек мәтінмен жұмыс істейді және оның табиғи контексті 262,144 токен. Егер сіздің қолданбаңыз мультимодальды енгізуге немесе басқарылатын кіріктірілген құралдарға сүйенсе, бұл айырмашылық маңызды.
Qwen 3.8 архитектурасы мен сипаттамалары
CometAPI “Qwen3.8 Max деген не” бөлімінде модельдің негізін қамтып қойған, сондықтан бұл орналастыру нұсқаулығы архитектураны жад, параллелизм және сервингке әсер ететін бөлшектер тұрғысынан ғана қарастырады.
| Орналастыруға қатысты спецификация | Qwen3.8-2.4T-A95B |
|---|---|
| Жалпы / белсенді параметрлер | 2.4T / ~95B токен сайын |
| Қабаттар құрамы | 92 қабат: 69 Gated DeltaNet + 23 толық назар |
| MoE бағыттауы | 512 бағытталған эксперт; 10 бағытталған + 1 ортақ белсенді |
| Толық назар бастары | 64 сұрау / 4 кілт-мағына бастары |
| Табиғи контекст | 262,144 токен |
| Кеңейтілген контекст | Шамамен 1,010,000 токенге дейін |
| Көп-токенді болжау | Қолдау бар |
| Ашық checkpoint модальдылығы | Тек мәтін |
Ресми Qwen гибридті модель архитектурасы SGLang Qwen3.8 орналастыру нұсқаулығында қолданылған.
“95B белсенді параметр” дегенді 95B-модельдің жад ізі ретінде түсінбеңіз. Сирек белсендіру әр токенге есептеуді азайтады, бірақ сервинг жүйесіне толық эксперт салмақтар жиынына қол жеткізу бәрібір қажет.
Qwen 3.8 Max бенчмарк шолуы
CometAPI-дің Qwen3.8 Max шолуы бенчмарктерді егжей-тегжейлі қарастырғандықтан, бұл мақала ресми Qwen модель карточкасындағы бенчмарк кестесінен тек орналастыруға қатысты ішкі жиынды пайдаланады.
| Бенчмарк | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
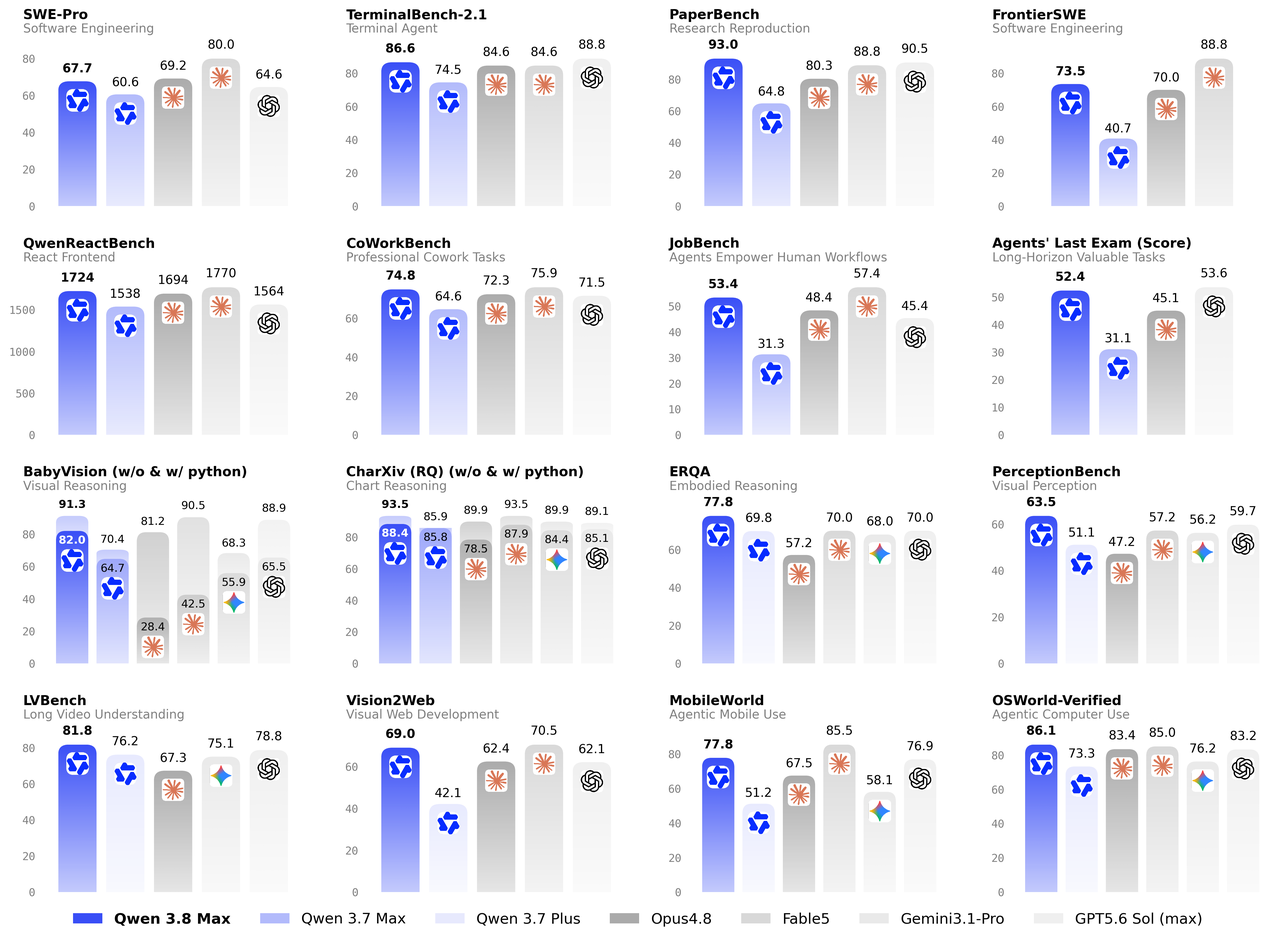
Qwen командасы жариялаған ресми Qwen3.8 өнімділік графигі осында.
Осы ішкі жиында Qwen3.7-Max-пен салыстырғандағы ең үлкен өсім PaperBench және FrontierSWE-де. Qwen3.8-Max сонымен қатар SWE-bench Pro және PaperBench-де GPT-5.6 Sol-дан асып түседі, ал GPT-5.6 Sol Terminal Bench 2.1-де әлі алда. Орналастыру шешімдері үшін бұларды қабілет контексті ретінде қарастырыңыз; төмендегі жад пен сервинг өткізу қабілеті өлшемдері операциялық тұрғыдан маңыздырақ.
Бенчмарк кестелері әмбебап рейтингтер емес. Аспаптар, таймауттар, контекст шектері, құралдарға қол жеткізу және кванттау нәтижелерді өзгерте алады. Қолданбақ нақты checkpoint-ті, дәлдікті, сервинг қозғалтқышын және промпт үлестірімін өзіңіз бенчмарктаңыз.
Qwen3.8-ді жергілікті орналастыруға қандай “темір” керек?
Qwen3.8-2.4T-A95B үшін GPU талаптары
Бұл — басты орналастыру сұрағы. Ағымдағы vLLM Qwen3.8 рецепті checkpoint іздерін және орындалу барысында қажетті қорымен шынайы GPU санын жариялайды — бұл тек параметр саны бойынша VRAM-ды бағалаудан пайдалырақ.
| Дәлдік | Салмақ ізі | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Ең қолайлы |
|---|---|---|---|---|---|
| BF16 | 4.45 TiB | 24 GPU | 24 GPU | 48 GPU | Ең жоғары дәлдік / зерттеу |
| FP8 | 2.27 TiB | 16 GPU | 16 GPU | 32 GPU | Жоғары дәлдікті продакшн |
| MXFP4 | 1.45 TiB | — | 8 GPU | 16 GPU | AMD үшін практикалық орналастыру |
| NVFP4 W4A4 | 1.32 TiB | 8 GPU | — | 16 GPU | NVIDIA үшін практикалық орналастыру |
Qwen3.8-ді шын мәнінде өзіндік хосттауды қажет ететін ұйымдардың көбісі үшін FP4 — практикалық бастау нүктесі. NVIDIA жағындағы үздік конфигурация — 8× B300-дегі NVFP4 W4A4; AMD үшін сәйкес жол — 8× MI355X-тегі MXFP4.
8× H200 сервері бұл ұсынылатын толық модель орналастырулары үшін жеткіліксіз. Ресми рецепт H200-ды FP4 үшін 16 GPU, FP8 үшін 32 GPU және BF16 үшін 48 GPU деп мөлшерлейді.
Qwen3.8-27B үшін VRAM талаптары
Qwen3.8-27B — практикалық жұмыс станциясына арналған балама. Шикі салмақ жады шамамен BF16-де 54 GB, FP8-де 27 GB және 4-биттік дәлдікте 13.5 GB. Орындалу үстеме шығындары және KV-кэш нақты қажеттілікті арттырады, әсіресе ұзын контексттерде.
| Дәлдік | Шамаланған салмақ жады | Практикалық орналастыру бойынша нұсқаулар |
|---|---|---|
| BF16 | ~54 GB | Контекст пен сервинг үстемесіне қарай 64–80 GB GPU пайдаланыңыз. |
| FP8 / INT8 | ~27 GB | 40–48 GB GPU шынайы орындалу қорын көбірек қамтамасыз етеді. |
| 4-бит | ~13.5 GB | Орташа контексттерде 20–24 GB тұтынушылық GPU жарамды болуы мүмкін. |
Бұл көрсеткіштер — жоспарлау бағалаулары, параметр санына негізделген. Өндірістік жабдық өлшемін анықтар алдында нақты checkpoint, кванттау форматы, сервинг қозғалтқышы, контекст ұзындығы және KV-кэш параметрлерін растаңыз.
Qwen3.8 тұтынушылық GPU-ларда жұмыс істей ала ма?
Толық Qwen3.8-2.4T-A95B моделін кәдімгі тұтынушылық GPU-ларда, тіпті агрессивті кванттаумен де іске қосу практикалық емес. Қауымдастық жобасы төрт DGX Spark жүйесінде 397 GB UD-Q1_0 шамадан тыс сығылған құрастырылымын көрсеткенімен, бұл — сапаға сезімтал сервингтің базалық нұсқасы емес, эксперименттік шеткі кванттау.
Жұмыс станциясы немесе үй зертханасы үшін анағұрлым лайықты модель — Qwen3.8-27B, оның ашық салмақтары 2026 жылғы тамыздың 14-інде шығарылды. Бұл модельді хосттау әлдеқайда оңай және “жергілікті” бір жұмыс станциясын білдірсе, дұрыс таңдау.
Qwen 3.8 Max-ты орнатпас бұрын
Команда енгізерден бұрын инфрақұрылымды жоспарлаңыз. Linux, үйлесімді акселератор стегі, checkpoint үшін жеткілікті жергілікті немесе ортақ сақтау, жоғары өткізу қабілетті GPU аралық қосылыстары және — тораптар арасында — таратылған инференс үшін желі қажет. vLLM рецепті қазір vLLM nightly және Transformers 5.4.0 немесе жаңарағын ұсынады.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
vLLM арқылы Qwen 3.8-ті FP8 дәлдігінде қалай орналастыруға болады
FP8 — Qwen ұсынған checkpoint қажет болғанда және көп торапты инфрақұрылымды көтере алған жағдайда орынды таңдау. Ресми checkpoint — Qwen/Qwen3.8-2.4T-A95B-FP8.
Екі торапты, 16-GPU B300 класты орналастыру үшін head торабында келесіні іске қосыңыз:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
Жұмысшы торапта (worker) дәл сол топологияны басқа node rank-пен және API серверінсіз пайдаланыңыз:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
16-GPU мысалды H200 серверлеріне топологияны өзгертпей көшірмеңіз. Дәл осы FP8 нұсқасы vLLM рецепті бойынша қазір 32× H200 деп мөлшерленген.
Бір 8× B300 серверінде Qwen 3.8-ті қалай іске қосу керек
NVIDIA Blackwell үшін ең практикалық толық модель конфигурациясы — NVFP4. vLLM қазір NVFP4 W4A4-ті сегіз B300 GPU арасында тензорлық параллелизммен растайды.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Inferact NVFP4 құрастырылымы — бастапқы BF16 Qwen артефакті емес, квантталған checkpoint. Оны BF16 немесе FP8 үшін тікелей алмастырғыш ретінде пайдаланбас бұрын, модель сапасын өзіңіздің қабылдау жиыныңызда растаңыз.
Qwen 3.8-ті SGLang арқылы қалай орналастыруға болады
SGLang Qwen3.8 үшін Day-0 қолдауды тамыздың 12-інде қосты және жоғары өткізу қабілетті сервинг, префикс кэштеу, эксперттік параллелизм, спекулятивті декодтау және префилл/декод бөлуді ұсынғанда ерекше тартымды.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang MTP қосулы TP8 B300-да партия өлшемі 1 болғанда секундына 346 шығыс токенін хабарлайды және дисагрегирленген сервинг схемаларында айтарлықтай жоғары жиынтық өткізу қабілетін көрсетеді. Бұл сандарды модель сапасының бенчмарктары емес, сервинг стегінің өлшемдері ретінде қарастырыңыз.
Жергілікті OpenAI-үйлесімді endpoint-ті сынау
vLLM мен SGLang екеуі де OpenAI-үйлесімді API ұсынады, бұл қолданбаларға біріктіруді жеңілдетеді.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Ресми модель картасы бастапқы үлгілеу параметрлері ретінде temperature=1.0, top_p=0.95 және top_k=20 ұсынады. Агенттік жұмыстар үшін, тек соңғы көрінетін жауапқа емес, ойлауға да жеткілікті шығыс бюджет қалдырыңыз, сондықтан max_tokens мәнін соған сай қойыңыз.
1M контекст терезесін қосу
Qwen3.8-2.4T-A95B ашық checkpoint-інің табиғи контексті 262,144 токен және шамамен 1.01M-ге дейін кеңейтіледі. vLLM рецепті келесі үлгіні құжаттайды:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Қолдау бар деп 1M-ді әдепкі етпеңіз. Ең үлкен максимал контекст көбірек кэш сыйымдылығын резервтейді және бірден параллелділікті күрт төмендетуі мүмкін. --max-model-len параметрін нақты жүктемеге сай мөлшерлеңіз.
Qwen3.8 инференс өнімділігін қалай жақсартуға болады?
Бір пайдаланушы кідірісін азайту үшін MTP-3 пайдаланыңыз
Qwen3.8 Multi-Token Prediction қолдайды. vLLM жариялаған өлшемдерде MTP-3 бір пайдаланушының өнімділігін FP8 TP16 үшін 130-дан 307 tok/s-қа және NVFP4 TP8 үшін 133-тен 304 tok/s-қа дейін жақсартады.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Жылдам іске қосу үшін fastsafetensors қолданыңыз
Терабайт ауқымындағы модельдер үшін іске қосу уақыты маңызды. Бір vLLM өлшемінде fastsafetensors және lazy loading қосылғанда салмақтарды жүктеу 545 с-тан 306 с-қа дейін қысқарған.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Бір уақытта өтетін ағынды арттыру үшін эксперттік параллелизм қолданыңыз
Жоғары параллелділік үшін Qwen3.8 эксперттік параллель схемаларынан пайда көреді, себебі онда 512 бағытталған эксперт бар. vLLM FP8 EP үшін GPU басына 3,200 жалпы tok/s-қа дейін және оңтайландырылған NVFP4 DEP16 конфигурациясында GPU басына 4,300 жалпы tok/s-қа дейін хабарлайды.
VRAM мен параллелділікті теңестіру үшін --max-model-len орнатыңыз
--max-model-len мәнін жүктемеге шын қажет ең ұзын тізбекке қойыңыз. Үлкен мән көбірек KV-кэш сыйымдылығын резервтейді, жад қысымын арттырады және модель салмақтары сыйса да, бір уақытта өтетін сұраулар санын азайтуы мүмкін.
Модельдің ең үлкен жарнамаланған контекстіне емес, өндірістік таралудың өкілдік перцентиліне сүйеніп бастаңыз. Таңдалған шекті дәл сол дәлдік, батч үлгісі және өндірісте қолданылатын сервинг қозғалтқышымен жүктемелік тесттен өткізіңіз, содан кейін нақты сұраулар көбірек контекст талап еткенде ғана көтеріңіз.
Qwen 3.8 Max жергілікті орналастыру ма, әлде API ме?
Ашық салмақтар жергілікті инференсті автоматты түрде үнемді етпейді. Дұрыс шешім пайдалану деңгейіне, деректердің орналасуына, штатқа, қолжетімділік мақсаттарына және сізге шынымен де басқарылатын модельдің мультимодальды мүмкіндіктері қажет пе соған байланысты.
| Өлшем | Өзіндік Qwen3.8-2.4T-A95B | CometAPI арқылы Qwen3.8-Max |
|---|---|---|
| Инфрақұрылым | Көп-GPU сервер немесе кластер | GPU инфрақұрылымы қажет емес |
| Енгізу модальдылығы | Мәтін | Мәтін, кескін, бейне |
| Контекст | 262K табиғи; ~1.01M кеңейтілген | Басқарылатын 1M |
| Деректерді бақылау | Ең жоғары | Бұлттық API |
| Операциялар | Мониторинг, жаңартулар және HA сізде | Провайдер басқарады |
| Ең қолайлы | Деректердің орналасуы, тұрақты жүктеме, инфрақұрылым командасы | Көпшілік қолданба командалары және айнымалы жүктемелер |
Егер сізде тиісті акселераторлар бар және пайдалану тұрақты жоғары болса, өзіндік хостинг өзін ақтай алады. Егер сіз бұл модель үшін ғана кластер сатып алатын болсаңыз, CometAPI-дегі Qwen3.8-Max әдетте аз үйкелісті жол. Бар API нұсқаулығы орналастырылған интеграцияны қамтиды, ал баға нұсқаулығы шығынды модельдеуді қамтиды; сондықтан бұл мақала жергілікті орналастыруға шоғырланады.
Qwen 3.8 жергілікті орналастырудағы жиі мәселелер
Сервер іске қосу кезінде GPU жадынан шығып кетеді
Егер мәселе кэште болса, алдымен --max-model-len мәнін азайтыңыз. Егер салмақтар өздері сыймай жатса, контекстті азайту түбірлі мәселені шешпейді; расталған төмен дәлдікті checkpoint-ке өтіңіз немесе GPU санын арттырыңыз.
Тензорлық параллелизм қате өлшеммен сәтсіз аяқталады
Qwen3.8 толық назар қабаттарында 64 назар басы бар, сондықтан vLLM TP-нің 64-ке бөлінуін талап етеді. Қарапайым TP өлшемдері — 1, 2, 4, 8, 16 және 32. Тек жиынтық VRAM жеткілікті дегенмен, бұл топологияны таңдауға жеткіліксіз.
Сервердің іске қосылуы ұзаққа созылады
Бірнеше терабайт салмақтарды жүктеу және ядроларды JIT компиляциялау минуттар алуы мүмкін. VLLM_ENGINE_READY_TIMEOUT_S мәнін арттырыңыз және қысқа іске қосу терезесін болжамай, шынайы инференс endpoint-ін тексеріңіз.
Жергілікті модель кескінді өңдей алмайды
Бұл — күтілетін жағдай. Qwen3.8-2.4T-A95B ашық checkpoint-і тек мәтінге арналған. Бұл шектеу Qwen3.8-2.4T-A95B-ке тән. Qwen3.8-27B бөлек vision projection файлдары жүктелгенде визуалды енгізуді қолдайды.
1M контекст өткізу қабілетін айтарлықтай төмендетеді
--max-model-len мәнін жүктемеге шын қажет ең ұзын тізбекке дейін азайтыңыз. Ең үлкен қолдау көрсетілген контекст терезесі әрқашан үздік өндірістік баптама емес; жүктеме талаптары, KV-кэш қолданылуы және параллелділік арасындағы теңгерімді сақтайтын контекст шегін таңдаңыз.
Ollama немесе LM Studio Qwen 3.8 Max-ты іске қоса ала ма?
Экожүйе Qwen3.8-дің қатты квантталған салмақтарын llama.cpp-стиліндегі инференс үшін пакеттерге жинай алады, бірақ бұл қалыпты жұмыс үстеліндегі Ollama жұмыс ағынымен шатастырылмауы тиіс. Жүздеген гигабайтты алатын квантталған құрастырылым әлі де жүздеген гигабайтқа қолжетімді жадты талап етеді және сапа мен өнімділік тұрғысынан елеулі айырбастарға әкеледі.
Кәдімгі жергілікті әзірлеу үшін Qwen3.8-27B — дұрыс нысана. Толық 2.4T модель — тіпті қауымдастықтың экстремалды кванттаулары оны ерекше жабдықта техникалық тұрғыдан жүктелетін етсе де — сервер/кластер үлгісі ретінде қарастырылуы тиіс.
Қай орналастыру әдісін таңдаған дұрыс?
NVIDIA Blackwell үшін қазіргі ең таза толық модель бастау нүктесі — 8× B300-дегі NVFP4. AMD үшін сәйкес практикалық конфигурация — 8× MI355X-тегі MXFP4. Checkpoint түпнұсқалығын және сапасын инфрақұрылым көлемінен жоғары қоятын болсаңыз FP8 пайдаланыңыз, ал BF16 — тек ең жоғары дәлдік көп сөрелі жад талаптарын ақтағанда.
Жұмыс станциясы үшін Qwen3.8-27B пайдаланыңыз. GPU-кластерлік операцияларсыз Max мүмкіндіктері қажет қолданба командалары үшін CometAPI-дегі Qwen3.8-Max орналастырылған моделін қолданыңыз.
Қорытынды
Qwen3.8-Max бастапқы API іске қосылғаннан бері маңызды шектен өтті: Max класты Qwen отбасы енді ұйымдар толықтай өз инфрақұрылымында басқара алатын ашық 2.4T checkpoint-ке ие.
Бірақ ашық салмақтар тұтынушылық жабдық дегенді білдірмейді. 4.45 TiB BF16 ізі, 2.27 TiB FP8 checkpoint-і және 1.3–1.5 TiB FP4 нұсқалары Qwen3.8-2.4T-A95B-ті қолжетімді ашық модельдердің ең инфрақұрылым-қарқындысының біріне айналдырады. Прагматикалық жағынан vLLM және SGLang бұл архитектураны қазірдің өзінде қолдайды, ал FP4 бір торапты 8× B300 немесе 8× MI355X орналастыруын мүмкін етеді.
Егер деректерді бақылау, тұрақты пайдалану және инфрақұрылымға иелік кластерді ақтайтын болса — өзіндік хосттаңыз. Әйтпесе басқарылатын Max API пайдаланыңыз — немесе бір жұмыс станциясында мықты Qwen моделін қаласаңыз, Qwen3.8-27B таңдаңыз.