
Қысқаша
DeepSeek-V4.1-Flash ашық салмақты және өзін-өзі хосттауға болады, бірақ “локалды” дегеніміз “гейминг ПК-де” дегенді білдірмейді. DeepSeek оны Causal Encoder-Decoder архитектурасын қолданатын 552B-параметрлі Mixture-of-Experts арқауы деп сипаттайды, мұнда префилл кезінде 8B, ал генерация кезінде 16B параметр белсенді болады. Толық модель әлі де фронтир ауқымындағы орналастыру нысанасы болып табылады.
Қазіргі vLLM орналастыру рецепті чекпойнтты шамамен дискіде 511 GB және шамамен 614 GB минималды VRAM деп қояды, бұл 8×H200 класты серверді немесе ұқсас жоғары жадты жүйені тұтынушылық жұмыс станциясына қарағанда әлдеқайда шынайы етеді.
Салмақ деңгейінде бақылау қажет емес командалар үшін, көп GPU-лы инференс серверін ұстаудан гөрі CometAPI-дегі DeepSeek V4.1 Flash API айтарлықтай оңай.
Негізгі тұжырымдар
- DeepSeek-V4.1-Flash префилл кезінде 8B, декод кезінде 16B белсенді параметрі бар 552B MoE арқауын қолданады; белсенді параметрлер резидент-жад талаптарын білдірмейді.
- Оның 1,048,576-токен контексті және токенге 890 байттық глобал KV кэші кэш қысымын азайтады, бірақ модель салмақтары әлі де сыйымдылықты жоспарлауда басым рөл атқарады.
- Ресми чекпойнт дискіде шамамен 511 GB. vLLM рецепті модельді және рантайм үстеме шығынын жүктеуге шамамен 614 GB жиынтық қолданбалы VRAM-ды ең төменгі бюджет ретінде бағалайды; бұл әрбір пакет өлшемі, контекст ұзындығы немесе мультимодаль конфигурациясы үшін кепілдік емес, базалық бағалау.
- vLLM — өндірістік сервингтің ең айқын жолы, ал SGLang — алдыңғы қатарлы таратылған инференске бағытталған; Ollama-ның ағымдағы бағыты толық локалды инференстен гөрі бұлтқа негізделген.
- Өзін-өзі хосттау құпиялылық, ауа алмасудан оқшаулану, салмақ деңгейіндегі зерттеу немесе тұрақты кластерлік жүктеме үшін ең тартымды; көпшілік әзірлеушілер үшін хостталған API қарапайымырақ.
DeepSeek-V4.1-Flash деген не? Архитектура, параметрлер және модель өлшемі
DeepSeek 2026 жылғы 10 қыркүйекте V4.1-Flash-ты жаңа архитектуралық отбасындағы ең шағын модель ретінде ресми түрде шығарды, отандық визуалды түсінуімен. “Flash” атауына қарамастан, бұл шағын тығыз модель емес.
Негізгі архитектуралық өзгеріс — Causal Encoder-Decoder (CED) дизайны. Модель есептеуді промптты қабылдау мен токен генерациясы арасында ассиметриялы түрде бөледі, белсенді есептеуді азайта отырып, өте үлкен мамандар пулын сақтайды.
| Сипаттама | DeepSeek-V4.1-Flash |
|---|---|
| Архитектура | Мультимодальды MoE, Causal Encoder-Decoder |
| Арқау параметрлері | 552B |
| Белсенді параметрлер, енгізу | 8B |
| Белсенді параметрлер, шығару | 16B |
| Трансформер қабаттары | 40: 20 энкодер + 20 декодер |
| Контекст терезесі | 1,048,576 токен |
| Глобал KV кэш | токенге 890 байт |
| Модальдар | Мәтін + сурет енгізу, мәтін шығару |
| Салмақ лицензиясы | MIT |
| Ұсынылатын семплинг | Temperature 1.0; top_p 0.95 немесе 1.0 |
| Ресми салмақтар | Hugging Face |
| Негізгі локалды сервинг опциялары | vLLM, SGLang, DeepSeek reference inference |
Белсенді параметрлер мен резидент параметрлер арасындағы айырмашылық өте маңызды. MoE маршрутизациясы жеке токен үшін қолданылатын есептеуді азайтады, бірақ сервер әлі де таңдалуы мүмкін маман салмақтарына қол жеткізе алуы керек. Сол себепті “8B белсенді” модель жүздеген гигабайт сақтау мен акселератор жадын талап ете алады.
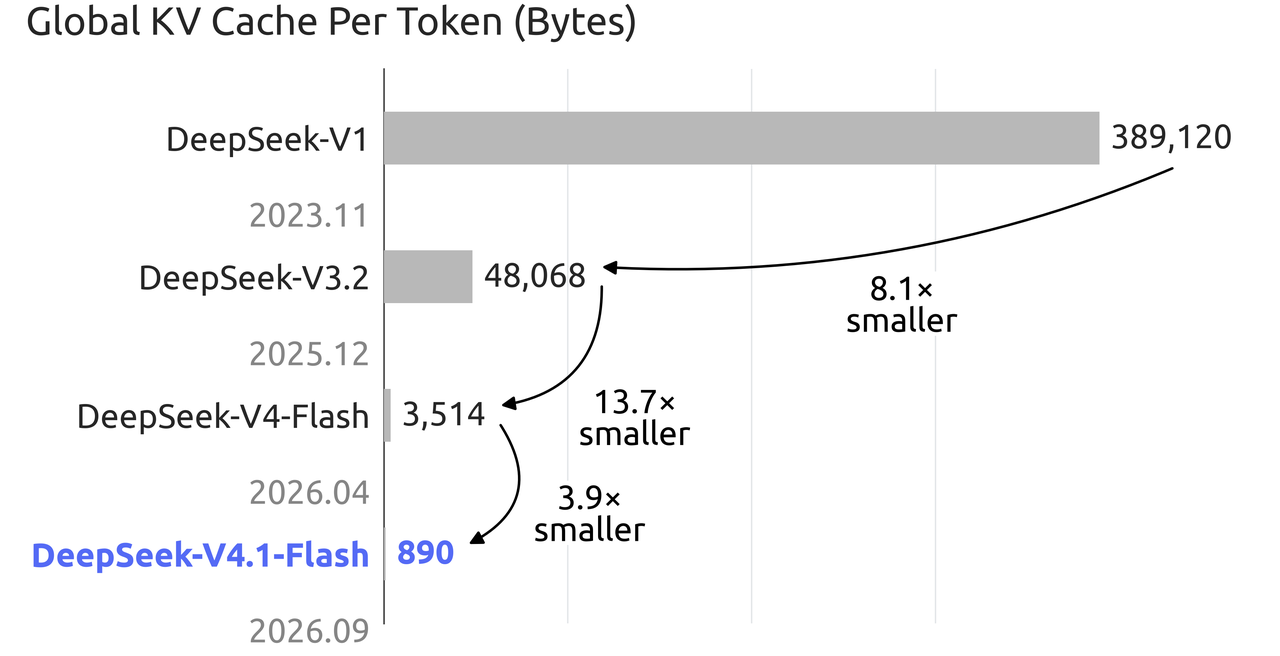
DeepSeek-тің ресми KV-кэш диаграммасы V4 Flash-та токенге 3,514 байттан V4.1 Flash-та токенге 890 байтқа дейінгі глобал кэштің ~3.9× қысқаруын көрсетеді. Бұл миллион токендік инференс үшін маңызды, бірақ ол модель салмақтарының әлдеқайда үлкен жад талаптарын жоймайды.
DeepSeek-V4.1-Flash-тың сапасы қандай? Орналастырмас бұрын
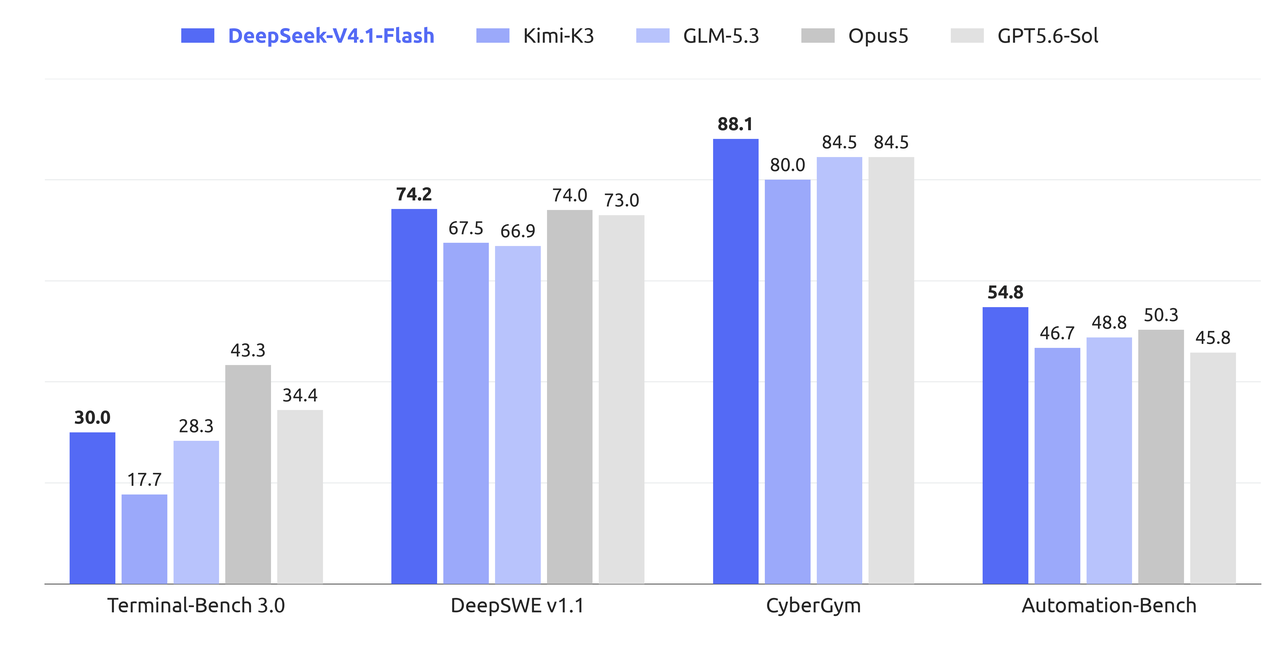
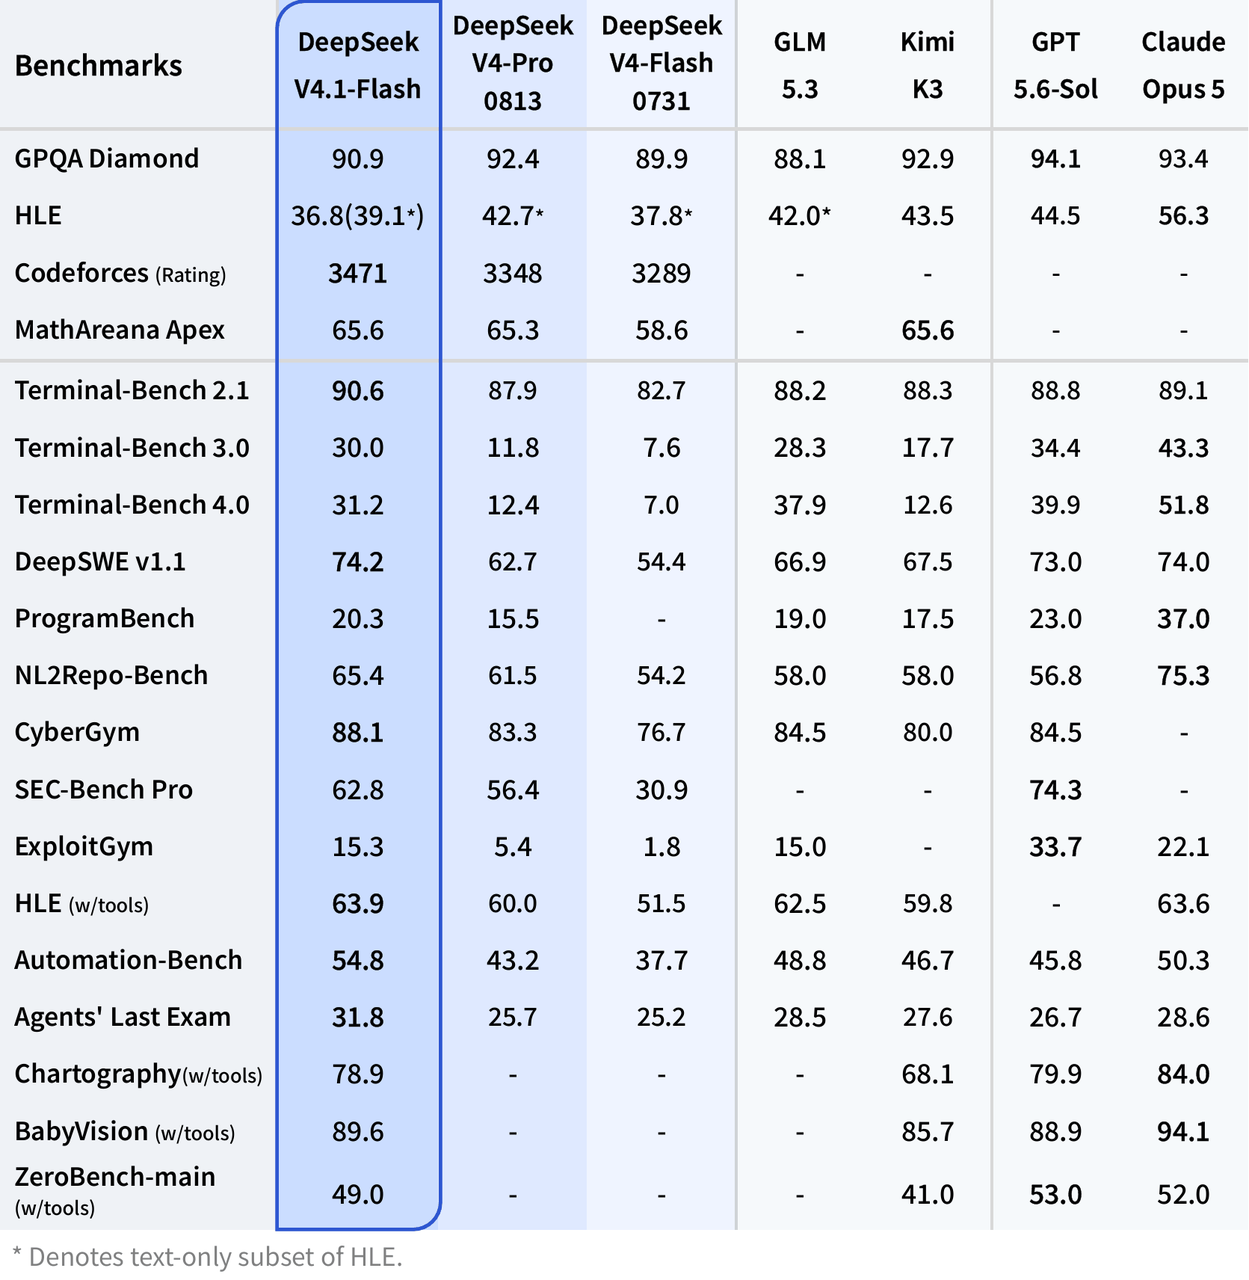
DeepSeek жариялаған бенчмарк кестесі V4.1-Flash-ты негізінен агенттік кодтау, терминал операциясы, автоматтандыру және бағдарламалық инженерия жүктемелерінде үлкен жаңарту ретінде позициялайды. Бұлар вендор жариялаған бенчмарк нәтижелері, сондықтан оларды кепілді қолданбалы өнімділік емес, анықтама өлшемдері ретінде қарастыру керек.
Қайталанымдылық үшін ресми модель картасы temperature 1.0 және top_p 0.95 ұсынады, ал reasoning effort және токен бюджеттері бағалауға байланысты өзгеріп отырады. Төмендегі көрсеткіштер — аппараттық тәуелсіз өнімділік кепілдіктері емес, вендор орындаған анықтамалық нәтижелер; оларды қайта өндіру алдында бенчмаркке тән қоршауларды тексеру қажет.
| Бенчмарк | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Үлгі кез келген бір нәтижеден маңыздырақ. V4.1-Flash барлық бенчмарктерде көш бастамайды, бірақ V4 Flash 0731-мен салыстырғанда Terminal-Bench, DeepSWE, автоматтандыру және киберқауіпсіздік жүктемелерінде секіріс өте үлкен. Бұл жеке кодтау агенттері, репозиторий ауқымды талдау, ішкі автоматтандыру және ауа алмасудан оқшауланған агент инфрақұрылымы үшін локалды орналастыруды ерекше маңызды етеді.
DeepSeek-V4.1-Flash-ты шынымен локалды іске қосуға бола ма?
Иә, бірақ “локалды” сөзі нақтылауды қажет етеді. Соңғы vLLM DeepSeek-V4.1-Flash рецепті чекпойнтты шамамен жарты терабайт деп есептеп, рантайм үстеме шығындарын қосқанда әлдеқайда үлкен VRAM бюджетін ұсынады.
| Компонент | Шамамен сақталатын өлшем |
|---|---|
| Routed + DSpark мамандары | 259.5 GiB |
| Engram кестелері | 183.1 GiB |
| Назар, тығыз проекциялар және роутерлер | 6.9 GiB |
| Эмбеддингтер, LM head және нормалар | 3.9 GiB |
| UE8M0 блок шкалалары | 21.9 GiB |
| Толық чекпойнт | ~476 GiB / ~511 GB |
| vLLM ұсынатын минималды VRAM бюджетті | ~614 GB |
Негізгі тосынсый — V4.1-Flash ішінен-ақ қатты қысылған. Routed маман салмақтары төмен дәлдікті форматтарды қолданады, сондықтан ресми чекпойнт “оңай 4-bit конверсияны күтетін” үлкен BF16 модель ғана емес.
DeepSeek-V4.1-Flash аппараттық талаптары
| Аппараттық конфигурация | Практикалық жағдай | Түсініктеме |
|---|---|---|
| 1× RTX 4090 / 5090 | Жоқ | Модельдің жад ізіне айтарлықтай жетпейді |
| 2–4 тұтынушылық GPU | Ресми толық чекпойнт үшін жоқ | Жиынтық VRAM жеткіліксіз |
| 128 GB жұмыс станциясы | Жоқ | Белсенді параметрлер резидент салмақ жадын анықтамайды |
| 256 GB жұмыс станциясы | Ресми сервинг жолы үшін жоқ | Ресми чекпойнт ізіне әлі де едәуір төмен |
| 512 GB жүйелік RAM + GPU offload | Эксперименттік | Қауымдастық/offload деңгейі, тексерілген өндірістік сервингке тең емес |
| 4× жоғары жадты ДЦ GPU | Аппаратқа тәуелді | Қазіргі заманғы жеткілікті үлкен акселератормен мүмкін; рантайм рецептіне қараңыз |
| 8× H200 | Иә, құжатталған класс | Шамамен 1,128 GB жиынтық HBM |
| GB200 NVL4-класс жүйесі | Иә | vLLM 768 GB трейін модельге сай деп келтіреді |
Маңызды: 8B белсенді параметрлер 8 GB VRAM дегенді білдірмейді. “Белсенді” MoE желісінің токен есептеуіне қаншасы қатысатынын сипаттайды. Толық маман жиынтығы әлі де инференс қозғалтқышы қолжетімді жерде сақталуы тиіс.
DeepSeek-V4.1-Flash үшін қай рантаймды қолдану керек?
| Рантайм | Ағымдағы V4.1-Flash мәртебесі | Үздік қолдану |
|---|---|---|
| vLLM | Ағымдағы орналастыру рецепті бар; соңғы бейне қажет | Өндірістік OpenAI-үйлесімді сервинг |
| SGLang | Ағымдағы DeepSeek-V4.1 орналастыруларымен қолдау | Жоғары өнімді таратылған инференс |
| DeepSeek reference inference | Ресми TP8 анықтамалық іске асыру | Архитектуралық зерттеу және валидация |
| Transformers | Hugging Face-тағы модель интеграциясы | Даму және эксперимент; аппараттық талап сақталады |
| Ollama | Ресми кітапхана бағыты қазіргі уақытта :cloud | Ыңғайлы бұлттық шақыру, өзін-өзі хосттауға тең емес |
Өндірістік өзін-өзі хосттау үшін vLLM қазіргі кезде ең айқын бастау нүктесі. SGLang орналастыру нұсқаулығы алдыңғы қатарлы таратылған инференс үшін тағы бір қолдау көрсетілетін жолды ұсынады.
DeepSeek-V4.1-Flash-ты vLLM арқылы локалды қалай іске қосуға болады
Бұл көп GPU-лы Linux сервері үшін практикалық жол.
Төмендегі барлық командалық мысалдар тілге тән код блоктары ретінде қайта пішімделіп, ықшам ағылшын сипаттамаларымен берілген.
1-қадам: Ортаны тексеріңіз
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Жүздеген гигабайт бос SSD кеңістігі.
- Қолдау көрсетілетін көп GPU конфигурациясы.
- Ағымдағы ресми салмақ сервинг профилі үшін шамамен 614 GB жиынтық қолданбалы акселератор жад.
- Егер модель жергілікті кэштелмеген болса, жылдам желі.
2-қадам: DeepSeek-V4.1-Flash салмақтарын жүктеп алыңыз
Ресми салмақтар MIT лицензиясымен DeepSeek-V4.1-Flash Hugging Face репозиторийінде хостталады.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
~/.cache/huggingface орналасқан файл жүйесінде 511 GB-тан әлдеқайда көп бос орын бар екеніне көз жеткізіңіз. Уақытша файлдар және қосымша қозғалтқыш артефакттары шыңдық диск қолдануын арттыра алады.
3-қадам: vLLM арқылы DeepSeek-V4.1-Flash-ты іске қосыңыз
Қазіргі vLLM рецепті бойынша DeepSeek-V4.1 қолдауы жеткілікті жаңа vLLM бейнесін қажет етеді. Тек мәтіндік сегіз GPU-лы бастапқы конфигурация мынадай болуы мүмкін:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Мұнда екі әдейі таңдау бар. Біріншіден, --language-model-only мәтіндік-only жүктемелер үшін көру энкодерін сөндіреді. Екіншіден, бірден бір миллион токендік контекстті қоспай, 131,072 токеннен бастау қауіпсізірек. Сервер тұрақталғанда, оны арттыра аласыз:
--max-model-len 1048576
Тиісті tensor-parallel параметрі акселератор топологиясына тәуелді, сондықтан әр серверге --tensor-parallel-size 8-ді соқыр көшіруге болмайды.
4-қадам: Локалды DeepSeek-V4.1-Flash эндпойнтын тестілеңіз
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
5-қадам: Локалды DeepSeek-V4.1-Flash серверін Python арқылы шақырыңыз
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
DeepSeek-V4.1-Flash ойлау режимін локалды қалай қосуға болады?
V4.1-Flash чат шаблоны арқылы айқын reasoning басқаруын қолдайды. Мысал:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Егер модель шағын max_tokens мәнімен аз немесе мүлдем соңғы контент қайтармаса, ойлау режимі генерация бюджетінің көбін тұтынуы мүмкін. Орналастыру бұзылды деп болжаудан бұрын max_tokens-ті арттырыңыз, reasoning effort-ті азайтыңыз немесе қарапайым сұраулар үшін ойлауды сөндіріңіз.
DeepSeek-V4.1-Flash-ты анықтамалық кодпен қалай іске қосуға болады?
DeepSeek сондай-ақ модель репозиторийінде минималды TP8 инференс іске асыруын қамтиды. Ол негізінен оқуға ыңғайлы анықтамалық код ретінде арналған, жоғары өткізу қабілетті өндірістік сервер ретінде емес.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Бұл жол CED, MoE маршрутизациясы, Engram жад, спекулятивті декод және қатысты іске асыру бөлшектерін зерттеу үшін пайдалы. Қалыпты өндірістік сервинг үшін vLLM немесе SGLang басқаруға оңай.
DeepSeek-V4.1-Flash-ты Ollama арқылы локалды іске қосуға бола ма?
Қалыпты 7B немесе 32B Ollama моделі сияқты емес. Ollama қазір V4.1-Flash-ты мына арқылы көрсетеді:
ollama run deepseek-v4.1-flash:cloud
Маңызды бөлігі — :cloud. Ағымдағы Ollama кітапхана жазбасы бұлттық бағытты қолданады, сондықтан бұл команда толық модельді жүктеп, инференсті толығымен өз машинаңызда орындаумен тең емес.
DeepSeek-V4.1-Flash локалды орналастыру vs API: қайсысы қисындырақ?
| Өлшем | Локалды DeepSeek-V4.1-Flash | Хостталған API |
|---|---|---|
| Бастапқы аппарат | Өте жоғары | Жоқ |
| Акселератор жады | ~614 GB практикалық ресми нысана | Провайдер басқарады |
| Модельді бақылау | Толық | Шектеулі |
| Деректер локалды ма | Иә | Жоқ |
| Салмақты өзгерту | Иә | Жоқ |
| Техникалық қызмет | Сіздің жауапкершілігіңіз | Провайдер басқарады |
| Орнату күрделілігі | Жоғары | Төмен |
| Масштабтау | Инфрақұрылымды талап етеді | API-негізді |
| Үздік үшін | Оқшауланған, жеке, зерттеу, жоғары жүктемелі кластер | Көпшілік әзірлеушілер және өндірістік қолданбалар |
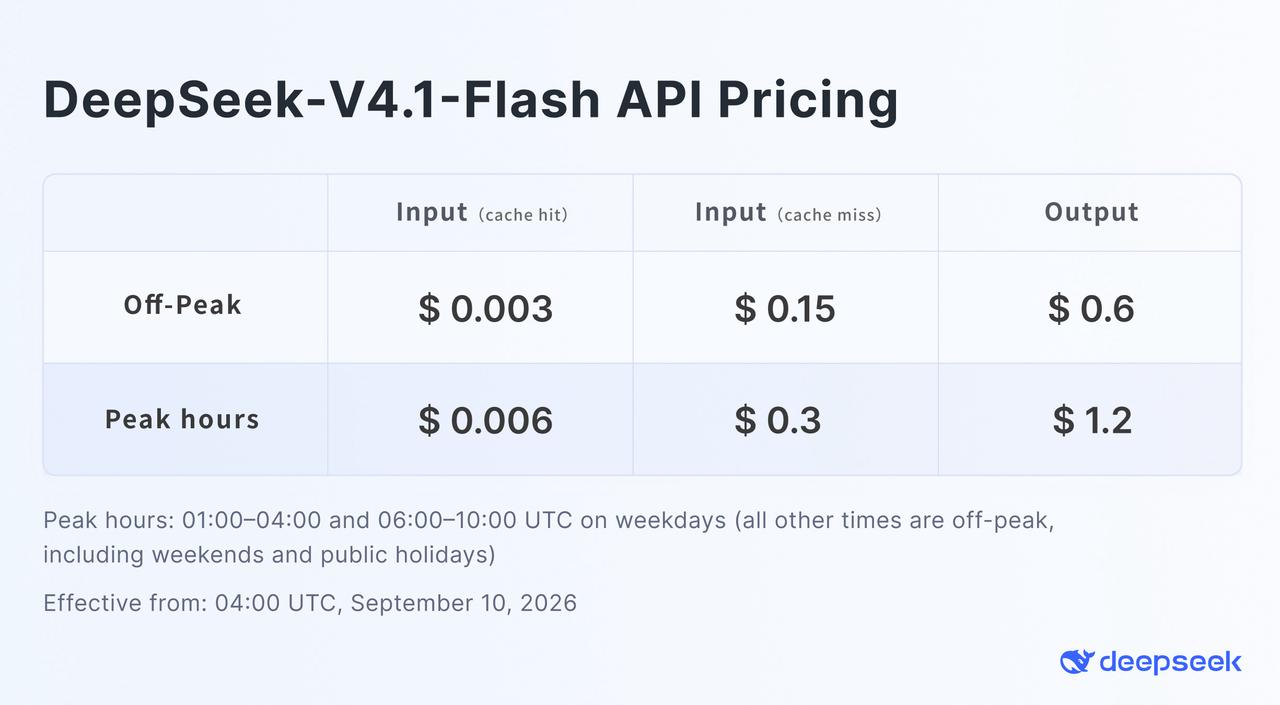
DeepSeek-тің ресми off-peak бағалары оның V4.1-Flash баға графигінде көрсетілген. Салмақтарға физикалық ие болу қажет емес әзірлеушілер үшін CometAPI-дегі DeepSeek V4.1 Flash API OpenAI-үйлесімді балама береді.
Төмендегі мысалда CometAPI моделі идентификаторы қолданылады. Бұл DeepSeek-тің ресми API идентификаторы емес.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
Практикалық шешім айқын: құпиялылық, ауа алмасудан оқшаулану, салмақ деңгейіндегі эксперименттер, болжамды ауыр жүктеме немесе реттеуші талаптар инфрақұрылым құнынан басым болғанда локалды орналастыру тартымды болады. Кәдімгі қолданба әзірлеу үшін хостталған эндпоинт жүздеген гигабайттық модель басқаруы мен көп GPU-лы оркестрациядан құтқарады.
DeepSeek-V4.1-Flash-ты локалды іске қосқанда қандай мәселелер пайда болуы мүмкін?
Генерация басталмай тұрып сервер жадтан таусылады
Жад талаптарының негізгі бөлігін 8B/16B белсенді параметр саны емес, толық чекпойнт анықтайды. Tensor parallelism, GPU жад қолданылуы, көруді жүктеу және қолжетімді HBM-ді тексеріңіз.
DeepSeek-V4.1-Flash іске қосылуға ұзақ уақыт алады
Жарты терабайттық чекпойнтты жүктеу, маппинг, инициализация және шардтау уақыт алады. Бұл класс модельдері үшін engine-ready тайм-ауттарының ұзақ болуы қалыпты.
Жауап бос немесе finish_reason=length-пен аяқталады
Ойлау режимі генерация бюджетін тұтынып жатқан болуы мүмкін. max_tokens-ті арттырыңыз, reasoning effort-ті төмендетіңіз немесе қарапайым сұраулар үшін ойлауды сөндіріңіз.
Құрал шақырулары дұрыс парсингтелмейді
Сервер DeepSeek V4.1 tokenizer, tool-call parser, reasoning parser және auto-tool-choice жалаушаларын қолданатынына көз жеткізіңіз.
Көру енгізуі жұмыс істемейді
Егер сіз --language-model-only арқылы іске қосқан болсаңыз, визуалды энкодерді әдейі сөндірдіңіз. Суреттерді тестілеуден бұрын мультимодаль қолдаумен қайта іске қосыңыз.
DeepSeek-V4.1-Flash-ты локалды іске қосу керек пе?
DeepSeek-V4.1-Flash өзін-өзі хосттау тұрғысынан ерекше қызықты, себебі оның архитектурасы токенге шаққандағы есептеу мен KV-кэш құнын едәуір азайтады, бірақ ол фронтир ауқымындағы ашық салмақ модельді “десктоп моделіне” айналдырмайды.
Зертхана, кәсіпорын AI платформасы, жеке кодтау агенттері стегі немесе оқшауланған орта үшін vLLM және SGLang өзін-өзі хосттауды техникалық тұрғыдан шынайы етеді. Бір-екі GPU-лы әзірлеуші үшін бұл толық модельді орналастыру нысанасы практикалық емес. Бұл жағдайда CometAPI арқылы DeepSeek V4.1 Flash-ты пайдалану сервингті үлкен инфрақұрылым жобасына айналдырмай модельге қол жеткізуге мүмкіндік береді.
Жиі қойылатын сұрақтар
DeepSeek-V4.1-Flash ашық па?
Модель салмақтары және репозиторий MIT лицензиясымен шығарылған, бұл лицензия шарттарына сәйкес кеңінен қолдануға, өзгертуге және қайта таратуға рұқсат береді.
DeepSeek-V4.1-Flash-ты RTX 4090 немесе RTX 5090-да іске қоса аламын ба?
Ресми толық модельді — жоқ. Бір тұтынушылық GPU-да толық чекпойнт талап ететін жадтың шағын бөлігі ғана бар.
8B белсенді параметрлер DeepSeek-V4.1-Flash тек 8 GB VRAM қажет етеді дегенді білдіре ме?
Жоқ. 8B саны промпт өңдеу кезінде қатысатын параметрлерді сипаттайды. Толық мамандар желісі және қолдаушы күй әлі де сақталып, қолжетімді болуы тиіс.
DeepSeek-V4.1-Flash қанша VRAM қажет етеді?
Ағымдағы vLLM рецепті ресми чекпойнт пен рантайм үстеме шығындары үшін жоспарлау фигурасы ретінде шамамен 614 GB қолданады. Нақты қажеттіліктер аппарат, пакет өлшемі, контекст, көру қолдауы және сервинг конфигурациясына байланысты өзгеріп отырады.
DeepSeek-V4.1-Flash дискіде қандай көлем алады?
Ағымдағы vLLM бөлінісі чекпойнтты шамамен 476 GiB, яғни шамамен 511 GB деп келтіреді.
DeepSeek-V4.1-Flash 1M-токен контекстін локалды іске қоса ала ма?
Архитектура 1,048,576 токенге дейін қолдайды, бірақ практикалық жад қолдануы пакет өлшемі, рантайм буферлері, көру күйі және басқа үстеме шығындарға да тәуелді.
DeepSeek-V4.1-Flash-ты Ollama арқылы локалды іске қоса аламын ба?
Ағымдағы Ollama жазбасы :cloud бағытын қолданады, бұл толық салмақтарды толықтай өз машинаңызда орындаумен бірдей емес.
vLLM немесе SGLang — қайсысы DeepSeek-V4.1-Flash үшін жақсы?
Екеуі де жоғары өнімді сервингті нысана етеді. Қазіргі уақытта vLLM-да V4.1-ге тән егжей-тегжейлі рецепт бар, ал SGLang да алдыңғы қатарлы таратылған орналастырулар үшін жарамды.
DeepSeek-V4.1-Flash-ты жергілікті аппаратсыз пайдаланудың ең оңай жолы қандай?
Хостталған API қолданыңыз. DeepSeek өзінің API-ын ұсынады, ал CometAPI OpenAI-үйлесімді DeepSeek-V4.1-Flash эндпойнтын басқа AI модельдерімен қатар береді.