
TL;DR
Muse Wonder, Claude Opus 5.5 және GPT-6 Sol — кодтау мен агенттік жұмыс ағындарына бағытталған жоғары мүмкіндікті модельдер. Meta-ның жаңа Muse Wonder моделі тұрақты жад пен ұзақ орындалуды баса көрсетеді; Opus 5.5 жарияланған жиынтық интеллект индексінде алда; GPT-6 Sol осы салыстыруда стандартты қысқа контекст үшін ең төмен енгізу/шығару бағаларына ие, ал ұзын контекст деңгейі бөлек бағаланады. Таңдауды бір ғана лидерборд ұпайына емес, өкілді тапсырма сапасы, сенімділік және толық құн бойынша жасаңыз.
Негізгі тұжырымдар
- Жалпы интеллект: Claude Opus 5.5 — 58, Muse Wonder — 52 (Intelligence Index v4.3 бойынша).
- Ұзақ көкжиекті кодтау: Muse Wonder DeepSWE 1.1-де 78.8 және SWE-Marathon-да 53.1; Opus 5.5 Meta кестесінде тиісінше 74.2 және 46.3 көрсетеді.
- Төмен құнды пайымдау: GPT-6 Sol OpenAI-дың стандартты қысқа контекст API-ы арқылы 1 млн токен үшін $2 енгізу / $10 шығару бағасынан басталады.
- Жадқа бағытталған агенттер: Muse Wonder Active Memory және Active Focus ұсынады.
- Қолжетімділік маңызды: Muse Wonder Full — әзірлеушілерге қолжетімді стандартты Muse Wonder-дан бөлек, шектеулі өнім.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol қысқаша шолу
Тұрақты агенттер мен ұзаққа созылатын инженерлік үшін Muse Wonder-ді, кең ауқымды кодтау мен терминалға тәуелді жұмыс үшін Claude Opus 5.5-ті, ал қысқа контексттегі төмен токен құны үшін GPT-6 Sol-ды таңдаңыз.
| Шешім факторы | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Неден бастап тестілеу | Тұрақты агенттер және ұзартылған инженерия | Терминалға тәуелді кодтау және кәсіби жұмыс | Бюджетке сезімтал кодтау және автоматтандыру |
| Контекст терезесі | 1,048,576 токен | 1M токен | 1,050,000 токен |
| Жарияланған күшті жақ | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Стандартты енгізу/шығару $2/$10 (1 млн токен) |
| Стандартты енгізу / шығару (1 млн токен) | $4 / $20 | $4 / $20 | $2 / $10; қысқа контекст деңгейі |
| Провайдер арқылы қол жеткізу | Meta Model API; Full — бөлек жазылымдық өнім | Anthropic API | OpenAI API |
| Таңдау метрикасы | Қабылданған тапсырма сапасы және толық құн | Қабылданған тапсырма сапасы және толық құн | Қабылданған тапсырма сапасы және толық құн |
| Әзірлеуші | Meta | Anthropic | OpenAI |
| Шығарылым | 12 қазан, 2026 | 22 қыркүйек, 2026 | 16 қыркүйек, 2026 |
| Енгізу модальдығы | Мәтін, кескін, аудио, видео; PDF енгізулері құжатталған | Мәтін, кескін | Мәтін, кескін |
| Шығарылым | Мәтін | Мәтін | Мәтін |
| Ерекше мүмкіндік | Active Memory және Active Focus | Құралдар және субагент жұмыс ағындары | Конфигурацияланатын reasoning effort және API құралдары |
Бұл шолу төменде қаралған даталанған сипаттамалар мен жарияланған нәтижелерді жинақтайды. Бенчмарк жолдары әртүрлі бағалау әдістерін қолданады, ал төмен токен бағалары әрбір сәтті тапсырмаға төмен құнды кепілдемейді. Стандартты Muse Wonder және Muse Wonder Full — бөлек қолжетімді нұсқалар.
Сипаттамалар 13 қазан, 2026 жағдайы бойынша тексерілді. Қолдау көрсетілетін модальдықтар мен мүмкіндіктер таңдалған эндпойнт пен релиз бетіне тәуелді, оның ішінде аудиоға қолжетімділік. Модель деңгейіндегі мүмкіндіктер әрбір шлюз бағытында қолдауды кепілдемейді.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Шолу және техникалық сипаттамалар
Muse Wonder: Тұрақты агент жұмыс ағындары
Meta 2026 жылғы 12 қазанда Muse Wonder және Muse Wonder Full шығарды. Стандартты Muse Wonder ұзаққа созылатын кәсіби тапсырмаларға, агенттің тұрақты жадына және кедергілерден қалпына келуге басымдық береді. Active Memory пайдалы алдыңғы контексті алуға арналған, ал Active Focus көпқадамды жұмыста прогресті ұстап тұруға бағытталған. Meta негізгі сценарийлер ретінде кодтауды, зерттеуді, қаржылық талдауды және жеке көмек көрсетуді атайды.
Claude Opus 5.5: Кәсіби кодтау және құралдарды пайдалану
Claude Opus 5.5 кодтау, пайымдау және көпқұралды кәсіби жұмыс ағындарын нысанаға алады. Anthropic оны 2026 жылғы 22 қыркүйекте шығарды. Оның контекст терезесі бір миллион токен, ал төменде келтірілген кодтау нәтижелері бенчмаркке қарай күшті жақтардың өзгеретінін көрсетеді.
GPT-6 Sol: Құны маңызды пайымдау
GPT-6 Sol мықты пайымдау мен құрал пайдалануды салыстырмалы түрде қолжетімді инференсимен ұштастыруды мақсат етеді. Ол OpenAI API экожүйесі арқылы бағдарламалық жұмыс ағындарын қолдайды. Оның стандартты қысқа контекст бағалары тізімдегі Claude Opus 5.5 бағаларынан төмен, дегенмен соңынан соңына дейінгі экономика ретрайлер мен reasoning-токендерді пайдалануға да тәуелді.
OpenAI GPT-6 Sol-ды күрделі кодтау және агенттік жұмыс ағындарына арналған модель ретінде сипаттайды; оның релиз анонсы төменде пайдаланылған бағалау нәтижелерін береді. Бұл мақала әр жеткізушінің желісіндегі ең жаңа барлық модельдерді емес, нақты көрсетілген модель нұсқаларын салыстырады.
Архитектура және пайымдауды басқару параметрлері
Мұнда сілтеме жасалған дереккөздер үш модель үшін де салыстыруға келетін параметр саны мен архитектуралық жіктеуді бермейді. Сондықтан тығыз және Mixture-of-Experts бойынша рейтинг жасау негізсіз. Active Memory және Active Focus — Meta-ның агент мүмкіндіктерін сипаттайтын атаулар; олар ашықталған нейрожелі архитектурасының орнына жүрмейді. GPT-6 Sol конфигурацияланатын reasoning effort ұсынады, ал Meta және Claude жариялаған ұпайлар да күш жұмсау деңгейі мен бағалау баптауларына тәуелді. Бұл баптауларды салыстырылып отырған конфигурацияның бөлігі ретінде қарастырыңыз, есептеу шығынының алмастырмалы өлшемдері ретінде емес.
Салыстыру нәтижесі: Үшеуінде де үлкен контекст терезелері және әзірлеуші API-лары бар. Muse Wonder модель деңгейінде кеңірек енгізу модальдықтарын құжаттайды; Opus 5.5 және GPT-6 Sol мәтін және кескін жұмыс ағындарын баса көрсетеді. Контекст сыйымдылығы мен мүмкіндік қолжетімділігін таңдалған эндпойнттан нақтылап тексеру қажет.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Өнімділік
Жарияланған бенчмаркдер және дереккөз шектері
Meta-ның ресми модель картасы Muse Wonder мен Claude Opus 5.5-ті тікелей салыстырады. OpenAI GPT-6 Sol нәтижелерін бөлек жариялайды, сондықтан үш модельді де нұсқалар мен баптауларды үйлестірмей бір ортақ, толық бақыланатын лидербордқа қою мүмкін емес.
| Бенчмарк | Muse Wonder | Claude Opus 5.5 | Жоғары ұпай |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
Ресми модель картасының әдістемесі ішкі тесттерді, үшінші тарап бағалауларын және провайдер хабарлаған бәсекелес ұпайларын ажыратады. Кесте жарияланған мәндерді келтіреді; ол жолдардың барлығына ортақ, тәуелсіз бақыланатын сынақты орнатпайды.
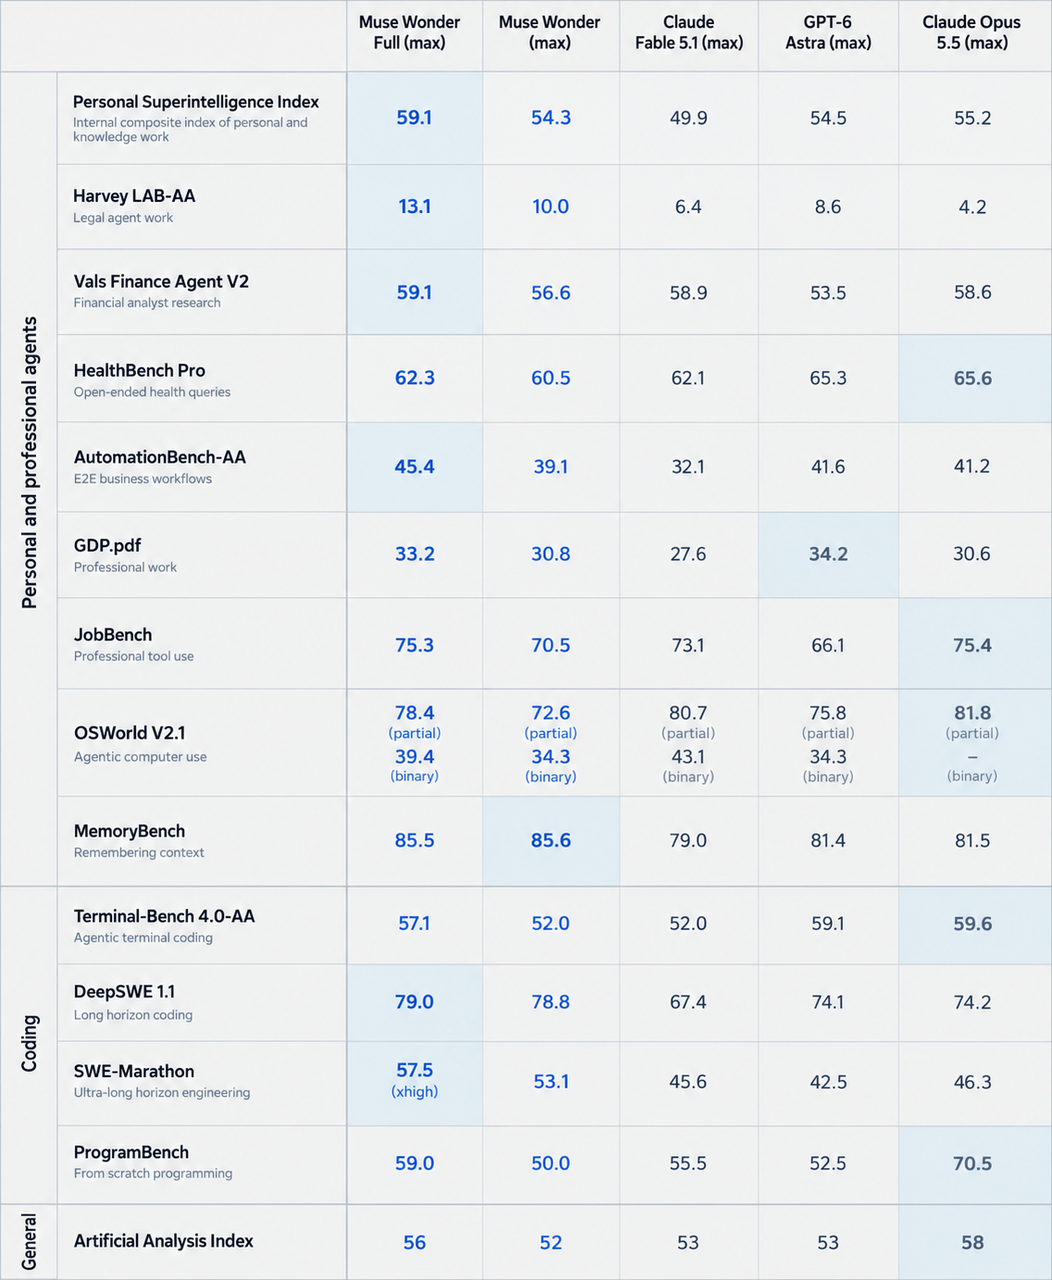
Meta-ның Muse Wonder модель картасынан алынған бастапқы бенчмарк скоркарт, қайта сызусыз келтірілді. Бұл ресми суретте көрсетілген қосымша OpenAI моделі — GPT-6 Astra, GPT-6 Sol емес. Жанындағы кестелер осы мақалаға қатысты модельдерді анықтайды.
Бағалау шарттары
DeepSWE v1.1 — 91 репозиторий мен бес тілдегі 113 тапсырманы қамтиды, функциялық және регрессия тесттерімен pass@1 бойынша бағаланады; Meta скоркарты Muse Wonder және Opus 5.5 үшін Datacurve нәтижелерін пайдаланады. SWE-Marathon жоба тесттерін қолданады және Abundant AI ұсынған pass@1-ді есептейді; агент қоржындары өзгереді, ал Wonder Full ұпайы xhigh деп белгіленген. ProgramBench mini-swe-agent қолданады және интернет орнатудан кейін өшірілген күйде жасырын тесттердің кемінде 95%-ын өтетін роллауттарды өлшейді. MemoryBench — Meta-ның ішкі 64K–100K токендік әңгіме тесті, LLM төрешісімен бағаланады. Бұл орта мен метрикаларды бір жалпы дәлдік ұпайына біріктіруге болмайды.
Кодтау және бағдарламалық инженерия
Жарияланған DeepSWE 1.1 және SWE-Marathon нәтижелерінде Muse Wonder алда. Claude Opus 5.5 Terminal-Bench 4.0-AA және ProgramBench бойынша алда. Бұл айырмашылық ұзақ көкжиекті инженерия, командалық жол құралдарын пайдалану және бағдарламаны қалпына келтіру әртүрлі дағдыларды сынайтынын көрсетеді.
GPT-6 Sol нәтижелері және дереккөздер арасындағы салыстырмалылық
| OpenAI жариялаған бағалау | GPT-6 Sol | Есепте көрсетілген баптау |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
OpenAI-дың жарияланған бағалау нәтижелері жоғарыдағы ұпайларды береді. Оның OSWorld нәтижесі — v2026.08.08 офлайн жиынтығында ішінара марапат, қатаң тапсырманы орындау көрсеткіші емес. OpenAI бағалаулар зерттеу ортасында немесе API арқылы жүргізілгенін атап өтеді; өндірістік конфигурациялар өзгеше болуы мүмкін.
Жарияланған DeepSWE ұпайлары Muse Wonder мен GPT-6 Sol арасында 10.0 пайыздық пункт айырманы және Opus 5.5 пен GPT-6 Sol арасында 5.4 пункт айырманы меңзейді. Бұл — жарияланымдар арасындағы арифметикалық айырмалар, модельдің өз артықшылығын бақыланатын бағалау емес. Әртүрлі агент баптаулары, промпттар, күш жұмсау деңгейлері және құрал бюджеттері нәтижеге әсер етуі мүмкін.
Жад және ұзақ жұмыс істейтін агенттер
Muse Wonder алдыңғы шешімдерді еске алып, контексті қалпына келтіріп, үзілген жұмысты жалғастыруы керек агенттерді нысанаға алады. Active Memory зерттеу көмекшісіне жобаға тән фактілерді есте сақтауға көмектесе алады, ал Active Focus бұрынғы жоспар сәтсіз болғанда итеративті әрекетті қолдайды. Бұл өнім мүмкіндіктері сезімтал әрекеттерге арналған күйді тексеруді, рұқсаттарды, аудит іздерін немесе міндетті адамдық растауды алмастырмайды.
Muse Wonder Full өнімділігі
Muse Wonder Full — бөлек өнім таңдауы. Meta стандартты Muse Wonder-ді API арқылы ұсынады, ал Full Muse Code ішіндегі Power Usage және Maximum Usage жазылымдарында шектелген. Жоғары ұпай Full-ды стандартты модельдің API алмастырушысы етпейді.
Meta-ның хабарлаған Wonder Full нәтижелері: Intelligence Index — 56, Personal Superintelligence — 59.1, Harvey LAB-AA — 13.1, AutomationBench-AA — 45.4. Сондай-ақ ол DeepSWE 1.1-де 79.0, SWE-Marathon-да 57.5, MemoryBench-те 85.5 және JobBench-те 75.3 ұпайға ие. Бұл жарияланған нәтижелер бөлек қолжетімді Full өнімін сипаттайды; олар ортақ қоржынмен жаңа өлшеулер емес.
Жоғарыдағы стандартты Muse Wonder ұпайларымен салыстырғанда, Full осы сегіз көрсеткіштің жетеуінде жақсарады; MemoryBench аздап төмен — 85.5 vs 85.6. Opus 5.5 жарияланған Intelligence Index бойынша 58 ұпаймен әлі де алда.
Кідіріс және сенімділік
Келтірілген деректер үш модель бойынша сәйкестендірілген кідіріс салыстыруын бермейді. Пайдалы алғашқы шығуға дейінгі уақытты, медианалық және 95-процентильдық толық тапсырма уақыты, таймаут жиілігі және араласусыз аяқтауды өлшеңіз. Тапсырма енгізулерін, құрал рұқсаттарын, бір мезгілде орындалуды және қабылдау критерийлерін бірдей ұстап, күш баптауларын және ретрайлер бюджеттерін тіркеңіз. Жай ғана жылдам токен генерациясы көпқадамды тапсырманы жылдамырақ аяқтауды дәлелдемейді.
Салыстыру нәтижесі: Muse Wonder келтірілген ұзақ инженерлік тесттерде алда, ал Opus 5.5 терминал және бағдарлама-қалпына келтіру тесттерінде алда. GPT-6 Sol төмен токен бағасымен үміткер болып қалады, бірақ қолжетімді жарияланымдар үшеуінің де бірдей ортада сапа немесе жылдамдық рейтингін дәлелдемейді.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Құны
Ресми API токен бағалары
| 1 млн токен үшін баға | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Стандартты енгізу | $4 | $4 | $2 |
| Стандартты шығару | $20 | $20 | $10 |
| Кэштенген енгізу | $0.20 | $0.20 | $0.20 |
| Ұзын контекст енгізу | $4 | $4 | $4 |
| Ұзын контекст шығару | $20 | $20 | $15 |
| Ұзын контекст кэш енгізу | $0.20 | $0.20 | $0.40 |
Meta 1 млн токен үшін енгізуде $4, шығаруда $20 және кэштенген енгізуде $0.20 жариялайды. Anthropic Opus 5.5-ті 1 млн токен үшін енгізуде $4, шығаруда $20 және кэш хиттерінде $0.20 деп көрсетеді. OpenAI-дың баға кестесі GPT-6 Sol үшін қысқа контекстте енгізу/шығару $2/$10 және ұзын контекстте $4/$15 деп тізімдейді; кэштенген енгізу бағалары да деңгейге қарай өзгереді. Жұмыс жүктемесін бағалағанда тиісті сұрау контекст деңгейін, өңдеу режимін және эндпойнт шарттарын қолданыңыз.
GPT-6 Sol үшін 272,000-нан көп енгізу токені бар сұрауларда жоғарырақ бағалар қолданылады:
- Енгізу токендері: стандартты мөлшерлеменің 2×, $2-ден $4-ке (1 млн токен үшін) өседі.
- Кэштенген енгізу токендері: стандартты мөлшерлеменің 2×, $0.20-дан $0.40-қа (1 млн токен үшін) өседі.
- Шығару токендері: стандартты мөлшерлеменің 1.5×, $10-нан $15-ке (1 млн токен үшін) өседі.
Бұл жоғарырақ бағалар тек асқан токендерге емес, бүкіл сұрауға қолданылады. Яғни 272,001 енгізу токені бар сұрау енгізу, кэштенген енгізу және шығару токендерінің барлығына ұзын контекст баға деңгейіне өтеді.
Салыстыру үшін, Muse Wonder және Claude Opus 5.5 стандартты API бағаларында мұндай ұзын контексттік қосымша үстеме енгізбейді.
Бұл айырмашылық үлкен құжаттарды талдау, репозиторий деңгейінде кодтау және ұзақ уақыт жұмыс істейтін AI агенттері үшін маңызды, мұнда GPT-6 Sol-дың қысқа контексттегі баға артықшылығы сұраулар үлкейген сайын тарылуы мүмкін.
CometAPI бағалары және биллинг шарттары
Шолу сәтінде CometAPI Opus 5.5 үшін 1 млн токенге $3.20 енгізу / $16 шығару және GPT-6 Sol үшін $1.60 енгізу / $8 шығару деп тізімдеді. Бұлар CometAPI-дың тәуелсіз бағалары және жоғарыдағы ресми провайдер бағаларымен шатастырылмауы керек. Құнды есептер алдында қолданылатын маршрутты, контекст деңгейін және аккаунт биллинг шарттарын растаңыз; бағалар мен шарттар өзгеруі мүмкін.
Қабылданған тапсырмаға шаққандағы құн
Қабылданған тапсырмаға шаққандағы құнды алдын ала анықталған қабылдау критерийлеріне сай келген шығулар санына бөлінген, модель мен құралдарға кеткен барлық төленген шығын ретінде есептеңіз, оған ақылы ретрайлер мен фолбэктар кіреді. Адамдық тексеру уақытын бөлек тіркеңіз немесе оны нақты еңбек мөлшерлемесімен ақшаға айналдырыңыз. Сәтсіз сұраулар мен нақты төлемдерді бөлек қадағалаңыз: сәтсіздік — сұрау төленді ме, жоқ па екенін өздігінен анықтамайды.
Салыстыру нәтижесі: GPT-6 Sol стандартты қысқа контекст үшін ең төмен енгізу/шығару бағаларына ие, ал Muse Wonder және Opus 5.5 бірдей базалық бағаларды бөліседі. Нақты қабылданған тапсырма құны таңдалған биллинг маршрутына, кэш қолдануға, контекст деңгейлеріне, құрал төлемдеріне, ретрайлерге және тексеру еңбегіне тәуелді.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Салыстыру және таңдау
Мүмкіндіктер мен жүктемеге негізделген таңдау
- Кең ауқымды кодтау және терминал жұмыс ағындары үшін Claude Opus 5.5-тен бастаңыз, себебі ол келтірілген Intelligence Index, Terminal-Bench және ProgramBench нәтижелерінде алда. Рефакторинг, құрал орындау және бағдарлама деңгейіндегі бірізділік бойынша тексеріңіз.
- Ұзартылған инженерлік жобалар үшін Muse Wonder-ден бастаңыз, өйткені оның жарияланған DeepSWE және SWE-Marathon нәтижелері Opus 5.5-тен жоғары. Тапсырманы аяқтау, кедергілерден қалпына келу және толық тапсырма құнын өлшеңіз.
- Тұрақты жеке агенттер үшін Muse Wonder-ден бастаңыз, өйткені ол Active Memory және Active Focus ұсынады және Opus 5.5-тен жоғары MemoryBench ұпайына ие. Еске түсіру, түзетулер, үздіксіздік және жобаларды оқшаулау бойынша сынаңыз.
- Көпқадамды құрал жұмыс ағындары үшін үшеуін де бағалаңыз. Muse Active Focus ұсынады, Opus құрал оркестрациясын баса көрсетеді, ал GPT-6 Sol Responses API құралдарын қолдайды. Агент стекін толық салыстырыңыз: құрал рұқсаттары, ретрайлер және күйді өңдеу.
- Кәсіби құжаттар және талдау үшін Muse Wonder немесе Claude Opus 5.5-ті бағалаңыз. Muse-дің маманданған күшті жақтары бар, ал Opus жарияланған жиынтық индекс бойынша күштірек. Өкілді құжаттар мен тапсырмаға тән қабылдау критерийлерін қолданыңыз.
- Көлемі жоғары, құнға сезімтал автоматтандыру үшін GPT-6 Sol-дан бастаңыз, өйткені ол стандартты қысқа контекст үшін ең төмен енгізу/шығару бағаларын ұсынады. Қабылданған тапсырма құнын, контекст деңгейлерін, кідірісті және ретрайлерді тексеріңіз.
- Meta-ның ең жоғары деңгейлі нұсқасы үшін, қолжетімді болса, Muse Wonder Full-ды бағалаңыз. Ол бірнеше маманданған тапсырмаларда жоғары ұпай көрсетеді, бірақ стандартты API модельден бөлек. Жазылым қолжетімділігін және жарамдылығын тексеріп алыңыз.
Кәсіби кодтау
Claude Opus 5.5 құрал орындау, рефакторинг және бағдарлама деңгейіндегі бірізділік маңызды болғанда кең ауқымды инженерлік көмекші қажет командалар үшін жақсы әдепкі таңдау. Оның Terminal-Bench және ProgramBench бойынша артықшылықтары бұл пайымды күшейтеді, дегенмен командалар тек модельді ғана емес, толық агент стекін тексеруі қажет.
Көлемі жоғары автоматтандыру
GPT-6 Sol сұраулар саны көп және құнға сезімталдық жоғары болғанда тартымды. Аздаған сапа тапшылығы да төмен қауіп-қатерлі, оңай тексерілетін тапсырмаларда (мысалы, құжаттама жазу, құрылымдалған өрістерді шығару немесе кодты түсіндіру) қабылдануы мүмкін. Ұзақ автономды жүгірулерде сапаны, токендерді, кідірісті және ретрайлерді бірге бақылаңыз.
Продакшн бағалау тізімдемесі
Продакшн бағалау алты метриканы қадағалауы тиіс: дұрыстық — қабылданған жауаптар немесе өткен тесттермен өлшенеді; сенімділік — адам көмегінсіз аяқталған тапсырмалармен; кідіріс — толық тапсырма ұзақтығымен; токен қолдану — төленген енгізу және шығару көлемімен; агент тиімділігі — құрал шақырулары және түзетуші ретрайлермен; тиімді құн — жалпы шығынды қабылданған тапсырмаларға бөлу арқылы.
Салыстыру нәтижесі: Ұзаққа созылатын агенттік және инженерлік тапсырмалар үшін Muse Wonder-ді, терминалға басым жүктемелері бар кең кодтау жұмыс ағындары үшін Opus 5.5-ті, ал токен құны негізгі шектеу болғанда GPT-6 Sol-ды шортлистке енгізіңіз. Кандидатты тек тапсырмаға тән сапа және сенімділік шектерін өткеннен кейін ғана продакшнға ілгерілетіңіз.
Muse Wonder, Claude Opus 5.5 және GPT-6 Sol-ға қайдан қол жеткізуге болады?
Ресми провайдер арқылы қол жеткізу
Стандартты Muse Wonder үшін Meta Model API-ды, Opus 5.5 үшін Anthropic API-ды немесе GPT-6 Sol үшін OpenAI API-ды пайдаланыңыз. Muse Wonder Full стандартты API моделіне тікелей алмастырғыш емес, Muse Code-тың көрсетілген жазылым жоспарлары арқылы қолжетімді. Таңдалған маршрут үшін аккаунт қолжетімділігін, пайдалану шектерін және сұрау мүмкіндіктерін тексеріңіз.
CometAPI арқылы қол жеткізу
Біріктірілген шлюз аутентификацияны, биллинг пен маршрутизацияны жеңілдетуі мүмкін. Күрделі архитектуралық шолуға өнімдірек модельді, ал қайталанатын, төмен қауіп-қатерлі драфтингке арзанырақ модельді қолданыңыз. Модель идентификаторы мен сұрау форматының қолдауын мақсатты API эндпойнтімен әрқашан салыстырып тексеріңіз.
Әзірлеушілер өкілді жұмыс жүктемелерін бағалау үшін Claude Opus 5.5 API in CometAPI және GPT-6 Sol API in CometAPI пайдалана алады. Ортақ шлюз барлық сұрау форматтарын алмастырмалы ететінін болжамай, әр модель үшін қолдау көрсетілетін API интерфейсін растаңыз.
Бұл мақалада келтірілген CometAPI маршруттары Opus 5.5 және GPT-6 Sol-ды қамтиды. Бұл мақала Muse Wonder немесе Wonder Full үшін CometAPI маршрутын орнатпайды; оларды бағалағанда расталған провайдер маршрутын қолданыңыз.
Қорытынды
Ешбір модель барлық жұмыс жүктемелерінде жеңімпаз емес. Muse Wonder — тұрақты агенттік мінез-құлық пен ұзаққа созылатын инженерлік тапсырмалар үшін ең мықты үміткер. Claude Opus 5.5 — кең ауқымды кодтау, терминалға тәуелді жұмыс ағындары және білімге негізделген жұмыс үшін күшті үміткер, әрі ол Meta хабарлаған Artificial Analysis Intelligence Index мәнінде алда. GPT-6 Sol стандартты қысқа контекст үшін ең төмен токен бағаларын ұсынады және құнға сезімтал автоматтандыру үшін тартымды. Продакшн командалары ақырғы таңдауды өкілді жұмыс жүктемелерінде қабылданған тапсырма сапасы, сенімділік, кідіріс, ретрайлер, құрал қолдану және толық құн бойынша жасауы керек.
ЖҚС
Командалар Muse Wonder, Opus 5.5 және GPT-6 Sol модельдерін әділ қалай сынай алады?
Шынайы тапсырмалардан тұратын, ұстап қалынған жиынтығын қолданыңыз: қабылдау критерийлерін бекітіңіз, кіріс артефактілерін бірдей қылыңыз және құрал рұқсаттарын құжаттаңыз. Әр модель нұсқасын, күш деңгейін, агент қоржыны, таймаут және токен бюджетін тіркеңіз. Шығулар өзгеретін жағдайда қайталап іске қосыңыз, сәтсіздіктерді де хабарлаңыз және ортақ қоржындағы салыстыруды ең жақсы конфигурацияланған жүйелер салыстыруынан бөліңіз. Бұл басқа команданың бенчмаркіне емес, сіздің жұмыс ағындарыңызға қатысты дәлелдеме береді.
Модельдерді ауыстырғанда API шлюзі агент күйін сақтай ала ма?
Жалпы шлюз мекенжайы ғана әңгіме күйінің портативтілігін, құрал шақыру идентификаторларын немесе сақталған жауап сілтемелерін кепілдемейді. Хабарламалар, құрал нәтижелері және тексерілген тапсырма күйінің канондық жазбасын қолданба деңгейінде сақтаңыз. Жүріп жатқан жұмысты басқа модельге бағыттар алдында әр маршруттың күй және құрал семантикасын сынаңыз; әйтпесе арзанырақ фолбэк жұмысты дұрыс аяқтауға қажет ақпаратты жоғалтуы мүмкін.
Қайта әрекеттер мен адамдық тексеруге командалар қалай бюджет жасайды?
Тестілеуге дейін қабылданған нәтижені анықтаңыз, содан соң қабылданған нәтижелер санына бөлінген төленген модель және құрал шығыны ретінде есептеңіз. Тексеру еңбегін бөлек тіркеңіз немесе оны сағаттық мөлшерлемемен қосыңыз. Сәтсіз әрекеттерді, түзетуші шақыруларды және фолбэк модельдерді санаңыз, әрі типтік және ең қымбат тапсырмаларды салыстырыңыз. Бұл төмен токен бағасын пайдалы жұмыс құнының автоматты төмендеуі ретінде қабылдаудан сақтайды.
Жадыға сезімтал агентті бағалау нені қамтуы тиіс?
Агенттің тиісті фактілерді еске түсіретінін, түзетулерді енгізетінін, ескірген нұсқауларды елемейтінін және бөлек жобаларды оқшау ұстайтынын тексеріңіз. Тек бір ұзын промптпен шектелмей, кешіктірілген жалғастар мен қайшы жаңартуларды қосыңыз. Тұрақтылық, іздестіру және жою енгізілген жүйеге тәуелді болғандықтан, жады мінез-құлқын модель деңгейінде де, қолданба деңгейінде де тексеріңіз.