Choose your path
Qwen3 Блог
Qwen3.8-Flash API-ні қалай пайдалану керек: әзірлеушілерге арналған толық нұсқаулық
CometAPI көмегімен Qwen3.8-Flash API-ді пайдалануды үйреніңіз, оның ішінде Python, JavaScript, cURL, ағындық беру, ойлау режимі, көпмодальды енгізу, құрылымдалған шығыс,.
Qwen 3.8 Max-ты жергілікті түрде қалай орналастыруға болады: аппараттық қамтамасыз ету, vLLM, SGLang және кванттау жөніндегі нұсқаулық
Төменде Qwen3.8-2.4T-A95B ашық салмақтарын жергілікті түрде орналастыруға арналған практикалық нұсқаулық берілген. Мақсаттар: GPU талаптары мен өлшемдеу, FP8/FP4 (4-бит) квантизация опциялары, vLLM және SGLang арқылы қызметке шығару, 1M контекст терезесіне дайындық, өндірістік оңтайландыру. 1) Аппараттық талаптар және өлшемдеу - Салмақ VRAM есебі: - Бағдар: салмақ жады ≈ параметр саны × байт/параметр. - Байт/параметр жуық мәндері: BF16/FP16 ≈ 2; FP8 ≈ 1; 4-бит (AWQ/GPTQ) ≈ 0.5–0.6 (квант масштаб/кесте үстемелері бар). - Мысал (шамамен): 95B параметр болса, BF16 ≈ 190 GB, FP8 ≈ 95 GB, 4-бит ≈ 48–60 GB (тек салмақтар; жүйелік үстеме мен активацияларды қоспағанда). - KV-кэш жады (үлкен контекст үшін негізгі фактор): - Жуық формула: KV(bytes) ≈ batch × seq_len × layers × 2 × hidden_size_per_token × bytes_per_elem. - bytes_per_elem: BF16/FP16=2, FP8=1, 4-бит≈0.5–0.6 (егер бекенд қолдаса). - Бағалау: тіпті 7B модельде 1M токен контекст FP8-да жүздеген ГБ, 70–100B класта терабайттар деңгейінде болуы мүмкін. Практикада paged-KV, CPU/SSD offload және скользящее окно/терезені шектеу тәсілдері қажет. - GPU таңдауы: - FP8 үшін H100 класс (FP8 TensorCore) ұсынылады; A100 көбіне BF16/FP16/INT4 үшін. - 4-бит салмақтармен үлкен модельді 1×80GB немесе 2×80GB GPU-да сыйдыруға болады, бірақ 1M контекст үшін KV offload/шардтау міндетті. - Көп-GPU: tensor parallel/pipeline parallel қолданыңыз (vLLM/SGLang қолдайды). 2) Орта дайындау - ЖЖЖ/Драйвер: CUDA 12.x, жаңартылған NVIDIA драйвері, NCCL. - Python/Кітапханалар: Python 3.10+, PyTorch (CUDA сәйкес), FlashAttention 2/3 қолдауы бар құрастыру, Triton жаңарған нұсқа. - Орнату: - vLLM: pip install vllm - SGLang: pip install sglang - Қажетіне қарай: autoawq, auto-gptq, transformer-engine, tensorrt-llm (егер FP8/FP4-ті арнайы жолмен қажет етсе). 3) Модельді алу - Ашық салмақтарды жергілікті каталогқа немесе модель хабына жүктеңіз: . - Конфигурацияда ұзын контекстке арналған rope/NTK/YaRN параметрлері барын тексеріңіз (модельдің ресми нұсқаулығына сай). 4) Квантизация нұсқалары (FP8/FP4/4-бит) - FP8: - Түпнұсқа FP8 салмақтары немесе іске қосу кезінде FP8-ге түсіру бекендіге тәуелді (H100 қажет, TransformerEngine/TRT-LLM арқылы жиі қолданылады). - vLLM/SGLang-та FP8 қолжетімділігі нұсқасына байланысты; қолдау болса FP8 салмақтарын немесе FP8 runtime режимін таңдаңыз. - FP4/4-бит: - Нақты FP4 көбіне TensorRT-LLM/TE-ге тән эксперименттік режимдерде; кең таралған жұмыс үлгісі — 4-бит weight-only (AWQ немесе GPTQ). Практикада “FP4” талаптары үшін 4-бит AWQ/GPTQ пайдаланылады. - Дайындау: AutoAWQ/AutoGPTQ арқылы 4-битке квантизацияланған модель артефактілерін алыңыз, содан кейін vLLM/SGLang-қа соларды жүктеңіз. 5) vLLM арқылы орналастыру - Негізгі іске қосу (мысал параметрлер, нақты жалаушалар бекенд нұсқасына тәуелді): - Модель: vllm serve - Дәлдік: --dtype bfloat16 немесе қолдау болса FP8 режимін/салмақтарын таңдаңыз. - 4-бит: --quantization awq немесе gptq (квант модельін көрсетіңіз). - Параллельдеу: --tensor-parallel-size N (GPU санына сай). - Ұзын контекст: --max-model-len 1000000 (модель қолдаса); rope_scaling/ntk/longrope параметрлерін конфигурацияда қосыңыз. - Paged KV және offload: бекенд нұсқасына сай KV кэштін типін (мыс., fp8) және swap/offload параметрлерін қосыңыз; CPU RAM/SSD жеткілікті болсын. - Өнімділік: --gpu-memory-utilization 0.9, сәйкес жоспарлау және батч параметрлері. - Ескертпе: нақты жалауша атаулары vLLM нұсқалары арасында өзгеруі мүмкін; ұзын контекст пен FP8/4-бит қолдауы үшін құжаттағы сәйкес опцияларды қолданыңыз. 6) SGLang арқылы орналастыру - Негізгі іске қосу: - Модель/каталог: sglang serve --model --tp N - Дәлдік: bf16/fp16 режимі; FP8 қолдау болса TE/TRT-LLM интеграциясын қосыңыз. - 4-бит: AWQ/GPTQ квантизацияланған салмақтарды жүктеңіз. - Ұзын контекст: max_context_len/rope_scaling баптауларын, paged KV және offload параметрлерін қосыңыз. - Жүктеме: concurrency, batch-ану, prefilling/decoding құбырын теңшеңіз; ұзын контекстте prefill-доминант сценарийлерді оңтайландырыңыз. 7) 1M контекстке практикалық ескертпелер - Модель қолдауы: 1M контекст сапалы жұмыс істеуі үшін модель ұзын контекстке арнайы үйретілген/реттелген болуы тиіс; тек rope_scaling қосу сапа мен тұрақтылықты толық қамтамасыз етпеуі мүмкін. - Жады шегі: 1M терезе KV-кэшін толық GPU-да ұстау іс жүзінде мүмкін емес; paged-KV, CPU/SSD offload және кішірейтілген белсенді терезе (sliding window) керек. - Тюнинг: - Белсенді терезені шектеу: effective window (мыс., 16k–64k) сақтап, толық 1M позиция үшін rope/NTK масштабын қолданыңыз. - PagedAttention block size-тарын кіші етіп баптау, prefetch және CPU pinned memory қосу. - Prefill-ді бөлік-бөлік (chunked prefill) өңдеу, attention sink/кросс-торап кэшін пайдалану (бекенд қолдаса). - Альтернативалар: - RAG, индекс/таңдамалы жүктеу, қисынды беттік терезелер және контекст конденсациялау. - KV кэш компрессиясы немесе selective activation (бекенд мүмкіндігіне сай). 8) Өндірістік оңтайландыру - Жүйе: - NUMA affinity, nvidia-persistenced, қуат/жылу режимдерін тұрақты ұстау. - Docker + nvidia-container-toolkit; hugepages және pinned memory. - Мониторинг: NVML/DCGM, Prometheus/Grafana; tail latency және токен/с ені. - Инференс қозғалтқышы: - FlashAttention 2/3, CUDA Graphs (бекенд қолдаса), fused kernels. - Беттеу/жоспарлау: үлкен prefill жүктемелерге арнап max_num_batched_tokens, max_num_seqs, waiting/throughput саясаттарын теңшеу. - Спекулятив декодтау (draft-модель) және үздіксіз батчтау (continuous batching) мүмкіндігін пайдалану. - Параллельдеу: - Tensor parallel дұрыс факторын таңдаңыз (шина ені/AllReduce т.б. ескеріп). - Қажет болса pipeline/model sharding және бірнеше процесс/жұмысшы. - Тұрақтылық: - Request timeout, контекст/шығыс токен лимиттері, денсаулық тексерулері. - Warmup және модель прогретілуі; cold-start-ты азайту үшін алдын ала KV блоктарын резервтеу. - Сапа/құны: - FP8: жылдамдық/сапа жақсы балансты (H100). - 4-бит: VRAM үнемдейді, prefill/quality төмендеуі мүмкін; сыныпталған промпттармен тексеріп таңдаңыз. 9) Конфигурация үлгілері (нұсқаулық ретінде) - vLLM (жобаңыздағы нақты жалаушаларды құжаттан тексеріңіз): - BF16, 2×H100 80GB, 128k тиімді терезе, 1M позиция шкаласы: vllm serve --dtype bfloat16 --tensor-parallel-size 2 --max-model-len 1000000 --gpu-memory-utilization 0.9 (model config ішінде rope_scaling/ntk/longrope қосулы; paged-KV және offload конфигурациясын да енгізіңіз) - 4-бит AWQ, 1×80GB, ұзын контекст offload-пен: vllm serve --quantization awq --max-model-len 1000000 --tensor-parallel-size 1 --gpu-memory-utilization 0.95 - SGLang: - BF16/FP8 (TE қолдауы болса), TP=2: sglang serve --model --tp 2 --max-context-len 1000000 (paged-KV, rope_scaling және offload параметрлерін sglang конфигурациясында көрсетіңіз) - 4-бит GPTQ: sglang serve --model --tp 1 --max-context-len 1000000 10) Тексеру және бенчмарк - Correctness: қысқа және ұзын промпттарда жауап сапасын салыстырыңыз. - Жүктеме: prefill-heavy және decode-heavy сценарийлерін бөлек өлшеңіз. - Профилинг: GPU util, HBM BW, KV hit rate (paged), PCIe/NVLink толуы. - Параметр тюнингі: batch size, max_num_batched_tokens, swap-space, block size, concurrency. Ескерту - Нақты жалаушалар мен FP8/FP4/4-бит қолдауы бекенд нұсқаларына байланысты өзгереді. Қолданатын vLLM/SGLang нұсқасының құжатындағы дәл атауларды пайдаланыңыз. - 1M контекст практикасында сапа мен ресурстық шектеулерге байланысты selective window, offload және/немесе RAG секілді стратегиялармен біріктіру ұсынылады.
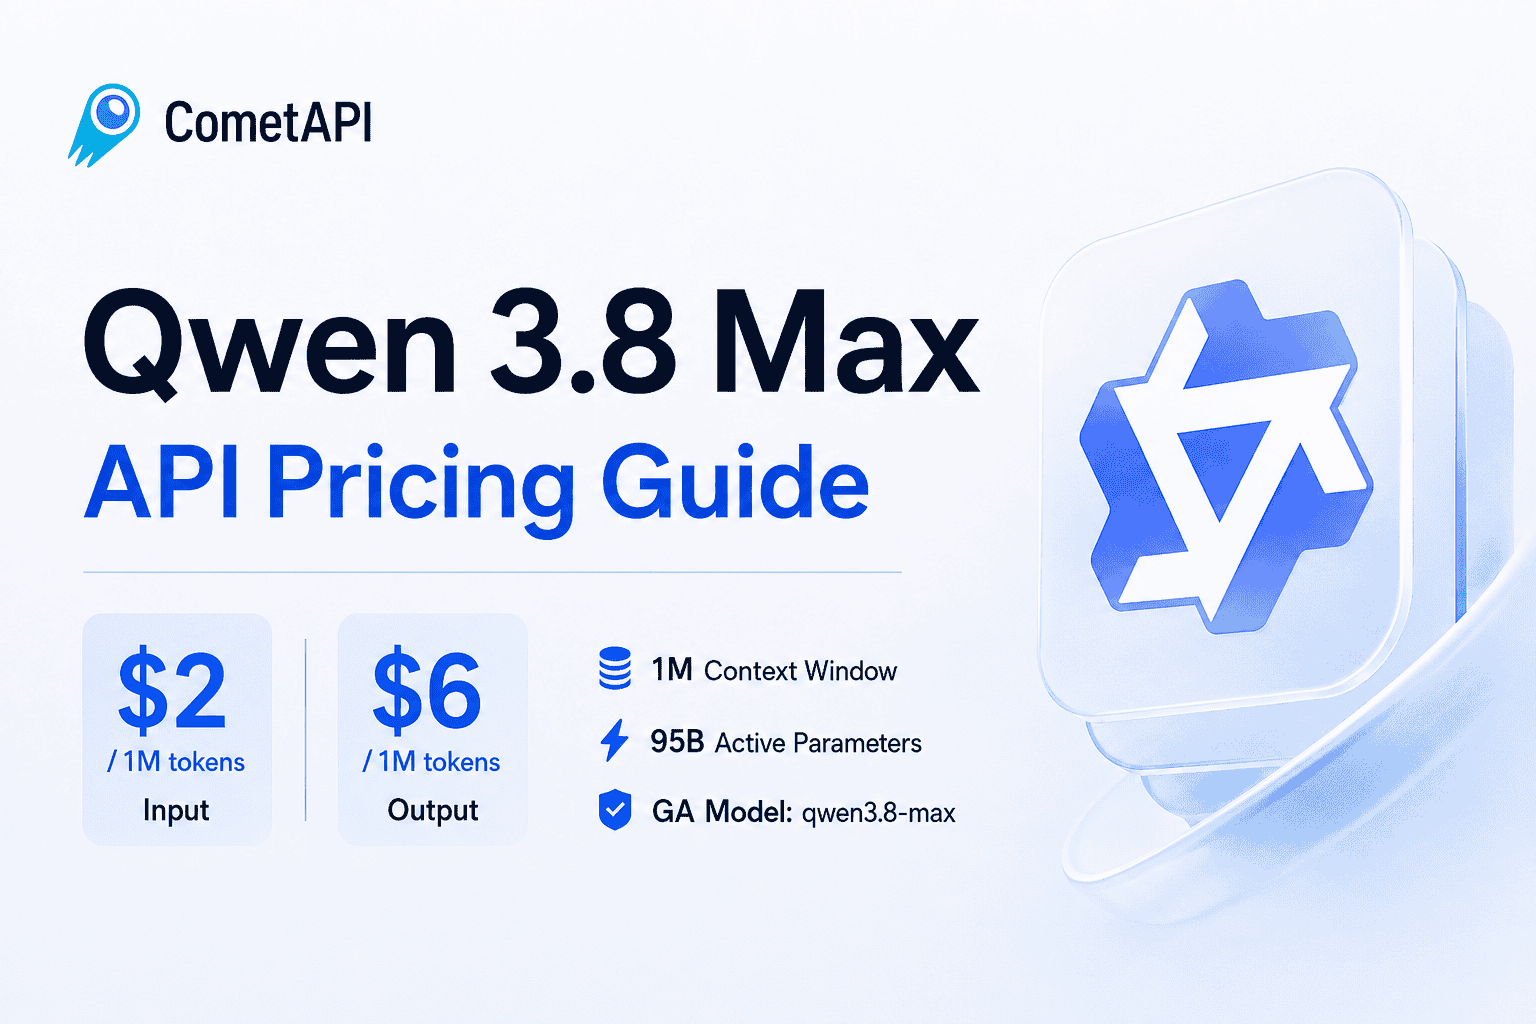
Qwen 3.8 Max API бағалары: $2 кіріс, $6 шығыс, 1M контекст
Qwen 3.8 Max құны енгізу үшін $2/M және шығару үшін $6/M. Кэш төлемдерін, құралдар құнын, нақты мысалдарды, шектеулерді және Qwen 3.7-ге көшу жөніндегі кеңестерді салыстырыңыз.
Qwen 3.5 API-ді қалай пайдалану керек
Ай күнтізбесі бойынша Жаңа жылдың қарсаңында (Feb 16–17, 2026), Alibaba Group келесі буындағы модель — Qwen 3.5-ті шығарды, ол компания “agentic AI” дәуірі деп атайтын кезеңге бағытталған мультимодальды, агенттік мүмкіндіктері бар модель. Салалық жарияланымдар тиімділік пен шығындар бойынша үлкен өсімдер туралы мәлімдемелерді және аппараттық және бұлттық жеткізушілер тарапынан жедел қолдауды атап өтті. CometAPI — хостингтелген API-ге қол жеткізуді немесе OpenAI-мен үйлесімді интеграцияны қалайтын әзірлеушілер үшін нұсқалар, ал AMD өзінің Instinct желісінде модель үшін Day-0 GPU қолдауын жариялады. ByteDance — дәл сол мерекелік кезеңде жаңартулар шығарған негізгі отандық бәсекелестердің бірі. OpenAI бенчмарк көрсеткіштері мен интеграция стилі бойынша салыстыру үшін анықтамалық нүкте болып қала береді.
Qwen-3.5 Ай күнтізбесі бойынша Жаңа жылда — ол 2026 жылы жабық бастапқы кодты үздіктерден оза ма?
Alibaba-ның жаңа Qwen3.5-і үлкен алға қадам — ол бірқатар қоғамдық бенчмарктер мен ішкі сынақтарда кейбір алдыңғы қатарлы жабық-кодты модельдермен арадағы алшақтықты жабады, ал кейбір агенттік/көпмодальды жүктемелерде паритетті немесе басымдықты көрсетеді деп мәлімдейді. Алайда, “outperform” жүктемеге байланысты: агенттік құралдарды пайдалану, көпмодальды құжат/бейне түсіну және бір инференске шаққандағы құн бойынша Qwen3.5 аса бәсекеге қабілетті деп хабарланады (және кейбір жеткізушілердің диаграммаларында алда). Практикалық қорытынды: Qwen3.5 2026 жылдың басында нағыз алдыңғы қатарлы үміткер болып көрінеді — көптеген кәсіпорындық агенттік және көпмодальды қолдану жағдайлары үшін ол енді негізгі нұсқа ретінде өміршең.
Qwen3-max thinking-ді қалай пайдалану керек
Alibaba компаниясының Qwen3-Max-Thinking — алып Qwen3 отбасындағы «ойлау» нұсқасы — биыл ЖИ саласындағы басты жаңалықтардың біріне айналды: триллионнан астам параметрі бар, терең пайымдауға, ұзақ контексті түсінуге және агенттік жұмыс ағындарына бейімделген флагмандық модель. Қысқасы, бұл өндірушінің қолданбаларға баяуырақ, ізі жақсы қадағаланатын «System-2» ойлау режимін ұсыну қадамы: модель тек жауап беріп қана қоймай, қадамдарды, құралдарды және аралық тексерулерді бақыланатын тәсілмен көрсете (және пайдалана) алады.
Alibaba AI Qwen3-Max ұсынады: триллион параметрлі Qwen моделі, CometAPI қолдайды
Alibaba-ның Qwen командасы Qwen3-Max-Preview (Нұсқау) шығарды — компанияның бүгінгі таңдағы ең үлкен моделі, 1 триллионнан астам параметрлері — және оны жасады
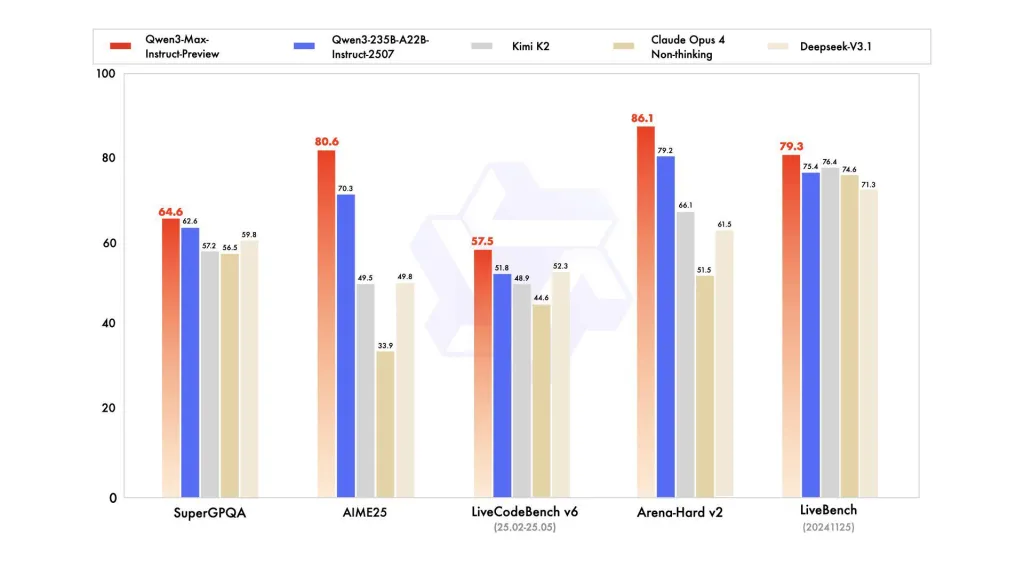
Qwen3-Max-Preview API
Qwen3-Max-Preview – Alibaba-ның Qwen3 отбасындағы ең соңғы алдын ала қарау үлгісі — триллион+-параметр, ультра ұзын 262к таңбалауыш мәтінмәндік терезесі бар Сарапшылар қоспасы (ММ) стилі үлгісі, кәсіпорын/бұлтты пайдалану үшін алдын ала қарауда шығарылды. Ол *терең негіздеуге, ұзақ құжатты түсінуге, кодтауға және агенттік жұмыс процестеріне бағытталған.