
요약
Anthropic는 Claude Sonnet 5.5의 입력 토큰을 $2/M, 출력 토큰을 $10/M로 공시합니다. CometAPI는 제3자 경로의 별도 요금으로 입력 $1.60/M, 출력 $8/M를 제시합니다. Sonnet 5.5는 Sonnet 5와 동일한 표준 입력·출력 요금을 유지하지만, 캐시 읽기 요금이 더 낮습니다. 승인된 작업당 비용은 캐시 적중, 토큰 사용량, 도구 호출, 재시도에 따라서도 달라집니다.
캐시 쓰기·읽기, 과금되는 출력 토큰(과금되는 reasoning 토큰 포함), 도구 사용, 재시도, 그리고 인간 검수나 수정에 대한 예산을 반영하세요. 작업 비용 개선은 워크로드에 따라 달라지며, 모든 요청에 일괄 적용되는 보편적 할인은 아닙니다.
핵심 포인트
- Claude Sonnet 5.5는 Claude API에서 입력 $2/M, 출력 $10/M이며, CometAPI 요금은 입력 $1.60/M, 출력 $8/M부터 시작합니다.
- 캐시 읽기는 $0.10/M; 쓰기는 5분 $2.50/M 또는 1시간 $4/M입니다. 절감액은 실제 캐시 적중과 재사용 시점에 좌우됩니다.
- Claude Batch API는 입력과 출력 요금을 50% 낮춥니다. 사용하는 경로에서의 가용성과 캐시 결합 과금을 확인하세요.
- Sonnet 5.5는 Sonnet 5의 표준 입력·출력 요금을 유지하되, 캐시 읽기 요금이 더 낮습니다. 승인된 작업당 더 낮은 비용은 토큰 사용량, 재시도, 도구, 완료 품질에 따라 달라집니다.
- 1M 토큰 컨텍스트와 128K 표준 출력 한도는 대형 작업을 지원합니다. 300K 출력은 Batch API 베타 옵션이며 표준 한도가 아닙니다.
한눈에 보는 Claude Sonnet 5.5 비용은?
아래 공식 Sonnet 5.5 토큰 요금은 백만 토큰(USD) 기준입니다. 캐시 쓰기, 읽기, 일반 입력은 서로 다른 과금 범주입니다. Batch는 비동기 처리 옵션이며 모든 게이트웨이에서 제공된다고 가정해서는 안 됩니다.
| Claude API mode | Input / 1M | Output / 1M | Cache treatment |
|---|---|---|---|
| Standard | $2.00 | $10.00 | Read $0.10; 5m write $2.50; 1h write $4.00 |
| Batch | $1.00 | $5.00 | Confirm combined Batch and cache billing |
Sonnet 5.5는 1M 토큰 컨텍스트 윈도우를 제공합니다. 예산 수립 전 선택한 제공자, 라우팅 지역, 적용 요금, 캐시 과금을 확인하세요. 컨텍스트 용량은 모델 한도이며, 다른 모델의 가격 임계값이나 처리 티어를 적용해야 할 이유가 아닙니다.
CometAPI에서 Claude Sonnet 5.5는 얼마입니까?
CometAPI의 Claude Sonnet 5.5 API는 Claude API 요금 대비 입력과 출력이 각각 20% 낮은 요금을 표시합니다. 2026년 10월 1일 기준 확인; 토큰 추정에는 도구, 재시도 및 기타 요금이 제외됩니다.
| Rate or workload | Claude API | CometAPI | Difference |
|---|---|---|---|
| Input / 1M | $2.00 | $1.60 | 20% lower |
| Output / 1M | $10.00 | $8.00 | 20% lower |
| 10K input + 2K output | $0.040 | $0.032 | $0.008 per request |
| 100K input + 10K output | $0.300 | $0.240 | $0.060 per request |
10K 입력, 2K 출력 요청 100,000건 기준 단순 토큰 추정치는 각각 $4,000과 $3,200로, 차이는 $800입니다. 100K 입력, 10K 출력 요청 10,000건 기준으로는 $3,000과 $2,400로, 차이는 $600입니다. 캐시 사용, 출력 변동, 재시도에 따라 총액은 달라집니다.
모델 토큰 너머의 비용
코딩 또는 리서치 에이전트는 검색, 브라우저, 스토리지, 애플리케이션 호스팅, 실행 리소스도 소비합니다. 도구 결과는 외부 작업 자체가 저렴하더라도 다음 프롬프트를 키울 수 있습니다. 실제로 도구를 실행하는 제공자의 호스팅 도구 가격을 확인하세요. 모델 토큰 할인은 별도 서비스까지 자동 할인하지 않습니다.
추론 노력과 총 지출
노력은 이 요율표에서 별도 곱셈 항목이 아닙니다. 그러나 과금되는 출력 토큰 수, 도구 반복, 재시도에 영향을 줄 수 있습니다. 동일한 작업 집합에서 노력 설정을 비교하고 총 비용과 함께 완료 품질을 보고하세요.
현실적 워크로드에서 Claude Sonnet 5.5 비용은?
이 통제된 예시는 캐시되지 않은 입력과 표준 요율의 과금 출력만 사용하며, 도구와 재시도를 제외합니다. 입력과 예약된 출력은 활성 컨텍스트 한도 내에 들어가야 합니다.
| Workload | Input | Output | Claude API estimate | CometAPI estimate |
|---|---|---|---|---|
| Small coding request | 10K | 2K | $0.040 | $0.032 |
| Document analysis | 100K | 10K | $0.300 | $0.240 |
| Long agent turn | 300K | 20K | $0.800 | $0.640 |
| Repository task | 800K | 40K | $2.000 | $1.600 |
300K 입력, 20K 출력 예시에서 Claude API 비용은 (300,000 / 1,000,000 × $2) + (20,000 / 1,000,000 × $10) = $0.80입니다. 입력 $1.60/M, 출력 $8/M일 때 CometAPI의 해당 계산은 $0.64입니다. 두 추정 모두 일반 캐시되지 않은 입력과 표준 과금 출력을 가정하며, 도구와 재시도를 제외합니다.
멀티턴 에이전트는 누적 히스토리를 반복 전송할 수 있습니다. 최종 답변만 가격을 매기지 말고, 실패한 실행을 포함해 모든 요청의 합계를 추정하세요. 승인된 작업당 비용은 측정된 총 워크로드 지출을 승인된 작업 수로 나눈 값입니다. 인간 검수 시간은 별도로 보고할 수 있습니다.
무엇이 Claude Sonnet 5.5를 더 비용 효율적으로 만드나요?
더 빠른 출력 생성. Anthropic는 Sonnet 5 대비 Sonnet 5.5가 30% 이상 빠르게 출력을 생성한다고 말합니다. 더 빠른 생성은 토큰당 과금을 직접 낮추지는 않지만, 처리량을 개선하고 상호작용형 에이전트 루프의 지속 시간을 줄일 수 있습니다.
작업당 토큰 감소. 가장 큰 절감은 동일한 결과를 더 적은 reasoning, 도구, 최종 출력 토큰으로 달성할 때 발생합니다.
에이전트 단계 감소. 반복적인 도구 호출은 대화 히스토리와 도구 출력이 종종 모델에 다시 전송되기 때문에 컨텍스트를 증폭시킬 수 있습니다. 불필요한 도구 반복 하나를 줄이면, 고립된 한 번의 생성 요금 이상을 제거할 수 있습니다.
적응적 노력. Sonnet 5.5는 적응적 사고를 지원하며 Claude Platform에서 기본적으로 높은 노력을 사용합니다. 필요하지 않은 워크로드에서는 낮은 노력 설정으로 일부 추론 깊이를 포기하고 더 짧고 빠르며 저렴한 응답을 선택할 수 있습니다.
따라서 중요한 최적화 목표는 모든 비용을 무릅쓰고 토큰을 최소화하는 것이 아닙니다. 승인된 결과당 최저 비용입니다.
Claude Sonnet 5.5란?
Claude Sonnet 5.5는 2026년 9월 28일 출시된 Anthropic 모델입니다. 1M 토큰 컨텍스트와 텍스트·이미지 입력을 통해 텍스트 출력을 기반으로 코딩, 에이전트, 문서 분석을 지원합니다. Claude API는 기본적으로 높은 노력을 사용합니다. 워크로드의 품질과 비용을 측정해 적절한 노력을 선택하세요.
| Specification | Claude Sonnet 5.5 |
|---|---|
| Provider | Anthropic |
| Claude API model ID | claude-sonnet-5-5 |
| Release date | September 28, 2026 |
| Context window | 1M tokens |
| Maximum output | 128K tokens |
| Batch API max output | 300K tokens, beta |
| Input | Text, images |
| Output | Text |
| Thinking | Adaptive |
| Default API effort | High |
| Reliable knowledge cutoff | June 2026 |
| Official input price | $2/M tokens |
| Official output price | $10/M tokens |
| Cache read | $0.20/M tokens |
| 5-minute cache write | $2.50/M tokens |
| 1-hour cache write | $4/M tokens |
| Batch API | 50% discount |
Claude Sonnet 5.5로 어느 정도 성능을 구매하는 걸까요?
공식 평가 방법론은 테스트 설정을 구분합니다. 별도 언급이 없으면, 요약은 적응적 사고, Max 노력, 기본 샘플링, 5회 시험을 사용합니다. 과거 모델 구성은 다를 수 있습니다. 이 가격 중심 비교는 세 가지 코딩·에이전트 벤치마크(내 Terminal-Bench, FrontierCode, CursorBench)를 유지합니다. 아래 취소선 5개 행은 개정 본문에서 제거되었으며 검토를 위해 여기만 유지합니다.
| Benchmark / metric | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | Evaluation setting |
|---|---|---|---|---|
| Terminal-Bench 4.0 / success | 70.6% Max | 10.3% | 66.4% Xhigh | 66 containerized terminal tasks; Sonnet uses Claude Code --bare, no internet egress, safeguards enabled |
| FrontierCode 1.1 Main / score | 46.2% Max | 42.4% | 54.4% | Repository patches in containers with internet access; held-out tests and rubric grading |
| CursorBench 4.0 / score | 55.5% Max | 34.1% | 57.8% | Real coding tasks in Cursor production agent harness; independently measured by Cursor |
이 세 벤치마크는 터미널 에이전트 작업, 저장소 패칭, 프로덕션 에이전트 하니스에서의 코딩을 다룹니다. 점수는 동일 노력 비교나 측정된 비용 우위를 의미하기보다 서로 다른 평가 설정을 설명합니다. 가성비를 평가하려면 대표 작업을 재현하고 캐시 사용, 도구, 재시도 포함하여 승인된 결과당 총 지출을 비교하세요.
프롬프트 캐싱은 Claude Sonnet 5.5 입력 비용을 어떻게 바꾸나요?
Anthropic의 프롬프트 캐시 가격은 5분 쓰기, 1시간 쓰기, 성공적인 읽기를 구분합니다. $0.10/M 읽기는 $2/M 일반 입력 대비 95% 낮지만, 이 비율은 재사용된 입력 토큰에만 적용됩니다.
| Operation | Claude API price / 1M |
|---|---|
| Ordinary input | $2.00 |
| 5-minute write | $2.50 |
| 1-hour write | $4.00 |
| Successful read | $0.10 |
동일한 100K 토큰 접두어를 포함하는 10개의 요청을 가정해 보세요. 만료 전 5분 쓰기 1회 후 전체 접두어 읽기 9회가 성공한다고 가정하며, 추가 쓰기는 없고 나머지 프롬프트와 출력을 위한 충분한 컨텍스트가 있다고 가정합니다.
| Repeated-prefix component | No caching | One write + nine reads |
|---|---|---|
| Ordinary prefix input | 10 × 100K × $2/M = $2.00 | $0.00 |
| Initial write | $0.00 | 100K × $2.50/M = $0.25 |
| Nine reads | $0.00 | 9 × 100K × $0.10/M = $0.09 |
| Repeated-prefix total | $2.00 | $0.34 |
반복 접두어 자체에 대한 절감은 83%입니다. 각 요청이 2K 과금 출력 토큰도 생성한다면, 출력이 10개 요청 전체에서 $0.20 추가됩니다. 모델 토큰 총액은 캐싱 없이 $2.20, 캐싱 시 $0.54로 약 75.5% 감소입니다. 추가 입력, 캐시 만료, 재작성된 접두어, 도구에 따라 청구서는 다시 달라집니다.
성공적인 읽기와 쓰기를 별도로 추적하세요. 반복 프롬프트가 곧 캐시 적중의 증거는 아닙니다. 이 예시는 Claude API 요금을 설명합니다. 동일한 추정을 적용하기 전에 선택한 CometAPI 경로의 캐시 요금과 사용 보고를 확인하세요.
Claude Sonnet 5.5는 다른 모델과 어떻게 비교되나요?
Claude Sonnet 5.5 vs Claude Sonnet 5
Claude API 가격 비교에서 두 모델 모두 입력 $2/M, 출력 $10/M로 같습니다. Sonnet 5의 캐시 읽기는 $0.20/M인 반면, Sonnet 5.5의 캐시 읽기는 $0.10/M입니다. CometAPI의 Claude Sonnet 5 API와 Sonnet 5.5를 평가하는 개발자는 모델 업그레이드에서 토큰 요율 절감이 있다고 추정하지 말고 승인된 작업 지출을 비교해야 합니다.
Anthropic는 Sonnet 5.5가 작업 비용을 최대 30% 낮춘다고 보고하며 출력 생성도 더 빠릅니다. 이는 공급업체가 보고한 워크로드 결과이지, 요율표가 30% 인하된 것이 아닙니다. 토큰, 도구 반복, 재시도가 줄어들면 청구서가 바뀝니다. 귀하의 승인 기준을 사용해 이러한 수량을 직접 측정하세요.
두 모델이 동일한 캐시되지 않은 입력·출력 토큰을 소비하고 성공률도 동일하다면, 표준 토큰 청구서는 동일합니다. 캐시 읽기에서는 토큰 수가 동일하더라도 청구서가 달라질 수 있습니다. 더 많은 작업을 완료하거나 수정이 덜 필요한 모델이 경제적으로 더 나을 수 있습니다. 실패한 시도를 포함해 전체 평가 집합의 총 지출을 비교하세요.
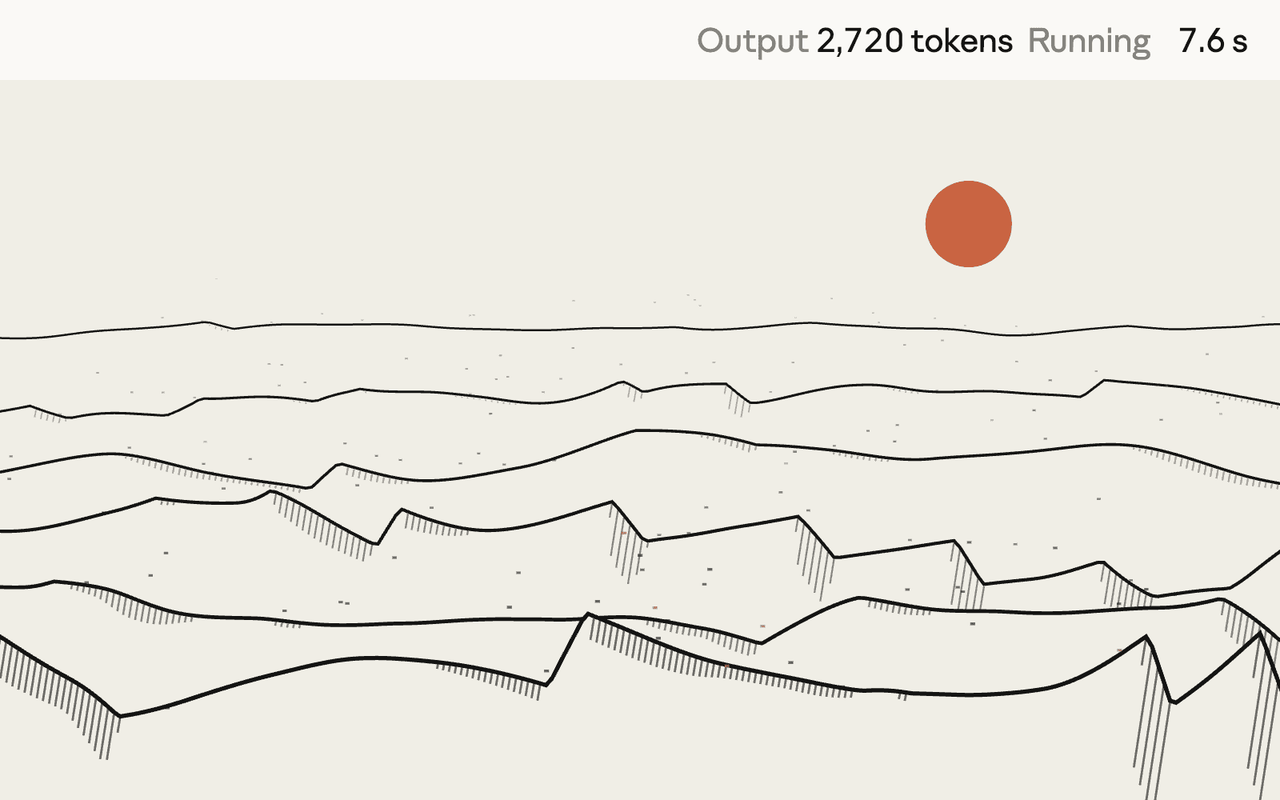
Anthropic의 공개 Sonnet 5.5 사구 코딩 데모.
Anthropic의 사구 데모는 공식 제품 데모의 코딩 출력을 보여줍니다. 이 이미지는 단일 예시일 뿐, 지연 보장이나 재현 가능한 비용 벤치마크가 아닙니다.
Claude Sonnet 5.5 vs Claude Opus 5.5
| Model | Input / 1M | Output / 1M | Cache Read | Context |
|---|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | 1M |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 1M |
Anthropic는 Opus 5.5에 대해 1M 컨텍스트, 128K 출력, 입력 $4/M, 출력 $20/M를 문서화합니다. CometAPI의 Claude Opus 5.5 API는 복잡하고 개방형 작업의 대안입니다. Sonnet 5.5는 명목상 표준 토큰 요금이 절반입니다. 에스컬레이션 경로에는 실패한 Sonnet 시도, 검증, 재시도가 결합 비용에 포함되어야 합니다.
Claude Sonnet 5.5 vs GPT-6 Sol
OpenAI는 GPT-6 Sol 가격과 모델 한도를 문서화합니다. 표준 요금은 입력 272K 토큰까지 Sonnet과 같습니다. 그 입력 임계값을 넘으면 GPT-6 Sol은 전체 요청에 대해 입력 $4/M, 출력 $15/M를 적용합니다. 컨텍스트 용량과 저요율 경계는 서로 다른 한도입니다.
| Dimension | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| Standard input / output, USD per 1M | $2 / $10 | $2 / $10 for input up to 272K |
| Standard input / output above 272K input | $2 / $10 | $4 / $15 for the full request |
| Context / standard max output | 1,000,000 / 128,000 | 1,050,000 / 128,000 |
| Native modalities | Text and images in; text out | Text and images in; text out |
| Reasoning control | Adaptive thinking; default high | Effort none through max; default medium |
| Direct API integration | Claude Messages API | Responses; Chat Completions has tool-calling constraints |
GPT-6 Sol은 Responses를 통해 내장 도구를 지원합니다. Chat Completions 함수 호출은 reasoning_effort=none이 필요합니다. 개발자는 CometAPI의 GPT-6 Sol API를 평가할 수 있지만, 게이트웨이 호환성과 실시간 요금은 별도로 확인해야 합니다. 두 모델 모두 선택한 노력과 가격 티어에서 총 토큰, 도구, 재시도, 지연, 승인된 작업 완료를 비교하세요.
Claude Sonnet 5.5 API 비용을 줄이는 방법은?
- 시스템 프롬프트, 도구 스키마, 코딩 규약, 대용량 정적 문서 같은 안정적 접두어를 캐시하세요.
- 불필요한 컨텍스트 성장을 줄이기 위해 오래된 도구 결과와 이전 대화 내용을 가지치기하거나 요약하세요.
- 간단한 분류나 포매팅 작업에는 최대 추론 대신 작업 난이도에 맞는 노력 수준을 사용하세요.
- 즉각 응답이 필요 없는 워크로드에는 Batch 처리를 사용하세요.
- 백만 토큰당 비용이 아니라, 성공한 작업당 비용을 평가하세요.
Claude Sonnet 5.5는 가격 대비 가치가 있나요?
Claude Sonnet 5.5의 가격 전략은 독특합니다. Anthropic는 표준 입력·출력 요금을 유지하면서 캐시 읽기 요금을 낮췄습니다. Sonnet 5와 동일한 입력 $2/M, 출력 $10/M를 유지하면서 각 작업에 필요한 모델 작업량을 줄이는 데 초점을 맞췄습니다.
워크로드가 단순히 동일한 수의 캐시되지 않은 입력·출력 토큰을 생성한다면, Sonnet 5.5는 Sonnet 5 대비 공식적으로 토큰당 절감을 만들어내지 않습니다. 그러나 더 강한 코딩, 도구 사용, 더 간결한 실행으로 에이전트 턴, 재시도, 출력 토큰이 줄어든다면, 동일한 토큰 요율에서도 청구서가 감소할 수 있습니다.
Anthropic의 작업당 최대 30% 비용 절감 주장은 워크로드 의존적 효율 결과로 받아들여야 하며, 보편적 30% API 할인으로 간주하면 안 됩니다. 마이그레이션 테스트에서는 실제 프로덕션 작업 집합을 고정해 양쪽 모델로 재생하고, 총 입력, 캐시된 입력, 생성 토큰, 도구 호출, 완료율, 지연, 총 비용을 기록하세요.
결론
Claude Sonnet 5.5는 익숙한 토큰 요율에 효율 중심 업그레이드를 결합합니다. 측정된 작업 완료, 캐시 재사용, 노력, 도구 활동, 재시도를 사용해 실제 가치를 판단하세요. 마이그레이션 전에 대표 작업 집합을 양쪽 모델에서 재생하고, 현재 제공자 요금을 기준으로 승인된 작업 비용, 완료율, 재시도, 지연을 비교하세요.
FAQ
팀이 가변 출력 길이를 예산에 어떻게 반영할 수 있나요?
프로덕션 요청을 하나의 평균 응답에 의존하지 말고 워크로드별로 그룹화하세요. 각 그룹에 대해 과금 입력, 출력, 재시도, 캐시 사용을 측정한 다음 적용 요율로 예상 월간 물량을 계산합니다. 관측된 장문 응답을 반영해 중심 추정과 고사용 시나리오를 보고하고, 분포나 트래픽 믹스가 변하면 예산을 업데이트하세요.
Sonnet 5.5 에이전트는 언제 더 긴 캐시 수명을 사용해야 하나요?
예상 재사용 타이밍을 재작성 비용과 비교하세요. 1시간 쓰기는 초기 비용이 5분 쓰기보다 높지만, 더 긴 시간이 지난 뒤에 유효한 요청이 도착한다면 가치가 있을 수 있습니다. 동일 접두어에 대해 각 옵션에서 예상되는 쓰기와 적중을 계산하고, 모든 반복 요청을 적중으로 간주하지 말고 실제 사용을 검증하세요.
Sonnet 5.5와 Opus 5.5의 에스컬레이션 전략은 어떻게 평가하나요?
동일한 작업 집합을 Sonnet 전용, Opus 전용, Sonnet 우선 경로로 재생하세요. 검증 실패 또는 미달한 승인 기준에서 에스컬레이션 트리거를 정의하고, 결합 경로 비용에 실패한 Sonnet 시도도 포함하세요. 승인된 작업 완료, 총 지출, 수정 시간, 지연을 비교한 뒤 워크로드에 대해 에스컬레이션이 비용을 줄이는지 결정하세요.