
TL;DR
Z.AI는 GLM-6.0이라는 이름을 공개적으로 명명하고 차세대 로드맵의 중심에 Full Self-Training을 배치했다. 공개된 방향은 사전 학습, 중간 학습, 사후 학습 전반에 걸쳐 자체 생성 경험을 자체 평가와 교정에 연결하여, 학습을 단일 데이터 생성 한 번이 아니라 관리되는 피드백 루프로 전환한다.
난점은 통제다: GLM-6.0은 합성 데이터를 정제하고, 오류를 탐지·수정하며, 비생산적 반복을 중단하고, 평가자가 편법에 보상을 주지 않도록 해야 한다. 이러한 메커니즘은 독립적 검증, 안전성, 비용, 거버넌스에 관한 실무적 질문을 제기한다. 완전한 모델 카드, 벤치마크 모음, API 명세, 가격, 출시일이 공개되지 않았기에, 본 글은 추정적 사양이 아니라 학습 아키텍처와 그 증거를 평가한다.
Key Takeaways for GLM 6.0?
- 가장 강력한 공개 증거는 누설된 파라미터 수나 벤치마크 결과가 아니라 Full Self-Training 시스템에 관한 것이다.
- 공개된 방향은 자체 생성 데이터, 자체 구성 학습 환경, 모델 보조 인프라 최적화를 포괄한다.
- 의도된 피드백 루프는 사후 학습에만 한정하지 않고 사전·중간·사후 학습 전반을 아운다.
- 네이티브 멀티모달 모델링, 더 긴 지평의 강화학습, 계획, 도구 사용, 복구, 검증은 관련 연구 방향이지만, 아직 공개된 GLM 6.0 사양이 아니다.
- Ox Alpha는 누설된 GLM 6.0 성능의 증거가 아니다; Z.AI는 이를 GLM-5.3-Flash의 사전 배포 아이덴티티로 식별했다.
What Has Z.AI Actually Confirmed About GLM 6.0?
Z.AI의 공개 자료는 네 가지 구체적 신호를 확립한다: GLM-6.0이라는 이름, Full Self-Training을 핵심 학습 방향으로 삼는다는 점, 사전·중간·사후 학습을 관통하는 의도된 루프, 그리고 자체 평가 및 교정 메커니즘. 또한 순수익의 약 60%를 차세대 모델, Full Self-Training, 대규모 학습, 추론, 연산 및 관련 인프라 지원에 투입할 계획임을 명시했다.
Z.AI’s Full Self-Training Framework
Full Self-Training은 GLM-6.0을 위한 조직 원리로 제시되며, 사후 학습의 작은 기능이 아니다. 의도된 시스템은 학습 경험을 생성하고, 결과에서 학습하며, 약한 샘플을 필터링하고, 명시적 품질 통제 하에 사이클을 반복한다.
GLM-6.0 Self-Training Across Pre-, Mid-, and Post-Training
공개된 순서(사전 학습 → 중간 학습 → 사후 학습)는 자체 생성 경험이 파운데이션 지식, 능력 형성, 작업 정렬에 영향을 줄 수 있음을 시사하며, 최종 튜닝 단계에만 나타나는 것이 아님을 의미한다. Z.AI는 데이터셋, 단계 경계, 혼합 비율을 공개하지 않았으므로, 이는 완전한 레시피가 아니라 확인된 방향으로 보아야 한다.
GLM-6.0 Self-Evaluation and Correction Mechanism
로드맵은 Full Self-Training을 자체 평가, 오류 탐지, 교정, 데이터 자체 정화와 연결한다. 실무적으로, 모델은 경로를 판별하고, 실패한 단계를 수정하며, 신뢰성이 낮은 데이터를 폐기하고, 독립적 성능 지표가 더 이상의 반복이 개선에 기여하지 않는다고 판단할 때 중단해야 한다. 평가자 설계와 중단 규칙은 아직 비공개다.
The GLM-6.0 and Full Self-Training disclosure should be read together with Z.AI’s public proceeds allocation.
What We Know vs What We Don't
공개 기록은 로드맵을 뒷받침하지만, 완성된 사양을 뒷받침하지는 않는다. 아래 표는 공개된 의도와 미확정 요소를 구분하여, 공개된 의도를 근거 없는 제품 주장으로 바꾸지 않도록 한다.
| 주장 | 증거 상태 | 지원되는 내용 | 아직 알려지지 않은 사항 |
|---|---|---|---|
| GLM-6.0 이름 | 공개 확인 | Z.AI가 차세대 모델을 GLM-6.0으로 명명했다. | 출시일과 최종 포지셔닝. |
| Full Self-Training | 로드맵 확인 | 전략적 최우선 과제로 명시되어 있다. | 구현 세부와 스케일링 거동. |
| 사전 학습 → 중간 학습 → 사후 학습 | 방향 확인 | 셀프 트레이닝이 학습 생애주기를 관통하도록 의도되어 있다. | 데이터셋, 검증기, 단계 경계, 데이터 비율. |
| 자체 평가 및 교정 | 목표 확인 | 로드맵에 자체 정화, 오류 탐지, 교정이 포함된다. | 신뢰성, 독립적 검증, 중단 기준. |
| 명세 | 미공개 | 완전한 공개 사양 없음. | 파라미터, 컨텍스트 윈도우, 모달리티, 가격, API 식별자. |
| 벤치마크 | 미공개 | 공식 GLM-6.0 결과 집합 없음. | 점수, 방법론, 독립적으로 재현 가능한 결과. |
What Is Full Self-Training and how it work
Full Self-Training은 모델이 과제나 환경을 만드는 데 참여하고, 이를 시도한 뒤, 생성된 경로를 평가하고, 약한 단계를 교정하며, 승인된 경험을 다시 학습에 반영하는 닫힌 학습 루프다. 중요한 변화는 일회성 합성 데이터 파이프라인에서 지속적으로 관리되는 프로세스로의 전환이다.
- Generate: 문제, 도구 환경, 후보 해법 경로를 구성한다.
- Act: 과제를 수행하고, 행동·관찰·중간 추론을 경로로 보존한다.
- Evaluate and correct: 검증기로 결과를 점수화하고, 오류를 탐지하고, 실패한 단계를 수정하며, 신뢰도가 낮은 샘플을 거부한다.
- Train and stop: 승인된 경험으로 학습하고, 독립적 평가에서 유의미한 개선이 확인되는 동안에만 계속한다.
이 루프를 사전·중간·사후 학습으로 확장하면, GLM-6.0은 각 단계에서 데이터 품질, 능력 형성, 작업 정렬을 향상시킬 수 있다. 이 아키텍처는 여전히 신뢰할 수 있는 평가자에 의존한다: 독립적 점검 없이 셀프 트레이닝은 자신의 맹점을 스스로 보상할 수 있다.
How Could Full Self-Training Change GLM 6.0?
공개된 설계는 단일한 새로운 Transformer 블록이 아니라 시스템 아키텍처로 이해하는 것이 바람직하다. 목표는 모델을 둘러싼 루프를 닫아, 모델이 다음 학습 사이클에 필요한 자원을 점점 더 많이 생성하도록 하는 것이다.
How could GLM 6.0 produce training data?
첫 번째 루프는 데이터 자가 생산이다. 사람 작성이나 외부 수집 데이터에만 의존하는 대신, 모델은 셀프 플레이, 규칙 기반 점검, 실행 결과, 모델 판정, 인적 스팟 점검을 활용해 새로운 예제를 생성·여과할 수 있다. 승인된 예제는 사전·중간·사후 학습으로 다시 흘러간다.
중요한 제약은 검증이다: 저비용 합성 생성은 시스템이 정확하고, 다양한, 퇴화하지 않은 예제를 식별할 수 있을 때에만 유용하다. 실용적인 루프는 모델 생성 → 과제 실행 → 규칙 또는 도구 검증 → 필터링 → 재학습이다.
How could GLM 6.0 construct training environments?
두 번째 루프는 환경 자가 구성이다. 에이전트는 실제 과제를 수집·변환하고, 이를 시도하며, 검증기를 만들고, 학습 자료가 되기 전에 과제가 실제로 풀 수 있는지 확인할 수 있다. 이는 특히 코딩과 에이전트 작업에서 중요하다. 터미널 상태, 도구 출력, 브라우저 상태, 테스트 결과, 실패 복구는 텍스트만으로 된 답변보다 더 강한 감독 신호를 제공한다.
평가의 목표는 답변이 그럴듯해 보이는지에서, 행동이 성공하는지, 결과가 독립적으로 검증 가능한지, 에이전트가 실패 후 복구할 수 있는지로 이동한다.
How could GLM 6.0 optimize its training infrastructure?
세 번째 루프는 인프라 자가 최적화다. 실무적으로 이는 AI 보조 시스템 엔지니어링으로 해석하는 것이 가장 적절하다: 강한 코딩 모델이 연산자, 커널, 스케줄링, 캐싱, 서빙 코드에 대한 변경을 제안하고, 자동화된 벤치마크와 사람 주도의 검증이 어떤 변경을 수용할지 결정한다.
결과적인 사이클은 더 나은 모델 → 더 나은 시스템 제안 → 검증된 효율 향상 → 더 많은 학습 실험 → 더 나은 모델이다. 인간 검토와 재현 가능한 벤치마크는 선택적 요소가 아니라 통제 지점으로 남는다.
What Does the Current GLM 5.3 Flash Baseline Tell Us About GLM 6.0?
GLM 6.0에 대한 공개 모델 카드가 없기 때문에, 가장 방어적인 비교는 현재 측정된 GLM 역량과 차세대 방향을 분리하는 것이다. Z.AI는 GLM-5.3-Flash를 320B 총, 18B 활성 MoE 모델이며 30T 토큰 멀티모달 말뭉치로 학습됐다고 설명한다. 이는 GLM-5.3-Flash 사양이며 GLM 6.0 사양이 아니다.
| 비교 차원 | CometAPI의 GLM-5.3-Flash API | GLM 6.0 공개 방향 |
|---|---|---|
| 출시 상태 | 사용 가능 | 개발 중; 인용된 공시로 최종 제품명이 독립적으로 확립된 것은 아님 |
| 파라미터 | 총 320B / 활성 18B | 미공개 |
| 코어 아키텍처 | MoE; 하이브리드 스파스 + 선형 어텐션; mHC | 블록 수준에서 미공개 |
| 학습 데이터 | 30T 토큰 멀티모달 말뭉치 | 자체 생성 데이터가 재귀 루프로 유입될 예정 |
| 멀티모달리티 | 네이티브 멀티모달 입력 | 통합 멀티모달 모델링은 연구 방향이며, 공개된 사양은 아님 |
| 학습 단계 | 공개된 단계별 학습 레시피 | 사전·중간·사후 학습 전반의 셀프 트레이닝 |
| 학습 환경 | 연구자가 설계·벤치마크한 환경 | 에이전트가 환경 구성과 검증을 보조 |
| 검증 | 기존 평가 및 학습 파이프라인 | 더 강한 자체 판정, 실행 피드백, 자체 검증 |
| 인프라 | 최적화된 추론 스택 | 모델이 인프라 최적화를 보조 |
| API 세부 | 공개된 모델 ID 및 라이브 API | 미공개 |
Z.AI의 릴리스 텍스트는 GLM-5.3 API 대비 GLM-5.3-Flash의 어텐션 연산량이 약 3.0× 낮고 KV 캐시 크기가 4.4× 작다고 보고한다( GLM-5.3 API ). 동반된 공식 그래픽은 백만 토큰 비교에서 어텐션 연산을 3.40×, 레이어별 KV 캐시를 3.80×로 표시한다. 두 공식 자료가 서로 다른 수치를 사용하고 있으므로, 이를 하나의 측정값으로 합치지 말고 각 문맥과 함께 보고해야 한다.
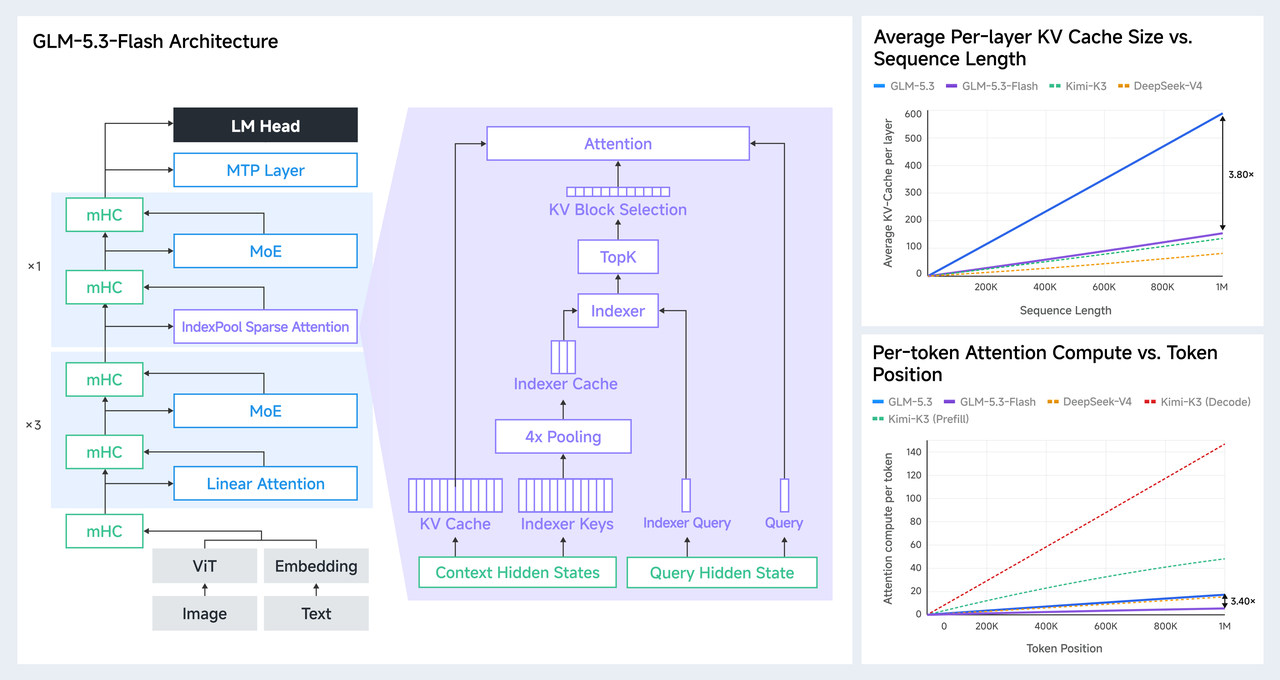
Z.AI가 공개한 공식 GLM-5.3-Flash 아키텍처 및 효율 비교
Which Benchmark Results Form the GLM 6.0 Baseline?
검증된 GLM 6.0 벤치마크 표는 공개되어 있지 않다. 현재 GLM 세대는 공개된 Full Self-Training 방향과 가장 관련 있는 능력—계획, 코딩, 도구 사용, 자동화, 장기 지평 실행—을 측정하기 때문에, 기준선으로서만 유용하다.
| 공식 Z.AI 평가 | GLM-5.3-Flash | GLM-5.2 | 보고된 차이 |
|---|---|---|---|
| Terminal Bench 2.1 | 84.3 | 81.0 | +3.3 |
| DeepSWE v1.1 | 63.4 | 46.2 | +17.2 |
| NL2Repo | 56.3 | 48.9 | +7.4 |
| Toolathlon Verified | 78.4 | 59.9 | +18.5 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | +22.6 |
| Agents’ Last Exam | 26.3 | 20.4 | +5.9 |
| HLE with Tools | 55.3 | 54.7 | +0.6 |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | +269 Elo |
비교는 단일 점수 순위가 아니라 다차원적이다. GLM-5.3-Flash는 AutomationBench(+22.6), Toolathlon Verified(+18.5), DeepSWE(+17.2)에서 가장 큰 보고된 향상을 보이는 반면, HLE-with-Tools 차이는 +0.6에 그친다. 이는 모든 형태의 도구 보조 추론에서 일괄적인 향상을 예고하기보다, 실행 중심 에이전트 과제에서 더 강한 향상을 시사한다. 이는 GLM 6.0 점수를 예측하지 않는다.
Why these benchmarks matter
여기서 벤치마크가 중요한 이유는 Full Self-Training이 개선하려는 능력을 드러낼 때뿐이다. 아래 표의 여섯 범주는 올바른 결과물을 생성하는 것에서 실제 환경에서의 효과적 행동 유지로 이어지는 발전 단계를 형성한다. 코딩은 모델이 복잡한 과제를 실행할 수 있는지 시험하고, 도구 사용은 행동을 피드백으로 전환해 다음 단계를 선택할 수 있는지 시험하며, 자동화는 긴 워크플로 전반에서 그 루프를 유지할 수 있는지 시험한다.
| 벤치마크 범주 | GLM-6.0에 중요한 이유 |
|---|---|
| 코딩 | 복잡한 과제 실행을 테스트 |
| 도구 사용 | 행동→피드백 루프를 테스트 |
| 자동화 | 장기 지평 워크플로 실행을 테스트 |
| HLE | 복잡한 전문가 수준 문제 해결을 테스트 |
| GDPval | 전문 작업 품질을 테스트 |
| 멀티모달 | 시각적 피드백 활용을 테스트 |
HLE는 해결되는 문제의 난도를 높이고, GDPval은 산출물이 전문 업무에 유용한지 묻고, 멀티모달 평가는 시각적 관찰이 이후 행동을 이끌 수 있는지 시험한다. 함께 읽으면, 여섯 범주는 고립된 역량에서 종단 간 과제 완수로 이동한다: 계획을 수립하고, 행동하고, 피드백을 관찰하고, 오류를 교정하며, 목표를 달성할 때까지 계속한다.
따라서 미래의 GLM-6.0 결과가 의미를 갖는 이유는 단지 더 높은 총점을 내서가 아니라, 이러한 차원 전반의 향상이 자체 생성 학습 경험이 신뢰할 수 있는 실제 환경 실행으로 이전됨을 보여주기 때문이다. Full Self-Training의 궁극적 목표는 시험 점수를 올리는 것이 아니라, 모델이 실제 세계 과제를 완수하는 능력을 향상시키는 것이다.
Why Could Full Self-Training Matter for GLM 6.0?
핵심은 GLM 6.0이 단순히 “스스로 학습한다”는 약속이 아니다. 더 의미 있는 변화는 개발 파이프라인의 더 많은 부분이 기계 생성 및 기계 검증으로 전환될 수 있다는 점이다. 오늘날에도 연구자들은 여전히 모델 주변의 많은 작업—데이터 수집, 과제 설계, 평가기 구축, 환경 구성, 실패 진단, 시스템 소프트웨어 튜닝—을 수행한다. Full Self-Training은 이러한 단계들 가운데 더 많은 부분으로 모델을 끌어들인다.
접근이 효과적이라면, 중요한 스케일 변수는 더 많은 파라미터를 추가하는 능력보다, 단위 연산 대비 얼마나 많은 유용하고 검증된 학습 사이클을 실행할 수 있는지가 된다. 이는 무제한 자율적 자기 수정의 공상과학적 버전이 아니라, 재귀적 자기 개선을 실용적으로 해석한 것이다.
공개된 전략은 검증기, 재현 가능한 환경, 인프라 벤치마크, 인간 통제가 있는 엔지니어드 피드백 시스템으로 평가해야 하며, 무제한 자율적 자기 개선의 증거로 받아들여서는 안 된다.
What Could Go Wrong With Full Self-Training?
셀프 트레이닝 루프는 유용한 경험을 축적하는 만큼이나 실수를 복합적으로 증폭할 수도 있다. 네 가지 실패 모드에 특히 주의할 필요가 있다:
- 오류 증폭: 약한 합성 경로가 미래 학습 데이터가 되어, 그럴듯하지만 틀린 패턴이 스스로 강화될 수 있다.
- 보상 및 평가자 게임화: 동일한 시스템이 작업을 생성하고 판정까지 하면, 실제 과제 성공이 아니라 검증기의 빈틈을 최적화할 수 있다.
- 분포 축소: 모델 생성 데이터에서 반복 학습하면 다양성이 줄어들고, 드문 실제 사례 대응력이 약화될 수 있다.
- 비용·보안·거버넌스 압박: 환경 구성, 도구 접근, 지속적 반복은 연산 수요를 늘리고 공격 표면을 확장한다.
신뢰할 수 있는 GLM-6.0 구현은 따라서 독립적 검증기, 데이터 출처 관리, 수용 임계치, 레드팀 테스트, 인간 감사, 명시적 중단 규칙을 필요로 한다. 자기 교정은 교정 신호가 교정 대상 행동보다 더 신뢰할 수 있을 때만 유용하다.
When Could the GLM 6.0 API Become Available?
Z.AI는 GLM 6.0 API의 출시일, 모델 ID, 컨텍스트 윈도우, 최대 출력, 토큰 가격, 오픈 웨이트 커밋, 배포 요구사항을 공개하지 않았다. 현재로서는 어떤 구체적 값도 추정에 불과하다.
개발자는 네이티브 멀티모달 및 효율 지향 워크로드를 위해 CometAPI의 GLM-5.3-Flash API, 현재 플래그십 브랜치를 위해 CometAPI의 GLM-5.3 API, 이전 세대 기준 비교를 위해 CometAPI의 GLM-5.2 API를 통해 현재 방향을 평가할 수 있다.
Conclusion
GLM-6.0은 약속된 제품이라기보다, Z.AI가 Full Self-Training을 반복 가능한 엔지니어링 시스템으로 전환할 수 있는지에 대한 시험으로서 중요하다. 로드맵은 자체 생성 경험, 단계적 학습, 자체 평가, 교정, 통제된 반복을 연결한다. 결정적 증거는 이러한 메커니즘이 도구를 사용하는 긴 실제 워크플로에서 신뢰성을 개선하는지 여부가 될 것이다.
그 증거는 아직 불완전하다. Z.AI는 GLM-6.0 모델 카드, 출시일, API 식별자, 가격, 벤치마크 모음을 공개하지 않았다. 이러한 산출물이 나오기 전까지 합리적 결론은 좁다: 회사는 학습 방향을 공개했을 뿐, 완성된 역량 프로필을 공개한 것은 아니다.
Full Self-Training의 궁극적 목표는 시험 점수를 올리는 것이 아니라, 모델이 실제 세계 과제를 완수하는 능력을 향상시키는 것이다.