
TL;DR
Claude Fable 5.1는 어려운 자율 코딩과 장기 과제에서 더 강한 벤치마크 근거를 보인다. GPT-5.6 Sol은 일반 토큰 비용이 더 낮고, 폭넓은 네이티브 도구 스택과 독립 최대-노력 구성에서 더 짧은 첫 토큰 도달 시간을 제공한다. 올바른 기본값은 최고 벤치마크 점수만이 아니라 실패한 작업의 비용에 달려 있다.
2026년 9월 8일 Intelligence Index 스냅샷에서 Fable 5.1은 53점을, GPT-5.6 Sol은 47점을 기록했다. 출력 처리량은 각각 69.9 대 69.8 tokens/s로 사실상 동일했다. 이 결과는 품질 대 비용 의사결정을 지지하며, 보편적인 속도 우위를 확립하지는 않는다.
Key Takeaways
- 가장 어려운 자율 작업에서 더 높은 가격을 정당화할 수 있을 때 Fable 5.1을 선택하라.
- 비용에 민감한 프런티어 추론과 통합 도구의 이점을 얻는 애플리케이션에는 GPT-5.6 Sol로 시작하라.
- 시작 지연과 출력 속도를 분리해서 비교하라: GPT-5.6 Sol은 측정된 첫 토큰까지의 시간이 더 낮고, 처리량은 거의 동일하다.
- 모델 캐시 쓰기, 읽기, 보존, 장문맥 요율을 별도로 산정하라. 입력/출력의 헤드라인 가격만으로 모든 에이전트 워크로드를 설명할 수 없다.
데이터 확인 시점: 2026년 9월 8일. 독립 결과는 GPT-5.6 Sol을 최대 노력으로, Fable 5.1을 Adaptive Reasoning, Max Effort, Default Fallback으로 사용했다. 벤더 벤치마크와 독립 벤치마크는 서로 다른 평가 설정을 사용한다. 가격은 별도 표기가 없는 한 USD per million tokens (MTok) 기준이다.
GPT-5.6 Sol vs Fable 5.1: quick verdict
| Dimension | GPT-5.6 Sol | Claude Fable 5.1 | Better choice |
|---|---|---|---|
| Independent Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (Sep 7) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Context window | 1.05M | 1M | Effectively tied |
| Maximum output | 128K | 128K | Tie |
| Text/image input | Yes | Yes | Tie |
| Official input price / MTok | $4 | $10 | Sol |
| Official output price / MTok | $20 | $50 | Sol |
| Official cache read / MTok | $0.40 | $0.25 | Fable 5.1 |
| Independent output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Effectively tied |
| API tool breadth | Very broad | Strong | Sol |
| Long-running autonomous work | Excellent | Core strength | Fable 5.1 |
| Cost-sensitive production | Better default | Premium escalation | Sol |
유용한 시작 정책은 일상적인 프런티어 작업에는 Sol을 사용하고, 작업이 품질 또는 자율성 임계를 넘겨 실패할 때 Fable 5.1로 승격하는 것이다. 그 정책을 성공당 비용 기준으로 검증하라.
GPT-5.6 Sol은 여섯 가지 추론 노력 수준을 제공하며, none부터 max까지, 기본은 medium이다. Fable 5.1은 상시 적응형 사고를 사용한다; effort가 추론 깊이를 제어하며, 기본은 high다.
GPT-5.6 Sol의 컨텍스트에 추가된 50,000 토큰은 대부분의 아키텍처에서 결정적이지 않다. 요청이 백만 토큰에 근접할수록 청구 및 캐시 재사용이 더 중요해진다; 아래 장문맥 섹션이 그 이유를 보여준다.
What is GPT-5.6 Sol?
GPT-5.6 Sol은 OpenAI GPT-5.6 계열의 고성능 티어로, 까다로운 코딩, 리서치, 계획, 에이전트 워크플로우를 위한 모델이다. 이 비교에서의 주요 매력은 추론 제어와 주변 실행 환경의 조합이다.
Responses API를 통해 GPT-5.6 Sol은 폭넓은 네이티브 도구 포트폴리오를 지원한다: web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills, tool search. 이는 애플리케이션이 통합해야 하는 별도의 런타임 구성 요소 수를 줄일 수 있다.
OpenAI는 또한 이 계열에 대해 프로그래밍 방식 도구 호출과 멀티 에이전트 실행을 설명한다. 이러한 플랫폼 기능은 모델이 단일 답변을 반환하는 대신 도구 전반에 작업을 조율해야 할 때 중요하다.
What is Claude Fable 5.1?
Claude Fable 5.1은 까다로운 코딩, 전문 지식 작업, 리서치, 장기 실행 에이전트를 목표로 한다. 직접적인 벤치마크 결과는 짧은 응답보다 회복, 지속, 성공적인 완료가 더 중요한 작업에 강력한 후보임을 보여준다.
Anthropic은 계획, 실패 단계에서의 복구, 진행 상황 커뮤니케이션을 포함한 지속적인 자율 실행을 강조한다. 그 포지셔닝은 더 긴 작업을 테스트할 근거이지, 모든 워크플로우가 올바르게 완료될 보장은 아니다.
Fable 5.1은 API 동작에서도 GPT-5.6 Sol과 다르다: 강제 도구 선택 제한은 모델이 특정 도구를 반드시 호출해야 하는 워크플로우에서 중요하다. 결정적 에이전트 루프를 마이그레이션할 때 지원되는 tool_choice 모드를 확인하라.
통합 여부는 실용적인 문제다: 애플리케이션이 더 자율적인 추론 루프를 허용할 수 있는가, 아니면 각 단계를 더 세밀하게 제어해야 하는가? 경로를 선택하기 전에 정확한 도구 동작을 테스트하라.
Benchmark comparison: Fable 5.1 has the stronger direct evidence
경쟁 벤더 간의 벤치마크 비교는 오용되기 쉽다. OpenAI의 초기 GPT-5.6 출시 평가는 Fable 5.1 이전이고, Anthropic의 Fable 5.1 릴리스는 더 최신의 직접 GPT-5.6 Sol 비교를 포함한다.
증거를 읽는 가장 깔끔한 방법은 세 층위다: Anthropic의 직접 비교, 현재 독립 테스트, OpenAI의 GPT-5.6 Sol 자체 역량 프로파일.
Anthropic’s direct Fable 5.1 vs GPT-5.6 Sol results
공식 벤치마크 결과는 두 모델 모두에 대해 보고된 다섯 가지 작업을 포함한다. 아래의 퍼센트 포인트와 Elo 차이는 해당 공표 값에서 계산되었다.
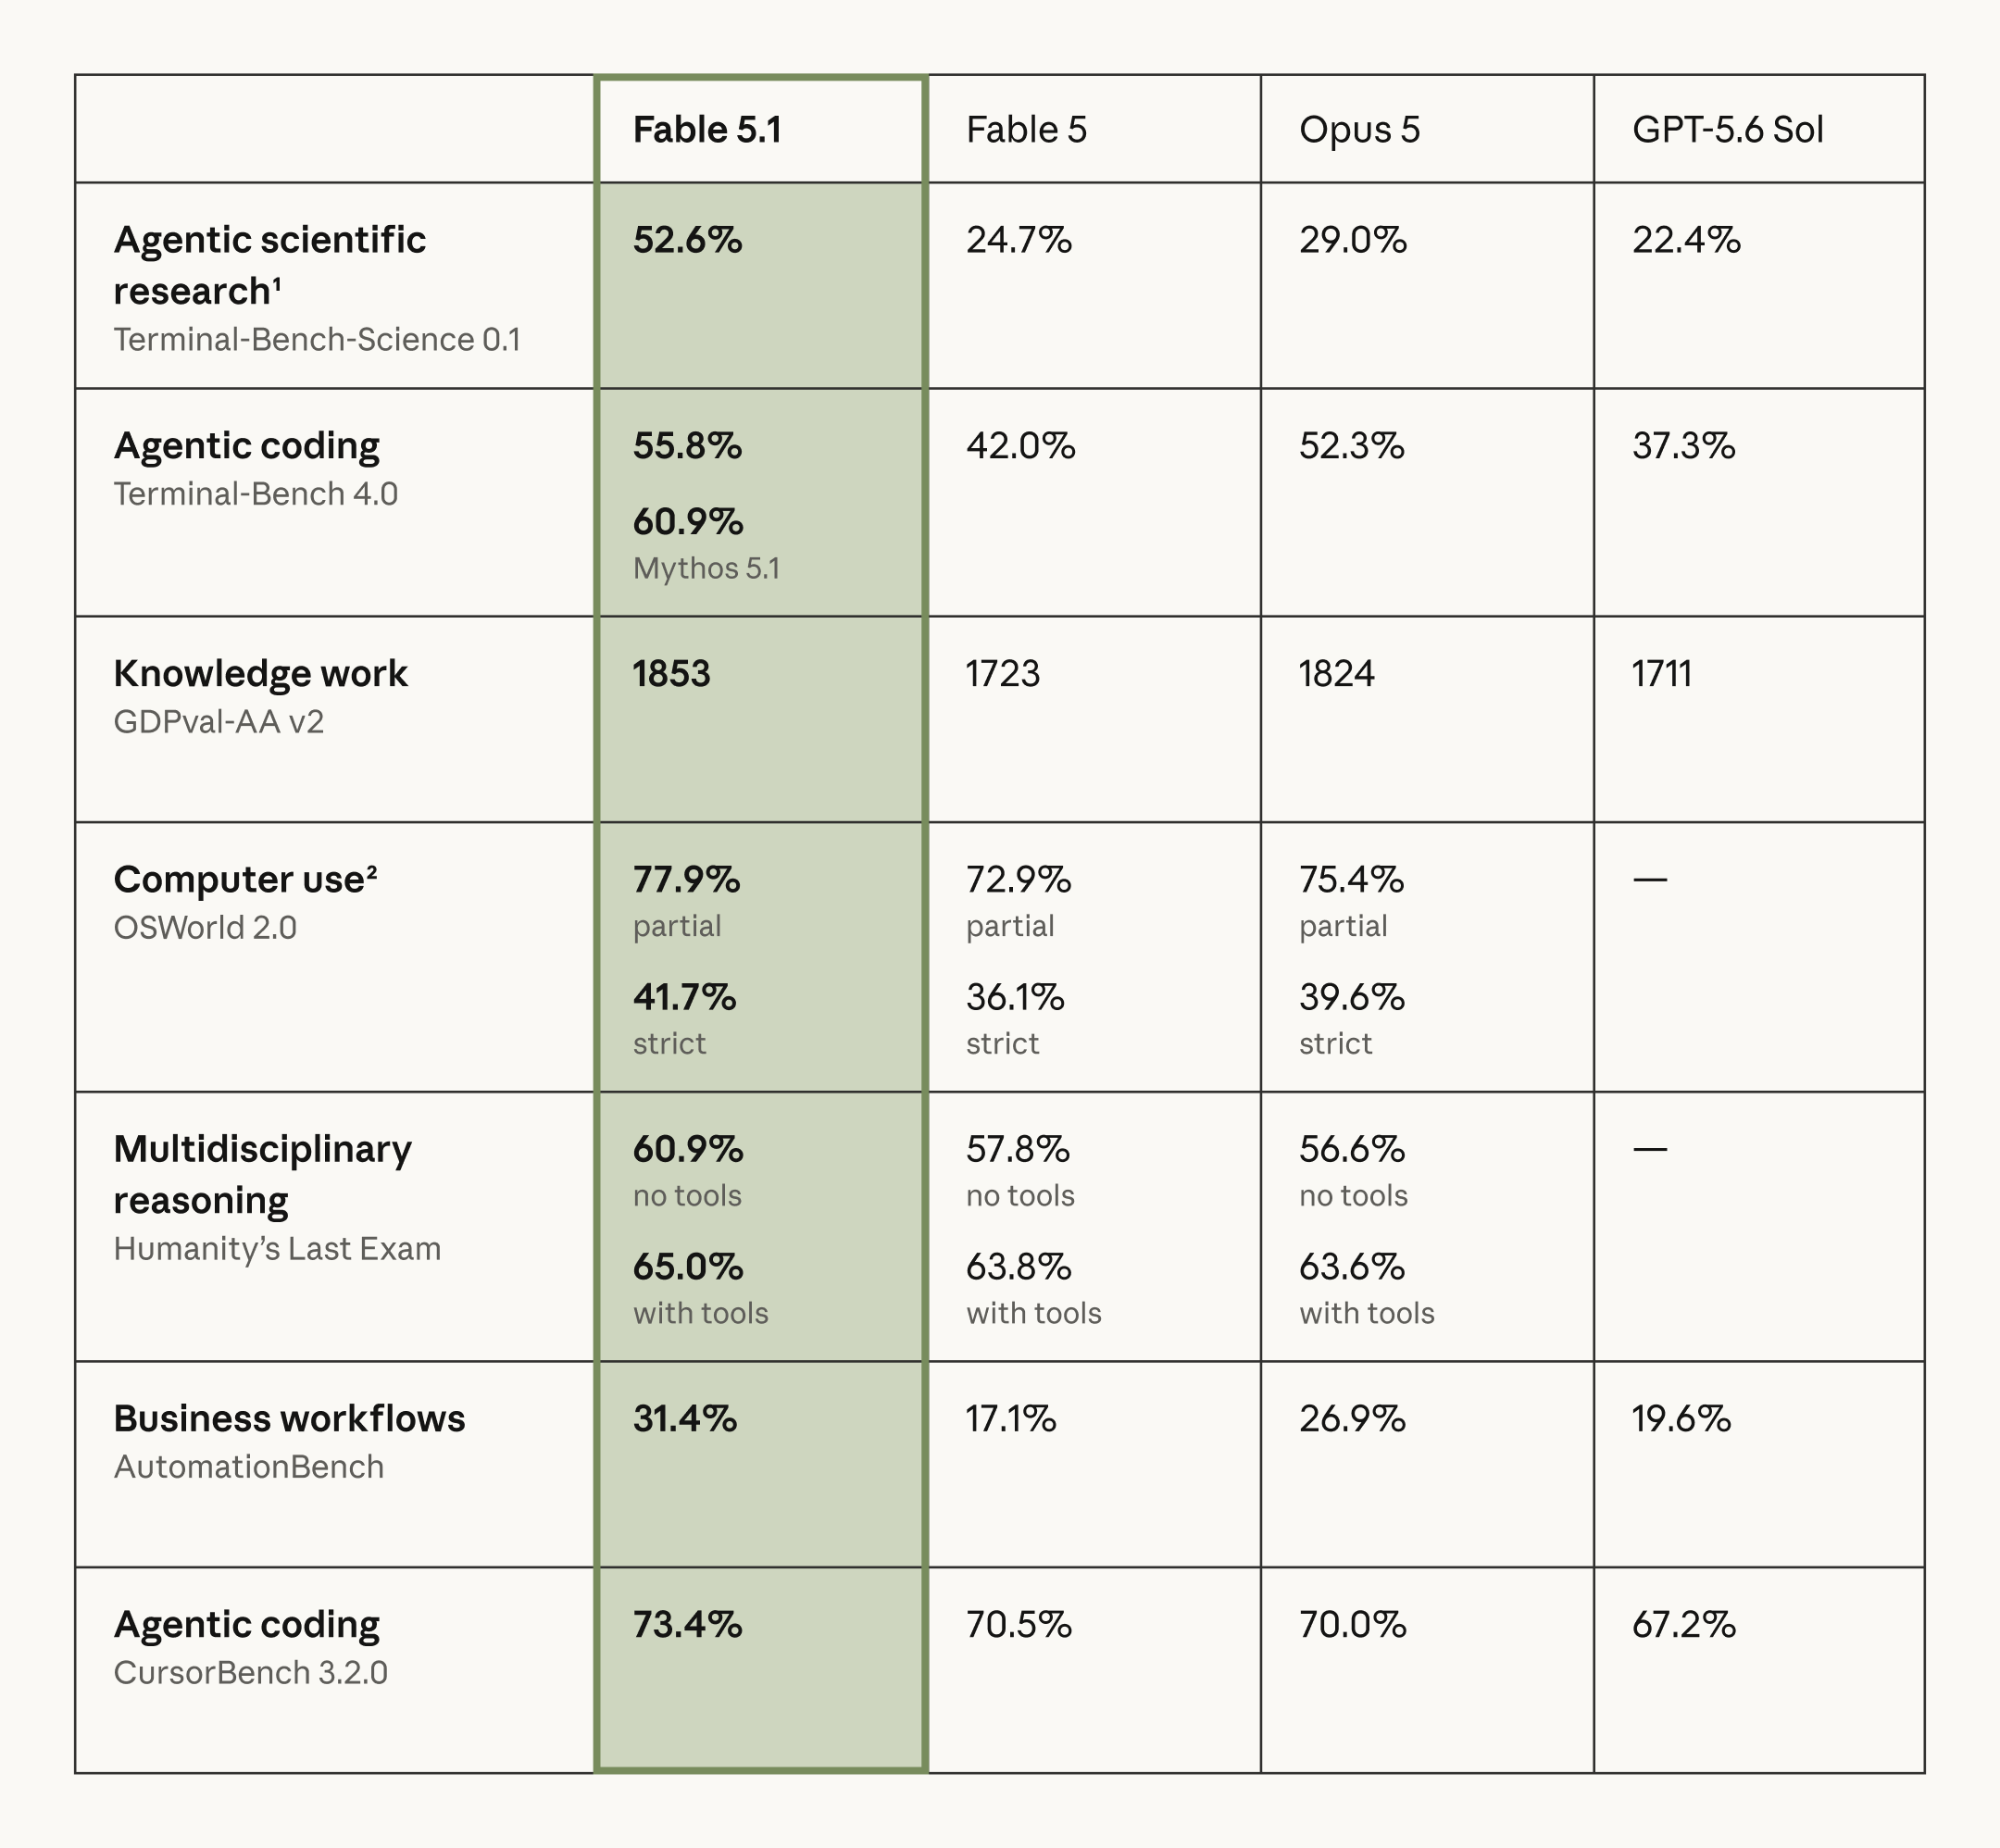
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Fable 5.1 lead |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
결과는 이례적으로 일관적이다: Anthropic이 게시한 모든 직접 행에서 Fable 5.1이 GPT-5.6 Sol을 앞선다. 가장 큰 차이는 일반적인 단기 추론보다는 에이전트형 과학 연구와 터미널 기반 코딩에서 나타난다.
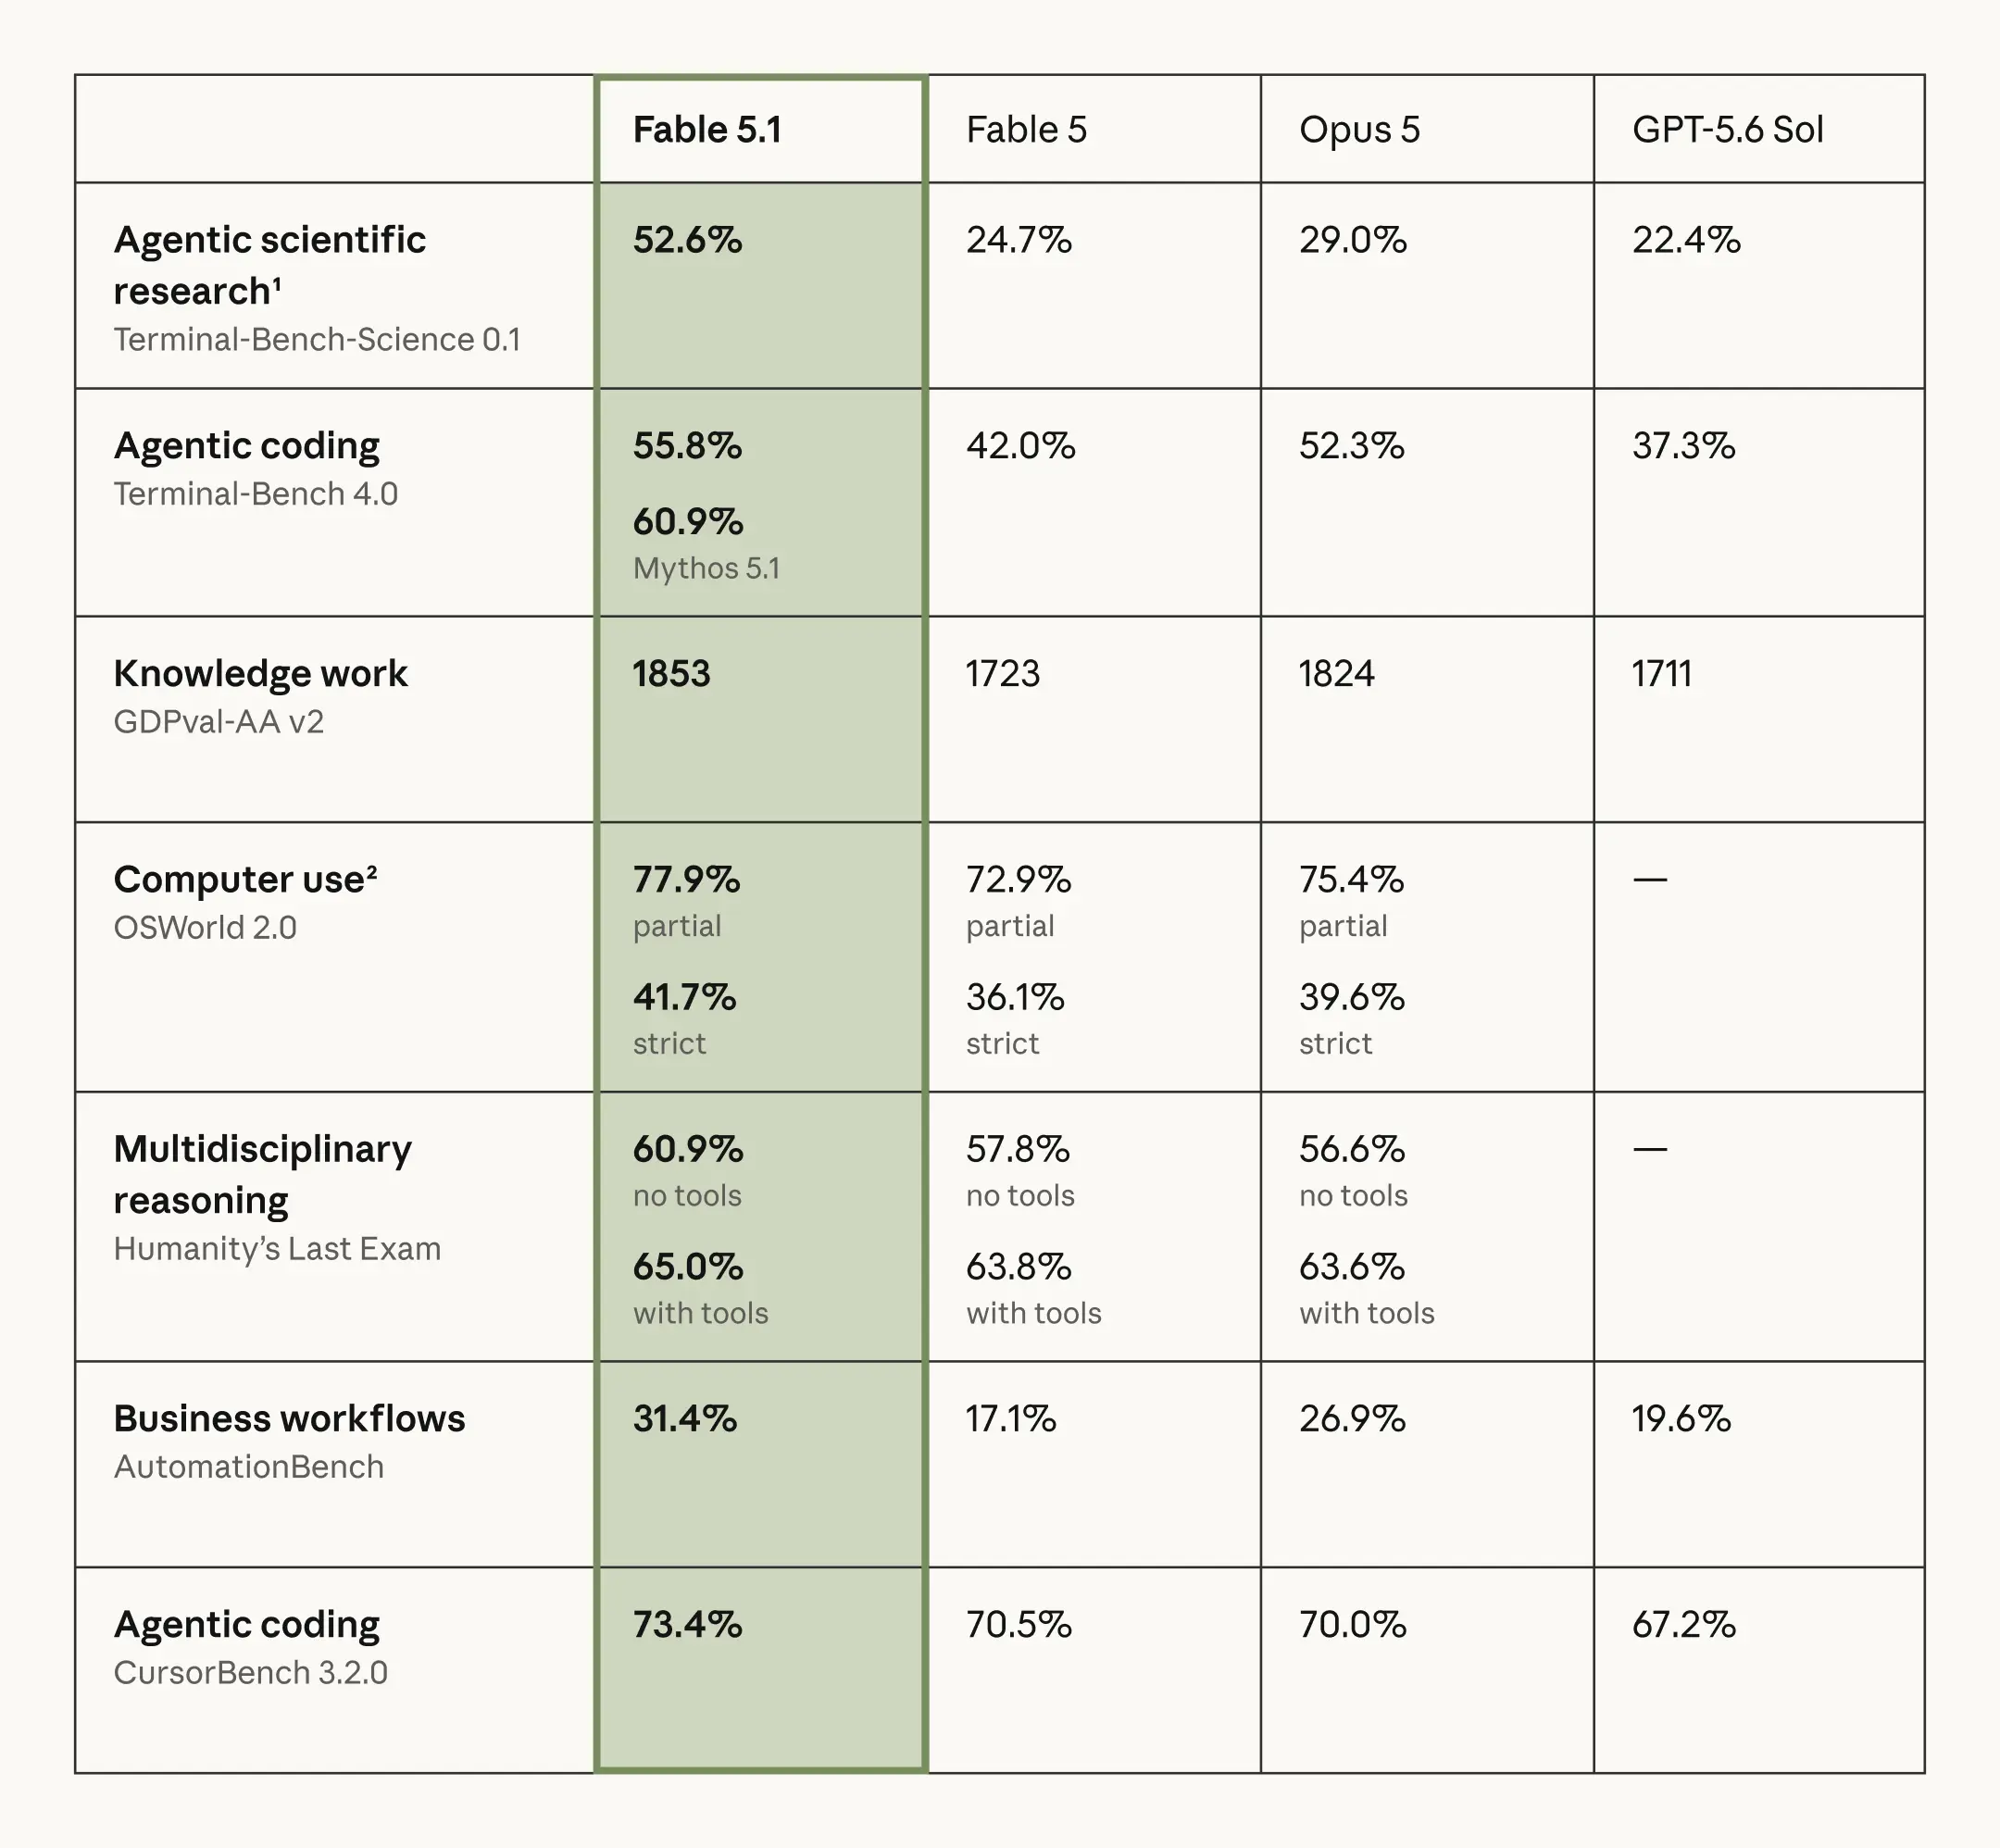
출처: Anthropic — 원본 벤치마크 그래픽.
이는 벤더가 수행한 평가다: Anthropic이 자사 모델과 경쟁 모델 모두를 테스트했다. 직접 비교 증거를 제공하지만 독립 테스트는 아니다. Anthropic은 Terminal-Bench-Science에서 모델당 ±3.5–4.5 퍼센트포인트의 표준 오차를 보고한다; 위 표는 신뢰 구간이 아닌 점 추정치를 보여준다.
벤더 결과는 Fable 5.1에 유리하지만, 독립 증거는 자체 날짜와 구성이 필요하다.
Independent benchmarks: separate dated results from live measurements
Artificial Analysis는 9월 7일 Intelligence Index v4.3를 도입하여 Terminal-Bench 2.1을 Terminal-Bench 4.0으로 대체하고 AutomationBench-AA를 추가했다. 릴리스는 Fable 5.1에 53, GPT-5.6 Sol에 47을 보고했으며, 이는 9월 8일 비교에 표시된 반올림 점수와 일치한다. 표는 릴리스의 터미널 결과를 이후 성능 스냅샷과 구분한다.
| Independent metric AA comparison / v4.3 release | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Result |
|---|---|---|---|
| Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (Sep 7 release) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Effectively tied |
| Time to first token (Sep 8) | 132.10 s | 277.47 s | Sol |
| AA normalized token-mix price / MTok | $3.08 | $7.175 | Sol |
스냅샷: 2026년 9월 8일, 명시적으로 9월 7일로 날짜가 표시된 Terminal-Bench 행 제외. Fable 5.1은 Adaptive Reasoning, Max Effort, Default Fallback; Sol은 max를 사용. 라이브 측정은 변할 수 있다. AA의 정규화 토큰 믹스 가격은 7:2:1 캐시-히트/입력/출력 비율을 사용한다; 이는 모든 API 요청의 비용이 아니다.
OSWorld 2.0은 이 비교에서 Sol의 가장 큰 보고 우위다: 62.6% 대 41.7%로 20.9포인트 차이다. 이는 Intelligence Index와 Terminal-Bench에서 더 강한 Fable 결과를 상쇄한다.
증거는 특정 트레이드오프를 뒷받침한다: Fable 5.1은 더 높은 Intelligence Index를, Sol은 더 낮은 첫 토큰까지의 시간과 더 낮은 정규화 가격을 가진다. 출력 처리량은 사실상 동일하다. 이러한 측정은 품질 민감 배치 작업과 대화형 애플리케이션에 서로 다른 선택을 지지한다.
날짜가 명확한 독립 Terminal-Bench 비교도 Anthropic의 테스트와 같은 방향을 가리킨다: 52.0% 대 39.9%, 벤더 결과 55.8% 대 37.3%와 비교된다. 평가 설정이 다르기 때문에 두 격차는 상호 교환할 수 없다.
What OpenAI’s benchmarks still tell us about GPT-5.6 Sol
OpenAI의 출시 평가는 GPT-5.6 Sol의 역량에 대한 추가 맥락을 제공한다. 이는 위에서 논의한 최신 정면 비교 이전이므로 Fable 5.1과의 직접 비교로 사용해서는 안 된다.
OpenAI는 GPT-5.6 Sol이 Terminal-Bench 2.1에서 88.8%라고 보고한다. 이는 출시 설정 하에서 강력한 에이전트형 코딩 역량의 증거다; 오래된 벤치마크 버전은 Terminal-Bench 4.0 점수와 수치적으로 비교하면 안 된다.
GPT-5.6 Sol vs Fable 5.1 for coding
단순한 코드 생성에서는 두 모델 모두 많은 프로덕션 워크로드에 과분할 수 있다. 분리가 더 명확해지는 지점은 코딩이 에이전트형 소프트웨어 엔지니어링으로 전환될 때다: 대규모 리포지토리 검사, 다중 파일 편집, 명령 실행, 실패 진단, 테스트 작성, 과제 통과까지 반복.
여기서 Claude Fable 5.1은 더 강한 현재 벤치마크 근거를 가진다. 벤더 수행과 독립 Terminal-Bench 4.0 비교 모두에서 앞서며, Anthropic의 CursorBench 결과도 73.4% 대 67.2%로 이를 뒷받침한다.
실용적 코딩 평가에는 리포지토리 전반의 변경, 테스트, 리뷰, 성능 작업을 포함하라. 짧은 코드 스니펫의 성공은 여러 파일과 실패 시도를 아우르는 과제를 완료하는 데 약한 대리 지표다.
주변 실행 환경이 원시 모델 품질만큼 중요할 때 GPT-5.6 Sol은 여전히 매력적이다. 셸 실행, apply-patch, 코드 인터프리터, 파일 검색, 컴퓨터 사용, MCP에 대한 네이티브 지원은 자체 오케스트레이션 인프라의 필요를 줄일 수 있다.
코딩 판정: 가장 어려운 자율 리포지토리 작업을 강조하는 평가에서는 Fable 5.1을 선택하라. 약간 낮은 벤치마크 역량을 감수하고 더 낮은 비용과 광범위한 통합 실행 스택을 얻고자 한다면 GPT-5.6 Sol을 선택하라.
Reasoning controls and developer experience
두 API는 지능을 다르게 노출한다.
Sol의 none-to-max 추론 범위는 팀이 여러 설정에서 품질과 지연을 테스트하게 한다. 더 낮은 effort는 추론 작업을 줄일 수 있지만, 올바른 설정은 작업 실패 비용에 달려 있다.
Fable의 상시 적응형 사고는 effort 튜닝을 다른 연습으로 만든다. 동일한 effort 레이블을 동일한 컴퓨트 예산으로 보지 말고, 애플리케이션에서 실제로 배포할 설정을 비교하라.
따라서 “기본 Sol”과 “기본 Fable” 간에 보편적으로 공정한 비교는 없다. 이들의 기본 추론 구성이 다르다. 프로덕션 평가에서는 동일한 컴퓨트 예산 또는 애플리케이션이 실제로 배포할 정확한 설정을 비교해야 한다.
GPT-5.6 Sol vs Fable 5.1:Which is better for AI agents?
선택은 병목이 어려운 추론인지, 그 주변 런타임인지에 달려 있다.
인용된 터미널, 자동화, 전문 작업 벤치마크에서 Fable의 리드는 가장 어려운 작업에 합리적인 후보가 되게 한다. 그 리드를 에이전트 전반으로 일반화하기 전에 완료율과 실패 단계에서의 회복을 측정하라.
GPT-5.6 Sol의 문서화된 Responses 도구 포트폴리오는 검색, 파일, 셸 실행, 패치 중심의 애플리케이션에 매력적이다. 이는 과제 정확성과 함께 평가해야 할 통합상의 이점이지, 그 대체물이 아니다.
| Agent requirement | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Hard long-horizon reasoning | Excellent | Best fit |
| Terminal/repository autonomy | Excellent | Stronger evidence |
| Native integrated tool portfolio | Stronger | Strong |
| Forced tool selection | Supported; check chosen API | Restricted; check tool_choice modes |
| Multi-agent platform integration | Strong advantage | Available through agent architecture |
| Progress communication during long jobs | Good | Core behavior |
| Cost-sensitive high-volume agents | Better | Premium |
| Repeated massive cached context | Good | Potentially very attractive |
필요 시 두 모델을 함께 사용하는 것이 경제적일 수 있다. 추가 성공 완료가 두 번째 모델의 더 높은 가격과 시작 지연을 상쇄하는지 측정하라.
Long context: 1.05M vs 1M is not the important difference
헤드라인 수치는 거의 동일해 보인다: GPT-5.6 Sol은 1.05M 토큰, Fable은 1M 토큰을 제공한다. 5% 용량 차이는 대규모 리포지토리, 법률 코퍼스, 연구 아카이브, 다시간 에이전트 히스토리를 분석할 수 있는지 여부를 결정할 가능성이 낮다. 둘 다 이미 백만-토큰 클래스다.
GPT-5.6 Sol에서는 272K를 넘는 입력이 요청에 대해 더 높은 장문맥 요율을 트리거한다: 입력 $8/MTok, 캐시 읽기 $0.80/MTok, 출력 $30/MTok. 캐시 쓰기도 $5에서 $10/MTok로 상승한다.
Fable 5.1은 표준 1M-문맥 요율을 유지한다: 입력 $10/MTok, 출력 $50/MTok, 캐시 읽기 $0.25/MTok. 이 문서화된 구성에서는 272K 이상에 대한 별도 프리미엄이 없다.
100K 비캐시 입력 토큰, 900K 캐시-읽기 토큰, 20K 총 과금 출력 토큰을 갖는 한 턴을 고려하자. GPT-5.6 Sol 비용은 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 비용은 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
이 캐시-중심 턴은 Fable의 캐시 읽기 비용이 더 저렴하기 때문에 가격 격차를 거의 없앤다. 결과는 워크로드의 토큰 믹스에 달려 있으며, 전체 에이전트 세션에서 두 모델이 동일한 비용이라는 의미는 아니다.
비용 가정: 900K-토큰 프리픽스는 이미 캐시되어 있고, 100K 신규 입력은 새로운 캐시 쓰기로 과금되지 않는다. 추정치는 초기 캐시 쓰기와 도구 수수료를 제외한다. 20K 출력 허용량에는 청구되는 모든 출력, 즉 청구되는 추론 토큰이 포함된다.
Pricing: Sol wins ordinary workloads, Fable wins one important cache metric
확인된 요율에서 Sol은 MTok당 입력 $4 / 출력 $20이며, 캐시 읽기 $0.40이다. Fable 5.1은 입력 $10, 출력 $50, 캐시 읽기 $0.25다. 표는 제공자 가격을 CometAPI의 GPT-5.6 Sol API와 Claude Fable 5.1 API 요율과 구분한다.
| Price component | GPT-5.6 Sol Official prices | Claude Fable 5.1 Official prices |
|---|---|---|
| Official input / MTok | $4.00 | $10.00 |
| Official output / MTok | $20.00 | $50.00 |
| Official cache read / MTok | $0.40 | $0.25 |
| Official cache write / MTok | $5.00 (30 minutes) | $12.50 (5 minutes) |
| Above 272K input: input / cache read / cache write / output | $8 / $0.80 / $10 / $30 | Same documented base rates |
| CometAPI input / MTok | $3.20 | $8.00 |
| CometAPI output / MTok | $16.00 | $40.00 |
캐시 쓰기 보존 시간이 다르다: Sol은 기본 30분 보존 기간을 사용하고, Fable 5.1 요율은 5분 쓰기에 해당한다. 실제로 사용하는 제공자와 라우트의 캐시 생성, 갱신, 만료 동작을 확인하라.
확인된 직접-제공자 요율에서 Fable 5.1은 비캐시 입력($10 vs $4/MTok)과 출력($50 vs $20/MTok) 모두에서 Sol보다 2.5배 비싸다. 제공자 프로모션과 게이트웨이 가격이 변할 수 있으므로 이 확인된 요율을 날짜가 붙은 비교로 취급하라.
100K 입력과 10K 총 과금 출력이 있는 단문맥 요청은 직접-제공자 요율에서 Sol 약 $0.60, Fable 약 $1.50가 든다. 위의 CometAPI 요율에서는 각각 $0.48 또는 $1.20다. 이 예시는 캐시 쓰기와 도구 수수료를 제외한다.
Fable의 단문맥 캐시-읽기 요율은 37.5% 낮다: ($0.40 − $0.25) ÷ $0.40. 이는 큰 안정적 프리픽스를 재사용하는 에이전트에 중요할 수 있지만, 총 절감액은 신규 입력, 쓰기 빈도, 출력량에 여전히 달려 있다.
가격 판정: 신규 컨텍스트 트래픽의 출발점으로는 Sol이 더 저렴하다. 캐시-읽기 비중이 커질수록 Fable이 더 경쟁력이 높아진다; 캐시 생성 및 갱신을 포함해 전체 세션 비용을 비교하라.
Speed and latency
최대-노력 테스트는 첫 가시 토큰 이전에 상당한 시간을 추론에 사용할 수 있다.
9월 8일 처리량과 지연 측정은 Fable 69.9 출력 토큰/s, Sol 69.8을 보여준다. 첫 토큰까지의 시간은 277.47초 대 132.10초다. 출력 처리량은 사실상 동일하며, 이 구성에서 Sol이 더 빨리 가시 출력을 시작한다.
이는 최대-노력 벤치마크 측정이며, 모든 API 호출에 대한 약속된 지연이 아니다. 프롬프트 길이, 추론 구성, 제공자 부하, 도구, 캐시 상태가 결과를 바꿀 수 있다. 첫 토큰까지의 시간과 전체 응답 시간은 다른 지표다.
대화형 작업에서는 더 낮은 관측 시작 지연이 Sol에 유리할 수 있다. 비동기 리서치나 야간 리포지토리 작업에서는 첫 토큰을 기다리기보다 성공적인 완료가 더 중요할 수 있다. 배포할 설정과 동시성에서 두 모델을 벤치마크하라.
Safeguards are a production difference
두 모델 모두 역량이 민감한 사이버보안 및 과학 도메인까지 확장되기에 더 강한 안전장치를 적용하지만, 구현 방식은 다르다.
OpenAI는 GPT-5.6 계열에 대한 계층적 보호와 모니터링을 설명한다. 민감 도메인의 애플리케이션은 배포 동작의 일부로 관련 안전장치를 평가해야 한다.
Anthropic의 리라우팅 및 보존 조건은 일부 민감한 사이버보안 또는 생물학 요청을 덜 강력한 모델로 라우팅하면서, 그러한 라우팅 요청에는 Fable 요율을 부과하지 않는다고 설명한다. 기본 데이터 보존 기간은 30일이며, 적격 엔터프라이즈 계약에는 예외가 있다.
일반 코딩과 지식 작업에서는 이러한 차이가 나타나지 않을 수 있다. 보안 제품, 규제 워크로드, 프라이버시 민감 배포에서는 벤치마크 품질과 가격과 함께 평가 체크리스트에 포함되어야 한다.
Which model should you choose?
전체 비교는 워크로드 형태로 요약할 수 있다.
| Workload | GPT-5.6 Sol | Claude Fable 5.1 | Recommendation |
|---|---|---|---|
| Difficult autonomous coding | Excellent | Stronger current benchmarks | Fable 5.1 |
| Long-horizon research | Excellent | Core strength | Fable 5.1 |
| High-volume frontier API | Much cheaper | Expensive | Sol |
| Interactive coding assistant | Lower measured max-effort TTFT | Higher measured max-effort TTFT | Test deployed settings |
| Tool-heavy API agent | Broader native tool stack | Strong | Sol |
| Million-token cached agent | Competitive | Very low cache-read price | Test both |
| Maximum reasoning quality | Excellent | Independent lead | Fable 5.1 |
| Cost per ordinary request | Clear advantage | Premium | Sol |
| Image/document reasoning | Strong | Strong | Test on workload |
| Single-provider OpenAI stack | Natural fit | Requires migration/gateway | Sol |
| Model-independent routing | Strong | Strong | Use both through CometAPI |
라우팅 정책은 그 복잡성만큼의 가치를 제공해야 한다. 단일 모델 기준선을 Sol-우선 정책과 비교하여 어려운 작업을 Fable 5.1로 승격시키고, 전환이 요구 품질에서 성공당 비용을 개선할 때만 라우터를 유지하라.
How to compare GPT-5.6 Sol and Fable 5.1 through CometAPI
CometAPI는 이미 GPT-5.6 Sol과 Claude Fable 5.1을 통합했다. 두 모델을 네이티브 요청 형식으로 액세스하고 동일한 평가 세트를 보내, 일치된 설정에서 반환 결과를 비교하라.
각 모델에 네이티브 형식 요청을 사용하고 프롬프트, 데이터셋, effort 설정, 동시성, 채점 규칙을 고정하라. 실행을 반복하라; 모델당 단일 순차 요청만으로는 신뢰할 수 있는 지연 또는 품질을 추정하기에 충분하지 않다.
프로덕션 평가에서는 고정 프롬프트 세트를 사용하고, 교대로 반복 실행하며, effort 설정을 기록하고, 정확도, 테스트 통과율, 도구 성공, 재시도, 토큰 사용량, 경과 시간, 성공당 총 비용을 채점하라. 공통 기준선 이후에는 각 모델을 별도로 튜닝하라.
Final verdict: GPT-5.6 Sol or Claude Fable 5.1?
Fable 5.1은 가장 어려운 자율 코딩과 장기 과제에서 더 강한 직접 증거를 가진다. 다섯 개의 공유 벤더 벤치마크 행과 날짜가 명확한 독립 터미널 비교에서 앞선다. 이는 자체 작업에서 검증을 전제로 한 강력한 승격 후보임을 의미한다.
Sol은 더 낮은 일반 토큰 가격, 더 정교한 추론 제어, 폭넓은 네이티브 도구 스택을 보유한다. 확인된 독립 최대-노력 구성에서는 첫 토큰까지의 시간이 더 낮았고, 출력 처리량은 사실상 동일했다.
가장 어려운 자율 작업이 성공률을 좌우할 때는 Fable 5.1을 우선시하라. 비용에 민감한 프런티어 추론이나 도구 중심 애플리케이션에는 Sol로 시작하라. 대화형 워크로드에서는 배포 effort 설정에서 관찰된 시작 지연 우위가 지속되는지 테스트하라.
단일 모델로 요구사항을 간단히 충족할 수 있을 때는 그 모델을 선택하라. 평가 결과가 두 모델 간 전환이 품질 또는 성공당 비용을 개선함을 보여줄 때 라우팅을 추가하라.
FAQ
Is Claude Fable 5.1 better than GPT-5.6 Sol?
9월 8일 스냅샷에서 독립 Intelligence Index가 더 높다: Fable 5.1이 53, Sol이 47. 또한 날짜가 명확한 독립 터미널 테스트에서도 앞선다. 이는 이러한 평가에서의 품질 우위를 뒷받침하지만, 모든 워크로드에서 더 낫다는 주장은 아니다.
Is GPT-5.6 Sol cheaper than Claude Fable 5.1?
일반 비캐시 API 트래픽에서는 그렇다: 확인된 직접-제공자 입력/출력 요율은 Sol이 $4/$20 per MTok, Fable 5.1이 $10/$50이다. 캐시-중심 워크로드에서는 Fable의 캐시-읽기 요율이 더 낮기 때문에 격차가 줄어들 수 있다. 견적에는 쓰기와 만료 동작을 포함하라.
Which model is better for coding?
이 비교에서 Fable 5.1은 자율 코딩 벤치마크 증거가 더 강하다. Sol은 더 낮은 비용 워크플로우와 통합 실행 도구로 매력적이다. 실행 가능한 테스트가 있는 리포지토리 작업으로 측정 역량 격차가 애플리케이션에 중요할지 결정하라.
Which model has the larger context window?
Sol은 1.05M, Fable 5.1은 1M 토큰으로 기술적으로 더 크다. 실무에서는 Sol의 >272K 가격 임계와 Fable의 저렴한 캐시-읽기가 50K-토큰 용량 차이보다 더 중요하다.
Can I access both models through CometAPI?
가능하다. CometAPI의 GPT-5.6 Sol API와 Claude Fable 5.1 API는 텍스트 평가를 위한 공통 출발점을 지원한다. 기준선을 프로덕션 에이전트로 확장하기 전에 라우트별 추론, 캐싱, 도구 지원을 확인하라.