대량 처리·검증 가능·비용 민감 작업에는 GPT-6.1 Terra부터 시작하세요. 복잡한 코딩, 다단계 도구 사용, 실패 비용이 큰 워크플로에는 GPT-6.1 Sol을 평가하세요. 실용적인 기본값은 먼저 Terra를 사용하고, 사전 정의된 테스트나 검증 체크에 실패하면 Sol로 승급하는 것입니다.
Key Takeaways
표준 토큰 가격: OpenAI Standard에서 Terra는 입력 100만 토큰당 $1, 출력 100만 토큰당 $5이며, Sol은 각각 $2와 $10입니다.
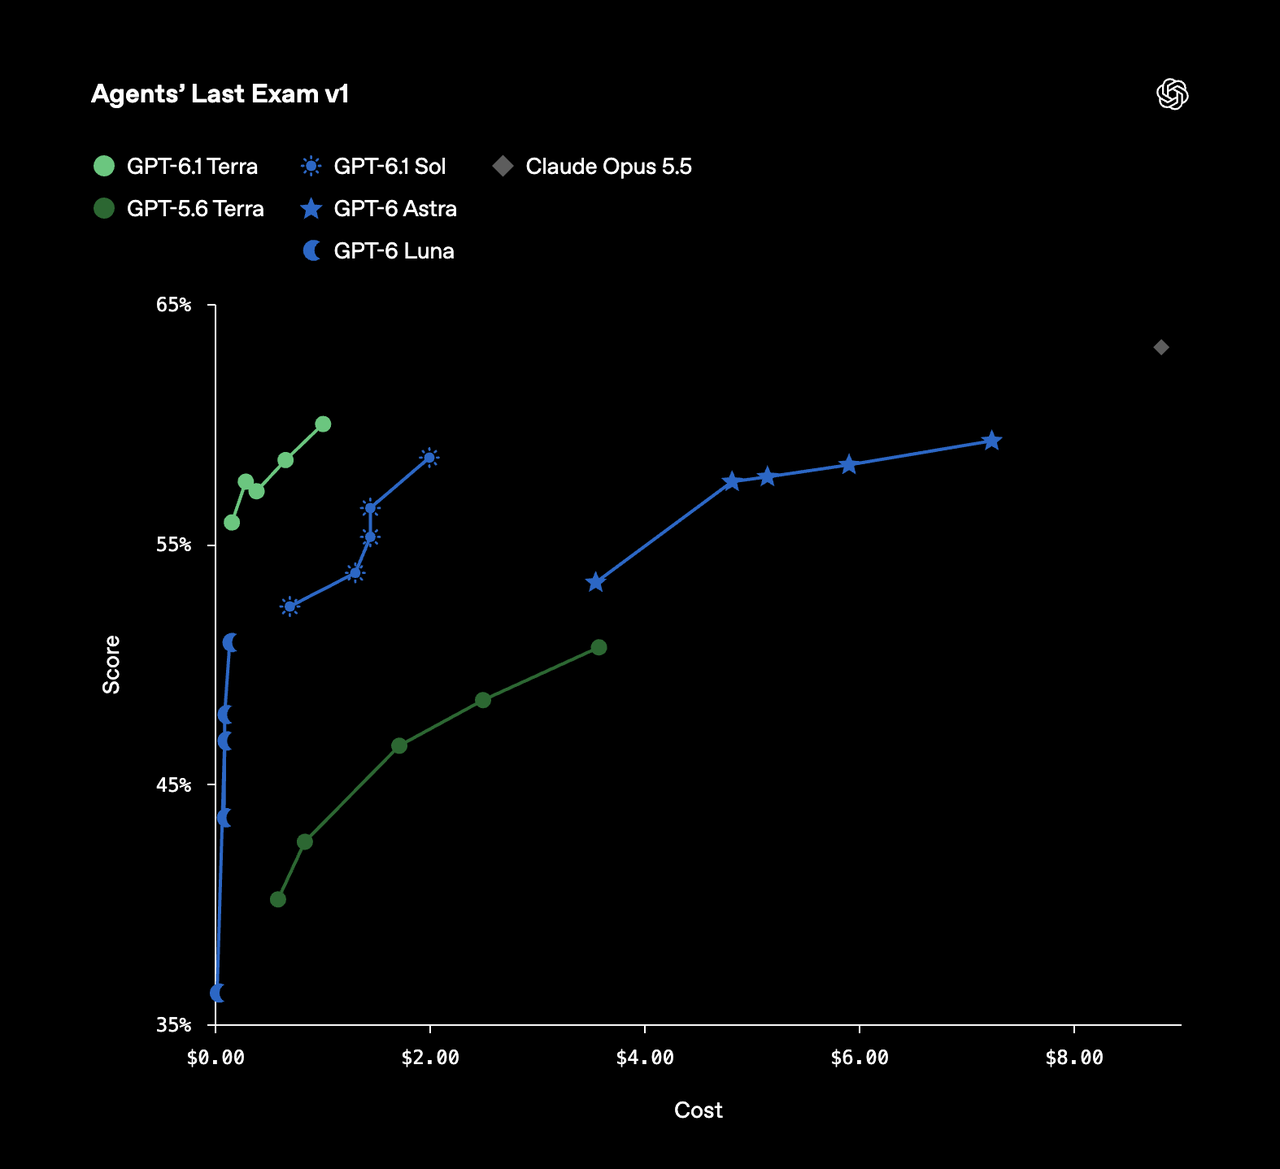
작업별 성능: 최대 추론 노력에서 Terra는 Agents’ Last Exam v1과 Terminal-Bench-Science 0.1에서 근소하게 앞서고, Sol은 Terminal-Bench 4.0과 OSWorld 2.1에서 앞섭니다.
공유 컨텍스트 용량: 두 모델 모두 105만 토큰 컨텍스트 윈도우를 제공하며 텍스트와 이미지 입력을 지원합니다.
상이한 추론 제어: Terra는 none으로 추론을 끌 수 있으며, Sol은 최소 low의 추론 노력이 필요합니다.
운영 비용의 중요성: 재시도와 도구 호출을 포함해 성공적으로 완료된 작업당 지출을 비교하고, 휴먼 리뷰 비용은 별도로 추적하세요.
GPT-6.1 Terra vs GPT-6.1 Sol: Overview and Specifications
아래 개요는 트레이드오프를 요약합니다. 자세한 섹션에는 각 선택의 근거, 과금 가정, 한계가 설명되어 있습니다.
GPT-6.1 Terra: Efficient Visual and Agent Workflows
OpenAI는 2026년 10월 26일에 GPT-6.1 Terra를 소개했습니다. 이는 일상적인 프로페셔널 워크플로를 위한 비전 추論, 컴퓨터 사용, 범용 텍스트 생성을 결합합니다. 더 낮은 토큰 요율 덕분에 작업이 빈번하고 결과를 확인할 수 있을 때 유용한 시작점입니다.
GPT-6.1 Sol: Complex Coding and Professional Reasoning
GPT-6.1 Sol은 2026년 9월 29일 출시되었습니다. 까다로운 코딩과 전문가 작업을 목표로 합니다. 익숙하지 않은 리포지토리, 연쇄적인 의존 단계가 길거나 수정 비용이 큰 경우 추가 추론 능력이 가치 있는지 평가하세요.
Context, Reasoning, and API Specifications
API features: 두 모델은 Structured Outputs, 스트리밍, Batch API를 지원합니다. 도구 호출은 Responses API를 사용하며, 파인튜닝은 지원되지 않습니다. 선택한 제공자와 엔드포인트가 애플리케이션에 필요한 기능을 제공하는지 확인하세요.
두 모델 모두 1,050,000-토큰 컨텍스트 윈도우 내에서 최대 128,000 출력 토큰을 허용합니다. 전체 출력 할당을 예약하면 입력, 시스템 지시문, 도구 히스토리를 포함해 나머지 교환에 922,000 토큰이 남습니다. 이는 계획 계산이며 별도의 고정 입력 한도가 아닙니다.
Architecture disclosure: 연결된 공개 모델 사양은 신뢰할 만한 비교를 할 만큼 충분한 내부 아키텍처 세부 정보를 제공하지 않습니다. 컨텍스트 용량과 추론 설정을 파라미터 수나 아키텍처의 증거로 간주해서는 안 됩니다.
Reasoning controls: Terra의 none 설정은 단순한 변환과 추출에 유용합니다. 첫 비교에서는 두 모델에서 동일하게 지원되는 추론 설정을 사용한 뒤, 각 모델을 워크로드의 품질과 지연에 맞춰 튜닝하세요.
두 모델은 동일한 공개 컨텍스트 용량을 제공하지만, 이는 동일한 검색 정확도나 장문맥 추론 품질을 의미하지 않습니다. 따라서 모델 선택 시 추론 품질, 워크플로 효율, 비용, 작업별 검색 성능을 함께 고려해야 합니다.
GPT-6.1 Terra vs GPT-6.1 Sol: Performance
보고된 결과는 혼재되어 있습니다. Terra는 일부 에이전트 및 과학 코딩 평가에서 근소하게 앞서고, Sol은 일반 터미널 코딩, 데스크톱 자동화, 비전에서 더 높은 점수를 기록합니다. 아래 비교는 OpenAI의 출시 결과와 독립 평가를 분리해, 각각이 실제 운영 성능에 대해 말해줄 수 있는 바와 한계를 설명합니다.
Official Benchmark Results and Test Conditions
다음 결과는 OpenAI의 Terra 출시 평가에서 나온 것입니다. Terra는 medium과 최대 추론 노력으로, Sol은 최대 노력으로 표시되어 있습니다. 마지막 열은 오직 최대 노력 구성만 비교합니다.
OSWorld는 오프라인 2.1 평가를 사용합니다. 사실성 테스트는 오류 유발을 위해 설계된 OpenAI 내부 프롬프트를 사용합니다. 이는 특정 평가 설정에서의 벤더 보고 결과이며, 실제 운영 워크로드의 측정값이 아닙니다.
모든 점수는 백분율이며, 차이는 퍼센트포인트(pp)로 표시됩니다. 사실 오류율만 낮을수록 좋습니다. 0.1포인트의 오류율 차이만으로 의미 있는 신뢰도 우위를 단정할 수는 없습니다.
소프트웨어 엔지니어링의 경우, Sol의 Terminal-Bench 우위와 Terra의 근소한 Terminal-Bench-Science 우위는 결과가 코딩 작업 유형에 따라 달라질 수 있음을 시사합니다. 애플리케이션 워크플로 측면에서, Sol의 더 높은 OSWorld 점수는 데스크톱 자동화를 평가 대상으로, Terra의 Agents’ Last Exam 결과는 프로페셔널 에이전트 작업의 후보로 삼을 수 있음을 보여줍니다. 어느 쪽도 보편적 승자를 입증하지는 않습니다.
에이전트 스캐폴딩, 도구 접근, 환경 구성은 이러한 결과에 영향을 줄 수 있습니다. 수치를 활용해 테스트 후보를 선정한 후, 실제 완료해야 하는 리포지토리 변경과 애플리케이션 워크플로에 대해 검증하세요.
OpenAI의 Agents’ Last Exam v1 차트는 모델 구성별 점수를 추정 작업 비용에 대비해 플롯합니다. 이는 위 점수 표에 비용 효율 관점을 더합니다. 표시된 비용은 해당 평가 설정에 특정합니다.
Independent Intelligence and Coding Evaluations
Artificial Analysis의 10월 26일 평가에 따르면, 최대 추론 노력에서 Terra는 Intelligence Index에서 Sol보다 4점 낮습니다. Coding Agent Index v2.0에서는 Terra 48, Sol 54를 기록했습니다. 이는 서로 다른 방법과 점수 척도를 가진 별도 평가이므로, OpenAI의 벤치마크 결과와 수치적으로 결합해서는 안 됩니다.
같은 분석은 Intelligence 평가에서 Terra의 low 및 medium 추론 설정이 특히 비용 효율적임을 지적합니다. 이는 최대 노력 설정과 함께 실용적 구성을 시험할 근거를 뒷받침합니다. 평가 비용은 여전히 테스트 설정에 특정하며, 애플리케이션 지출 추정치로 간주되어서는 안 됩니다.
Speed and Latency: Task Completion vs. Token Generation
OpenAI는 Terra가 평가된 Agents’ Last Exam 작업을 Sol보다 3배 이상 빠르게 완료한다고 보고합니다. 이는 추론과 소프트웨어 상호작용을 포함하는 엔드 투 엔드 작업 측정이며, 출력 토큰 처리량이 3배 높다는 뜻도, 모든 API 요청에서 동일한 속도 향상이 있다는 뜻도 아닙니다.
대화형 애플리케이션에서는 출력이 시작되기 전 대기 시간을 나타내는 time to first token과, 답변이 이어지는 속도를 나타내는 output tokens per second를 구분하세요. 에이전트의 경우 도구 호출, 재시도, 복구를 포함한 end-to-end completion time을 우선시하세요.
두 모델을 동일한 프롬프트, 도구, 지원 추론 설정, 승인 기준으로 비교하세요. 지연 시간을 작업 성공과 함께 기록하세요. 더 빠른 응답이라도 수정이 더 필요하거나 워크플로를 완료하지 못하면 가치가 제한됩니다.
Vision and Long-Context Performance: What the Results Establish
MMMU-Pro 최대 노력에서 Sol의 0.8퍼센트포인트 우위는 보고된 비전 결과 중 하나일 뿐이며, 모든 비전 워크플로에서 더 나은 성능을 보장하지는 않습니다. 작은 라벨, 불량 스캔, 조밀한 도표, 낯선 레이아웃을 대표 입력으로 테스트하세요.
위 평가들은 어떤 모델이 장문맥 검색이나 추론에 더 나은지 확정하지 못합니다. 두 모델이 동일한 공개 컨텍스트 용량을 갖고 있어도, 용량만으로 검색 정확도나 세션 간 메모리를 입증할 수는 없습니다. 각 모델이 문서에서 관련 증거를 찾고 활용할 수 있는지 테스트하고, 애플리케이션 상태는 요청 간에 명시적으로 유지하세요.
GPT-6.1 Terra vs GPT-6.1 Sol: Cost
토큰 가격은 비용 비교의 출발점입니다. 재시도, 추론 토큰, 도구 호출, 휴먼 리뷰 역시 작업을 성공적으로 완료하는 데 드는 총비용에 영향을 줍니다.
다음 요율은 USD 기준 100만 토큰당 가격입니다.
OpenAI API Pricing
위 범주에서 Terra의 Standard 요율은 Sol의 절반입니다. 실제 청구는 요청 구성에 따라 달라집니다. 장문맥 요청, 처리 티어, 리전 처리, 도구 사용은 다른 조건이 적용될 수 있습니다. 운영 비용 추정 전 적용 가능한 OpenAI 가격 문서를 확인하세요.
CometAPI Pricing
CometAPI는 자체 가격과 기능 제공 범위를 가진 타사 접근 경로입니다. 표시된 일반 입력·출력 요율은 아래에 별도로 표시되어 있습니다.
이 요율에서 CometAPI의 일반 입력·출력 가격은 위 OpenAI Standard 대비 20% 낮습니다. 계정의 최신 가격, 장문맥 과금, 캐시 지원, 도구 제공 가능 여부를 배포 전 확인하세요.
Example Cost for 1,000 Requests
애플리케이션이 1,000건의 요청을 수행하고, 각 요청에서 2,000개의 캐시되지 않은 입력 토큰과 500개의 과금 대상 출력 토큰을 사용한다고 가정해 봅시다. 이는 총 200만 입력 토큰과 50만 출력 토큰을 생성합니다.
1,000건 요청에서 각 2,000개의 캐시되지 않은 입력 토큰과 500개의 과금 대상 출력 토큰을 사용할 때의 예상 비용은 다음과 같습니다:
Terra via OpenAI: 입력 $2.00, 출력 $2.50로 합계 $4.50
Sol via OpenAI: 입력 $4.00, 출력 $5.00로 합계 $9.00
Terra via CometAPI: 입력 $1.60, 출력 $2.00로 합계 $3.60
Sol via CometAPI: 입력 $3.20, 출력 $4.00로 합계 $7.20
이 계산은 위에 나열된 일반 요율을 사용하며 Batch API 할인은 제외합니다. 캐시 쓰기, 별도 도구 과금, 재시도는 포함하지 않습니다. 출력으로 청구되는 추론 토큰은 출력 총량에 포함해야 합니다.
Effective Cost per Successful Task
이 글에서 성공적인 작업은 추가 휴먼 수정 없이 사전 정의된 품질, 스키마(해당 시), 완료 체크를 통과한 작업을 의미합니다.
낮은 토큰 가격이 항상 낮은 운영 비용을 보장하지는 않습니다. Terra는 시도가 더 필요하거나 추론 토큰·휴먼 개입이 늘어나면 절감 효과가 줄어들 수 있습니다. Sol은 첫 시도 성공률이 높아 더 적은 수정을 요구한다면 더 높은 토큰 요율을 정당화할 수 있습니다.
Effective model-and-tool cost per successful task = total model and tool spending across all attempts ÷ number of successful tasks.
휴먼 리뷰 및 수정 비용은 별도로 추적하세요. 토큰 가격만 비교하지 말고, 목표 품질을 최저 결합 비용으로 충족하는 모델을 선택하세요.
Which Model Should You Choose: GPT-6.1 Terra or GPT-6.1 Sol?
작업 복잡도, 검증 가능한 출력 품질, 총 완료 비용을 기준으로 선택하세요. Terra는 반복적인 워크플로에 유용한 시작점이며, Sol은 어려운 추론이나 실패 비용이 큰 경우 추가 지출을 감수할 가치가 있습니다.
When to Choose GPT-6.1 Terra
대량 추출, 문서 초안 작성, 카탈로그 매칭, 예측 가능한 애플리케이션 워크플로에서는 Terra로 시작하세요. 이들 작업은 결과를 소스 문서, 필수 필드, 자동 검증 규칙으로 확인할 수 있을 때 적합합니다.
허용된 재시도·휴먼 리뷰 예산 내에서 정확도·완료 목표를 충족한다면 Terra를 선택하세요. 반복 실패로 절감 효과가 사라지면 낮은 토큰 요율의 이점은 제한됩니다.
When to Choose GPT-6.1 Sol
어려운 디버깅, 다수의 의존성을 포함하는 리포지토리 변경, 의존 단계가 긴 데스크톱 워크플로에는 Sol을 평가하세요.
테스트에서 더 많은 패치를 승인받거나, 더 많은 테스트를 통과하거나, 수동 수정이 줄어드는 것으로 나타난다면 Sol을 선택하세요. 이러한 개선이 작업 완료의 총비용을 낮춘다면 더 높은 토큰 비용은 정당화됩니다.
When to Use Terra First and Escalate to Sol
하이브리드 워크플로는 초기에 Terra를 사용하고, 사전 정의된 체크에 실패하면 Sol로 승급할 수 있습니다. 승급은 모델의 자체 신뢰도보다는 관측 가능한 결과에 기반하세요.
예를 들어, 코드 생성 워크플로는 다음과 같이 할 수 있습니다:
Terra에 요청된 변경을 생성하도록 합니다.
관련 테스트와 검증 체크를 실행합니다.
변경이 해당 체크에 실패하거나 Terra의 검증된 역량을 벗어나면 Sol로 승급합니다.
재시도 예산을 소진한 후에도 해결되지 않으면 휴먼 리뷰로 넘깁니다.
승급 시 원래 요청, 관련 컨텍스트, 실패한 출력, 검증 결과를 보존하세요. 두 모델의 사용량을 모두 기록해 전체 워크플로를 비용 비교에 포함시키세요.
Production Evaluation Checklist
배포 전 기본 모델을 선정하거나 승급 워크플로를 설계할 때:
대표 작업 사용: 반복 요청과 실패 비용이 큰 사례를 포함하세요.
통제된 비교 유지: 지시문, 증거, 도구, 승인 기준을 동일하게 유지하세요. 모델 ID, 엔드포인트, 추론 설정, 테스트 날짜를 기록하세요.
승인 결과 측정: 정확도, 스키마 유효성(해당 시), 테스트 통과, 수동 개입 없는 완료를 확인하세요.
시간과 지출 측정: 중앙값·꼬리 지연, 청구된 토큰, 도구 호출, 재시도, 휴먼 리뷰 노력을 추적하세요.
비교 반복: 작업을 여러 번 실행하고 모델 순서를 교차하여 일회성 결과의 영향을 줄이세요.
운영 제한 정의: 재시도 예산, 승급 트리거, 휴먼 승인 요건을 사전에 설정하세요.
전체 워크플로 비교: 성공하지 못한 시도와 승급 비용을 포함해 성공 작업당 지출을 계산하세요.
Where Can You Access GPT-6.1 Terra and GPT-6.1 Sol?
Official Provider Access
두 모델 모두 OpenAI API를 통해 제공됩니다. 텍스트 요청에는 Chat Completions가 지원되며, 도구 호출은 Responses API가 필요합니다. 사용할 경로에서 지원되는 파라미터, 계정 한도, 도구를 확인하세요.
CometAPI Access
CometAPI를 통해 모델을 사용하려면, quickstart guide를 따라 OpenAI 호환 SDK를 설정하세요. COMETAPI_KEY 환경 변수로 CometAPI 키를 안전하게 제공하고, base URL을 https://api.cometapi.com/v1로 설정하세요. 모델 식별자로 gpt-6.1-terra 또는 gpt-6.1-sol을 선택하고, 계정에서 해당 경로가 활성화되어 있는지 확인하세요.
첫 비교에서는 두 모델에 동일한 대표 작업을 부여하고 중간 수준의 추론 노력으로 시작하세요. 지시문과 승인 기준을 일관되게 유지하고, 각 작업을 반복 실행하며, 모델 순서를 교차하세요. 단일 응답에 의존하기보다 성공 결과, 경과 시간, 청구 토큰, 재시도를 비교하세요.
Conclusion
빈번하고 검증 가능한 워크플로에서 낮은 토큰 가격과 빠른 작업 완료가 중요하다면 GPT-6.1 Terra로 시작하세요. 복잡한 코딩, 다단계 도구 사용, 실패 비용이 큰 상황에서는 더 높은 추론 능력이 유용하므로 GPT-6.1 Sol을 평가하세요. 최종 선택은 가격이나 단일 벤치마크가 아니라, 대표 평가 세트에서 성공 작업당 비용을 기준으로 해야 합니다.
많은 애플리케이션에서 다음 실용적 단계는 명확한 합격 조건과 제한된 승급 경로를 가진 소규모 대표 테스트입니다. 가격이나 단일 벤치마크에 의존하기보다 측정된 결과로 모델을 결정하세요.
Decision factor
GPT-6.1 Terra
GPT-6.1 Sol
Starting workload
일상적인 비전 작업과 반복 가능한 에이전트
복잡한 코딩과 지속적인 전문가 수준 추론
Context and modalities
동일한 총 컨텍스트 용량; 텍스트·이미지 입력
동일한 총 컨텍스트 용량; 텍스트·이미지 입력
Reasoning control
추론 끄기 옵션 포함
최소 낮은 수준의 추론 노력이 필요
Published performance pattern
반복 가능한 에이전트 작업에서 비용 효율적 성능
여러 어려운 코딩·데스크톱 테스트에서 더 강함
API access
OpenAI 및 CometAPI
OpenAI 및 CometAPI
Specification
GPT-6.1 Terra
GPT-6.1 Sol
Official release date
2026년 10월 26일
2026년 4월 30일
API model ID
gpt-6.1-terra
gpt-6.1-sol
Context window
1,050,000 tokens
1,050,000 tokens
Knowledge cutoff
2026년 6월 1일
2026년 4월 30일
Input / output
텍스트와 이미지 / 텍스트
텍스트와 이미지 / 텍스트
Reasoning effort
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Default reasoning effort
medium
medium
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Comparison at max effort
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Factual error rate on difficult prompts
10.10%
4.30%
4.40%
Terra 0.1 pp 낮음
Provider and token category
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — input
$1.00
$2.00
OpenAI Standard — cached input
$0.05
$0.10
OpenAI Standard — output
$5.00
$10.00
OpenAI Standard — 30-minute cache write
$1.25
$2.50
OpenAI Standard — 12-hour cache write
$2.50
$5.00
CometAPI ordinary input
$0.80
$1.60
CometAPI ordinary output
$4.00
$8.00
GPT-6.1 Terra vs GPT-6.1 Sol: 벤치마크, 가격, 그리고 어떤 것을 선택할지 - CometAPI