
요약
GPT-6 Astra는 탁월한 헤드라인 점수를 기록했으며, 추론을 실행으로 전환해야 하는 영역에서 가장 큰 향상이 나타난다: 터미널 작업, 소프트웨어 사용, 자동화, 장기 컨텍스트 검색, 과학 워크플로, 사이버보안. 이미 포화된 학술 시험에서는 이전 OpenAI 세대 대비 향상이 종종 훨씬 작다.
이 모델은 1,050,000 토큰 컨텍스트 윈도우와 폭넓은 도구 지원을 결합한다. OpenAI가 공개한 실행 벤치마크는 실제 업그레이드가 장기 과제에서 가장 강하다고 시사하지만, 하네스 설계, 추론 강도, 지연시간, 도구 접근성이 결과에 실질적으로 영향을 준다.
핵심 요점
- Astra의 가장 명확한 향상은 에이전트형 실행에서이지, 모든 형태의 질의응답에서가 아니다.
- Terminal-Bench, AutomationBench, 컴퓨터 사용, 데이터베이스 마이그레이션 결과는 GPQA나 DeepSWE보다 훨씬 큰 변화를 보여준다.
- ARC-AGI-3 결과는 모델 상태, 컨텍스트 관리, 평가 하네스가 최종 점수를 지배할 수 있음을 보여준다.
- 대형 컨텍스트 윈도우는 한계 근처에서도 정보가 검색 가능할 때만 의미가 크다; 광고된 용량 그 자체보다 MRCR이 더 정보량이 크다.
- 토큰 단가가 높다고 해서 반드시 작업 비용이 높아지는 것은 아니다. 모델이 더 적은 토큰, 회차, 재시도, 사람 교정을 필요로 할 수 있기 때문이다.
- 프로덕션 의사결정은 성공률, 경과 시간, 총비용, 도구 신뢰성, 교정 부담을 함께 비교해야 한다.
GPT-6 Astra 한눈에 보기
OpenAI는 최대 128,000 출력 토큰, 텍스트·이미지 입력, 텍스트 출력, 추론 강도는 low부터 max까지를 명시한다. 이 사양은 대규모 다단계 워크플로를 가능하게 하지만, 모델이 올바른 증거를 검색하거나 작업을 신뢰성 있게 완료함을 증명하지는 않는다.
| 공식 사양 | CometAPI의 GPT-6 Astra | 실질적 의미 |
|---|---|---|
| Model ID | gpt-6-astra | API 라우팅을 위한 안정적 식별자 |
| Context window | 1,050,000 tokens | 대규모 리포지토리, 아카이브, 에이전트 기록 지원 |
| Maximum output | 128,000 tokens | 대형 보고서, 패치, 구조화 산출물 생성 가능 |
| Knowledge cutoff | April 30, 2026 | 이후 사실은 도구나 제공 자료 필요 |
| Input | Text and images | 문서, 스크린샷, 다이어그램, 혼합 증거 지원 |
| Output | Text | 산문, 코드, 구조화 텍스트 생성 |
| Reasoning effort | low, medium, high, xhigh, max | 더 깊은 탐색을 위해 지연·비용을 교환 |
| Agent capabilities | Function calling, structured outputs, computer use, web/file search, hosted shell, Apply Patch, MCP | 개별 답변이 아닌 종단간 워크플로 가능 |
| OpenAI Standard input | $10 per million tokens | 입력 크기와 캐시 재사용이 총비용에 영향 |
| OpenAI cached input | $1 per million tokens | 프롬프트 접두부를 캐시에서 재사용 시 적용 |
| OpenAI cache writes | $12.50 per million tokens | 비캐시 입력 요율의 1.25×로 청구 |
| OpenAI Standard output | $50 per million tokens | 장황한 출력이 작업 비용을 지배할 수 있음 |
| Requests above 272K input tokens | Input 및 캐시 요율 ×2; 출력 요율 ×1.5 | 높은 요율이 요청 전체에 적용 |
컨텍스트 한도는 용량을 측정할 뿐, 실제 검색 가능성을 보장하지 않는다. 도구 목록은 가용성을 의미할 뿐, 성공적 실행을 담보하지 않는다. 사양이 실제 완성된 작업으로 번역되는지를 검증하려면 벤치마크가 필요하다.
GPT-6 Astra의 벤치마크 결과는 무엇을 보여주나?
포트폴리오는 불균등한 패턴을 보인다. Astra는 일부 학술·소프트웨어 추론 테스트에서는 Sol을 간신히 넘어서는 반면, 터미널 작업, 자동화, 데이터베이스 마이그레이션, 시각 상호작용, 장기 컨텍스트 검색, 고급 수학에서는 두 자릿수 향상을 보인다.
| 공개 벤치마크 | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Astra vs. Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | +20.6 pp |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | +1.4 pp |
| Database Migration Tasks | 63.9% | 42.7% | 57.8% | +21.2 pp |
| OSWorld 2.0 | 72.6% | 65.7% | — | +6.9 pp |
| ScreenSpot-Pro | 92.7% | 76.9% | — | +15.8 pp |
| AutomationBench | 41.4% | 18.1% | 31.4% | +23.3 pp |
| BenchCAD | 95.9% | 83.3% | 84.3% | +12.6 pp |
| FrontierMath Tier 4 v2 | 97.6% | 83.0% | 87.8% | +14.6 pp |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | +1.4 pp |
| MRCR v2, 512K–1M | 96.3% | 73.8% | — | +22.5 pp |
| AA Intelligence Index v4.1.1 | 61.2 | 60.9 | 65.7 | +0.3 |
| ARC-AGI-3, Provider Adapter | 99.9% | 7.8% | — | +92.1 pp |
세 가지 클러스터가 드러난다. 첫째, DeepSWE와 GPQA에서의 1.4포인트 격차는 이미 강한 모델이 잘 수행하는 과제에서의 점진적 향상이 제한적임을 시사한다. 둘째, Terminal-Bench, AutomationBench, 데이터베이스 마이그레이션, 백만 토큰 검색에서 20포인트 이상의 격차는 실행 성능에서 훨씬 큰 변화를 보여준다. 셋째, ARC-AGI-3는 그 해석이 하네스에 의존하는 특이값이다.
독립 테스트 결과
Artificial Analysis는 Intelligence Index에서 Astra와 Sol이 대략 61로 비슷하다고 보고하는 반면, Coding Agent Index에서는 훨씬 더 명확한 향상을 보여준다. 이는 OpenAI 데이터의 패턴을 독립적으로 보강한다: 가장 큰 개선은 에이전트형 실행에 집중되어 있다.
Codex 하네스에서 최대 강도로, Astra는 Coding Agent Index에서 Sol 대비 약 3분의 1 토큰만 사용한다고 전해진다. Intelligence Index의 토큰 사용은 약 10%만 감소한다. Astra의 토큰 단가는 더 높기 때문에, 이 두 가지 효율 프로파일은 서로 다른 경제성을 만든다.
| 독립 평가 | 관찰 결과 | 프로덕션 해석 |
|---|---|---|
| Intelligence Index | Sol과의 분리도 낮음 | 광범위 추론은 큰 가격 프리미엄을 정당화하지 않을 수 있음 |
| Coding Agent Index | 명확한 에이전트형 개선 | 더 적은 토큰이 더 높은 토큰 단가를 상쇄할 수 있음 |
| AA-Omniscience | 최대 강도에서 환각률 92% → 51%로 하락 | 연구·검색 시스템에서는 더 나은 응답 보류가 중요할 수 있음 |
| 장기 지식 작업 | 과제별 혼합된 진전 | 현지 평가가 여전히 필요 |
어떤 독립 벤치마크도 프로덕션 사실성이나 안전성을 인증하지 않는다. 팀은 정답, 정당한 불확실성, 근거 없는 주장, 소스 제약 위반을 별도로 채점해야 한다.
Astra가 장기 에이전트형 작업에 더 적합한 이유
GPT-6 Astra는 실행 중에 작업이 변하는 상황을 위해 설계된 세 가지 제어를 추가한다. 장기 실행 신뢰성은 전체 컨텍스트 시스템에도 좌우된다: 컨텍스트 윈도우는 용량을 설정하고; 압축은 과거 자료의 요약 방식을 제어하며; 지속 추론은 관련 모델 상태를 이어가고; 검색은 이전 증거를 찾을 수 있게 하며; 애플리케이션은 중요한 도구 출력, 테스트 결과, 실패한 접근, 사용자 요구를 보존해야 한다. 이 메커니즘은 에이전트 하네스와 함께 테스트되어야 한다.
- 비동기 도구 호출: 긴 실행 도구가 동작하는 동안 Astra는 독립 추론을 계속하거나 다른 도구를 호출할 수 있다.
- 턴 중간 조정: 애플리케이션은 WebSocket으로 교정을 보내거나 새로운 요구사항을 전달해도, 완료된 작업을 폐기하지 않는다.
- 대화 중 추론 조정: 캐시된 프롬프트 접두부를 보존한 채 구성 업데이트로 추론 강도를 높이거나 낮출 수 있다.
Astra가 실제로 개선된 영역
에이전트형 코딩: 더 큰 업그레이드는 터미널 작업
Terminal-Bench 4.0은 에이전트가 고난도 터미널 과제를 해결할 수 있는지를 평가하며, 단일 코드 답안을 생성하는 데 그치지 않는다. Astra는 57.9%를 기록해 Sol보다 20.6포인트, Fable보다 2.1포인트 높다. OpenAI 세대 간에는 상당한 개선이지만, 다른 프런티어 에이전트형 시스템과의 격차는 더 좁다.
DeepSWE는 다른 이야기를 한다: Astra 74.1%, Sol 72.7%. 1.4포인트 격차는 하나의 코딩 벤치마크로 일반화하는 데 신중해야 함을 시사한다. Astra는 코딩이 환경 상호작용, 반복, 상태 보존, 검증을 요구할 때 가장 큰 이득을 얻는 것으로 보인다.
Database Migration Tasks는 이 해석을 강화한다. 63.9%는 Sol 대비 21.2포인트, Fable 대비 6.1포인트 높다. 마이그레이션 작업은 코드 이해, 도구 사용, 순서화, 운영 판단을 결합한다—작은 추론 향상이 훨씬 큰 완료율 향상으로 누적될 수 있는 복합 워크플로다.
코딩 에이전트를 평가할 때는 모델과 하네스를 함께 평가하라. 리포지토리 지침, 터미널 도구, 재시도 동작, 컨텍스트 보존, 테스트 실행 모두가 측정 결과에 기여한다.
컴퓨터 사용: 성공률과 런타임 모두 중요
Agents’ Last Exam에서 GPT-6 Astra는 59.3%, GPT-5.6 Sol은 53.6%로, 5.7포인트 향상이다. 이는 위의 벤치마크 개요에 있는 OSWorld 2.0과 ScreenSpot-Pro 점수에 더해, 보다 광범위한 에이전트 과제 결과를 추가한다.
정확도 외에도, OSWorld 런타임 비교는 또 다른 실용적 차원을 제공한다: OpenAI는 Astra가 과제당 약 40분, Sol은 약 75분으로 보고했으며, 성공률 증가와 함께 경과 시간이 약 47% 감소했다.
성공률이 약간 더 높고 훨씬 더 빨리 끝나는 에이전트는 큰 처리량 개선을 제공할 수 있다. 따라서 조달 테스트는 정확도만이 아니라, 성공률, 경과 시간, 도구 호출, 재시도, 인간 개입도 함께 보고해야 한다.
자동화와 전문 업무
AutomationBench는 18.1%에서 41.4%로 23.3포인트 상승했다. 절대 점수는 여전히 완벽과 거리가 있지만, 포화 근처의 1포인트 움직임보다 실패 프로파일의 변화가 더 의미 있다. BenchCAD에서 Astra는 95.9%를 기록해 Sol보다 12.6포인트, Fable보다 11.6포인트 앞선다.
이 결과는 특정 주장을 뒷받침한다: Astra는 지시를 검증된 행동 시퀀스로 전환하는 능력이 더 뛰어나다. 이는 모든 비즈니스 워크플로에서 동일한 향상을 보장하지는 않는다. 프로덕션 프로세스에는 인증 단계, 독점 인터페이스, 모호한 정책, 벤치마크에 없는 데이터 형식이 추가될 수 있다.
과학
과학은 Astra의 가장 뚜렷한 역량 향상 중 하나다. FrontierMath Tier 4 v2에서 Astra는 97.6%를 기록하며, Sol 83.0%, Fable 87.8%와 비교해 14.6포인트 앞선다. 이는 상당한 벤치마크 향상이지만, 전체 과학 워크플로가 아닌 선별된 과제 분포를 다룬다.
사이버보안
사이버보안은 보통의 리더보드 움직임보다 더 높은 중요도를 지닌 두 번째 주요 향상 영역이다. 2026년 6–8월을 다루는 ExploitBench에서 Astra는 39.0%, Sol은 5.5%를 기록했다. OpenAI는 이 새로운 세트가 최근 3개월의 취약점을 대상으로 하여 과거 노출로 인한 영향을 줄였다고 보고했다. OpenAI의 사이버보안 평가에서, Astra는 통제된 테스트 중 이전에 알려지지 않은 제로데이 취약점 두 건을 발견·익스플로잇하는 능력을 보였다. 이 결과는 오래된 보안 이슈가 아닌 최근 공개 취약점을 중심으로 평가가 설계되었다는 점에서, 단순 암기 사례로 인해 성능이 부풀려졌을 가능성을 줄였다는 점이 중요하다. 이 결과는 Astra가 OpenAI의 Critical 사이버보안 역량 임계치에 도달하는 데 기여했으며, 그에 따라 배포에 필요한 보호장치가 변경되었다. 이는 Astra가 무제한의 자율 사이버 작전을 수행할 수 있음을 의미하는 것이 아니라, 역량 수준이 배포 보호장치 요구사항을 변화시킨다는 의미다. 더 강한 취약점 발견·익스플로잇 능력을 가진 시스템은 더 엄격한 접근 제어, 모니터링, 샌드박싱, 인간 검토 메커니즘이 필요하다.
장기 작업: 컨텍스트 윈도우가 전부는 아니다
Astra의 1,050,000-토큰 컨텍스트 윈도우는 용량을 설명할 뿐이다. 장기 실행 성능은 압축, 지속 상태, 검색 가능한 이전 컨텍스트, 보존된 추론 상태, 도구 출력 보존에도 좌우된다. MRCR v2에서 Astra는 256K–512K 구간에서 100.0%, 512K–1M에서 96.3%를 기록한 반면, Sol은 각각 91.5%, 73.8%였다. 가장 긴 구간에서의 22.5포인트 격차는 한계 근처에서의 사용 가능한 검색성이 광고된 용량 자체보다 더 중요함을 보여준다.
MRCR은 여전히 합성 검색 테스트이므로, 프로덕션 평가는 요약이 종종 잃어버리는 증거를 보존해야 한다: 이전 수정이 실패한 이유, 특정 구성요소의 동작, 테스트 결과, 과거 요구사항, 도구 출력에 묻힌 세부사항. 또한 리포지토리와 연구 아카이브는 중복 이름, 교차 참조, 오래된 정책, 상충 소스, 긴 미끼 구간과 함께 테스트해야 한다. 이는 순수 컨텍스트 용량과 장기 에이전트가 실제로 필요로 하는 컨텍스트 보존·검색 행동을 구분한다.
컨텍스트 보존: Astra가 전통적 장문맥 시스템과 다른 점
전통적 장문맥 워크플로는 보통 다음 패턴을 따른다:
context → compaction → summary → continue
이 접근은 토큰 사용량을 줄이지만, 요약 과정에서 중요한 중간 정보가 사라질 수 있다는 중대한 위험을 도입한다.
유실되는 정보는 종종 최종 답 그 자체가 아니라, 향후 의사결정에 필요한 운영 세부사항이다:
- 이전 수정이 실패한 이유;
- 비정상 동작을 보인 구성요소;
- 구현 방향을 바꾼 테스트 결과;
- 나중에 추가된 사용자 요구사항;
- 중요한 증거가 담긴 도구 출력.
GPT-6 Astra는 장기간 실행되는 에이전트 워크플로 내부에서 컨텍스트 보존과 검색 메커니즘을 결합하여 이 한계를 해결한다.
압축 요약에만 의존하는 대신, 시스템은 중요한 메모를 보존하고, 필요할 때 이전 정보를 검색하며, 여러 도구 상호작용 사이에서 연속성을 유지할 수 있다.
Codex 같은 코딩 에이전트의 경우, 긴 디버깅 작업이 다음을 유지할 수 있음을 의미한다:
- 이전 실패 실험;
- 리포지토리 변경 사항;
- 테스트 출력;
- 아키텍처 결정;
- 미해결 이슈.
따라서 Astra의 100만 토큰 컨텍스트 윈도우의 가치는 단지 수용 가능한 정보량에 있지 않고, 몇 시간의 상호작용 후에도 올바른 정보를 보존·복구할 수 있는지에 달려 있다.
추론과 해석
ARC-AGI-3: 하네스도 결과의 일부다
ARC-AGI-3는 프런티어 벤치마크가 고립된 모델이 아닌 시스템을 측정할 수 있음을 가장 명확히 보여준다. ARC Prize는 표준 하네스에서 최대 강도 62.7%, Provider Adapter에서 높은 강도 99.9%를 보고한다.
| ARC Prize 평가 | Standard Harness | Provider Adapter | Adapter Gain |
|---|---|---|---|
| max | 62.7% | 98.6% | +35.9 pp |
| xhigh | 59.3% | 98.4% | +39.1 pp |
| high | 54.8% | 99.9% | +45.1 pp |
| medium | 38.6% | 98.4% | +59.8 pp |
| low | 17.5% | 98.0% | +80.5 pp |
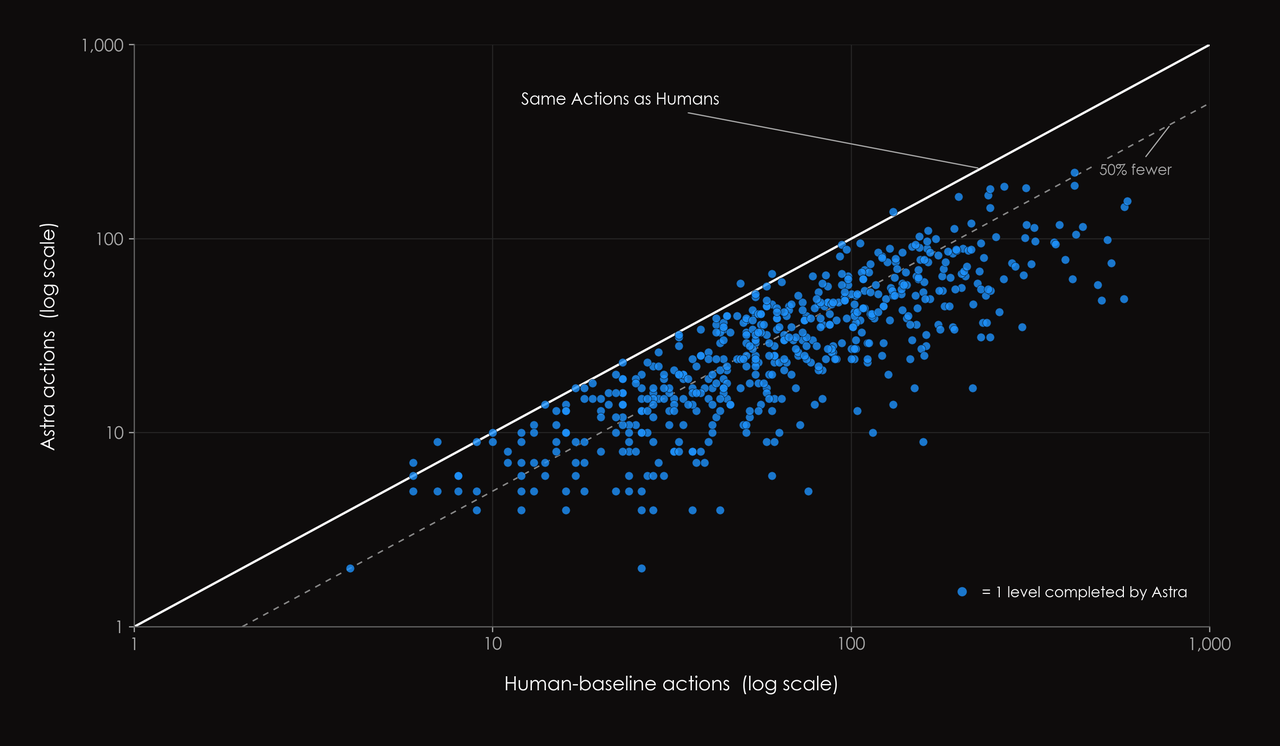
ARC Prize에서 하네스별 Astra 행동 효율 비교
공급자 중립 하네스 정책은 모델이 중요한 정보를 가시 상태에 보존할 것을 요구한다. Provider Adapter는 추가 추론 상태를 보존하고, 공급자별 컨텍스트 관리를 사용한다. 공유된 해결 게임-추론 쌍 전반에서, ARC Prize는 어댑터 사용 시 3.66× 더 빠른 실행과 총 토큰 49% 감소를 보고한다.
99.9% 결과는 특정 모델–공급자–어댑터 시스템을 측정한 것이며, 하네스와 무관한 순수 모델 지능의 척도로 간주되어서는 안 된다. 컨텍스트 아키텍처는 벤치마크된 시스템의 일부다.
추론 강도는 선형적으로 스케일하지 않는다
ARC 표는 또한 최대 강도가 항상 최고 점수를 내지 않음을 보여준다. Provider Adapter에서는 높은 강도가 99.9%에 도달하며, max는 98.6%다. 표준 하네스에서는 max가 가장 좋다.
OpenAI는 출시 표의 수치가 일반적으로 최고 관측 추론 설정을 사용한다고 언급한다. 이 접근은 성능 상한을 추정하지만, 최적의 프로덕션 구성을 식별하지는 않는다. 팀은 여러 강도를 테스트하고, 추가 1초·1달러당 한계 품질 향상을 계산해야 한다.
수학과 학술 추론
FrontierMath Tier 4 v2는 83.0%에서 97.6%로 14.6포인트 상승했다. 이는 큰 벤치마크 향상이지만, 프런티어 수학이 해결되었다는 증거는 아니다. 평가는 선별된 과제 분포를 다루며, 문제 선정, 형식적 증명 검증, 장기 프로그램 개발, 적대적 동료 검토 등 수학 연구의 모든 단계를 측정하지 않는다.
GPQA Diamond는 반대 패턴을 제공한다: Astra 96.0%, Sol 94.6%, Fable 93.7%, Gemini 3.8 Flash 95.3%. 모델들은 천장 근처에서 촘촘히 클러스터링된다. Astra–Sol 1.4포인트 차이를 보고하는 것은 정확하지만, 이를 광범위한 지능 혁명으로 부르는 것은 과장일 수 있다.
Critical capability + 보호장치
| 사이버보안 평가 | Astra | Sol | 절대 향상 |
|---|---|---|---|
| ExploitBench | 100.0% | 78.5% | +21.5 pp |
| ExploitGym | 42.4% | 30.3% | +12.1 pp |
| ExploitBench, June–August 2026 | 39.0% | 5.5% | +33.5 pp |
| SRE-Bench | 88.0% | 55.9% | +32.1 pp |
| SEC-Bench Pro | 85.4% | 79.1% | +6.3 pp |
OpenAI는 ExploitBench(2026년 6–8월)를 직전 3개월 동안 공개된 취약점에서 구성해, 과거 취약점 노출이 결과를 부풀렸을 가능성을 낮췄다. Astra는 이 세트에서 39.0%를, Sol은 5.5%를 기록했으며, OpenAI는 Astra가 이전에 알려지지 않은 제로데이 취약점 두 건을 발견·익스플로잇했다고 보고한다. 이러한 결과는 Astra가 OpenAI에서 폭넓게 배포된 모델 중 최초로 Critical 사이버보안 역량 임계치에 도달하는 데 기여했으며, 이는 보호장치와 접근 정책에 직접적인 영향을 미쳤다.
포화 근처 점수를 읽는 법
90% 이상의 점수는 중간 범위 결과보다 더 신중한 언어가 필요하다. 50%에서 60%로 이동하면 100개 중 10개를 추가로 해결한다. 95%에서 96%로 이동하면 100개 중 단 1개를 더 해결하지만, 남은 오류 수는 5개에서 4개로 줄어든다—오류가 20% 감소한 것이다. 두 설명 모두 수학적으로 맞지만, 매우 다른 헤드라인을 지지한다.
반대로 저득점 벤치마크에 대한 주의도 필요하다. 18.1%에서 41.4%로의 상승은 여전히 신뢰할 수 있는 자율 운영과 거리가 멀지만, 성공 사례 수를 두 배 이상 늘려 감독되는 워크플로를 변모시킬 수 있다. 절대 점수는 시스템의 준비도를 결정하고, 개선 폭은 역량이 얼마나 빠르게 변하는지를 나타낸다. 프로덕션 의사결정에는 두 가지가 모두 필요하다.
다차원 비교
| 차원 | Astra | Sol | Fable | 의사결정 시그널 |
|---|---|---|---|---|
| 일반 학술 추론 | 우수; 종종 포화 근처 | 바로 뒤를 따름 | 경쟁력 있음 | 소폭 격차만으로 배포 결정을 내리진 않음 |
| 터미널 실행 | 최상위권 | 세대 간 큰 격차 | 근접 경쟁자 | 전체 코딩 하네스를 테스트 |
| 컴퓨터 사용 | 더 높은 성공과 더 낮은 런타임 | 더 느리고 덜 정확 | 출시 표에 직접 비교 데이터 부족 | 시간당 성공을 측정 |
| 장기 컨텍스트 검색 | 100만 토큰 근처에서도 강함 | 한계 근처에서 실질적 성능 저하 | 직접 비교 가능한 데이터 부족 | 프로덕션 형태의 검색 테스트 사용 |
| 추론 제어 | low부터 max까지 | 다른 강도 범위 | 적응형 사고 접근 | 모델 이름만이 아니라 구성을 튜닝 |
| 사이버 역량 | 질적으로 더 높은 위험 등급 | 더 낮은 공개 결과 | 여기서 비교하지 않음 | 보호장치와 접근 정책이 중요 |
| 토큰 경제성 | 더 높은 요율; 때로 더 적은 토큰 | 더 낮은 요율 | 작업 부하에 따라 다름 | 성공한 작업당 비용을 비교 |
결과는 작업 부하에 따라 달라진다. Astra는 도구와 환경과의 지속적 상호작용, 실패 후 복구, 매우 큰 컨텍스트 전반의 신뢰 가능한 검색이 요구될 때 가장 설득력이 있다. Sol은 컨텍스트가 보통 수준이고 반복이 제한된 경계 작업에서는 경제성이 더 나을 수 있다. Fable은 터미널 작업에서 근접 경쟁자이며 일부 외부 학술 평가에서 앞서므로, 공급자 수준 결론보다 애플리케이션 수준 벤치마크가 더 유용하다.
누가 GPT-6 Astra를 사용해야 할까?
| 사용 사례 | 권장 사항 |
|---|---|
| 단순 분류 | 반드시 Astra를 쓸 필요는 없음 |
| 단순 요약 | 반드시 Astra를 쓸 필요는 없음 |
| 표준 RAG | 비용 대비 성능을 먼저 벤치마크 |
| 장문서 통합·분석 | Astra 테스트할 가치 있음 |
| 에이전트형 코딩 | 강력히 테스트 권장 |
| 컴퓨터 사용 | 강력히 테스트 권장 |
| 다단계 자동화 | 강력히 테스트 권장 |
| 복잡한 리서치 | 테스트할 가치 있음 |
| 과학 컴퓨팅/전문 소프트웨어 | 테스트할 가치 있음 |
| 사이버보안 | 강력한 역량, 적절한 안전 통제가 필요 |
| 고처리량의 단순 작업 | 저비용 모델이 더 비용 효율적일 수 있음 |
GPT-6 Astra의 성능 향상은 더 높은 가격을 정당화하는가?
GPT-6 Astra는 GPT-5.6 Sol보다 상당히 비싸지만, 벤치마크 개선이 모든 작업 부하에 균등하게 분포하는 것은 아니다. 따라서 가격 질문은 토큰 요율만 비교해서는 답할 수 없다.
| 시나리오 | 성능 향상 | 비용 정당화 |
|---|---|---|
| 단순 Q&A | 소폭 개선 | 보통 프리미엄을 정당화하지 못함 |
| 코딩 에이전트 | 큰 개선 | 프리미엄 정당화 가능 |
| 장기 컨텍스트 분석 | 유의미한 개선 | 검색 필요에 따라 다름 |
| 컴퓨터 자동화 | 강한 개선 | 종종 테스트할 가치 있음 |
| 일반 추론 | 제한적 개선 | 비용을 신중히 비교 |
OpenAI Standard 요율에서 GPT-6 Astra는 입력 100만 토큰당 $10, 캐시된 입력 100만 토큰당 $1, 캐시 쓰기 100만 토큰당 $12.50, 출력 100만 토큰당 $50가 든다. Standard 입력과 출력은 GPT-5.6 Sol의 $4와 $20 대비 2.5×다. 요청이 272K 입력 토큰을 초과하면, Astra의 입력·캐시 요율은 2배로, 출력 요율은 1.5×로 전체 요청에 적용된다.
가격 프리미엄은 에이전트형 작업과 가장 명확히 일치한다. Astra는 Terminal-Bench, AutomationBench, 데이터베이스 마이그레이션, 최장 구간 MRCR에서 20포인트 이상 향상했고; 독립 테스트는 Coding Agent Index에서 Sol 대비 약 3분의 1 토큰 사용을 보고했다. 일반 추론에서는 Intelligence Index가 거의 비기고 토큰 사용이 약 10%만 감소하므로 일치도가 약하다. 구매 결정은 출력, 캐시 활동, 도구 사용, 경과 시간, 재시도, 실패, 인간 교정을 포함해 성공한 작업당 비용을 비교해야 한다.
작업 성공 1건당 비용
작업 성공 1건당 비용 = (Input cost + Output cost + Tool cost + Retry cost + Human review cost) / Successful tasks
예상 비즈니스 비용
예상 비즈니스 비용 = API cost + Tool cost + Retry cost + Human-review cost + Failure cost
의사결정 지표는 백만 토큰당 가격표가 아니라, 허용 가능한 품질 임계치에서 성공한 작업 수로 나눈 총비용이어야 한다.
개발자가 Astra를 벤치마크하는 방법
공개 리더보드는 무엇을 테스트할 가치가 있는지 결정하는 참고일 뿐, 최종 배포 결정을 대신할 수 없다. 일상 사례, 어려운 사례, 누락 컨텍스트 사례, 도구 실패, 적대적 지시를 포함한 대표 과제 세트를 구축하라. 모든 모델에 동일한 프로덕션 프롬프트, 권한, 소스 파일, 시간 예산, 완료 기준을 사용하라.
| 평가 차원 | 측정치 | 중요한 이유 |
|---|---|---|
| 작업 성공 | 수용 기준 통과 | 그럴듯하지만 불완전한 답변이 성공으로 점수화되는 것을 방지 |
| 신뢰성 | 반복 실행 전반의 성공 분포 | 불안정한 일회성 승리를 노출 |
| 도구 실행 | 검증된 성공 행동 | 단순 도구 호출과 올바른 결과를 구분 |
| 사실성 | 근거가 뒷받침된 사실 주장 | 증거 품질과 응답 보류를 측정 |
| 지연 | 완료 시간의 중앙값과 꼬리 | 운영 처리량을 포착 |
| 비용 | 작업 성공 1건당 총비용 | 재시도와 실패 시도를 포함 |
| 인간 노력 | 교정 및 검토 시간(분) | 실제 배포 비용을 종종 지배 |
| 조정 가능성 | 요구사항 변경 후 복구 | 장기 에이전트 동작을 테스트 |
CometAPI의 Astra API는 모델 ID gpt-6-astra를 사용한다. 멀티 모델 API는 동일한 평가를 Astra, Sol, Fable, Gemini 전반에 실행하면서, 한 공급자의 헤드라인 차트에 맞춰 벤치마크를 재설계할 필요를 줄여준다. 요구도가 높은 에이전트형 작업은 프리미엄을 정당화하는 모델로 라우팅하고, 측정된 이점이 사라지는 곳에는 저비용 모델을 사용하라.
결론
Astra의 벤치마크 시트는 인상적이지만, 가장 화려한 점수가 자동으로 가장 유용한 것은 아니다. ARC-AGI-3는 공급자별 에이전트 하네스의 잠재력을 보여주며; 표준 하네스 점수는 인프라가 결과에 얼마나 크게 기여하는지 보여준다. GPQA와 독립 Intelligence Index는 일반적 추론 향상이 온건할 수 있음을 보여준다. 터미널 작업, 자동화, 컴퓨터 사용, 장기 컨텍스트 검색, 과학 워크플로, 사이버보안이 더 중요한 이야기를 들려준다.
이번 출시의 요지는 챗봇이 모든 질문에 비례적으로 더 똑똑해진 것이 아니라, 프런티어 지능이 일을 더 잘 마무리하게 되었다는 점이다. 그 업그레이드를 지불할 가치가 있는지는 전체 모델–시스템 구성과 성공적인 프로덕션 작업의 경제성에 달려 있다.