최신 요금표(특히 Kimi K2.7/K2.6/K2.5)와 기능별 과금이 제 지식 범위(2024-10) 이후에 업데이트되었을 수 있어 정확한 수치를 단정할 수 없습니다. 공식 가격 페이지(또는 스크린샷/표)를 주시면 즉시 정밀 비교표로 정리해 드리겠습니다. 우선, 필요한 비교 항목과 “실제 코딩‑에이전트 비용” 계산 방법/템플릿을 제공합니다.
비교 항목 체크리스트(모델별 공통)
- 통화/지역: USD/CNY 등
- 과금 단위: 1K 입력 토큰, 1K 출력 토큰
- 컨텍스트 창/토큰 한도
- 캐시 정책: 캐시 가능 범위, 캐시 토큰 단가 또는 할인율, 캐시 보존/무효화 조건
- Batch API: 할인율(%), 최소 배치 크기/제한, 지연 허용 범위
- WebSearch: 호출당 고정 수수료, 검색 결과 토큰 과금 방식(있다면), 무료쿼리/쿼터
- CometAPI: 호출당/분당 요금, 포함 리소스(예: 코드 실행/메모리/스토리지), 무료 크레딧
- 기타 도구호출 과금: 함수호출/툴콜 토큰 과금 규칙, 외부 API 패스스루 비용 여부
- 속도/등급별(표준/가속) 단가 차등이 있는지
모델별 비교 템플릿(값만 채워 넣으면 바로 비교 가능)
- K2.7
- 입력 토큰: [ ]/1K
- 출력 토큰: [ ]/1K
- 컨텍스트: [ ] tokens
- 캐시: [캐시 토큰가 또는 할인율], [캐시 조건]
- Batch: [할인율], [최소 배치], [기타 제한]
- WebSearch: [호출당 ], [토큰 과금 규칙], [무료쿼리]
- CometAPI: [호출/분당 ], [제한/쿼터]
- K2.6
- 입력 토큰: [ ]/1K
- 출력 토큰: [ ]/1K
- 컨텍스트: [ ] tokens
- 캐시: [ ], [ ]
- Batch: [ ], [ ], [ ]
- WebSearch: [ ], [ ], [ ]
- CometAPI: [ ], [ ]
- K2.5
- 입력 토큰: [ ]/1K
- 출력 토큰: [ ]/1K
- 컨텍스트: [ ] tokens
- 캐시: [ ], [ ]
- Batch: [ ], [ ], [ ]
- WebSearch: [ ], [ ], [ ]
- CometAPI: [ ], [ ]
“실제 코딩‑에이전트 비용” 산정 방법
- 개념
- 계획/추론 토큰: 에이전트의 체인‑오브‑소트(Planning/Reasoning) 토큰
- 툴콜 토큰: 함수 인자(JSON 등)와 툴 응답 파싱에 쓰인 토큰
- 코드 실행 비용: CometAPI 등 런타임(분당/초당) 과금 + 실행 중 생성되는 모델 토큰
- WebSearch 비용: 호출당 고정 요금 + 검색/요약 과정 토큰
- 캐시 절감: 프롬프트/지시문/지식블록 재사용으로 인한 토큰 단가 절감
- Batch 절감: 동일 작업 대량 처리 시 단가 할인
- 실패/재시도 마진: 재시도율(%)을 비용에 가중
- 기초 변수
- PT: 총 입력 토큰
- CT: 캐시 적중 토큰(PT 중)
- OT: 총 출력 토큰
- IR: 입력 토큰 단가(/1K)
- CR: 캐시 토큰 단가(/1K) 또는 캐시 할인 적용 단가
- OR: 출력 토큰 단가(/1K)
- S: WebSearch 호출 수
- SF: WebSearch 호출당 수수료
- ST: WebSearch 관련 추가 토큰(요약/확장) 수
- Rm: 코드 실행 시간(분)
- RR: 런타임 단가(분당)
- BD: Batch 할인율(적용 시 0~1)
- FR: 실패/재시도율(0~1)
- 비용 공식(플러그‑인)
- 토큰 비용 = ((PT − CT) × IR + CT × CR)/1000 + (OT × OR)/1000
- WebSearch 비용 = S × SF + (ST × 관련 토큰 단가)/1000
- 코드 실행 비용 = Rm × RR
- 총비용(1회 시도) = 토큰 비용 + WebSearch 비용 + 코드 실행 비용
- Batch 적용 후 = 총비용 × (1 − BD)
- 재시도 반영 = Batch 적용 후 × (1 + FR)
- 실무 팁
- 캐시 전략: 정적 시스템 프롬프트/가이드라인/도메인 지식 블록을 캐시화해 CT를 극대화
- 툴콜 최소화: 하나의 툴콜에 더 많은 작업 인자를 묶어 호출 수 S를 축소
- 배치 묶음: 오프라인 대량 처리 라우트는 Batch API로 전환, BD 극대화
- 출력 제어: 필요 이상 장문 생성 억제해 OT를 관리
- 실패 예산: 재시도율(FR)을 주기적으로 측정해 예산 반영
비교 작업을 바로 진행하려면 아래 정보를 알려주세요.
- 통화/지역(USD/CNY 등)과 요금 플랜(종량제/엔터프라이즈)
- 각 모델(K2.7/K2.6/K2.5)의 공식 토큰 단가(입력/출력), 컨텍스트 크기
- 캐시 토큰 단가 또는 할인율과 적용 범위
- Batch API 할인율·조건
- WebSearch 호출당 수수료와 토큰 과금 규칙, 무료쿼터
- CometAPI(또는 코드 실행) 요금: 호출/분당/리소스 기준
- 예상 워크로드(요청당 PT/OT, 캐시 적중률, WebSearch 호출 수 S, 실행 시간 Rm, 재시도율 FR)
위 수치를 주시면 세 모델의
- 순수 토큰 단가 비교
- 캐시/Batch/검색/런타임 포함 “유효 단가”
- 사용 패턴별(검색 중심/코드 실행 중심/텍스트 생성 중심) 최소 비용 모델
을 한눈에 보이는 요약표로 제공해 드리겠습니다.
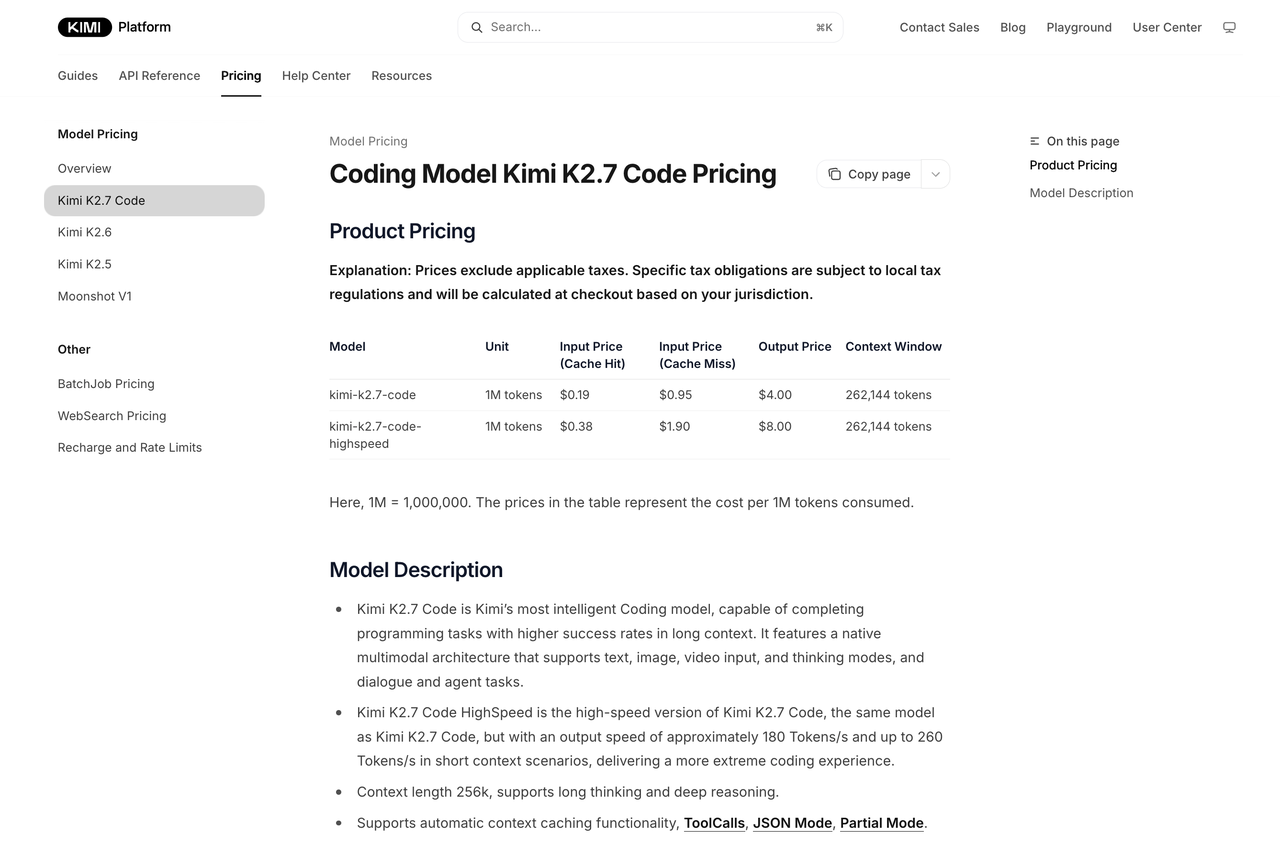
요약 Moonshot AI는 현재 Kimi K2.7 Code의 가격을 캐시 적중 입력 토큰 100만 개당 $0.19, 캐시 미스 입력 토큰 100만 개당 $0.95, 출력 토큰 100만 개당 $4.00로 책정하고 있습니다. Kimi K2.7 Code HighSpeed는 해당 요율을 두 배로 적용하여 $0.38 / $1.90 / $8.00입니다.
Moonshot의 K2.7 가격은 현재 프로모션입니다. 또한 Moonshot과 CometAPI는 서로 다른 입력 과금 구조를 사용하므로 표기된 요율을 직접적으로 동일 비교하면 안 됩니다.
Moonshot Kimi K2 가격 설명
K2.7 Code와 K2.6은 캐시 미스 입력 및 출력 가격이 동일합니다. 토큰 단위 차이는 K2.7 Code의 캐시된 입력 요율이 약간 더 높고, HighSpeed는 K2.7의 모든 요율을 두 배로 적용한다는 점입니다.
모델
적합한 용도
kimi-k2.7-code
코딩 에이전트, 저장소 편집, 장기 엔지니어링 작업
kimi-k2.7-code-highspeed
지연 시간이 중요하게 측정되는 대화형 코딩
kimi-k2.6
일반 멀티모달 추론, 에이전트 및 내장 WebSearch
kimi-k2.5
저비용 일반 및 멀티모달 워크로드
Moonshot은 HighSpeed를 동일한 기반 K2.7 Code 모델을 더 빠른 경로로 제공한다고 설명합니다. 문서화된 출력 속도는 대략 초당 180 토큰이며, 짧은 컨텍스트 상황에서는 초당 260 토큰까지 도달합니다. Moonshot이 리소스를 확장하는 동안 용량은 변동될 수 있습니다.
따라서 HighSpeed는 별도의 모델 품질 등급이라기보다 주로 지연 시간 선택지입니다.
Moonshot 직접 API의 대안: CometAPI
개발자는 Moonshot AI를 통해 직접 또는 CometAPI의 OpenAI 호환 API를 통해 Kimi K2.7 Code에 접근할 수 있습니다.
접근 경로
표준 입력
캐시된 입력
출력
Moonshot 직행 API
$0.95 / 1M 캐시 미스
$0.19 / 1M
$4.00 / 1M
CometAPI
$0.76 / 1M
별도 표기 없음
약 $3.20 / 1M
CometAPI의 표준 입력 및 출력 가격은 약 20% 낮으며, 캐시 적중 비율이 높은 워크로드에서는 Moonshot이 더 비용 효율적일 수 있습니다.
Kimi와 다른 모델 제공자를 하나의 API로 쓰고 싶다면 CometAPI를 선택하세요. 동일한 프롬프트나 저장소 컨텍스트를 자주 재사용한다면 Moonshot 직접 접근이 더 유리할 수 있습니다.
Initial model request
+ WebSearch tool fee
+ search-result input tokens
+ follow-up model request
+ retries
또한 중요한 모델 제약이 있습니다. Moonshot의 내장 WebSearch는 Thinking 비활성화를 요구하며, K2.7 Code는 비-Thinking 모드를 지원하지 않습니다. 공식 WebSearch 예제는 따라서 Thinking을 비활성화한 K2.6을 사용합니다.
Moonshot의 내장 검색을 사용할 경우 Thinking을 비활성화한 K2.6 또는 K2.5를 사용하세요.
K2.7 코딩 에이전트는 일반 함수 호출을 통해 독립적으로 구현된 검색 서비스를 호출할 수 있습니다. 이 경우 검색 과금은 Moonshot의 $0.005 내장 요금이 아니라 외부 제공자의 가격이 적용됩니다.
예시 1: 코딩 작업에서의 K2.7 Code 비용
다음과 같은 코딩 에이전트 워크플로우를 가정합니다:
30,000 캐시 미스 입력 토큰
8,000 출력 토큰(추론 포함)
내장 WebSearch 호출 없음
표준 K2.7 Code
구성 요소
계산
비용
입력
30,000 ÷ 1M × $0.95
$0.03
출력
8,000 ÷ 1M × $4.00
$0.03
합계
$0.06
K2.7 Code HighSpeed
구성 요소
계산
비용
입력
30,000 ÷ 1M × $1.90
$0.06
출력
8,000 ÷ 1M × $8.00
$0.06
합계
$0.12
동일한 토큰 사용량에서 HighSpeed는 정확히 두 배의 비용이 듭니다.
CometAPI K2.7 Code
현재 CometAPI 요율 사용:
구성 요소
계산
비용
입력
30,000 ÷ 1M × $0.76
$0.02
출력
8,000 ÷ 1M × $3.19998
약 $0.0256
합계
약 $0.0484
이는 이 예시에서 Moonshot 캐시 미스 토큰 비용 $0.0605 대비 약 20% 낮습니다. 계산에는 세금, 외부 도구 및 기타 플랫폼 서비스가 포함되지 않습니다.
예시 2: 내장 WebSearch를 사용한 K2.6
Thinking을 비활성화한 K2.6 워크플로우가 다음을 사용한다고 가정합니다:
전체 워크플로우에서 30,000 캐시 미스 입력 토큰
8,000 출력 토큰
성공한 내장 WebSearch 호출 1회
30,000 입력 토큰에는 후속 요청에 포함된 검색 결과 콘텐츠가 포함되어 있습니다.
구성 요소
계산
비용
입력
30,000 ÷ 1M × $0.95
0.0285
출력
8,000 ÷ 1M × $4.00
0.0320
WebSearch
1 × $0.005
0.0050
합계
0.0655
이 예시에서 직접적인 WebSearch 요금은 총액의 약 7.6%를 차지합니다. 더 긴 리서치 워크플로우에서는 검색 결과로 추가되는 토큰 비용이 도구 호출 자체 비용보다 더 클 수 있습니다.
공식 가격 문서는 모델이 어떻게 과금되는지 설명합니다. 외부 도입은 어디에 사용되고 개발자가 어떻게 평가하는지에 대한 추가 맥락을 제공합니다.
GitHub Copilot
GitHub는 2026년 7월 1일 Kimi K2.7 Code를 Copilot에서 일반 출시로 제공했으며, Copilot 모델 선택기에서 최초의 오픈 웨이트 모델이라고 설명했습니다. 초기에는 개인 요금제를 대상으로 제공되었고, 7월 7일 Business와 Enterprise 요금제로 확대되었습니다.
GitHub의 도입은 유의미한 배포 신호이지만, 모든 코딩 워크로드에서 K2.7이 다른 모델을 능가한다는 증거는 아닙니다.
Moonshot은 수정된 MIT 라이선스 하에 Hugging Face에 Kimi K2.7 Code를 게시합니다. 모델 카드는 1조 파라미터 Mixture-of-Experts 아키텍처, 활성 파라미터 320억, 256K 컨텍스트 윈도를 설명합니다. 또한 Transformers, vLLM, SGLang 같은 프레임워크용 배포 지침을 포함합니다.
Moonshot은 K2.6 대비 사고 토큰 사용량 약 30% 감소와 에이전트 능력 10% 향상을 보고합니다. 이는 벤더 보고 결과이며, 독립 워크로드로 검증해야 합니다.
Hacker News에서의 논의는 출시 자료보다 더 혼재되어 있습니다. 일부 개발자는 Kimi의 오픈 웨이트 가용성, 토큰 효율, 코딩 에이전트 도구 통합에 주목합니다. 다른 이들은 더 낮은 토큰 가격이 재시도, 감독, 컨텍스트 요구가 늘어나면 프로젝트 비용이 반드시 낮아지지 않는다고 주장합니다.
이 논의는 본 가이드의 핵심 권고를 뒷받침합니다. 공개 벤치마크만이 아니라 실제 저장소를 사용해 모델을 비교하고, 작업 완료, 재시도, 사람의 수정까지 측정하세요.
DeepSeek V4 Pro는 현재 1M 컨텍스트 윈도를 제공하며, 캐시 적중 입력 $0.003625, 캐시 미스 입력 $0.435, 출력 $0.87(각 100만 토큰당)로 표기되어 있습니다.
Claude Sonnet 5의 도입 요율은 100만 입력 토큰당 $2, 100만 캐시 읽기 토큰당 $0.20, 100만 출력 토큰당 $10이며 2026년 8월 31일까지 적용됩니다. 캐시 쓰기는 별도 가격이며, Anthropic은 최신 토크나이저가 이전 Claude 모델보다 동일 텍스트에서 더 많은 토큰을 생성할 수 있다고 명시합니다.
GPT-5.6 Sol의 표준 단기 컨텍스트 요율은 100만 입력 토큰당 $5, 캐시된 입력 토큰당 $0.50, 100만 출력 토큰당 $30입니다. OpenAI는 캐시 쓰기, 장기 컨텍스트, Batch, Flex, Priority 요율을 별도로 제공합니다.
표기된 토큰 요율 기준으로 Kimi K2.7 Code는 Claude Sonnet 5와 GPT-5.6 Sol보다 저렴하며, DeepSeek V4 Pro가 더 저렴합니다. 이는 특정 코딩 워크플로우에서 어떤 모델이 최저 비용을 제공하는지 단정하지는 않습니다.
어떤 Kimi 모델을 사용할까?
워크로드
권장 시작점
저장소 편집 및 장기 코딩 작업
kimi-k2.7-code
지연 시간이 중요한 대화형 코딩
kimi-k2.7-code-highspeed
일반 멀티모달 추론 및 에이전트
kimi-k2.6
Moonshot 내장 WebSearch
Thinking 비활성화한 kimi-k2.6 또는 kimi-k2.5
저비용 일반 워크로드
kimi-k2.5
오프라인 평가 및 대량 처리
Batch API
K2.7 Code는 품질이 중요한 코딩 작업의 자연스러운 시작점입니다. HighSpeed는 더 빠른 응답이 개발자 경험, 전환, 처리량을 개선하는 경우 테스트할 가치가 있습니다.
K2.6은 일반 멀티모달 및 검색 기반 워크플로우에 더 유연하며, K2.5는 표준 Kimi 토큰 요율 중 가장 낮습니다.
실제 비용을 평가하는 방법
공개 벤치마크에만 의존하지 말고 프로덕션 작업에서 평가 세트를 구축하세요.
유용한 테스트 사례:
저장소 수준 기능 구현
풀 리퀘스트 리뷰
디버깅 및 테스트 생성
장문 컨텍스트 코드 분석
다단계 도구 호출
검색 기반 개발자 지원
다음 항목을 추적:
작업 성공 완료
캐시 적중 비율
입력 및 출력 토큰
추론 토큰량
도구 호출 성공
재시도 횟수
p50 및 p95 지연 시간
인간의 수정
전체 워크플로우 비용
계산:
Cost per completed task =
total workflow cost ÷ successfully completed tasks
예를 들어 팀이 $10을 사용해 80개의 작업을 성공적으로 완료했다면:
Cost per completed task = $10 ÷ 80 = $0.125
토큰이 더 저렴한 모델이라도 재시도, 더 긴 추론, 광범위한 수동 수정이 필요하면 총비용이 더 높아질 수 있습니다.