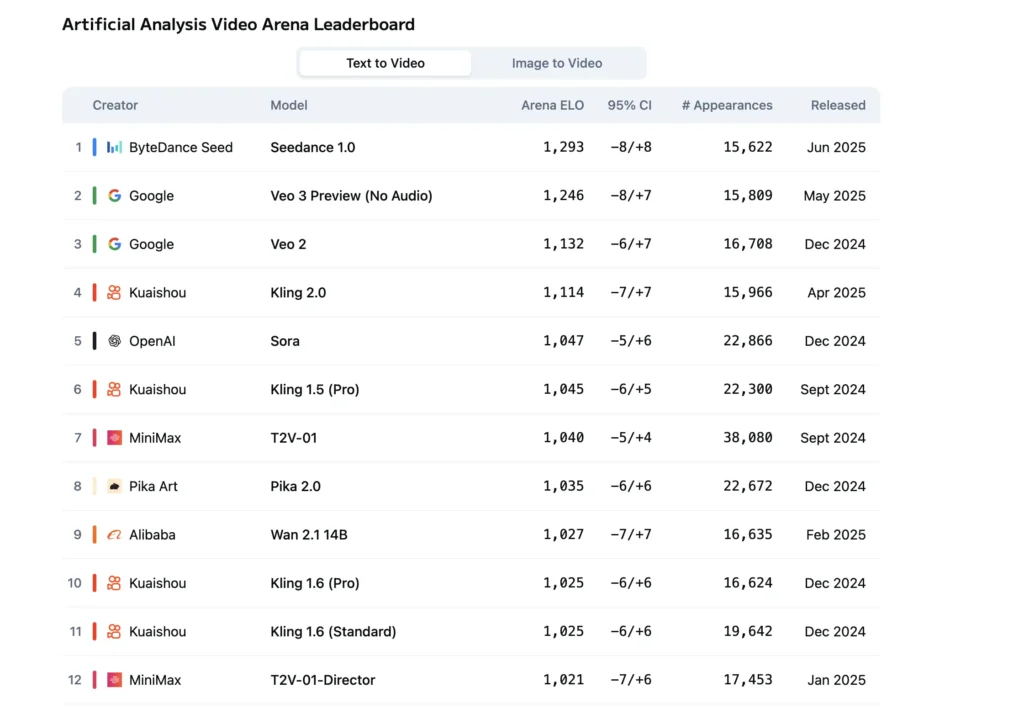
Seedance 1.0과 Google Veo 3는 현재 출시된 가장 진보된 두 가지 비디오 생성 모델로, 각각 신경망이 텍스트나 이미지를 역동적이고 영화 같은 경험으로 변환하는 데 있어 한계를 뛰어넘고 있습니다. ByteDance의 Volcano Engine(이전 Toutiao 엔진)과 Google DeepMind에서 각각 개발한 이 모델들은 빠르게 성장하는 AI 기반 콘텐츠 제작 시장에 대응하고 있습니다. 이 글에서는 Seedance 1.0이 Google Veo 3를 진정으로 능가하는지 확인하기 위해 두 모델의 기술적 혁신, 벤치마크 성능, 실제 적용 사례, 그리고 전반적인 가치 제안을 자세히 살펴봅니다.
Seedance 1.0의 핵심 혁신은 무엇입니까?
Seedance 1.0은 11년 2025월 XNUMX일 FORCE 컨퍼런스에서 공개되었습니다. 산업용 비디오 기반 모델로 설계된 이 솔루션은 다중 소스 학습, 아키텍처 효율성, 내러티브 일관성 측면에서 여러 가지 획기적인 발전을 이루었습니다.
멀티샷 내러티브 기능
Seedance 1.0은 기본적으로 멀티샷 비디오 생성을 지원합니다. 일반적으로 2초 클립 내에 3~10개의 일관된 카메라 컷이 포함되므로 단일 샷 시스템보다 훨씬 더 복잡한 스토리텔링이 가능합니다. 새로운 샷 분할 메커니즘과 샷 간 일관성 제약을 통해, 이 모델은 시각적 안정성이나 시간적 일관성을 유지하면서 원거리, 중거리, 근거리 시점 간의 부드러운 전환을 구현합니다.
아키텍처 및 비용 최적화
Seedance는 핵심적으로 다차원 보상 강화 학습(RLHF)으로 강화된 10단계 확산 프레임워크를 통합합니다. 첫 번째 단계에서는 시공간적 구조를 구축하고, 두 번째 단계에서는 세부 사항을 다듬고 즉각적인 준수를 강화합니다. 공격적인 다단계 증류 파이프라인과 결합된 이 모델은 NVIDIA L20 하드웨어에서 최대 5배 빠른 속도를 달성하며, 약 1080초 만에 41초짜리 0.50p 클립을 단 $3.67 USD(약 XNUMX위안)에 생성할 수 있어 시장에서 가장 빠르고 비용 효율적인 옵션 중 하나입니다.