Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmarks, Prijzen, Snelheid
Vergelijk Claude Haiku 5.5 met GPT-6 Luna op het vlak van benchmarks, API-tarieven, redeneervermogen, coderen, snelheid en agentprestaties. Ontdek welk AI-model wint.
Deon GoodwinOnderzoeksteam voor AI-modellen en API
Claude Haiku 5.5 en GPT-6 Luna zijn goedkope reasoning-modellen voor grootschalige API-werkbelastingen. Beide starten vanaf $0.10 per miljoen invoertokens en $0.50 per miljoen uitvoertokens. Haiku scoort hoger op de zes vergelijkingen die in de lanceermaterialen van Anthropic zijn gepubliceerd. Luna behoudt zijn basistarieven voor prompts tot 272K invoertokens, vergeleken met Haiku’s drempel van 100K. Voor ontwikkelaars zijn de sleutelmaatstaven acceptatiegraad, end-to-end-latentie, API-compatibiliteit en kosten per geaccepteerd resultaat—de totale kosten van alle pogingen gedeeld door het aantal outputs dat vooraf gedefinieerde controles doorstaat.
Key Takeaways
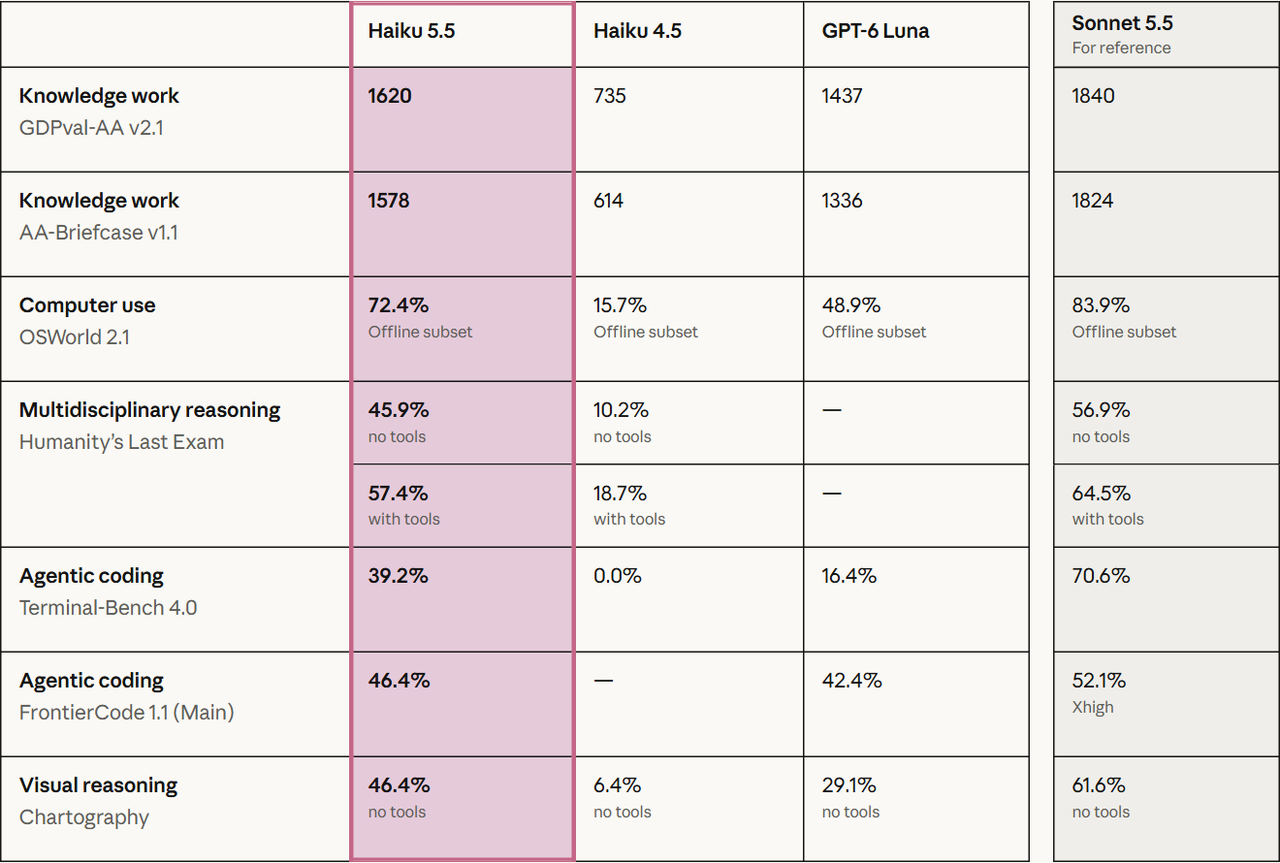
Haiku 5.5 leidt de aangehaalde OSWorld 2.1 computer-use-vergelijking, 72.4% versus Luna’s 48.9%.
Op Terminal-Bench 4.0 zijn de aangehaalde resultaten 39.2% voor Haiku en 16.4% voor Luna.
Beide starten met identieke prijzen voor korte context, maar Haiku’s hogere prijstier begint boven 100K prompttokens, tegenover Luna’s drempel van 272K.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmarks, Prijzen, Snelheid - CometAPI
De max-effort-modelpagina’s van Artificial Analysis, gecontroleerd op 9 oktober 2026, tonen uitvoersnelheden van 240.6 tokens/s voor Haiku en 123.0 tokens/s voor Luna; throughput sluit de wachttijd op het eerste token uit.
Begin met Haiku voor de computer-use- en terminaltaken die in de gedeelde benchmarks worden weerspiegeld; overweeg Luna voor grote prompts. Behoud uw huidige model totdat een representatieve pilot een nuttige verbetering aantoont.
What Are Claude Haiku 5.5 and GPT-6 Luna?
Claude Haiku 5.5: Overview
Claude Haiku 5.5 werd gelanceerd op 7 oktober 2026. Het combineert goedkope inferentie met aanpasbaar redeneren, toolgebruik, lange context en tekst- en afbeeldingsinvoer. Typische toepassingen zijn documentextractie, databasequeries, klantenondersteuning en lichte subagents.
GPT-6 Luna: Overview
GPT-6 Luna werd gelanceerd op 22 september 2026. Het is gepositioneerd voor gerichte taken op schaal, waaronder classificatie, informatie-extractie, gestructureerde output, programmeerassistentie en verwerking van lange documenten. De flexibele redeneringsinstellingen omvatten een non-reasoning-configuratie voor eenvoudiger werk.
Specifications
Specification
Claude Haiku 5.5
GPT-6 Luna
Developer
Anthropic
OpenAI
Release
October 7, 2026
September 22, 2026
Model ID
claude-haiku-5-5
gpt-6-luna
Context window
1,000,000 tokens
1,050,000 tokens
Maximum output (standard API)
128,000 tokens
128,000 tokens
Input
Text and image
Text and image
Output
Text
Text
Reasoning
Adjustable, Low to Max
None to Max
Default effort
Medium
Medium
Knowledge cutoff
June 2026
May 18, 2026
Tool use
Yes
Yes
Structured output
Yes
Yes
Open weights
No
No
Architecture and parameter count
De specificaties gebruiken de standaard API-modeldocumentatie van de leveranciers, gecontroleerd op 9 oktober 2026: Haiku’s standaard API-specificaties en Luna’s standaard API-specificaties. Architectuur en aantal parameters worden niet gespecificeerd omdat deze bronnen die niet vaststellen.
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark Results
Benchmark
Haiku 5.5
GPT-6 Luna
Leader
GDPval-AA v2.1 (Elo)
1,620
1,437
Haiku +183
AA-Briefcase v1.1 (Elo)
1,578
1,336
Haiku +242
OSWorld 2.1, offline partial score
72.4%
48.9%
Haiku +23.5 pp
Terminal-Bench 4.0
39.2%
16.4%
Haiku +22.8 pp
FrontierCode 1.1 Main
46.4%
42.4%
Haiku +4.0 pp
Chartography, no tools
46.4%
29.1%
Haiku +17.3 pp
De zes rijen hierboven reproduceren de door Anthropic gepubliceerde lanceervergelijkingen, gecontroleerd op 9 oktober 2026. Het zijn vergelijkingen die door Anthropic zijn gepubliceerd, inclusief onafhankelijke resultaten die daar zijn gereproduceerd, en geen nieuwe tests die voor dit artikel zijn uitgevoerd. GDPval-AA en AA-Briefcase zijn Elo-scores; percentageverschillen zijn procentpunten. Deze benchmarkfamilies meten verschillende taken en moeten niet worden gemiddeld tot één universele winnaar.
Haiku’s relatief sterkste resultaten in deze lanceringstabel lijken te liggen in visuele computerinteractie en terminaltaken. De kleinere voorsprong in FrontierCode waarschuwt tegen het extrapoleren van een kloof van 20 punten naar elke codeersituatie. Gebruik deze resultaten om pilootkandidaten te selecteren en valideer vervolgens uw prompts en toolstack.
Reasoning Effort and Evaluation Limits
Redeneringsinspanning verandert de nauwkeurigheid–kostenafweging. Vergelijk beschikbare instellingen met dezelfde werkbelasting en hetzelfde testharnas; gelijke naamgeving van instellingen bij leveranciers garandeert geen gelijk redeneringstokenbudget. De lanceringstabel rapporteert OSWorld’s offline subset en Chartography zonder tools. Harnas, taakselectie, herhalingen en tooltoegang kunnen uitkomsten veranderen. Anthropics system card documenteert de benchmarkspecifieke voorwaarden. Read the benchmark methods in Anthropic's system card.
OSWorld gebruikt de offline subset van 82 taken, een Ubuntu-virtuele machine, 1080p-schermafbeeldingen, een limiet van 500 acties, maximale inspanning en vijf pogingen per taak. De vergelijking 72.4%/48.9% is deelscore-beoordeling, niet het percentage taken dat perfect is voltooid; Haiku’s strikte slaagpercentage is 37.1%. Anthropic draaide Luna op dezelfde taaksubset via de API van OpenAI.
Terminal-Bench gebruikt 66 gecontaineriseerde taken; Haiku draaide op maximale inspanning in Claude Code bare-modus, zonder internet-egress of fallbackmodel, met gemiddeld tien pogingen per taak.
FrontierCode Main bevat 100 taken met vijf runs per taak; Claude-modellen gebruikten Claude Code en GPT-modellen gebruikten Codex.
GDPval-AA en AA-Briefcase zijn onafhankelijk geëvalueerd door Artificial Analysis en gereproduceerd in de lanceermaterialen. Dit zijn afzonderlijke evaluatiepijplijnen, niet één gedeeld productieharnas.
Claude Haiku 5.5 vs GPT-6 Luna: Feature Comparison
Computer Use and Agentic Coding
Haiku’s sterkste voordeel ligt in de gedeelde lanceringstaken die vereisen dat er met een grafische computer wordt gewerkt of in een terminal. De OSWorld-deelscorekloof is 23.5 procentpunt, terwijl Terminal-Bench 22.8 punten verschilt. Het kleinere verschil van 4.0 punten in FrontierCode laat zien waarom de bredere codeercategorie niet als één enkele werkbelasting moet worden behandeld.
Voor browserautomatisering: test paginanavigatie, formulierinvoer, herstel na toolfouten en end-to-end-voltooiing. Voor coderen: test of een patch de functionele checks van uw repository doorstaat en binnen de scope blijft. Die acceptatiecontroles zijn nuttiger dan een model kiezen op basis van het grootste verschil in kopcijfers.
Long Context and Document Processing
Het nominale verschil van 5% in contextcapaciteit is minder belangrijk dan de betrouwbaarheid en de prijs van het verwerken van substantiële prompts. Geen van beide modellen is inherent beter in het ophalen van informatie enkel omdat het contextvenster groter is.
Het belangrijkste verschil is wanneer hogere tarieven van toepassing zijn: een prompt van 150K tokens overschrijdt Haiku’s drempel, maar blijft binnen Luna’s basistier. Luna is daarom het laagkostenstartpunt voor die tokenwerkbelasting. Of het de betere documentanalist is, hangt nog steeds af van extractienauwkeurigheid, citaties en de herhalingen die nodig zijn voor een acceptabel antwoord.
Reasoning Controls
Beide modellen bieden verstelbare redeneringsinspanning, met medium als standaard in de aangehaalde documentatie. Luna biedt ook een none-instelling. Gebruik die controles passend bij de taak: extractie en routing vergen mogelijk minder redeneren dan een onzekere meerstaps toolworkflow. Dezelfde inspanningslabel impliceert niet hetzelfde rekenbudget bij verschillende leveranciers.
Multimodal Input and Structured Workflows
Beide accepteren tekst en afbeeldingen en produceren tekst. Dit maakt ze kandidaten voor screenshots, documentafbeeldingsextractie en gestructureerde downstream-workflows. Hun invoerondersteuning op zich bewijst geen gelijke nauwkeurigheid op kleine tekst, grafieken of visuele interfaces; meet die gevallen apart.
Speed and Task Economics
Independent metric (max effort)
Haiku 5.5 — Artificial Analysis
GPT-6 Luna — Artificial Analysis
Intelligence Index v4.3.2
43
38
Output speed
240.6 tokens/s
123.0 tokens/s
Weighted cost per Intelligence Index task
$0.21
$0.07
Artificial Analysis is de onafhankelijke testuitgever. De tabel is een momentopname van de max-effort-modelpagina’s, gecontroleerd op 9 oktober 2026, en niet de officiële prestatie van de leverancier. Uitvoersnelheid meet tokens die worden ontvangen nadat de generatie is begonnen; dit staat los van de tijd tot het eerste token en de volledige taaktijd. Kosten per taak is een gewogen Intelligence Index-metriek, geen prijsopgave voor uw productietaak of kosten per succesvol resultaat.
Haiku’s momentopname-doorvoer is ongeveer 1.96 keer die van Luna, terwijl Luna’s gewogen evaluatietaakkosten lager zijn. Dit bewijst geen 1.96-voudig voordeel in volledige taakvoltooiingstijd. Productietests moeten tijd tot eerste token, voltooiingstijd, outputlengte, redeneringsverbruik en tooluitvoeringstijd afzonderlijk registreren.
Claude Haiku 5.5 vs GPT-6 Luna: Pricing and API Access
Official Standard Rates
USD per 1M tokens
Haiku ≤100K
Haiku >100K
Luna ≤272K
Luna >272K
Input
$0.10
$0.50
$0.10
$0.20
Cached read
$0.01
$0.05
$0.01
$0.02
Cache write (Haiku: 5-minute TTL)
$0.125
$0.625
$0.125
$0.25
Output
$0.50
$2.50
$0.50
$0.75
USD per miljoen tokens tegen standaardverwerkingspercentages, gecontroleerd op 9 oktober 2026. De tabel gebruikt Haiku’s standaard- en 5-minuten cache-write-tarieven en Luna’s tarieven voor korte en lange context. Toolkosten, belastingen, regionale toeslagen en optionele verwerkingslaag-aanpassingen zijn uitgesloten. Boven de invoerdrempel zijn de hogere tarieven van toepassing op het verzoek en niet alleen op de overtollige tokens.
Haiku biedt ook cache-schrijfacties van 1 uur tegen $0.20/$1.00 per miljoen tokens voor korte/lange prompts. Cachepersistentie en prijsmechanismen verschillen per leverancier, dus vergelijk hergebruikspatronen in plaats van beide cachewrite-rijen als identieke producten te behandelen. Haiku’s limiet van 128K output is de standaard-API-limiet; de Message Batches API kan 300K output ondersteunen met een bèta-header.
Illustrative Costs at Fixed Token Budgets
Workload
Input / Output
Haiku 5.5
GPT-6 Luna
Ticket classification
2K / 200
$0.0003
$0.0003
Short report
40K / 4K
$0.006
$0.006
Repository analysis
150K / 5K
$0.0875
$0.0175
Large document review
300K / 10K
$0.175
$0.0675
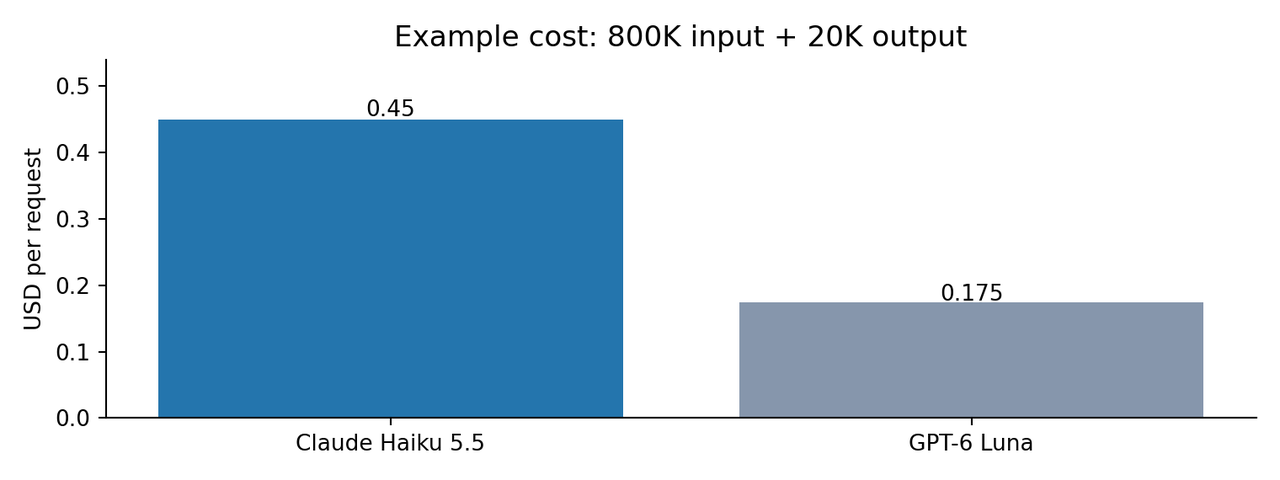
Massive context analysis
800K / 20K
$0.45
$0.175
Door de auteur berekende niet-gecachete schatting tegen standaardtarief: cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000. “Output” betekent de totale gefactureerde output voor deze schatting, inclusief redeneringstokens waar als output in rekening gebracht; het is niet noodzakelijk de zichtbare antwoordlengte. Dezelfde gerapporteerde tokenaantallen worden voor beide modellen gebruikt, hoewel tokenizers kunnen verschillen.
Een goedkope token is niet per se een goedkope succesvolle uitkomst. Teams moeten rekening houden met herhaalde pogingen, mislukte toolaanroepen, verbruik van redeneringstokens en verschillend tokenizergedrag.
CometAPI Access and Integration Constraints
CometAPI biedt toegangsopties voor beide modellen. Verifieer vóór vergelijking of implementatie via de gateway de model-ID’s, ondersteunde eindpunten, aanvraagparameters, toolgedrag en factureringsregels voor elke route. Deze providerlinks documenteren toegangsopties; ze vervangen niet de technische of standaardprijsbronnen van de leveranciers.
Voor directe OpenAI-integraties ondersteunt Luna ingebouwde tools via de Responses API; functieaanroepen in Chat Completions vereisen de none-redeneringsinspanning. Haiku gebruikt Anthropics Messages API en adaptief denken. Een gateway maakt de onderliggende schema’s niet uitwisselbaar: valideer tooldefinities, gedrag van gestructureerde output, streamingevents en afrekening via precies de route die u wilt gebruiken.
How Can Developers Compare Claude Haiku 5.5 and GPT-6 Luna With the Same Prompt?
Long-Document Extraction Example
Een praktische vergelijking kan een bundel leveranciercontracten gebruiken met ingangsdata, verlengingsvoorwaarden, opzegtermijnen en uitzonderingen. Houd de documentbundel, extractie-instructies, verwachte velden en validatieregels identiek. Het volgende is een evaluatieontwerp, geen nieuw gemeten modelresultaat.
Voorbeeldprompt: Extraheer per contract de naam van de leverancier, ingangsdatum, verlengingsdatum, opzegtermijn en prijsuitzonderingen. Citeer voor elke geëxtraheerde waarde de documenttitel en de exacte ondersteunende passage. Geef null terug wanneer een veld ontbreekt; leid ontbrekende datums niet af. Markeer conflicterende clausules en houd het eindantwoord binnen 1.000 woorden.
Check
Acceptance criterion
What to record
Extraction accuracy
Required fields match an independently checked answer key
Correct, incorrect, and missing values
Grounding
Every non-null field has a valid supporting passage
Unsupported claims and wrong document citations
Instruction following
No invented dates; absent fields return null
Schema failures and constraint violations
Economics
Calculate spend per accepted extraction
Billed input, output, reasoning, retries, and fallback cost
Latency
Compare full job completion under the same tool policy
First-token time and end-to-end time
Voer meer dan één representatieve bundel uit en herhaal de gevallen waar resultaten variëren. Begin met hetzelfde beschikbare inspanningsniveau en test vervolgens een goedkopere configuratie voor elk model. Rapporteer steekproefgrootte, instellingen, route, datum en aantallen fouten voordat u een winnaar presenteert.
Haiku 5.5 or GPT-6 Luna: Which to Choose?
Dimension
Better-supported starting point
Decision boundary
GUI interaction
Claude Haiku 5.5
Shared OSWorld partial scores favor Haiku; verify full task completion
Identical base rates; compare billed usage and retries
Prompts above 100K tokens
GPT-6 Luna on standard rates
Luna retains the base tier longer; accuracy may alter total cost
Streamed token throughput
Claude Haiku 5.5 in the dated snapshot
Throughput differs from full completion latency
Simple repeated extraction
Test Luna with low or no reasoning
Select by valid accepted output, rather than price alone
Choose Claude Haiku 5.5 for Benchmark-Relevant Interactive Tasks
Begin met Haiku wanneer uw toepassing lijkt op de gepubliceerde grafische-computer-, terminal-coderings- of professionele-werktaken, en wanneer een hogere voltooiingsgraad extra redenering of long-context-kosten compenseert. Bevestig dat voordeel op uw eigen toolstack voordat u productieverkeer routeert.
Choose GPT-6 Luna for Large-Prompt Cost Control
Begin met Luna wanneer prompts vaak de 100K tokens overschrijden en standaard tokenkosten uw budget materieel beïnvloeden. Het is ook een kandidaat voor herhaalde extractie of routing die kan slagen met lage of geen redenering. Houd de aanbeveling conditioneel op acceptatiegraad en werkelijke gefactureerde gebruik.
Use Both When Workloads Have Different Needs
Een pilot kan lange-documentextractie naar Luna routeren en GUI- of terminaltaken naar Haiku, en vervolgens elke keuze valideren tegen acceptatiecontroles. Activeer een fallback wanneer een output schema-validatie faalt, vereiste bewijsvoering ontbreekt of niet slaagt voor een taakspecifieke check, en neem fallbackkosten en latentie op in de vergelijking.
Validate Before Switching
Neem uw huidige model op als baseline. Stap alleen over wanneer de kandidaat een vooraf gedefinieerd correctheidsdoel haalt en de kosten per geaccepteerd resultaat of end-to-end-latentie voldoende verbetert om migratie en onderhoud te dekken. Houd de uitrol tegen als kritieke toolfouten toenemen. De aanbeveling verandert als uw pilot laat zien dat Luna’s lagere tarief wordt tenietgedaan door herhalingen, of dat Haiku’s hogere benchmarkscores uw taaksucces niet verbeteren.
Gebruik een representatieve steekproef van werkbelasting en scoor correcte, onjuiste en onvolledige resultaten.
Meet tijd tot eerste token, end-to-end-taaktijd en toolbetrouwbaarheid.
Volg input-, cache-, output- en redeneringstokenaantallen afzonderlijk.
Bereken de kosten per succesvol resultaat, inclusief herhalingen en fallbacks.
Vergelijk medium en hoge redeneringsinspanning voordat u standaard maximale instellingen inschakelt.
Conclusion
Claude Haiku 5.5 heeft sterkere head-to-head-lanceringsbewijzen over de professionele-werk-, computer-use- en agentisch-coderingsbenchmarks die hier worden vergeleken. Het heeft ook een hogere output-throughput in de onafhankelijke momentopname. GPT-6 Luna heeft een duidelijk standaardtariefvoordeel voor prompts boven Haiku’s drempel van 100K en lagere gewogen evaluatietaakkosten. Geen van beide observaties bepaalt op zichzelf de productiereliabiliteit of kosten per succesvol resultaat.
De praktische winnaar is het model dat een acceptabel resultaat levert tegen de laagste volledig gemeten operationele kosten. Laat beide draaien tegen uw eigen prompts, tools en herhaalregels in plaats van één benchmark als het antwoord te beschouwen.
FAQ
Why can task costs differ when both models have the same base token prices?
Dezelfde basistariefprijs betekent niet dezelfde totale rekening. Modellen kunnen verschillende hoeveelheden input-, output- en redeneringstokens gebruiken en kunnen verschillende aantallen herhalingen of toolaanroepen nodig hebben om een acceptabel resultaat te produceren. Long-context-tarieven en cachegebruik beïnvloeden ook het totaal. Vergelijk de totale kosten van alle pogingen gedeeld door het aantal geaccepteerde resultaten, in plaats van alleen tokenprijzen.
Do higher long-context rates apply only to tokens above the threshold?
Nee. Onder de standaardprijzen die in dit artikel worden beschreven, zijn bij overschrijding van de invoerdrempel de hogere tarieven van toepassing op het verzoek, niet alleen op de overtollige tokens. Een verzoek met 150K invoertokens overschrijdt bijvoorbeeld Haiku’s drempel van 100K, maar blijft binnen Luna’s basistier van 272K. Gebruik de toepasselijke input- en outputtarieven voor het gehele verzoek bij het schatten van kosten.
Can Claude Haiku 5.5 and GPT-6 Luna share a prompt cache?
Ga er niet van uit dat cache-items overdraagbaar zijn tussen modellen of providers. Ontwerp aparte hergebruikstrategieën en meet vervolgens hitratio’s en gefactureerd gebruik op elke route. Gateway-ondersteuning, retentieregels en de verzoekstructuur kunnen beïnvloeden of herhaalde invoer in aanmerking komt voor caching; verifieer dit voordat u besparingen voorspelt.
What should a Haiku-to-Luna migration test cover?
Test representatieve tekst- en afbeeldingsinvoer, vereiste gestructureerde velden, toolargumenten, gestreamde reacties en foutafhandeling. Stel de acceptatiegraad van uw huidige systeem vast vóór migratie en vergelijk vervolgens beide kandidaten onder hetzelfde herhaal- en toolbeleid. Vergelijkbare tokenprijzen of modelcategorieën impliceren geen compatibiliteit.
Should benchmark scores drive a Haiku or Luna fallback?
Gebruik scores om kandidaten te kiezen en activeer fallbacks bij waargenomen fouten zoals ongeldige toolargumenten, ontbrekende vereiste velden of onvoldoen aan taakspecifieke checks. Volg fallbackfrequentie en totale gefactureerde kosten. Een tweede model kan latentie en kosten toevoegen, dus verifieer dat het geaccepteerde uitkomsten verbetert en niet alleen een tweede antwoord produceert.
Can sensitive data be routed through both APIs?
Beoordeel de exacte leveranciers en gateway, hun huidige retentie-instellingen, verwerkingslocaties, contractvoorwaarden en het gegevensbeleid van uw organisatie voordat u gevoelige input routeert. Modelcapaciteit en prijstabellen bepalen niet of een route geschikt is voor gereguleerde of vertrouwelijke gegevens. Gebruik de goedgekeurde route wanneer die vereisten doorslaggevend zijn.