
In het snel evoluerende AI-landschap springt GLM-5.2 van Z.ai (Zhipu AI) eruit als een krachtig open-weightsmodel, geoptimaliseerd voor agentisch coderen, langetermijntaken en betrouwbaarheid in productie. Met een bruikbaar contextvenster van 1M tokens, twee redeneermodi (High en Max) en sterke prestaties tegen een fractie van de kosten van gesloten frontier-modellen, wordt het snel de voorkeurskeuze voor ontwikkelaars die autonome agents, IDE-integraties en complexe software-engineeringworkflows bouwen.
Of je nu een solodeveloper bent die agents prototypet, een CTO die kosteneffectieve opschaling evalueert, of een AI-productmanager die multimodaal redeneren in SaaS integreert: het beheersen van de GLM-5.2-API levert aanzienlijke voordelen op.
Wat is GLM-5.2?
GLM-5.2 is Z.ai’s (Zhipu AI) nieuwste vlaggenschip-open-weights Mixture-of-Experts (MoE)-model, uitgebracht medio juni 2026. Met ongeveer 753 miljard totale parameters (ongeveer 40B actief per token), een stabiel contextvenster van 1 miljoen tokens, MIT-licentie en sterke prestaties bij langetermijncodering en agentische taken, positioneert het zich als een competitief alternatief voor gesloten frontier-modellen zoals GPT-5.5, Claude Opus 4.8 en Gemini-varianten—tegen een fractie van de kosten voor veel workloads.
GLM-5.2-architectuur en technische specificaties
GLM-5.2 bouwt voort op de GLM-familie met essentiële upgrades voor langetermijnwerk.
- Parameters: ~753B totaal in MoE-ontwerp (actieve parameters ~40B per token). Dit levert enorme capaciteit met efficiënte inferentie.
- Contextvenster: 1,048,576 tokens (1M). Maximale output doorgaans tot 128K–131K tokens.
- Precisie: BF16 (met FP8-varianten voor lichtere deployment).
- Belangrijkste innovatie – IndexShare: hergebruikt één indexer over groepen van sparse attention-lagen, waardoor de FLOPs per token bij 1M context tot wel 2,9x worden verlaagd. Dit maakt long-context-inferentie haalbaar zonder uit de pan rijzende kosten of latentie.
- Redeneermodi: "High" (gebalanceerd) en "Max" (het diepst, aanbevolen voor coderen). Het denkproces kan voor eenvoudige taken worden uitgeschakeld.
- Modaliteiten: primair tekst/code (geen native vision bevestigd in de baserelease).
- Licentie: MIT – volledig open voor downloaden, modificatie en commercieel gebruik.
Deze openheid en efficiëntie maken GLM-5.2 ideaal voor teams die dataprivacy, maatwerk of kostenbeheersing prioriteren.
GLM-5.2 vs GLM-5.1
| Gebied | GLM-5.1 | GLM-5.2 | Praktisch verschil |
|---|---|---|---|
| Contextvenster | Rond 200K op gangbare gehoste routes | 1M | GLM-5.2 is veel geschikter voor context op projectniveau |
| Redeneerinspanning | Minder flexibel | High en Max | Betere controle over kosten, latentie en kwaliteit |
| Terminal Bench 2.1 | 63.5 in de gepubliceerde tabel | 81.0 | Grote verbetering in terminalgebaseerde agent-taken |
| SWE-bench Pro | 58.4 | 62.1 | Gematigde maar betekenisvolle winst op repositoryniveau |
| FrontierSWE | 30.5 | 74.4 | Zeer grote verbetering voor langetermijn-engineering |
| Open-weights-positie | Open-weights GLM-familie | Open-weights MIT-release | Vergelijkbare openheid, sterkere long-context-positionering |
Als je huidige GLM-5.1-workflow vooral uit korte chat of basale codegeneratie bestaat, zal de upgrade mogelijk niet alles veranderen. Als je workflow grote repositories, meerstaps codeeragents of lange taakuitvoering omvat, is GLM-5.2 een veel relevanter model.
GLM-5.2 vs Claude Opus, GPT-5.5, Gemini en DeepSeek
De duidelijkste manier om GLM-5.2 te vergelijken is per taaktype:
| Taaktype | Positie van GLM-5.2 |
|---|---|
| Langetermijncodering | Een van de sterkste open-weightsopties; dicht bij frontier-closed modellen op geselecteerde benchmarks |
| Algemeen redeneren | Sterk, maar niet altijd voor op de beste gesloten modellen |
| Toolgebruik | Sterke prestaties op MCP-Atlas en HLE-with-tools |
| Wiskundewedstrijden | Zeer sterke AIME 2026-score in gepubliceerde resultaten |
| Vision | Niet het juiste model; gebruik een visionmodel |
| Goedkope classificatie met hoog volume | Meestal overkill; gebruik een kleiner model |
| Zelfhosting en maatwerk | Sterkere optie dan gesloten alleen-API-modellen |
Voor teams is het beste antwoord meestal niet “vervang elk model door GLM-5.2.” Het betere antwoord is “routeren: zet GLM-5.2 in op de taken waar het een voordeel heeft.” Dat is een van de redenen waarom een uniforme API-aanbieder zoals CometAPI praktisch kan zijn. Zo kun je modellen per workload vergelijken en routeren zonder elke integratie te herbouwen.
Prijzen: betaalbare kracht op schaal
GLM-5.2 biedt aantrekkelijke economics, vooral voor token-intensief long-contextwerk.
- API-prijzen (via Z.ai/OpenRouter/etc.): $1.40 / 1M inputtokens, $4.40 / 1M outputtokens. Cache-lezen tot slechts $0.26/1M op sommige routes.
- Abonnementen voor GLM Coding Plan (inclusief volledige toegang, geen extra voor 5.2):
- Lite: ~$10–12.60/maand (lichte iteratie).
- Pro: ~$30/maand.
- Max/Team: Hogere quota voor zwaar gebruik.
Voorbeeld kostenbesparing: Voor een lange agentische sessie met 500K context + outputs kan GLM-5.2 4–5x goedkoper zijn dan Claude-equivalenten, terwijl het grotere contexten native afhandelt.
Aanbeveling CometAPI: Verkrijg toegang tot GLM-5.2 (en 500+ andere modellen) via de uniforme, OpenAI-compatibele endpoint van CometAPI tegen concurrerende tarieven. Eén sleutel, geen leverancierslock-in, testcredits bij aanmelding. Ideaal om GLM-5.2 naast Claude/GPT te vergelijken in productie. Bezoek cometapi voor naadloze integratie.
1M-contextvenster: het onderscheidende kenmerk
De 1M-context is in de praktijk “solide” en verliesvrij voor werk op projectniveau—ver voorbij marketinghype. Het stelt je in staat volledige middelgrote tot grote repositories in context te houden, waardoor samenvattings-overhead en foutaccumulatie in agents afnemen.
Tips voor effectief gebruik:
- Gebruik de identifier
glm-5.2[1m]. - Stel max tokens passend in; monitor voor productie.
- Combineer met tools/MCP voor dynamische gegevensopvraging.
Vroege tests bevestigen stabiliteit voorbij 200K, een veelvoorkomend faalpunt voor andere “long-context”-modellen.
Basisprestaties en benchmarks
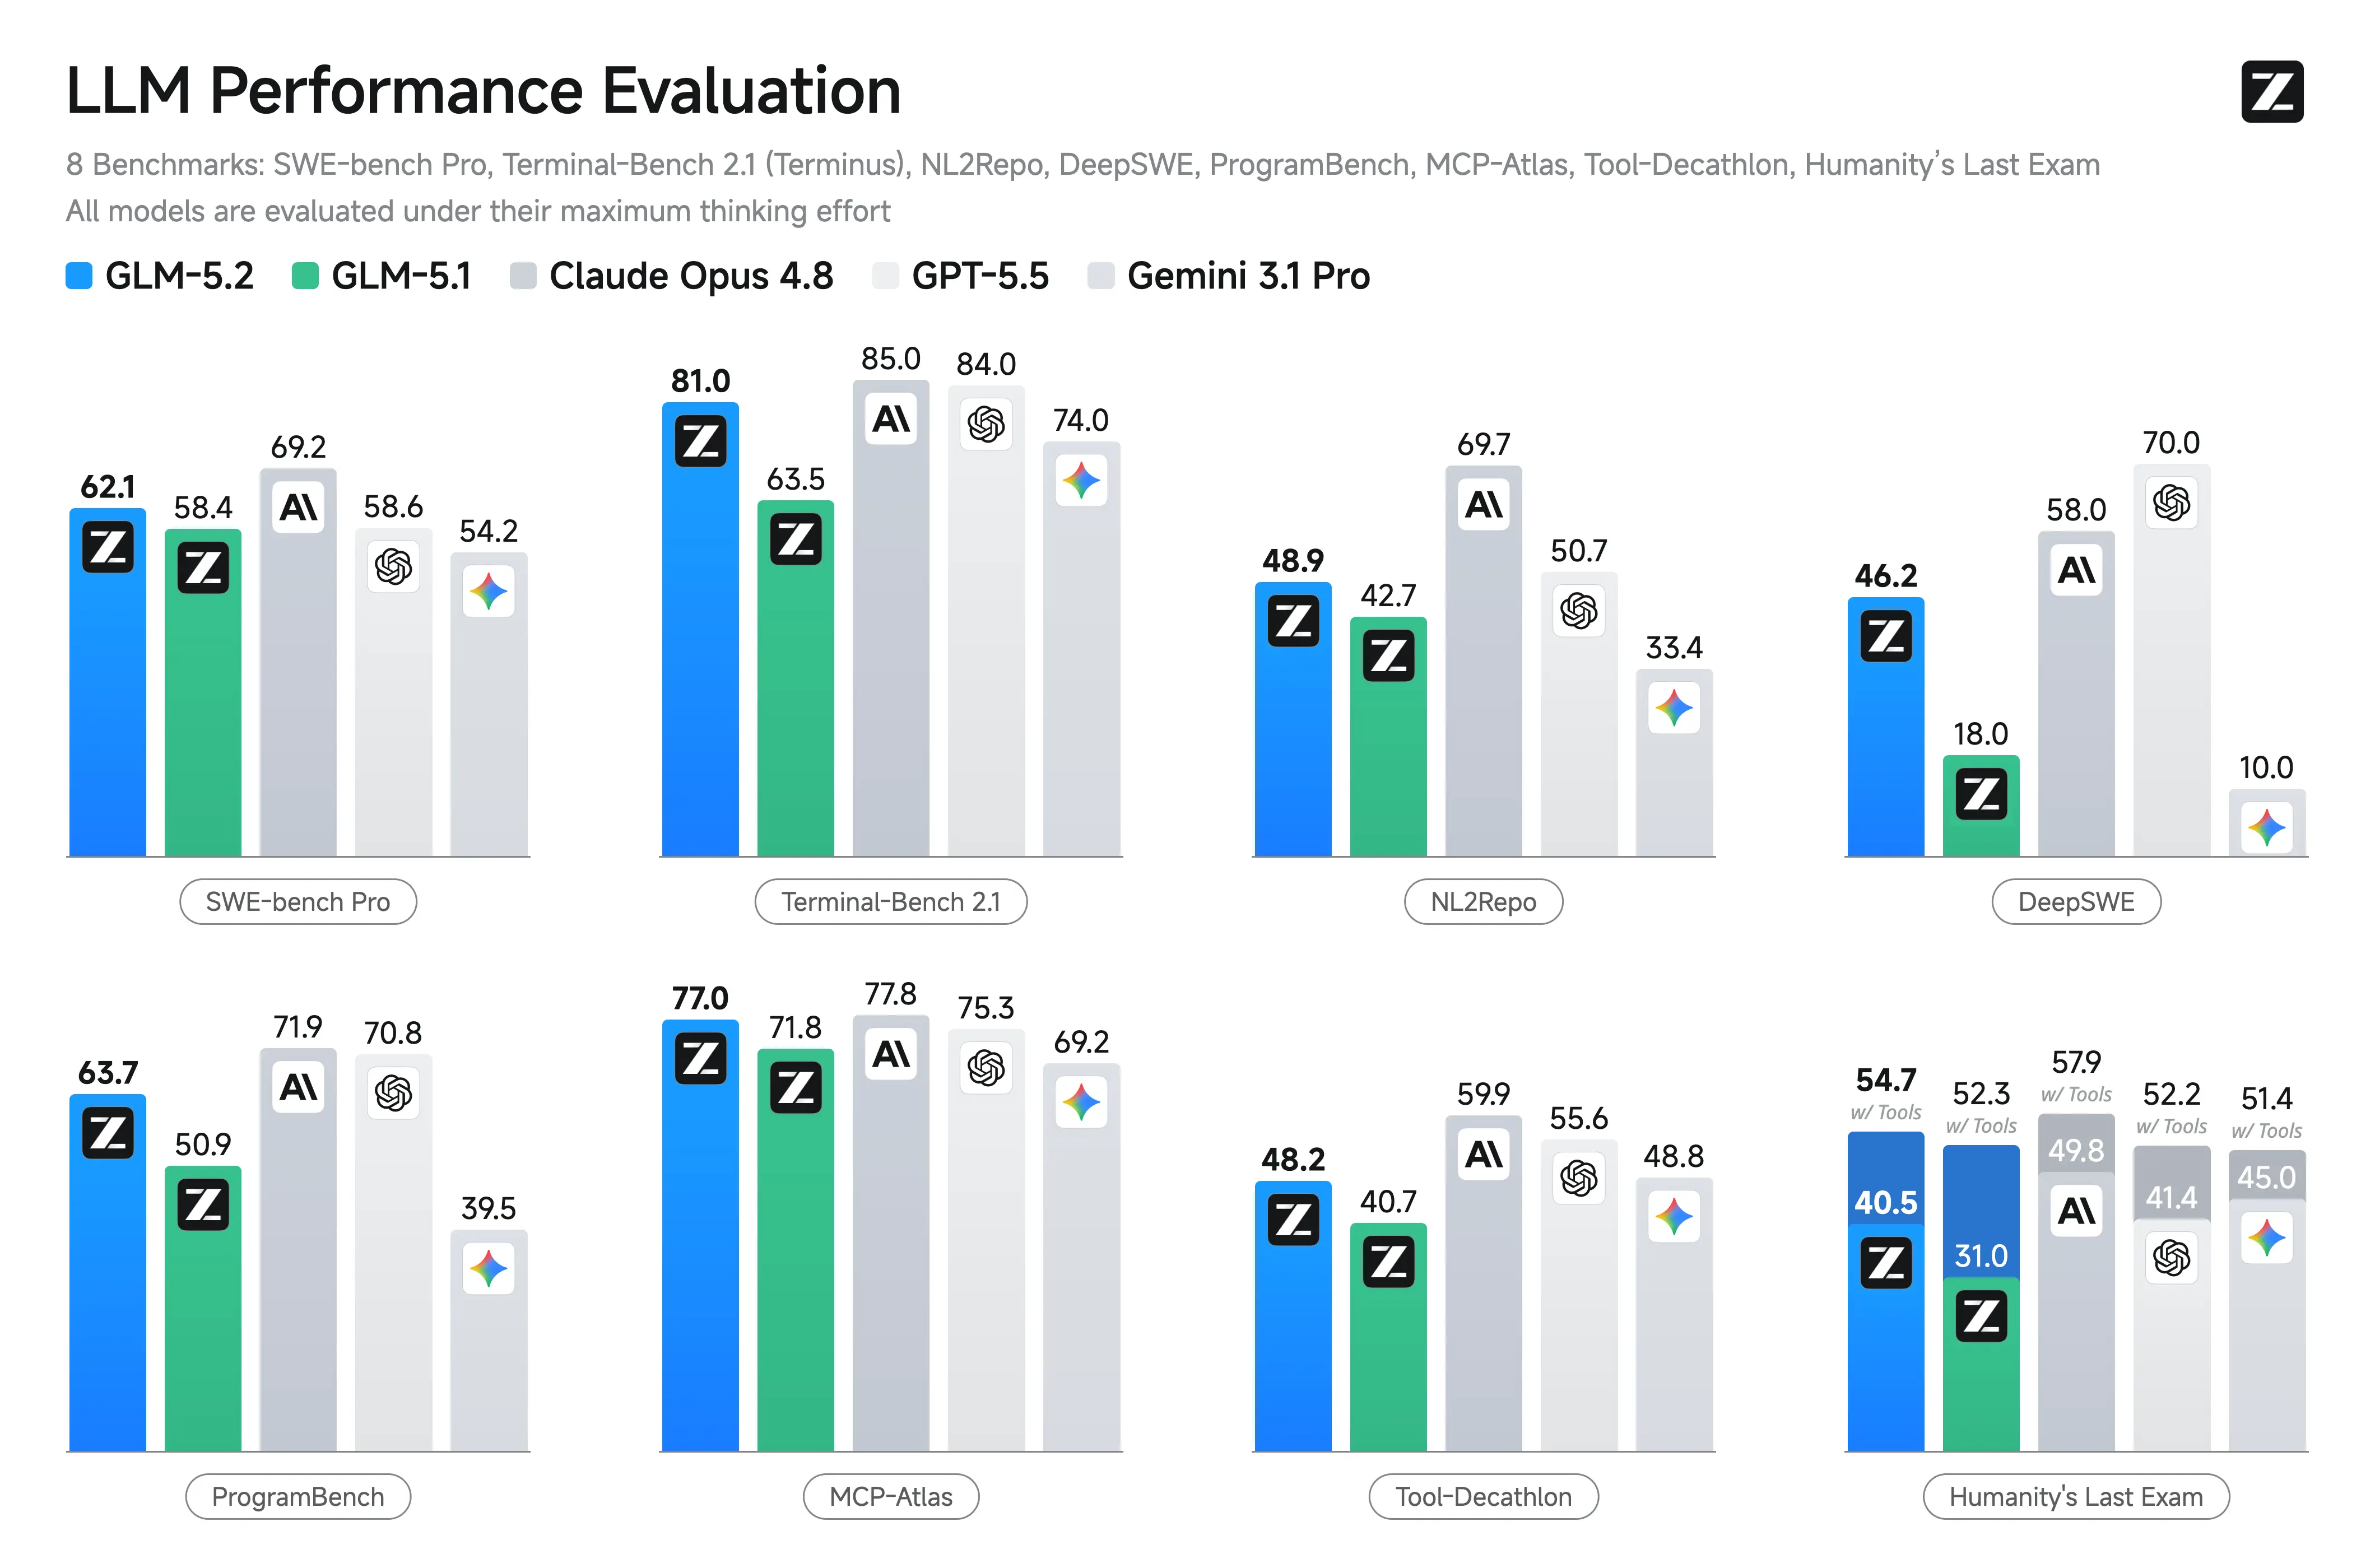
Z.ai en onafhankelijke rapporten benadrukken de sterke punten van GLM-5.2 in codeer- en agentische scenario’s. Het toont aanzienlijke winst ten opzichte van GLM-5.1 en competitieve resultaten tegenover gesloten modellen bij langetermijntaken.
Key reported benchmarks (Z.ai en derde-partij-aggregaties):
- Terminal-Bench 2.1: 81.0 (omhoog vanaf 62.0 voor GLM-5.1) – Uitstekend voor terminal-/agentoperaties.
- SWE-bench Pro: 62.1 (net boven GPT-5.5 met 58.6).
- MCP-Atlas: 77.0 (in de buurt van Claude Opus 4.8).
- Humanity’s Last Exam (met tools): 54.7.
Andere koplopers: Bovenaan of nabij de top onder open modellen op FrontierSWE, PostTrainBench, SWE-Marathon. Sterk op AIME 2026 (~99.2) en GPQA-Diamond (91.2).
Toegangsopties voor de GLM-5.2-API
Er zijn twee gangbare manieren om GLM-5.2 vanuit een applicatie te benaderen.
Optie 1: Gebruik Z.ai direct
De directe route is het gebruik van de officiële Z.ai-API. Dit kan de juiste keuze zijn wanneer je team een directe relatie met de modelprovider wil, uitsluitend Z.ai-modellen gebruikt of providerspecifieke controles nodig heeft zodra die worden uitgebracht.
De afruil is operationeel. Als je product meerdere modelfamilies gebruikt, moet je mogelijk afzonderlijke SDK-configuraties, facturatiestromen, failoverlogica, prijsnormalisatie en observability-conventies onderhouden. Voor een onderzoeksproject kan dat acceptabel zijn. Voor een productie-SaaS-platform kan het integratieoppervlak snel groeien.
Optie 2: Gebruik GLM-5.2 via CometAPI
CometAPI biedt toegang tot GLM-5.2 via een uniforme API-gateway. Het praktische voordeel is dat developers verschillende AI-modellen via één OpenAI-compatibele interface kunnen aanroepen in plaats van per provider een aparte integratie te bouwen. Je houdt je code dichtbij het OpenAI-SDK-patroon, zet de modelnaam op glm-5.2 en leidt verzoeken via CometAPI.
Dit is nuttig voor startups en productteams die willen:
- GLM-5.2 testen tegenover andere modellen zonder hun backend te herbouwen
- Eén API-sleutel en één billinglaag aanhouden voor meerdere modellen
- Sneller bewegen van benchmark naar prototype naar productie
- Modelfallback of routeringsstrategieën implementeren
- Kosten en kwaliteit tussen providers vergelijken
- Vertrouwde OpenAI-stijl aanvraagpatronen gebruiken
Meld je aan op CometAPI.com voor directe testcredits en OpenAI-compatibele endpoints die provider-eigen eigenaardigheden abstraheren.
- Verkrijg je API-sleutel.
- Stel omgevingsvariabelen in (best practice voor security):
bash
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $GLM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [
      {"role": "system", "content": "You are an expert full-stack engineer."},
      {"role": "user", "content": "Write a FastAPI endpoint for user authentication with JWT."}
],
"temperature": 0.7,
"max_tokens": 2048
}'
Veelvoorkomende GLM-5.2-use-cases
GLM-5.2 is een sterke kandidaat voor workflows waar lange context, redeneren en toolgebruik samenkomen.
| Use-case | Voorbeeldimplementatie | Waarom GLM-5.2 kan passen |
|---|---|---|
| Developer-assistent | Bugrapporten, codefragmenten, logs en tests analyseren | Vereist redeneren over technische context heen |
| Document intelligence | Contracten, policies, claims of rapporten beoordelen | Lange inputs en gestructureerde extractie |
| Research-agent | Bronnen lezen, claims vergelijken, samenvattingen produceren | Profiteert van lange context en citatiediscipline |
| Customer support-copilot | Ticketgeschiedenis, documentatie, accountdata en policy combineren | Vereist retrieval plus tool-calling |
| AI-productmanager-assistent | Feedback, specs, gebruiksdata en roadmap-notities synthetiseren | Lange context en businessredeneren |
| Security-analyse | Incidentrapporten, alerts en remediatieplannen beoordelen | Vereist zorgvuldig meerstaps redeneren |
| Sales engineering | Technische antwoorden genereren uit documentatie en klantvereisten | Nuttig voor complexe B2B-salescycli |
Het gemeenschappelijke patroon is niet “chatbot”. Het gemeenschappelijke patroon is workflowcompressie. GLM-5.2 kan de tijd verkorten tussen ruwe informatie en een bruikbare beslissing.
Wie zou GLM-5.2 moeten gebruiken?
GLM-5.2 past goed bij:
- Developers die AI-codingtools bouwen.
- SaaS-bedrijven die repository-bewuste assistenten toevoegen.
- CTO’s die open-weightsalternatieven voor gesloten codeermodellen evalueren.
- AI-productmanagers die long-context-workflows testen.
- Ondernemingen met toekomstige behoeften aan zelfhosting of datacontrole.
- Developerplatforms die modelopties nodig hebben.
- Teams die werken met grote technische documenten, SDK’s of codebases.
Het is vooral aantrekkelijk wanneer falen kostbaar is. Als een fout van het model leidt tot kapotte builds, slechte migraties of verspilde engineeringtijd, kan de inzet van een sterker model zich snel terugbetalen.
Wanneer GLM-5.2 niet gebruiken
Gebruik GLM-5.2 niet standaard voor:
- Korte en repetitieve classificatietaken.
- Eenvoudig herschrijven van tekst.
- Begrip van afbeeldingen of screenshots.
- Autocomplete met lage latentie waar milliseconden tellen.
- Workflows waar een kleiner model al goed presteert.
- Producten die geen langdurige generatie tolereren.
Het doel is niet om het grootste contextvenster te aanbidden. Het doel is de taak op te lossen met het juiste profiel van kwaliteit, kosten en latentie.
Eindoordeel
GLM-5.2 is een van de belangrijkste open-weights AI-modelreleases voor software-engineeringteams in 2026. De combinatie van 1M-context, sterke codeerbenchmarks, de redeneermodi High en Max, ondersteuning voor function calling en de MIT-licentie maakt het een serieuze optie voor codeeragents en langetermijn-AI-workflows.
Voor teams die het snel willen proberen is CometAPI een pragmatische toeganglaag. Je kunt GLM-5.2 aanroepen via een OpenAI-compatibele endpoint, het vergelijken met andere toonaangevende modellen, gebruik monitoren en een routeringsstrategie opbouwen zonder je stack rond één provider te herbouwen. Begin met een kleine, private evaluatie, meet de kosten per opgeloste taak en zet GLM-5.2 alleen daar in productie waar zijn long-context-sterktes zich duidelijk terugverdienen.
Klaar om GLM-5.2 in je eigen app te testen? Verken GLM-5.2 op CometAPI, maak een API-sleutel aan en voer je eerste OpenAI-compatibele aanvraag binnen enkele minuten uit. Gebruik het voor een echte repositorytaak, geen speelgoedprompt, en vergelijk het resultaat met je huidige modelstack.