Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Begin met GPT-6.1 Sol wanneer je al OpenAI Responses-tools gebruikt of zijn expliciete ladder voor redeneringsinspanning nodig hebt; test Claude Sonnet 5.5 voor goed afgebakende code-iteratie en sjabloongedreven professionele deliverables. Dit zijn evaluatieprioriteiten, geen bewezen kwaliteitsrangschikking. Beide starten op $2/M input en $10/M output en rekenen $0.10/M voor basis cache-lezingen. Met ongeveer 1M context en 128K standaard maximale output liggen de praktische verschillen in integratie, taakgedrag, cacheretentie en facturering voor lange context, niet in een korting op basis cache-lezen.
De belangrijkste afweging betreft taakgedrag en factureringsvoorwaarden. GPT-6.1 Sol gebruikt vijf inspanningsniveaus en vereist Responses voor tool-aanroepen; Sonnet 5.5 gebruikt adaptief denken. Boven 272K inputtokens past GPT-6.1 Sol hogere tarieven toe op het volledige verzoek. De hier beoordeelde bronnen stellen geen matched, exact-versie benchmarkwinnaar vast; kies het model dat aan je acceptatiecriteria voldoet met de laagste totale workflowkosten.
Key Takeaways
beide modellen rekenen $2/M input, $10/M output en $0.10/M cache-lezen. Vergelijk cache-schrijven, retentie, langcontexttiers en daadwerkelijk gefactureerd gebruik.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Gelijke basistarieven:
Context is vergelijkbaar: 1.05M versus 1M tokens; beide ondersteunen 128K standaard maximale output.
Integratie verschilt: GPT-6.1 Sol vereist Responses voor tool-aanroepen en accepteert geen none of minimal; Sonnet 5.5 gebruikt adaptief denken en model-specifieke toolbeperkingen.
Bewijs versie-specifiek houden: GPT-6 Sol-scores kunnen niet worden herlabeld als GPT-6.1 Sol-resultaten.
Kies op basis van afgerond werk: meet kwaliteit, latentie, retries, cache-schrijven en -lezen, toolkosten en menselijke correctie.
GPT-6.1 Sol vs Claude Sonnet 5.5 at a Glance
Decision factor / specification
GPT-6.1 Sol
Claude Sonnet 5.5
Provider
OpenAI
Anthropic
Release date
September 29, 2026
September 28, 2026
Model ID
gpt-6.1-sol
claude-sonnet-5-5
Context / standard maximum output
1,050,000 / 128,000 tokens
1,000,000 / 128,000 tokens
Input → output
Text and images → text
Text and images → text
Reasoning controls
low, medium, high, xhigh, max; medium default
Adaptive thinking; high default on Claude Platform
Default effort
medium
high on Claude Platform
Knowledge cutoff
April 30, 2026
June 2026
Official base input / output per 1M tokens
$2 / $10; Standard requests with up to 272K input tokens
$2 / $10
Official base cache reads per 1M tokens
$0.10
$0.10
Official base cache writes per 1M tokens
$2.50
$2.50 for 5 minutes; $4.00 for 1 hour
Long-context billing
Above 272K input: $4 input, $0.20 cache read, $5 cache write, $15 output per 1M; applies to the full Standard request
GPT-6.1 Sol Overview
GPT-6.1 Sol is OpenAI's September 29, 2026 Sol release for complex coding, computer use, and professional work. OpenAI beschrijft het als near-Astra performance at a lower cost; die positionering moet op jouw taken worden gevalideerd. De grote context en verstelbare redenering maken het een kandidaat voor repository-agenten en meerstaps professionele workflows.
De operationele beperkingen zijn even belangrijk als de positionering: medium is de standaardinspanning, low is het laagste ondersteunde niveau, en tool-aanroepen vereisen Responses. Een workflow gebaseerd op een no-reasoning pad of Chat Completions-tools vergt migratiewerk voordat dit model betrouwbaar kan worden gebruikt.
Claude Sonnet 5.5 Overview
Claude Sonnet 5.5 is Anthropic's release van 28 september 2026 voor goed afgebakende alledaagse coding, agenten en professionele werkzaamheden. De modeloverzichtspagina documenteert adaptief denken, een hoge standaardinspanning op Claude Platform, input van tekst en afbeeldingen, en 128K standaard maximale output. Anthropic legt de nadruk op bugfixing, duidelijke documenten, gepolijste slides en efficiënte iteratie.
Voor een developmentteam maakt dat Sonnet een bruikbare kandidaat voor herhaalde implementatie- en reviewcycli. Voor een kantoorworkflow evalueer je de kwaliteit van de eerste versie en sjabloon-naleving. De snelheidsclaim van de provider vergelijkt Sonnet 5.5 met Sonnet 5; die stelt geen snelheidsvoordeel vast over GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Performance
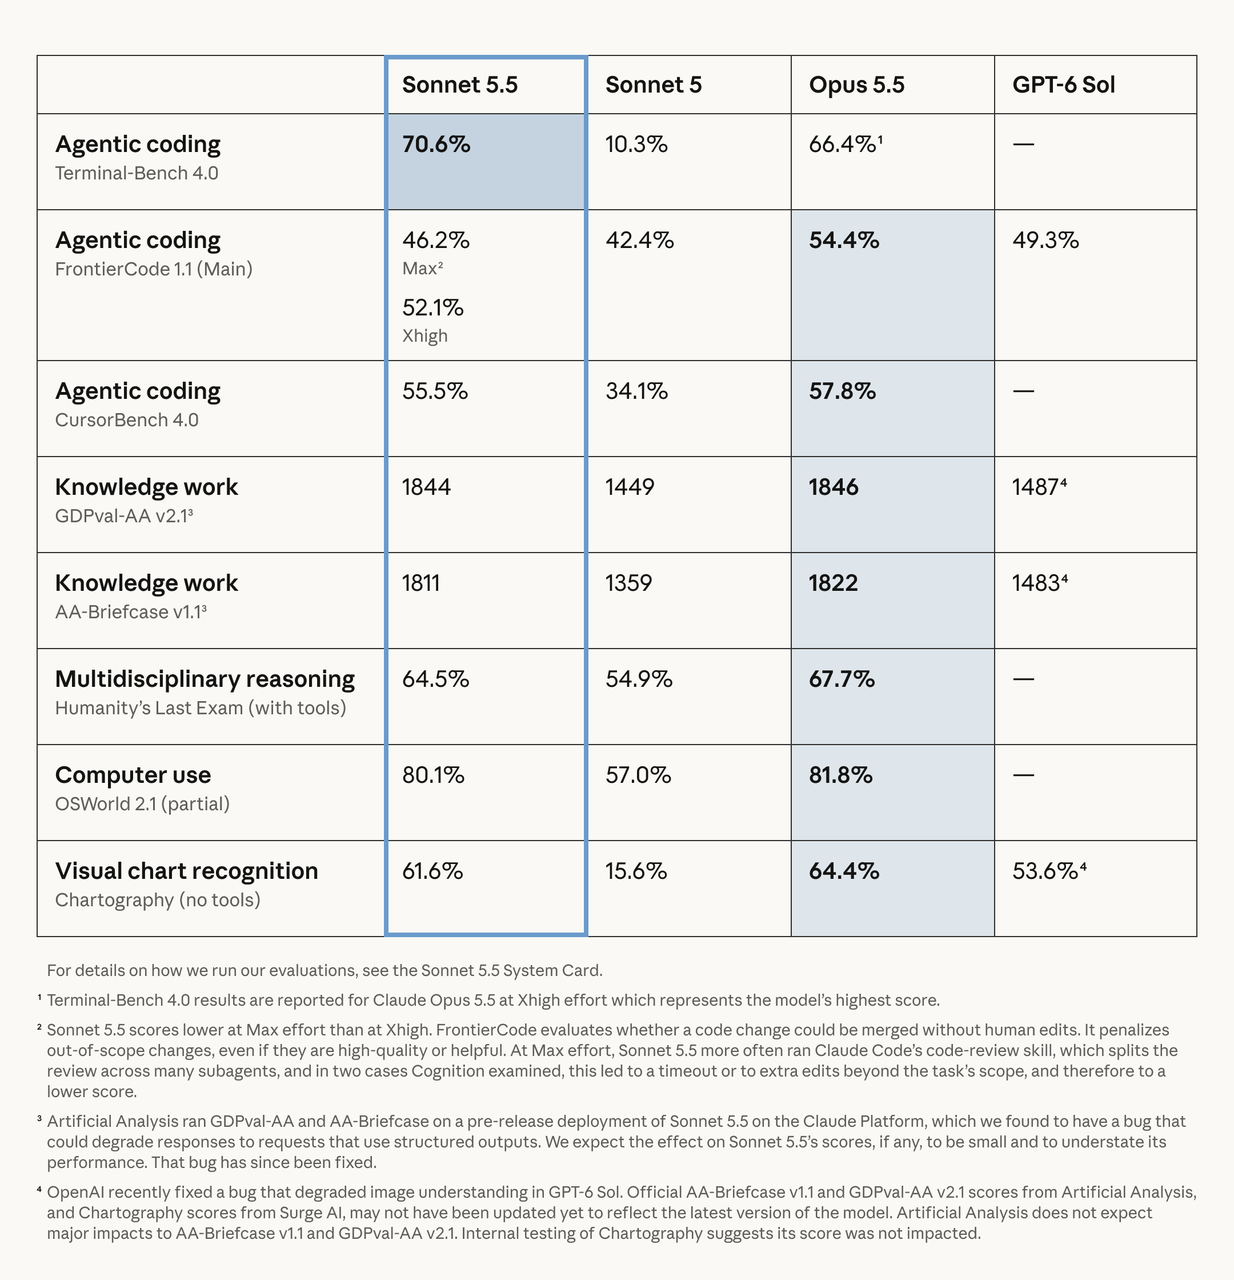
Anthropic's Sonnet 5.5 launch results bieden een nuttige set workload-signalen. De vergelijking omvat de oudere GPT-6 Sol, dus die OpenAI-kolomwaarden zijn uitgesloten van de huidige-modellentabel hieronder. “Not established” betekent dat de aangehaalde bronnen geen exact-versie score ondersteunen voor deze vergelijking; het betekent niet nul prestaties.
Benchmark / conditions
GPT-6.1 Sol
Claude Sonnet 5.5
What it measures
Terminal-Bench 4.0
Not established here
70.6%
Terminal coding tasks
FrontierCode 1.1 Main
Not established here
52.1% Xhigh; 46.2% Max
Mergeable repository changes
CursorBench 4.0
Not established here
55.5%
Agentic development in Cursor tasks
GDPval-AA v2.1
Not established here
1844
Professional knowledge work
AA-Briefcase v1.1
Not established here
1811
Long-horizon knowledge work
Humanity’s Last Exam, tools
Not established here
64.5%
Multidisciplinary reasoning
OSWorld 2.1, partial
Not established here
80.1%
Computer-use partial reward
Chartography, no tools
Not established here
61.6%
Visual chart recognition
Testcondities: inspanning en agent-harnas beïnvloeden de coderesultaten. GDPval-AA en AA-Briefcase zijn Artificial Analysis-evaluaties, terwijl Chartography-resultaten afkomstig zijn van Surge AI. Anthropic wijst op een nadien verholpen structured-output-bug in de pre-release Sonnet-deployment die de professionele-werkresultaten mogelijk licht heeft onderschat. Gebruik de System Card-link van de aankondiging voor testomgevingen en volledige methodologie; combineer geen ongelijke metriek tot één algemene ranking.
De originele Anthropic-afbeelding hieronder bevat de evaluatievoetnoten. De GPT-6 Sol-kolom is historische context en rapporteert geen prestaties van GPT-6.1 Sol.
Agentic Coding and Software Engineering
Sonnet 5.5 heeft gerapporteerd bewijs over terminal-coding, mergebare codewijzigingen en IDE-stijl agenttaken. GPT-6.1 Sol is gedocumenteerd voor complexe coding en integreert met het OpenAI-tool-ecosysteem. Noch productpositionering, noch de score van een voorganger stelt een huidige codingwinnaar vast. Voor een nuttige evaluatie kies je echte wijzigingen met regressietests en vraag je reviewers om scope, onderhoudbaarheid en gereedheid om te mergen te beoordelen.
Knowledge Work, Reasoning, Math, and Science
Sonnet’s GDPval-AA en AA-Briefcase-resultaten maken rapporten, analyses en kantoorleveringen tot zinvolle evaluatiedoelen. GPT-6.1 Sol richt zich ook op professioneel werk, maar de hier gebruikte bronnen bieden geen matched vergelijking over deze modellen. Gebruik je eigen document-, spreadsheet- en presentatie-sjablonen. Geavanceerde wiskunde en wetenschappelijke claims vereisen taak-specifiek bewijs in plaats van extrapolatie op basis van algemene redeneringsinstellingen.
Computer Use, Browser Automation, and Multimodal Workflows
Beide modellen accepteren afbeeldingen, wat screenshot-debugging en visuele analyse ondersteunt. Sonnet’s OSWorld- en Chartography-resultaten zijn bewijs voor die specifieke evaluaties. GPT-6.1 Sol documenteert computergebruik via Responses-tools. Test de volledige workflow: navigatienauwkeurigheid, herstel na een mislukte tool-aanroep, outputcorrectheid en tijd tot voltooiing. Input van tekst en afbeeldingen garandeert op zichzelf geen identieke integratie voor computergebruik.
Independent Evaluation and Evidence Quality
Een door de provider gepubliceerde tabel kan resultaten van derden bevatten zonder een enkele gecontroleerde experiment te worden. Voor elke onafhankelijke vergelijking leg je de exacte model-ID’s, implementatiedata, inspanning, tools, waarborgen, timeout, retry-policy en stopregels vast. Een geaggregeerde intelligentie-index, een coding-succesratio en een partiële beloning voor computergebruik beantwoorden verschillende vragen. De beoordeelde bronnen stellen geen complete, matched onafhankelijke resultset vast voor precies dit paar.
No equivalent surcharge stated in the cited overview
Alle tarieven zijn USD per miljoen tokens. GPT-6.1 Sol base cache reads cost $0.10/M en Sonnet 5.5 cache reads also cost $0.10/M. De voorwaarde van Sol boven 272K input verhoogt de tarieven voor het volledige Standard-verzoek, niet alleen de overtollige tokens. Vergelijk cache-schrijven, retentie, langcontexttiers, regionale verwerking en servicetiers; de basis leesprijs alleen geeft geen van beide modellen een voordeel.
Cost per Completed Task
Kosten per geaccepteerd resultaat = totale kosten over alle pogingen / aantal geaccepteerde resultaten. Totale kosten omvatten gefactureerde verse input, cache-lezingen en -schrijvingen, output (inclusief gefactureerde redeneertokens waar van toepassing), betaalde tool-aanroepen en menselijke review of correctie. Retry-kosten worden meegerekend via het daadwerkelijke gebruik, niet nogmaals toegevoegd als een dubbele last.
Voor één miljoen cache-gelezen tokens die volledig tegen het basistarief worden gefactureerd, kost elk model $0.10; het basisverschil in leesprijs is $0.00. Dit is een tariefillustratie, geen Sol-verzoek met één miljoen inputtokens geprijsd op de basistier. De werkelijke sessiekosten omvatten ook verse input, cache-schrijven, output, tools en retries. Vergelijk koude en warme sessies onder de toepasselijke contexttier en rapporteer het acceptatiepercentage naast de gefactureerde inzet.
CometAPI Pricing
Published CometAPI tier
GPT-6.1 Sol API in CometAPI
Claude Sonnet 5.5 API in CometAPI
Base input / output per 1M
$1.60 / $8.00
$1.60 / $8.00
Base discount vs provider
20%
20%
GPT long-context input / output
$3.20 / $12.00
Check current route-specific terms
GPT cache reads, base / long
$0.08 / $0.16
Not specified in the cited basic pricing table
Dit zijn de gepubliceerde modelrouteprijzen die voor deze revisie zijn gecontroleerd, los van providertarieven. De CometAPI-prijzen van GPT-6.1 Sol onderscheiden korte en lange context. De genoemde basistabel voor Sonnet vermeldt input en output, dus die rechtvaardigt niet de aanname van een identiek gateway-cachebeleid. Controleer de huidige factureringsvoorwaarden van de geselecteerde route voordat je een productiesessie schat.
How Do Context Windows, Speed, and Technical Specs Compare?
GPT-6.1 Sol ondersteunt 1.05M tokens, terwijl Claude Sonnet 5.5 1M tokens ondersteunt. Het nominale verschil is slechts ongeveer 5%, dus contextcapaciteit alleen zal de meeste deployments niet beslissen.
De inspanningsladder van GPT-6.1 Sol is low, medium, high, xhigh en max; medium is de standaard. Sonnet 5.5 gebruikt adaptief denken met high als standaard op het Claude Platform. Die namen impliceren niet gelijke redeneringsbudgetten. Meet bij gelijke kwaliteitsvereisten afzonderlijk time-to-first-token, outputdoorvoer, tool-loop-latentie en end-to-end voltooiing.
Anthropic rapporteert meer dan 30% snellere outputgeneratie voor Sonnet 5.5 dan Sonnet 5. Behandel dat als een vergelijking met een voorganger. Het bewijs in dit artikel stelt geen universeel latentiecijfer vast voor GPT-6.1 Sol, noch een directe snelheidswinnaar tussen de huidige modellen. Test voor interactieve workloads lagere inspanningsinstellingen tegen dezelfde acceptatierubriek in plaats van aan te nemen dat max de beste deploymentinstelling is.
What Matters for Safety, Alignment, and Deployment?
Deployments moeten gedocumenteerd modelgedrag onderscheiden van applicatieregeling. Een modelvergelijking alleen kan niet vaststellen welke deployment voldoet aan de vereisten van je organisatie voor gegevensafhandeling of toegang. Evalueer de provider of gateway die je daadwerkelijk gebruikt, inclusief requestlogging, dataresidency, toolrechten en foutafhandeling.
Reasoning migration: GPT-6.1 Sol ondersteunt geen none of minimal. OpenAI's migration guidance verwijst tool-call-workflows naar Responses.
Claude tool behavior: Sonnet 5.5's gedocumenteerde compatibiliteitswijzigingen omvatten niet-ondersteunde geforceerde tool-modi en conversation-bound thinking blocks. Test deze paden vóór uitrol.
Operationele controles: geef agenten alleen de tools die voor de taak nodig zijn, registreer mislukte aanroepen en behoud menselijke review voor consequente externe acties. Dit zijn keuzes in applicatieontwerp, geen gemeten voordelen voor een van beide modellen.
GPT-6.1 Sol vs Claude Sonnet 5.5: Which Should You Choose?
Test GPT-6.1 Sol eerst wanneer je al Responses-tools gebruikt of voorspelbare inspanningscontrole nodig hebt. Test Sonnet 5.5 voor goed afgebakende code-iteratie, slides, spreadsheets en document-workflows waar het gerapporteerde bewijs bij je taken past. Voor sessies met gecachte prefixes test je beide: hun basis cache-leestarieven zijn gelijk, terwijl schrijfkosten, retentie, langcontexttiers en taaksucces de totale rekening kunnen veranderen. Routeer werk pas nadat representatieve evaluaties een nuttig verschil in kwaliteit, kosten of latentie vaststellen.
Workload-Based Selection
Workload
Starting point
What to verify
Existing OpenAI Responses agent
GPT-6.1 Sol
Tool compatibility and effort changes
Coding iteration / bug fixing
Sonnet 5.5, then compare Sol
Merge readiness, latency and retries
Slides / spreadsheets / reports
Sonnet 5.5, then compare Sol
Template adherence and human edit time
Stable cached-prefix sessions
Both; equal base cache-read rates
Hit rate, writes, context tier and accepted quality
Full requests above 272K input
Both
Actual long-context bill and retrieval quality
Computer / browser automation
Both
Recovery, task completion and permissions
Math / scientific analysis
Both on task-specific tests
Correctness with verifiable answers
Cost-sensitive production
Both
Total cost per accepted result
Een productievergelijking moet het omliggende systeem constant houden. Gebruik dezelfde prompts, repositories of documenten, toolrechten, timeout, retry-policy en output-acceptatierubriek.
Leg verse input, cache-schrijvingen en -lezingen, outputgebruik, betaalde tool-aanroepen, retries, tijd voor menselijke review, taaksucces en end-to-end latentie vast. Een goedkoper eerste antwoord kan nog steeds een duurder geaccepteerd resultaat opleveren.
How Can You Access GPT-6.1 Sol and Claude Sonnet 5.5?
Developers hebben toegang tot GPT-6.1 Sol API in CometAPI en Claude Sonnet 5.5 API in CometAPI via de gedocumenteerde modelroutes. Maak een API-sleutel, sla die veilig op en verifieer modeltoegang en route-specifieke facturering vóór productiegebruik.
GPT-6.1 Sol Access
Voor Sol gebruik je de gedocumenteerde Responses-route wanneer tool-aanroepen nodig zijn. Selecteer gpt-6.1-sol en een ondersteund inspanningsniveau, met medium als standaard. Geef de taakinput door, configureer alleen de benodigde tools en valideer geretourneerde tekst, tool-aanroepen, fouten en gebruik. Bevestig gateway-ondersteuning voor provider-specifieke functies in plaats van aan te nemen dat elke OpenAI-optie beschikbaar is.
Claude Sonnet 5.5 Access
Voor Sonnet selecteer je claude-sonnet-5-5 op een gedocumenteerde compatibele interface en stuur je de taak als conversatieberichten met een passend outputbudget. Bevestig hoe die route native thinking en toolparameters afhandelt; OpenAI-reasoningvelden zijn niet automatisch uitwisselbaar met Claude-opties. Valideer conversatievoortzetting en foutafhandeling voordat je een agent uitrolt.
Een endpoint-check verifieert connectiviteit, geen vergelijkende prestaties. Lijn voor evaluatie prompts, effectieve output- en redeneerbudgetten, tools, retries, timeouts en acceptatiecriteria uit, en vergelijk geaccepteerd werk, latentie en totale gefactureerde kosten.
Conclusion
GPT-6.1 Sol en Claude Sonnet 5.5 delen dezelfde basis input-, output- en cache-leestarieven, met vergelijkbare contextcapaciteit. Sol is een logische kandidaat voor bestaande Responses-agenten en expliciete inspanningscontrole. Sonnet’s adaptief denken en gerapporteerde coding- en professioneel-werkresultaten maken het een bruikbare kandidaat voor dagelijkse deliverables. Cache-zware workflows vereisen een volledige sessievergelijking: gelijke basis leesprijzen garanderen geen gelijke schrijf-, retentie-, langcontext- of kosten per voltooide taak.
Kies het model dat je daadwerkelijke werk binnen kwaliteits-, latentie- en kostenvereisten voltooit. Houd voorgangerscores gescheiden van huidig-modelbewijs, prijs de contexttier die je workload gebruikt en vergelijk beide routes voordat je een standaard adopteert.
FAQ
Can GPT-6.1 Sol and Sonnet 5.5 share one tool schema?
Een gemeenschappelijke JSON-tooldefinitie kan een vertrekpunt zijn, maar endpointsupport, forced-tool-gedrag, thinking blocks en response-afhandeling verschillen. Valideer de tool-aanroepen van elk model met contracttests voor argumenten, faalpaden en conversatievoortzetting. Houd model-specifieke adapters aan voor niet-ondersteunde opties in plaats van aan te nemen dat een geslaagde tekstaanvraag agentcompatibiliteit bewijst.
How should reasoning effort be matched across both models?
Behandel identiek benoemde instellingen niet als gelijke computebudgetten. Definieer een acceptatierubriek en óf een kostengrens óf een latentiedoel, en sweep inspanningsinstellingen voor elk model. Vergelijk de beste configuratie die aan dezelfde operationele beperking voldoet, inclusief retries en menselijke correctie, in plaats van uitsluitend de hoogste instellingen van beide modellen te vergelijken.
When should a 1M-context workflow use retrieval instead?
Gebruik retrieval wanneer een taak een klein, identificeerbaar deel van een grote corpus nodig heeft en je retrievaltests consequent relevant materiaal terugvinden. Test full-context-verzoeken wanneer bewijs is verspreid of cross-file-relaties ertoe doen. Vergelijk antwoordsorrectheid, citatiedekking, inputkosten en latentie; een grote contextlimiet op zich bewijst niet dat het vullen van het volledige venster economisch of betrouwbaar is.
How can teams avoid a misleading cache-cost comparison?
Meet cold-cache- en warm-cache-runs afzonderlijk, registreer cache-schrijvingen evenals lezingen en pas het juiste retentievenster en langcontexttier toe. Houd gedeelde prefixes stabiel en vergelijk herhaalde realistische sessies, niet slechts één afgeprijsd verzoek. Rapporteer de hitrate en de totale gefactureerde inzet zodat een schijnbare besparing reproduceerbaar is.
What should trigger a new GPT-6.1 Sol vs Sonnet 5.5 evaluation?
Draai de betreffende taakset opnieuw na een deploymentupdate, providerbugfix, routeringswijziging, tool- of promptwijziging of een materiële prijsrevisie. Noteer evaluatiedatum, model-ID, endpoint, inspanning en harnasversie. Bewaar de eerdere run als baseline zodat veranderingen in kwaliteit of latentie niet worden verward met wijzigingen in het omliggende systeem.
No equivalent surcharge stated in the cited model overview
Primary positioning
Complex coding, computer use, and professional work
Fast coding iteration and professional workflows
Test first when
You already use Responses tools or need explicit effort controls
Your work centers on coding, documents, slides, or spreadsheets
Evidence and decision limit
Documented capabilities; no matched exact-version numerical winner established here
Published coding and knowledge-work results; not a controlled win over GPT-6.1 Sol
GPT-6.1 Sol versus Claude Sonnet 5.5: Welk AI-model moet je gebruiken? - CometAPI