Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Benchmarks, functies, prijzen
Vergelijk GPT-6.1 Terra en DeepSeek V4.1 Flash op benchmarks, coderen, visuele mogelijkheden, context, API-prijzen en CometAPI-toegang, om te bepalen welke beter is.
TL;DR: GPT-6.1 Terra is het sterkere startpunt wanneer redeneringskwaliteit en complexe visuele workflows het belangrijkst zijn; DeepSeek V4.1 Flash is aantrekkelijk wanneer tokenkosten, generatiesnelheid of zelf-hosting prioriteit hebben. Deze vergelijking gebruikt DeepSeek’s update van 17 oktober, Flash-1017.
DeepSeek Flash-1017 heeft lagere tokenprijzen, maar de kosten van een voltooide taak hangen ook af van de lengte van het redeneren, herhaalpogingen en tool-aanroepen.
De vergelijking hieronder behandelt architectuur, context, redeneren, coderen, visie, snelheid, prijzen en deployment. Prijzen en live-evaluatiepagina’s zijn gecontroleerd op 28 oktober 2026.
Belangrijkste punten
Terra leidt de aangehaalde onafhankelijke Intelligence Index-vergelijking, waardoor het een logische eerste kandidaat is voor veeleisende redeneertaken.
DeepSeek heeft lagere vermelde tokenprijzen. Vergelijk end-to-end latency en kosten per succesvolle taak, inclusief piekuren, cachegebruik, redeneertokens en herhaalpogingen.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Evalueer coderen op geaccepteerde patches en visuele workflows op voltooide taken. Gepubliceerde benchmarkscores zijn nuttig, maar de testopzetten verschillen.
Terra is een gehost model met propriëtaire hosting. DeepSeek biedt MIT-gelicentieerde downloadbare gewichten voor zelf-hosting, met hardware- en operationele kosten om te overwegen.
CometAPI biedt een gedeelde tekstinterface om beide modellen te testen. Controleer de geleverde modelversie en de ondersteuning voor tools, redeneringsinstellingen en gestructureerde output voordat u uitrolt.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Overzicht en specificaties
De belangrijkste specificatieverschillen hebben betrekking op outputlimieten, redeneerinstellingen, tool-aanroepen en deployment. De tabel hieronder vat de twee modellen samen.
Propriëtaire architectuur; aantal parameters onbekend
552B Causal Encoder–Decoder MoE; circa 8B actieve parameters voor input en 16B voor output
Contextvenster
1,050,000 tokens
1M tokens
Maximale uitvoer
128,000 tokens
384K tokens
Invoermodaliteiten
Tekst, afbeeldingen
Tekst, afbeeldingen
Uitvoermodaliteiten
Tekst
Tekst
Redeneerinstellingen
none, low, medium, high, xhigh, max
Thinking-schakelaar; low, high, max in Chat Completions
Tool-aanroepen
Ondersteund via de Responses API
Ondersteund; gedrag hangt af van endpoint en thinking-modus
Open gewichten
Nee
Ja, MIT-licentie
Architectuur en modelversies
Terra gebruikt een propriëtaire architectuur waarvan het aantal parameters niet publiekelijk is bekendgemaakt. DeepSeek-V4.1-Flash gebruikt een Causal Encoder–Decoder MoE-architectuur, met verschillende budgetten aan actieve parameters voor inputverwerking en outputgeneratie.
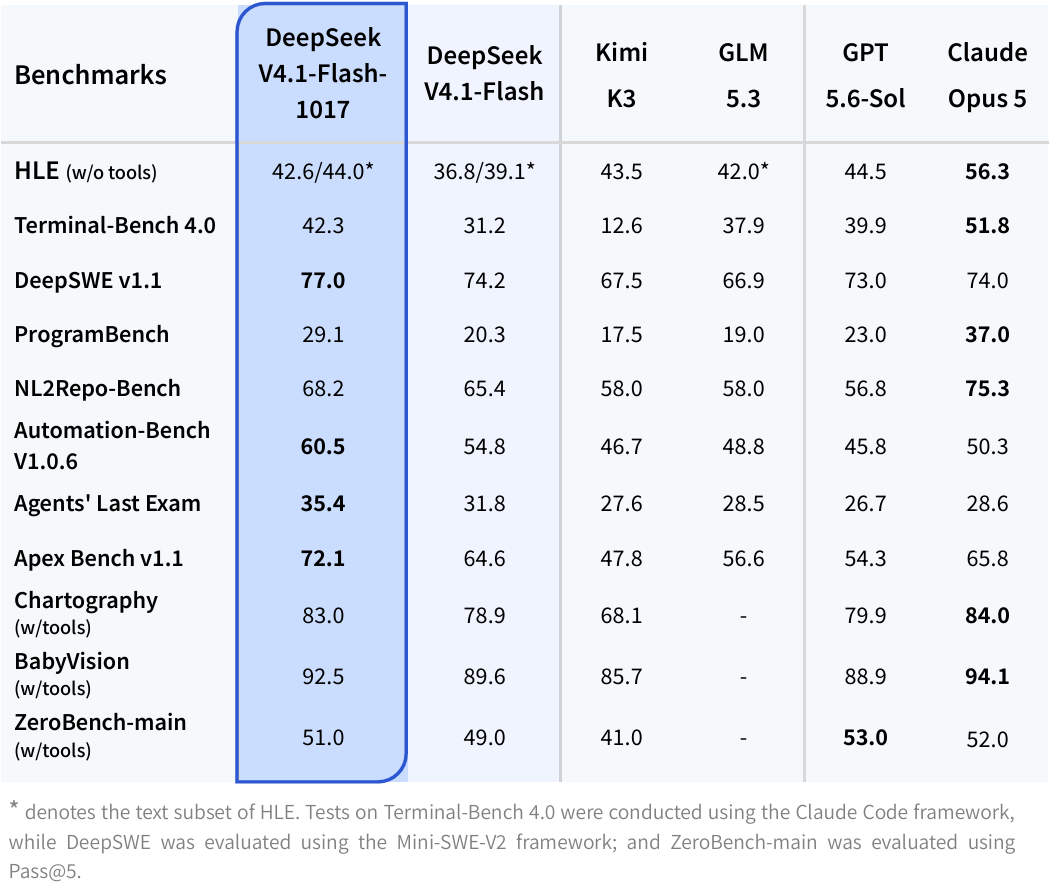
DeepSeek’s V4.1 Flash release beschrijft een Causal Encoder–Decoder Mixture-of-Experts-backbone met 552B parameters, met ongeveer 8B parameters actief tijdens inputverwerking en 16B tijdens outputgeneratie. De update van 17 oktober verbetert de gepubliceerde resultaten voor coderen, agents en visie.
In dit artikel verwijst Flash-1017 naar die oktober-checkpoint. Een generieke API-alias kan later naar een andere versie wijzen, dus een evaluatierecord moet de daadwerkelijk geleverde modelversie bevatten.
KV-cache en implementatievereisten
DeepSeek meldt een globale KV-cache-voetafdruk van circa 890 bytes per token, ongeveer een kwart van die van DeepSeek-V4-Flash. Dit verbetert de cache-efficiëntie, hoewel zelf-hosting nog steeds substantiële resources vereist voor de modelgewichten. Terra is beschikbaar via gehoste diensten, terwijl DeepSeek’s downloadbare gewichten een extra optie voor zelf-hosting bieden.
Redeneerinstellingen en tool-aanroepen
Beide modellen ondersteunen agent-workflows, maar redeneerinstellingen en vereisten voor tool-aanroepen verschillen. Terra’s gedocumenteerde tool-ondersteuning gebruikt de Responses API. DeepSeek’s modelkaart beschrijft numerieke redeneerinspanning van 1 tot 100; gehoste API-instellingen moeten afzonderlijk worden gecontroleerd. Pas bij het wisselen van model de redeneerparameters en tooldefinities aan het gekozen endpoint aan.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Prestaties
De vergelijking hieronder bestrijkt redeneren, coderen, visie en taken met lange context. Onafhankelijke evaluaties en door leveranciers gerapporteerde benchmarks worden afzonderlijk geïdentificeerd, met resultaten geïnterpreteerd in samenhang met hun modelconfiguraties en agent-frameworks.
Redeneren en kennis
Artificial Analysis meldt een Intelligence Index v5.0-score van 51 voor GPT-6.1 Terra (Max) en 32 voor DeepSeek Flash-1017 (Max) in de aangehaalde configuraties, per 28 oktober 2026. De index combineert negen evaluaties.
Terra’s hogere geaggregeerde score ondersteunt het om het eerst te testen voor veeleisende redeneertaken. Voor meer afgebakende workloads kan DeepSeek nog steeds de betere keuze zijn als het de vereiste nauwkeurigheid haalt tegen lagere kosten per succesvolle taak.
Officiële benchmarks voor coderen en agents
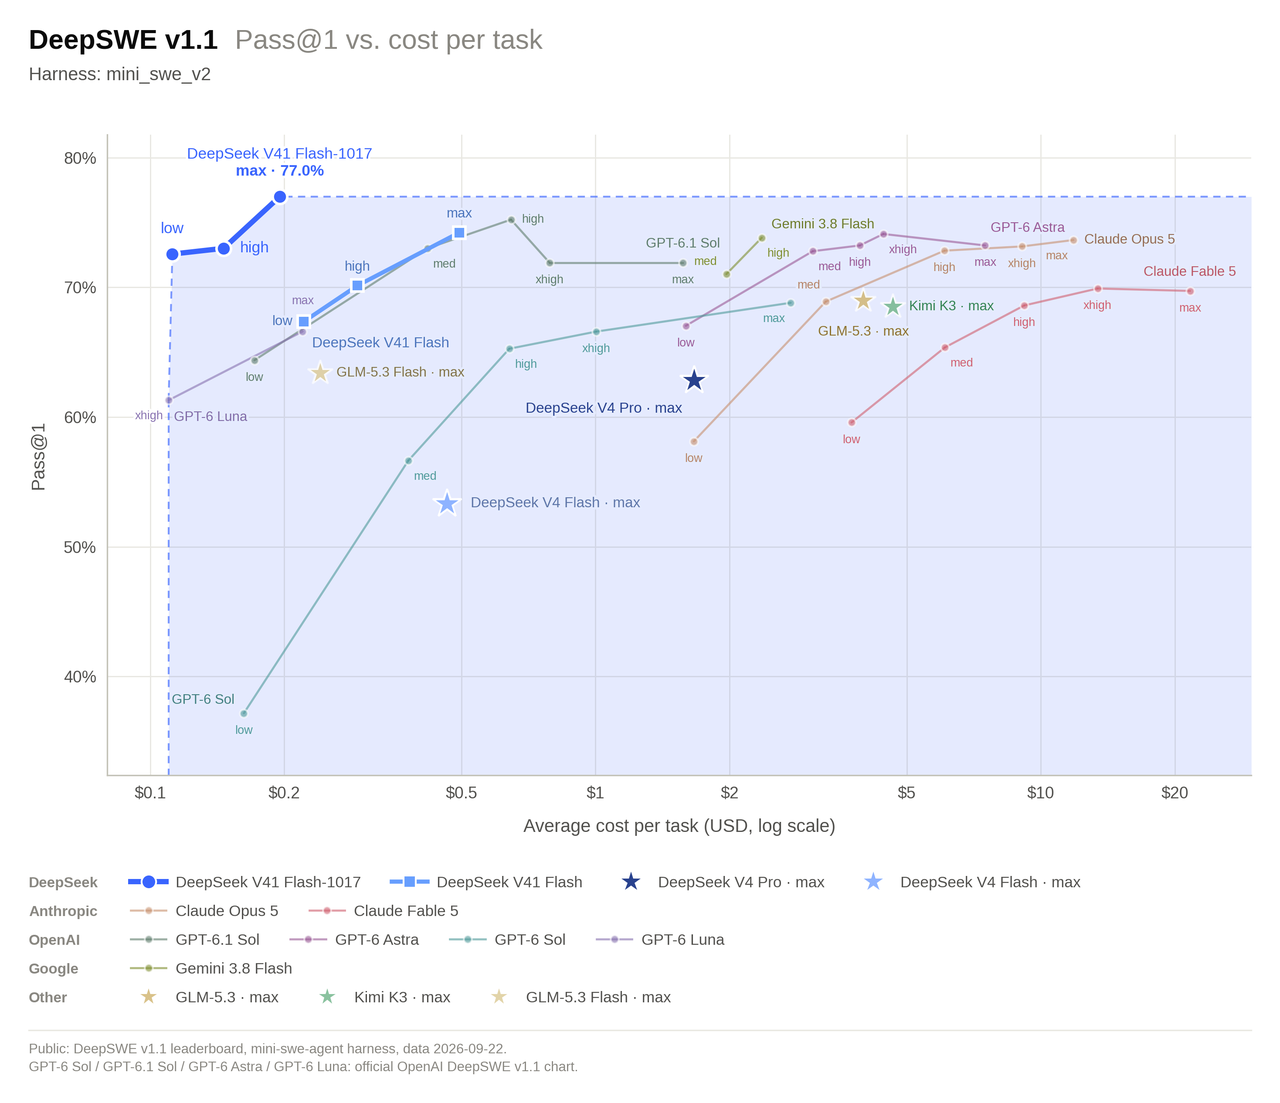
Terminal-Bench 4.0 en DeepSWE v1.1 leveren bewijs over codeer- en agentprestaties. Vergelijk bij leveranciersresultaten de exacte modelversie, redeneerinstelling, agent-framework en scoremetriek; verschillen in deze instellingen kunnen de scores materieel beïnvloeden.
Voor praktisch programmeerwerk: vergelijk of elk model patches produceert die bestaande tests halen, publieke interfaces behouden, randgevallen afhandelen en niet-gerelateerde wijzigingen vermijden. Betrouwbaarheid van tool-aanroepen en herstel na uitvoeringsfouten beïnvloeden ook hoeveel werk een agent kan voltooien.
De lagere vermelde tokenprijzen van DeepSeek maken het een nuttige kandidaat voor repetitief repository-onderhoud met duidelijke acceptatiecriteria. Voor complexe wijzigingen: vergelijk beide modellen op geaccepteerde patches, totale taakkosten en benodigde menselijke correctietijd.
Visie en computergebruik
Beide modellen accepteren afbeeldingsinvoer, maar beeldbegrip en desktopinteractie vereisen verschillende capaciteiten. OpenAI’s Terra-lancering behandelt MMMU-Pro en OSWorld 2.1, terwijl DeepSeek’s modelkaart visuele taken meldt waaronder Chartography en BabyVision, met tool-ondersteunde instellingen.
Voor documentextractie: vergelijk veldnauwkeurigheid, gemiste tekst en tabelstructuur. Voor desktopautomatisering: vergelijk voltooide workflows, onjuiste acties en herstel na interfacewijzigingen. Een model dat een schermafbeelding accuraat beschrijft, kan nog steeds moeite hebben met het bedienen van de getoonde applicatie.
Kies op basis van de workflow: extractienauwkeurigheid is het belangrijkst voor documentverwerking, terwijl betrouwbare acties en herstel belangrijker zijn voor computer-use agents. Vergelijk kosten pas nadat beide modellen de vereiste kwaliteitsdrempel halen.
Redeneren met lange context en retrieval
Beide modellen ondersteunen workflows met lange documenten, maar contextcapaciteit alleen bepaalt de retrievalkwaliteit niet. Vergelijk ze op dezelfde documentcollectie, met belangrijke bewijsstukken aan het begin, in het midden en aan het einde.
Evalueer antwoordnauwkeurigheid, ondersteunende passages, consistentie over documenten heen en volledigheid van antwoorden. Voor research en documentanalyse verdient het model de voorkeur dat relevante bewijzen betrouwbaar ophaalt en verbindt binnen uw latency- en kostvereisten.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Snelheid
Outputdoorvoer en taakafrondingstijd
Latency verdient een aparte behandeling ten opzichte van redeneringskwaliteit.
Op de pagina’s van Artificial Analysis van 28 oktober is de Flash-1017 (Max) output-snelheid 173,4 tokens per seconde, terwijl Terra (Max) output-snelheid 90,9 is. Die metingen beschrijven de configuraties die de evaluator kreeg aangeboden, geen gegarandeerde snelheden bij elke aanbieder.
Een model dat sneller tokens genereert, kan alsnog langer duren om te voltooien als het meer redeneert, op tools wacht of herhaalt. Meet time-to-first-token, totale voltooiingstijd en latency van geaccepteerde taken apart.
Interactieve latency op uw API-route
Voor een interactieve productervaring: test korte en lange prompts bij realistische gelijktijdigheid en noteer mediaan- en 95e-percentiellatency. Houd regio, API-route, promptcaching, redeneerinstellingen en retrybeleid in de resultaten bij. Dat record vertelt u meer over de gebruikerservaring dan één tokens-per-seconde-cijfer.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Kosten
Prijzen zijn een van de duidelijkste verschillen tussen deze modellen.
De Terra-tarieven en DeepSeek-prijsbeleid geven de volgende first-party tarieven zoals gecontroleerd op 28 oktober 2026. Alle prijzen zijn US dollars per miljoen tokens.
Officiële API-tarieven
Tokencategorie
GPT-6.1 Terra Standard
DeepSeek Flash off-peak
DeepSeek Flash peak
Invoer, cache-miss
$1.00
$0.15
$0.30
Invoer, cache-hit
$0.05
$0.003
$0.006
Uitvoer
$5.00
$0.60
$1.20
DeepSeek peak-prijzen gelden maandag–vrijdag, 01:00–04:00 en 06:00–10:00 UTC, met uitzondering van Chinese feestdagen. Dat is 09:00–12:00 en 14:00–18:00 in China Standard Time (UTC+8). Andere perioden gebruiken de off-peak-tarieven.
Voor Terra-verzoeken boven 272,000 invoertokens specificeert OpenAI 2× input- en cached-input-tarieven en 1,5× outputtarieven voor het hele verzoek. Vergelijk die voorwaarden met uw daadwerkelijke promptgroottes voordat u de basisprijs als effectieve prijs behandelt.
CometAPI-tarieven
CometAPI-basistarief per 1M tokens
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Niet-gecachete invoer
$0.80
$0.12
Uitvoer
$4.00
$0.48
Gecachete invoer
Niet afzonderlijk gespecificeerd
$0.0024
Tijdsafhankelijke multiplier
Niet gespecificeerd in basistarief
2× tijdens vermelde piekvensters
CometAPI vermeldt DeepSeek’s piekvensters als maandag–vrijdag, 01:00–04:00 en 06:00–10:00 UTC. Het vermelde schema legt niet dezelfde uitzondering voor feestdagen vast als DeepSeek’s first-party beleid. Controleer de facturatievoorwaarden van de gekozen route voor uw beoogde uitvoeringstijd.
Voorbeeld met vaste tokenhoeveelheid
Neem een verzoek dat 100,000 niet-gecachete invoertokens verbruikt en 10,000 outputtokens genereert.
Als dat de volledige gefactureerde tokentotalen zijn, is de tokenrekening $0.150 voor Terra, $0.021 voor DeepSeek off-peak of $0.042 voor DeepSeek tijdens piek. De off-peak-reductie is 86%. Het voorbeeld sluit extra toolkosten, infrastructuur en herhaalpogingen uit; apart getelde redeneertokens moeten ook in de berekening worden opgenomen.
Tegen de vermelde basistarieven van CometAPI kosten dezelfde 100,000 input- en 10,000 outputtokens $0.120 voor Terra of $0.0168 voor Flash. Toepassing van de vermelde 2× piekmultiplier geeft $0.0336 voor Flash. Dit zijn token-only berekeningen op basis van de opgegeven aantallen, geen metingen van een daadwerkelijke taak.
Wanneer extra output het tokenprijsvoordeel uitwist
Houd 100,000 niet-gecachete input gelijk en Terra’s totaal gefactureerde output op 10,000 tokens. Terra’s standaard tokenrekening is dan $0.150. Flash bereikt dezelfde rekening bij 225,000 gefactureerde outputtokens off-peak, of 100,000 tijdens piektarieven. Deze rekenkunde isoleert het outputvolume; caching, herhaalde input, toolkosten en herhaalpogingen veranderen de vergelijking.
Kosten per succesvolle taak
Evalueer een vaste batch taken en deel alle gefactureerde API- en tooluitgaven door het aantal taken dat uw acceptatiecontroles doorstaat. Tel de uitgaven voor mislukte pogingen ook mee. Rapporteer het succespercentage naast deze kosten, zodat een model niet simpelweg wordt beloond omdat het alleen de makkelijkste taken voltooit.
Kosten per succesvolle taak = Totale API- en toolkosten / Succesvol voltooide taken
Welke moet u kiezen: GPT-6.1 Terra of DeepSeek-V4.1-Flash?
Kies op basis van de kwaliteitsvereisten, kostendoelen en deploymentbehoeften van de taak. Gebruik de bovenstaande benchmarkresultaten om te beslissen welk model u eerst test.
Use case
Startkandidaat
Wat de keuze zou moeten bepalen
Veeleisend redeneren
GPT-6.1 Terra
Nauwkeurigheid en correctiewerk op representatieve moeilijke taken
Coding-agents
Test beide
Geaccepteerde patches, regressietests, toolfouten en totale kosten
Complexe visuele workflows
GPT-6.1 Terra
Voltooide workflows en herstel na interfacefouten
Tekst- of afbeeldingsextractie op hoge schaal
DeepSeek Flash-1017
Of de extractienauwkeurigheid aan de vereiste drempel voldoet
Retrieval over lange documenten
Test beide
Evidence-retrieval en antwoordnauwkeurigheid over inputposities
Zelf-hosting
DeepSeek Flash-1017
Beschikbare hardware, operationele kosten en controle over gewichten
Interactieve applicaties
Test beide
Mediaan- en staartlatency op de geselecteerde providerroute
Wanneer GPT-6.1 Terra kiezen
Geef Terra prioriteit voor evaluatie wanneer complex redeneren centraal staat. Voor veeleisende visuele of computer-use workflows: neem het op in de testset en meet voltooide taken, fouten en herstel.
De kernvraag is of Terra mislukte pogingen en handmatige correctie genoeg reduceert om de hogere tokenprijs te rechtvaardigen.
Wanneer DeepSeek-V4.1-Flash kiezen
Begin met DeepSeek-V4.1-Flash voor repetitieve, grootschalige taken met duidelijke acceptatiecriteria en krappe kostendoelen. Kies het als de output aan uw kwaliteitseisen voldoet tegen lagere kosten per succesvolle taak.
DeepSeek’s MIT-gelicentieerde gewichten maken het ook de relevante optie wanneer zelf-hosting een vereiste is. Neem hardware- en operationele kosten mee in die beslissing.
Wanneer beide modellen testen
Test beide wanneer codeerkwaliteit, toolbetrouwbaarheid, latency of nauwkeurigheid op lange documenten cruciaal is. Gebruik representatieve taken met dezelfde input, tools, uitvoeringslimieten en acceptatiecriteria.
Vergelijk succespercentage, totale kosten per succesvolle taak, end-to-end latency en menselijke correctietijd. Noteer de modelversie en redeneerinstellingen zodat de resultaten reproduceerbaar zijn.
Een hybride setup kan routinetaken met DeepSeek starten en geselecteerde falen opschalen naar Terra. Meet de kosten en het voltooiingspercentage van de volledige workflow om te bevestigen dat de extra modelaanroep de moeite waard is.
Waar hebt u toegang tot GPT-6.1 Terra en DeepSeek V4.1 Flash?
Gebruik OpenAI’s gehoste API voor Terra of DeepSeek’s gehoste API voor Flash. Bevestig de huidige modelidentifier, accountlimieten en ondersteund endpoint vóór integratie. Flash-1017’s downloadbare gewichten bieden een aparte optie voor zelf-hosting.
Toegang via CometAPI
CometAPI biedt een OpenAI-compatibele interface die multi-model applicatieontwikkeling kan vereenvoudigen.
Gebruik GPT-6.1 Terra API en DeepSeek V4.1 Flash API met een gedeelde tekstclient, en voeg pas modelspecifieke controles toe nadat u de ondersteuning van de route hebt gecontroleerd.
Vergelijk tekstantwoorden via CometAPI
Om beide modellen via één tekstclient te proberen, gebruikt u de OpenAI Python SDK met uw CometAPI-sleutel en de endpoint https://api.cometapi.com/v1. Bewaar de sleutel in een omgevingsvariabele, stuur vervolgens dezelfde prompt naar de routes gpt-6.1-terra en deepseek-v4.1-flash en vergelijk de teruggestuurde antwoorden en tokengebruik.
Vraag bijvoorbeeld elk model om een betalingsworkflow te beoordelen die time-outs opnieuw probeert zonder een idempotentiesleutel en volledige request-bodies logt. Vergelijk hoe duidelijk de antwoorden betrouwbaarheids- en privacyrisico’s identificeren en praktische oplossingen uitleggen. Een gedeelde prompt maakt de antwoorden makkelijker te inspecteren, maar een standaard tekstverzoek maakt de redeneerbudgetten niet gelijk en vormt geen prestatieranking. Bevestig het checkpoint dat door elke route wordt geleverd voordat u een resultaat als bewijs over Flash-1017 beschouwt.
Conclusie
GPT-6.1 Terra biedt het sterkere huidige geaggregeerde redeneerresultaat, terwijl DeepSeek Flash-1017 lagere tokenprijzen, sneller gemeten outputgeneratie en open-gewicht-deployment combineert. De nuttige keuze is het model dat aan uw kwaliteits- en latency-eisen voldoet tegen de laagste totale kosten.
Begin met een representatieve workload, houd de toolomgeving en acceptatiecriteria constant en vergelijk de kosten van succesvolle voltooiingen. Een gedeelde CometAPI-tekstintegratie kan die evaluatie eenvoudiger maken, terwijl modelspecifieke features nog steeds hun eigen configuratie nodig hebben.
Veelgestelde vragen
Waarom kan dezelfde taak verschillende tokenrekeningen opleveren met Terra en Flash-1017?
Een tekstprompt wordt niet noodzakelijk hetzelfde aantal tokens in twee modellen. Gegenereerde antwoorden en redeneerlengtes kunnen ook verschillen. Vergelijk het gebruik dat door elke route wordt gerapporteerd voor identieke taken, inclusief gecachete en factureerbare redeneertokens waar gerapporteerd, in plaats van beide prijslijsten op één geschat tokenaantal toe te passen.
Kunnen GPT-6.1 Terra en DeepSeek V4.1 Flash een promptcache delen?
U kunt de prompttekst in uw applicatie hergebruiken, maar ga er niet van uit dat een cache die voor het ene model of de ene provider is gemaakt de rekening van de ander verlaagt. Cache-geschiktheid en -verantwoording zijn route-specifiek. Controleer de gebruiksvelden van elke response en test herhaalde verzoeken voordat u besparingen in een prognose opneemt.
Hoe moet ik gestructureerde output van Terra en Flash-1017 valideren?
Definieer de vereiste velden en types in uw applicatie voordat u een model kiest. Als een route JSON of schema-gebonden output biedt, verifieer de exacte modus die het ondersteunt, parseer vervolgens de response en valideer die tegen uw schema. Behandel ontbrekende velden, ongeldige waarden, afgekapt output en weigeringen als afzonderlijke uitkomsten. Geldige JSON bewijst nog niet dat de geëxtraheerde feiten correct zijn.