Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Begin met GPT-6.1 Terra voor taken met hoog volume, verifieerbaarheid en kostenbewustzijn. Evalueer GPT-6.1 Sol voor complexe codering, meerstaps toolgebruik en workflows waarbij fouten duur zijn. Een praktische standaard is om eerst Terra te gebruiken en op te schalen naar Sol wanneer vooraf gedefinieerde tests of validatiecontroles falen.
Belangrijkste punten
Standaard tokenprijzen: Op OpenAI Standard kost Terra $1 per miljoen inputtokens en $5 per miljoen outputtokens; Sol kost respectievelijk $2 en $10.
Taakspecifieke prestaties: Bij maximale redeneringsinspanning leidt Terra nipt op Agents’ Last Exam v1 en Terminal-Bench-Science 0.1, terwijl Sol leidt op Terminal-Bench 4.0 en OSWorld 2.1.
Gedeelde contextcapaciteit: Beide modellen bieden een contextvenster van 1.05 miljoen tokens en accepteren tekst- en afbeeldingsinput.
Verschillende redeneringsbesturing: Terra ondersteunt het uitschakelen van redenering met ; Sol vereist ten minste redeneringsinspanning.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
none
low
Operationele kosten tellen: Vergelijk uitgaven per succesvol voltooide taak, inclusief retries en toolcalls, en volg kosten voor menselijke beoordeling apart.
GPT-6.1 Terra vs GPT-6.1 Sol: Overzicht en specificaties
Het onderstaande overzicht vat de afwegingen samen. De gedetailleerde secties lichten het bewijs, de factureringsaannames en de grenzen achter elke keuze toe.
Beslissingsfactor
GPT-6.1 Terra
GPT-6.1 Sol
Startwerkload
Routinematig visueel werk en herhaalbare agents
Complexe codering en volgehouden professionele redenering
Context en modaliteiten
Zelfde totale contextcapaciteit; tekst- en beeldinput
Zelfde totale contextcapaciteit; tekst- en beeldinput
Redeneringsbesturing
Bevat een optie om redenering uit te zetten
Vereist minimaal lage redeneringsinspanning
Gepubliceerd prestatiepatroon
Lagere kosten bij herhaalbare agent-taken
Sterker op diverse moeilijke coding- en desktoptests
API-toegang
OpenAI en CometAPI
OpenAI en CometAPI
GPT-6.1 Terra: Efficiënte visuele en agent-workflows
OpenAI introduceerde GPT-6.1 Terra op 26 oktober 2026. Het combineert visuele redenering, computergebruik en generieke tekstgeneratie voor routinematige professionele workflows. De lagere tokenprijzen maken het een nuttig startpunt wanneer taken frequent zijn en resultaten gecontroleerd kunnen worden.
GPT-6.1 Sol: Complexe codering en professionele redenering
GPT-6.1 Sol werd gelanceerd op 29 september 2026. Het richt zich op veeleisende codering en professioneel werk. Evalueer het wanneer een onbekende repository, een lange keten van afhankelijke acties of dure correcties extra redeneringscapaciteit waardevol maken.
Context, redenering en API-specificaties
Specificatie
GPT-6.1 Terra
GPT-6.1 Sol
Officiële releasedatum
October 26, 2026
September 29, 2026
API-model-ID
gpt-6.1-terra
gpt-6.1-sol
Contextvenster
1,050,000 tokens
1,050,000 tokens
Kennisafsnijdatum
June 1, 2026
April 30, 2026
Input / output
Tekst en afbeeldingen / tekst
Tekst en afbeeldingen / tekst
Redeneringsinspanning
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Standaardinspanning
medium
medium
API-features: Beide modellen ondersteunen Structured Outputs, streaming en de Batch API. Tool-calling gebruikt de Responses API, en fine-tuning wordt niet ondersteund. Controleer of je gekozen provider en endpoint de features bieden die je toepassing nodig heeft.
Beide modellen staan tot 128,000 outputtokens toe binnen een contextvenster van 1,050,000 tokens. Het reserveren van de volledige outputruimte laat 922,000 tokens over voor de rest van de uitwisseling, inclusief je input, systeeminstructies en toolgeschiedenis. Dit is een planningsberekening, geen aparte vaste inputlimiet.
Architectuurverklaring: De gelinkte publieke modelspecificaties geven niet genoeg interne architectuurdetails voor een betrouwbare vergelijking. Contextcapaciteit en redeneringsinstellingen mogen niet worden gezien als bewijs van het aantal parameters of de architectuur.
Redeneringsbesturing: Terra’s none-instelling is nuttig voor eenvoudige transformaties en extractie. Gebruik voor de eerste vergelijking dezelfde ondersteunde redeneringsinstelling op beide modellen en stem vervolgens elk model af op de kwaliteit en latency die je workload vereist.
Beide modellen hebben dezelfde gepubliceerde contextcapaciteit, maar dat impliceert niet identieke retrievalnauwkeurigheid of lang-context redeneringskwaliteit. Modelselectie moet daarom rekening houden met redeneringskwaliteit, workflow-efficiëntie, kosten en taakspecifieke retrievalprestaties.
GPT-6.1 Terra vs GPT-6.1 Sol: Prestaties
De gerapporteerde resultaten tonen een gemengd beeld: Terra leidt nipt op sommige agent- en wetenschappelijke-codingevaluaties, terwijl Sol hoger scoort op algemene terminal-coding, desktopautomatisering en visie. De vergelijkingen hieronder scheiden de lanceringsresultaten van OpenAI van onafhankelijke evaluaties en leggen uit wat elk wel en niet kan zeggen over prestaties in productie.
Officiële benchmarkresultaten en testcondities
De volgende resultaten komen uit de Terra-lanceringsevaluaties van OpenAI. Terra wordt getoond op medium en maximale redeneringsinspanning; Sol wordt getoond op maximale inspanning. De laatste kolom vergelijkt alleen de configuraties met maximale inspanning.
OSWorld gebruikt de offline 2.1-evaluatie. De factualiteitstest gebruikt interne prompts van OpenAI die bedoeld zijn om fouten uit te lokken. Dit zijn door de leverancier gerapporteerde resultaten uit specifieke evaluatieopzetten, geen metingen van jouw productie-workload.
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Vergelijking bij maximale inspanning
Agents’ Last Exam v1
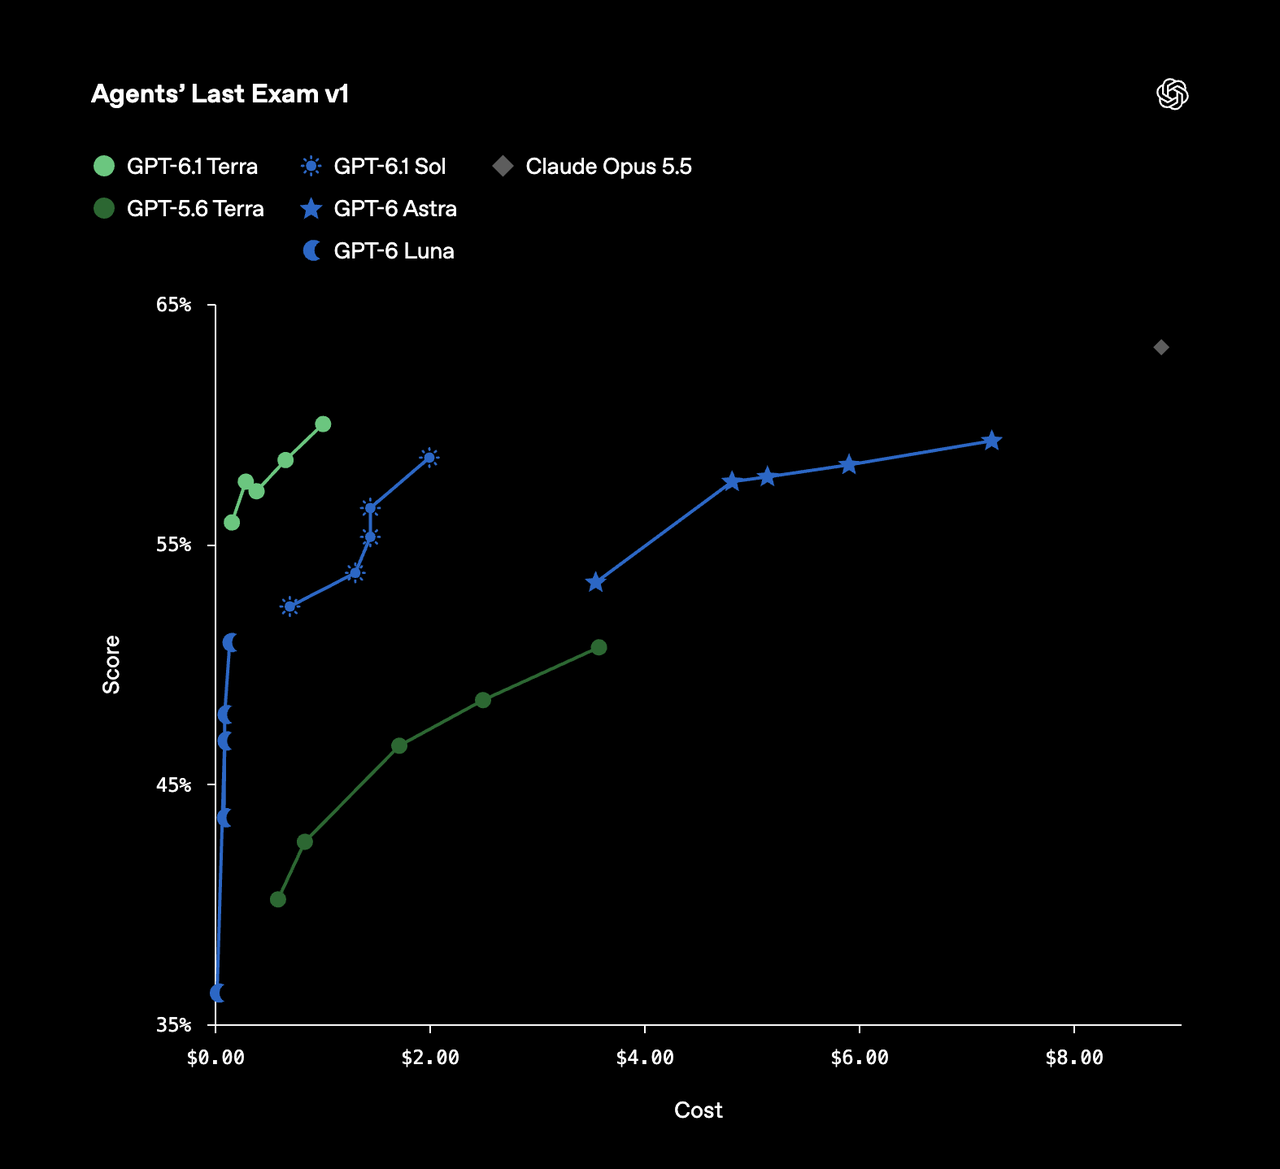
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Factual error rate on difficult prompts
10.10%
4.30%
4.40%
Terra 0.1 pp lager
Alle scores zijn percentages; verschillen worden uitgedrukt in procentpunten (pp). Lager is alleen beter voor de factualiteitsfoutgraad. Het verschil van 0.1 punt in foutgraad op zich vormt geen betekenisvol betrouwbaarheidsvoordeel.
Voor software-engineering suggereren Sol’s voorsprong op Terminal-Bench en Terra’s kleine voorsprong op Terminal-Bench-Science dat resultaten afhangen van het type codingtaak. Voor applicatieworkflows ondersteunt Sol’s hogere OSWorld-score de evaluatie voor desktopautomatisering, terwijl Terra’s Agents’ Last Exam-resultaat het tot kandidaat maakt voor professionele agent-taken. Geen van beide patronen wijst een universele winnaar aan.
Agent-scaffolding, tooltoegang en omgevingsconfiguratie kunnen deze resultaten beïnvloeden. Gebruik de cijfers om kandidaten voor testen te identificeren en valideer ze vervolgens tegen de repositorywijzigingen en applicatieworkflows die je daadwerkelijk moet voltooien.
OpenAI’s Agents’ Last Exam v1-grafiek plaatst scores tegenover geschatte taakkosten over modelconfiguraties. Het voegt een kostenefficiëntieperspectief toe aan de scoretabel hierboven; de geplotte kosten zijn specifiek voor de evaluatieopzet.
Onafhankelijke intelligentie- en codingevaluaties
De evaluatie van Artificial Analysis van 26 oktober plaatst Terra vier punten onder Sol op de Intelligence Index bij maximale redeneringsinspanning. De Coding Agent Index v2.0 geeft Terra 48 en Sol 54. Dit zijn afzonderlijke evaluaties met hun eigen methoden en scoreschalen; ze mogen niet numeriek worden gecombineerd met OpenAI’s benchmarkresultaten.
Dezelfde analyse identificeert Terra’s lage en medium redeneringsinstellingen als bijzonder kostenefficiënt op de intelligentie-evaluatie. Dit ondersteunt het testen van praktische configuraties naast instellingen met maximale inspanning. Evaluatiekosten blijven specifiek voor de testopzet en mogen niet worden behandeld als schattingen van de uitgaven van jouw toepassing.
Snelheid en latency: taakvoltooiing vs. tokenproductie
OpenAI rapporteert dat Terra de geëvalueerde Agents’ Last Exam-taken meer dan drie keer sneller voltooit dan Sol. Dit is een end-to-end taakmeting die redenering en software-interacties omvat. Het impliceert niet een driemaal hogere outputtoken-doorvoer of dezelfde versnelling voor elke API-aanvraag.
Maak voor interactieve applicaties onderscheid tussen time to first token, die de wachttijd meet voordat output begint, en output tokens per second, die meet hoe snel het antwoord doorgaat. Geef voor agents prioriteit aan end-to-end voltooiingstijd, inclusief toolcalls, retries en herstel.
Vergelijk beide modellen met dezelfde prompts, tools, ondersteunde redeneringsinstelling en acceptatiecriteria. Leg latency vast naast taaksucces: een sneller antwoord heeft beperkte waarde als het meer correctie vereist of de workflow niet voltooit.
Visie en long-contextprestaties: wat de resultaten vaststellen
Sol’s voorsprong van 0.8 procentpunt op MMMU-Pro bij maximale inspanning is één gerapporteerd visieresultaat, geen garantie voor betere prestaties in elke visuele workflow. Test kleine labels, slechte scans, dichte diagrammen en onbekende lay-outs met representatieve inputs.
De bovenstaande evaluaties stellen niet vast welk model beter is in long-context retrieval of redenering. Hoewel beide dezelfde gepubliceerde contextcapaciteit hebben, bewijst capaciteit alleen niet de retrievalnauwkeurigheid of het geheugen over sessies. Test of elk model relevante bewijzen in je documenten kan vinden en gebruiken, en onderhoud applicatiestatus expliciet over verzoeken heen.
GPT-6.1 Terra vs GPT-6.1 Sol: Kosten
Tokenprijzen zijn het startpunt voor het vergelijken van kosten. Retries, redeneringstokens, toolcalls en menselijke beoordeling beïnvloeden ook hoeveel je besteedt om een taak succesvol te voltooien.
De volgende tarieven zijn in USD per miljoen tokens en prijzen.
Provider en tokencategorie
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — input
$1.00
$2.00
OpenAI Standard — cached input
$0.05
$0.10
OpenAI Standard — output
$5.00
$10.00
OpenAI Standard — 30-minute cache write
$1.25
$2.50
OpenAI Standard — 12-hour cache write
$2.50
$5.00
CometAPI ordinary input
$0.80
$1.60
CometAPI ordinary output
$4.00
$8.00
OpenAI API-prijzen
Terra’s vermelde Standard-tarieven zijn de helft van die van Sol voor deze categorieën. Werkelijke kosten hangen af van de aanvraagconfiguratie: long-contextaanvragen, verwerkingstiers, regionale verwerking en toolgebruik kunnen andere voorwaarden hebben. Controleer de toepasselijke OpenAI-prijsdocumentatie voordat je productiekosten schat.
CometAPI-prijzen
CometAPI is een externe toegangsroute met eigen prijzen en featurebeschikbaarheid. De vermelde ordinary input- en outputtarieven worden hieronder apart weergegeven.
Tegen deze tarieven liggen CometAPI’s ordinary input- en outputprijzen 20% onder de hierboven vermelde OpenAI Standard-tarieven. Bevestig actuele prijzen, long-contextkosten, cachingondersteuning en toolbeschikbaarheid voor je account voordat je uitrolt.
Voorbeeldkosten voor 1,000 aanvragen
Stel dat een applicatie 1,000 aanvragen doet, elk met 2,000 ongecachete inputtokens en 500 in rekening gebrachte outputtokens. Dit levert in totaal 2 miljoen inputtokens en 500,000 outputtokens op.
Voor 1,000 aanvragen, elk met 2,000 ongecachete inputtokens en 500 in rekening gebrachte outputtokens, zijn de geschatte kosten:
Terra via OpenAI: $2.00 voor input en $2.50 voor output, in totaal $4.50.
Sol via OpenAI: $4.00 voor input en $5.00 voor output, in totaal $9.00.
Terra via CometAPI: $1.60 voor input en $2.00 voor output, in totaal $3.60.
Sol via CometAPI: $3.20 voor input en $4.00 voor output, in totaal $7.20.
Deze berekeningen gebruiken de hierboven vermelde ordinary-tarieven, zonder Batch API-korting. Ze sluiten cachewrites, afzonderlijke toolkosten en retries uit. Eventuele redeneringstokens die als output worden gefactureerd, moeten in het outputtotaal worden opgenomen.
Effectieve kosten per succesvolle taak
In dit artikel is een succesvolle taak er een die de vooraf gedefinieerde kwaliteits-, schema (waar van toepassing) en voltooiingscontroles doorstaat zonder aanvullende menselijke correctie.
Lagere tokenprijzen leveren niet altijd lagere operationele kosten op. Terra’s besparingen kunnen krimpen als meer pogingen, redeneringstokens of menselijke interventie nodig zijn. Sol’s hogere tarieven kunnen de moeite waard zijn als het meer taken in één keer succesvol voltooit.
Effectieve model-en-toolkosten per succesvolle taak = totale model- en tooluitgaven over alle pogingen ÷ aantal succesvolle taken.
Houd kosten voor menselijke beoordeling en correctie apart bij. Kies het model dat je kwaliteitsdoel bereikt tegen de laagste gecombineerde kosten, in plaats van alleen tokenprijzen te vergelijken.
Welk model moet je kiezen: GPT-6.1 Terra of GPT-6.1 Sol?
Kies op basis van taakcomplexiteit, verifieerbare outputkwaliteit en totale voltooiingskosten. Terra is een nuttig startpunt voor routinematige workflows; Sol is het evalueren waard wanneer moeilijke redenering of dure fouten extra uitgaven rechtvaardigen.
Wanneer kiezen voor GPT-6.1 Terra
Begin met Terra voor grootschalige extractie, documentopmaak, catalogusmatching en voorspelbare applicatieworkflows. Deze taken zijn goede kandidaten wanneer resultaten kunnen worden gecontroleerd aan bron documenten, verplichte velden of geautomatiseerde validatieregels.
Kies Terra wanneer het je nauwkeurigheids- en voltooiingsdoelen haalt binnen het toegestane retry- en beoordelingsbudget. Lagere tokenprijzen bieden weinig voordeel als herhaalde fouten de besparingen tenietdoen.
Wanneer kiezen voor GPT-6.1 Sol
Evalueer Sol voor lastig debuggen, repositorywijzigingen met veel afhankelijkheden en desktopworkflows met lange ketens van afhankelijke acties.
Kies Sol wanneer testen aantoont dat het meer geaccepteerde patches produceert, meer tests doorstaat of minder handmatige correctie vereist. De hogere tokenkosten zijn gerechtvaardigd wanneer die verbeteringen de totale kosten van het werk verlagen.
Wanneer eerst Terra gebruiken en opschalen naar Sol
Een hybride workflow kan Terra gebruiken voor de eerste poging en opschalen naar Sol wanneer vooraf gedefinieerde controles falen. Baseer opschaling op observeerbare resultaten in plaats van alleen op het vertrouwen van het model.
Een codegeneratieworkflow kan bijvoorbeeld:
Terra vragen de gevraagde wijziging te produceren.
De relevante tests en validatiecontroles uitvoeren.
Opschalen naar Sol als de wijziging die controles niet doorstaat of buiten Terra’s geverifieerde capaciteit valt.
Onopgeloste gevallen naar menselijke beoordeling sturen zodra het retrybudget uitgeput is.
Bewaar bij opschalen de oorspronkelijke aanvraag, relevante context, mislukte output en validatieresultaten. Registreer het gebruik van beide modellen zodat de kostenvergelijking de volledige workflow omvat.
Checklist voor productie-evaluatie
Voordat je een standaardmodel kiest of een opschalingsworkflow uitrolt:
Gebruik representatieve taken: Neem routinematige verzoeken en gevallen op waar falen duur is.
Houd vergelijkingen gecontroleerd: Gebruik vergelijkbare instructies, bewijs, tools en acceptatiecriteria. Leg model-ID’s, endpoints, redeneringsinstellingen en testdata vast.
Meet geaccepteerde uitkomsten: Controleer nauwkeurigheid, schemavaliditeit (waar van toepassing), testresultaten en voltooiing zonder handmatige correctie.
Meet tijd en uitgaven: Volg mediane en staartlatency, gefactureerde tokens, toolcalls, retries en inspanning voor menselijke beoordeling.
Herhaal de vergelijking: Voer taken meerdere keren uit en wissel de modelvolgorde af om de invloed van eenmalige resultaten te verminderen.
Definieer operationele limieten: Stel retrybudgetten, opschalings-triggers en vereisten voor menselijke goedkeuring vooraf vast.
Vergelijk de volledige workflow: Neem mislukte pogingen en opschalingskosten op bij het berekenen van uitgaven per succesvolle taak.
Waar heb je toegang tot GPT-6.1 Terra en GPT-6.1 Sol?
Officiële provider-toegang
Beide modellen zijn beschikbaar via de OpenAI API. Voor tekstverzoeken wordt Chat Completions ondersteund; tool-calling vereist de Responses API. Bevestig de ondersteunde parameters van het model, je accountlimieten en de beschikbare tools op de route die je wilt gebruiken.
CometAPI-toegang
Om een van beide modellen via CometAPI te gebruiken, volg je de quickstart guide om de OpenAI-compatibele SDK in te stellen. Lever je CometAPI-sleutel veilig aan via de COMETAPI_KEY-omgevingsvariabele en stel de basis-URL in op https://api.cometapi.com/v1. Kies gpt-6.1-terra of gpt-6.1-sol als modelidentifier en bevestig dat de route is ingeschakeld voor je account.
Gebruik voor een eerste vergelijking voor beide modellen dezelfde representatieve taken en medium redeneringsinspanning. Houd de instructies en acceptatiecriteria consistent, herhaal elke taak en wissel de modelvolgorde af. Vergelijk succesvolle resultaten, verstreken tijd, gefactureerde tokens en retries in plaats van een model te beoordelen op basis van één enkele respons.
Conclusie
Begin met GPT-6.1 Terra voor frequente, verifieerbare workflows waarbij lagere tokenprijzen en snellere taakvoltooiing belangrijk zijn. Evalueer GPT-6.1 Sol wanneer moeilijke codering, meerstaps toolgebruik of dure fouten extra redeneringscapaciteit waardevol maken. De uiteindelijke keuze moet gebaseerd zijn op de kosten per geaccepteerde taak onder een representatieve evaluatieset, niet op prijs of één enkele benchmark.
Voor veel applicaties is de nuttige volgende stap een kleine, representatieve proef met duidelijke slaagvoorwaarden en een begrensde opschalingsroute. Laat het gemeten resultaat het model bepalen, in plaats van te vertrouwen op prijs of één enkele benchmark.