Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Grok 4.7 is beschikbaar? 2.1T-model, SpaceX-training en het releasevenster
Grok 4.7 werd gelanceerd op 21 september 2026. Bekijk de programmeerbenchmarks, de verbeteringen ten opzichte van Grok 4.6, de API-tarieven en hoe je toegang krijgt tot het vrijgegeven model.
Grok 4.7-release-update: van voorspellingen naar officiële beschikbaarheid
Informatie gecontroleerd: 16 oktober 2026.
Grok 4.7 werd officieel uitgebracht op 21 september 2026. Eerdere verwijzingen naar een lancering op 12 september waren schattingen vóór release en moeten niet als de daadwerkelijke releasedatum worden beschouwd.
De officiële lanceringsaankondiging beschrijft verbeteringen in coderen, kenniswerk, langer lopende taken en verificatie van de eigen resultaten van het model. De beschikbaarheid via de Grok API, Cursor en Grok Build wordt bevestigd. Voor de exacte API-model-ID, ondersteunde functies, contextlimieten en actuele prijzen, raadpleeg de officiële documentatie van Grok 4.7.
Officiële resultaten tonen meetbare vooruitgang ten opzichte van Grok 4.6. Zo rapporteert de lanceringsvergelijking een Terminal-Bench 4.0-score van 37,6% voor Grok 4.7 bij xhigh effort, vergeleken met 20,3% voor Grok 4.6 bij high effort. Dit zijn door de aanbieder gerapporteerde resultaten onder de genoemde evaluatie-instellingen; de prestaties in toepassingen hangen af van prompts, tools, reasoning effort en taakmoeilijkheid.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Voor ontwikkelaars is de nuttige vraag nu of Grok 4.7 hun workloads betrouwbaarder en economischer voltooit. Test het op repository-wijzigingen, documentcreatie en meerstaps tool-workflows, en meet succesvolle afronding, latentie, retries en totale taakkosten.
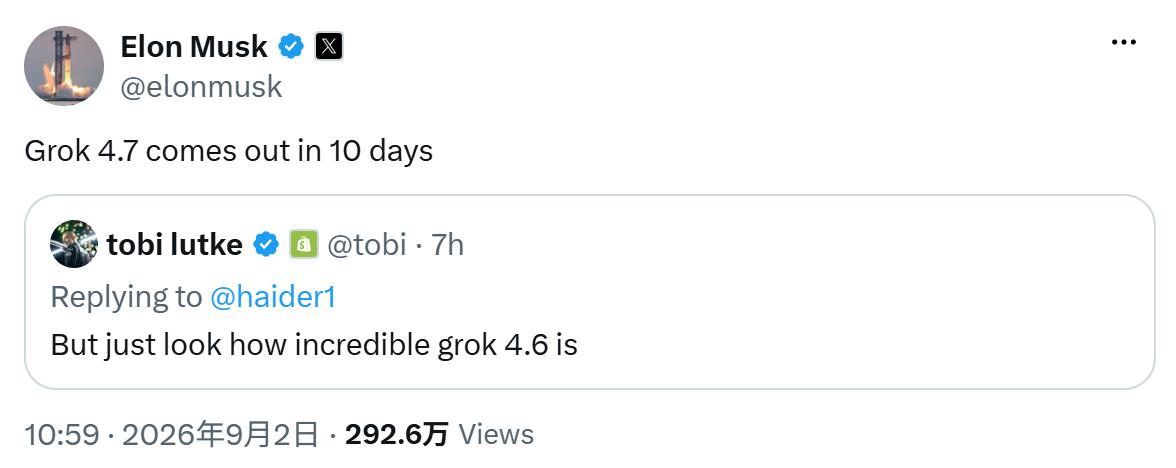
De verwachte datum van 12 september is afgeleid van Musks aftelling van tien dagen, niet van een afzonderlijk door xAI gepubliceerd kalenderbericht.
De uitspraken over 2.1T-schaal en SpaceX-gegevens zijn claims vóór release; actieve parameters, routing, architectuur en trainingsmethodologie zijn niet gepubliceerd.
Grok 4.6 laat al sterke kenniswerk- en agent-capaciteiten zien, waaronder 61,3% op FrontierCode v1.1 (Extended), maar het blijft achter bij het sterkste vergelijkingsmodel op enkele moeilijke code-evaluaties.
Grok 4.7 moet worden beoordeeld op acceptatiegraad voor taken, langetermijnbetrouwbaarheid, token-efficiëntie, latentie en kosten per succesvol resultaat—niet alleen op het aantal parameters.
CometAPI zal Grok 4.7 integreren zodra xAI het model officieel vrijgeeft en er productie-endpointtoegang beschikbaar is; ontwikkelaars dienen de live model-ID, prijs en responsgedrag te valideren vóór migratie.
Wat is Grok 4.7?
Grok 4.7 is de aangekondigde opvolger van Grok 4.6 en zal naar verwachting xAI’s focus op coderen, engineering, langlopende agents en professioneel kenniswerk voortzetten. Het publieke bewijs bestaat momenteel uit uitspraken van oprichters en een lanceringsaftelling in plaats van een volledig technisch launch-pakket.
Het belangrijkste onderscheid is tussen drie zaken: het aangekondigde Grok 4.7-model, de pre-release-signalen die de mogelijke schaal en training beschrijven, en de live Grok 4.6-productiebasislijn. Ontwikkelaars moeten Grok 4.7 behandelen als een aanstaande evaluatiekandidaat totdat xAI definitieve documentatie publiceert en een productieverzoek slaagt tegen het vrijgegeven endpoint.
Releasedatum en tijdlijn van Grok 4.7
Wanneer wordt Grok 4.7 verwacht te worden uitgebracht?
Musks verklaring van 2 september dat het model over tien dagen zou komen wijst op ongeveer 12 september 2026
Musk beschreef een model van ongeveer 2.1T, verbeterde token-efficiëntie en enigszins tragere verwerking.
Door oprichter gestelde verwachtingen over modelschaal en efficiëntie.
12 augustus 2026
Initiële training werd als voltooid beschreven; aanvullende training omvatte naar verluidt substantiële SpaceX-data.
Een update over trainingsvoortgang, geen bevestiging van release.
2 september 2026
“Grok 4.7 komt over 10 dagen uit.”
Tot dusver de duidelijkste publieke lanceringsaftelling.
12 september 2026
Kalenderdatum afgeleid van de aftelling.
Verwachte target; definitieve beschikbaarheid vereist nog een xAI-releasemelding en een werkend endpoint.
Grok 4.7-specificaties: bevestigde vs. onbevestigde informatie
De meest nuttige manier om huidige informatie over Grok 4.7 te lezen is om directe uitspraken van de oprichter te scheiden van specificaties die xAI niet heeft gepubliceerd. De nieuwe post bevestigt alleen de modelnaam en een lanceringsaftelling; er worden geen technische parameters of benchmarkresultaten toegevoegd.
Specificatie
Huidige status van Grok 4.7
Bewijsniveau
Release-timing
Rond 12 september, afgeleid van de aftelling van tien dagen op 2 september
Door oprichter aangekondigde doelstelling
Model-schaal
Ongeveer 2.1T parameters
Door oprichter gesteld
Initiële training
Beschreven als voltooid op 12 augustus
Door oprichter gesteld
Aanvullende training
Bevat substantiële SpaceX-bedrijfsgegevens
Door oprichter gesteld
Relatieve kwaliteit
Aangegeven als significant beter dan Grok 4.6
Niet-geverifieerde claim
Token-efficiëntie
Aangegeven verbetering ten opzichte van Grok 4.6
Niet-geverifieerde claim
Verwerkingssnelheid
Verwacht enigszins trager te zijn
Door oprichter gesteld
Contextvenster
Niet gepubliceerd door xAI
Onbekend
In-/outputmodaliteiten
Niet gepubliceerd door xAI
Onbekend
Definitieve API-model-ID
Niet bevestigd in xAI-documentatie
Onbekend
Officiële prijzen
Niet gepubliceerd door xAI
Onbekend
Officiële benchmarks
De claim van ongeveer 2.1T parameters onthult geen actieve parameters, sparsity, expert-routing, inferentiekosten of effectieve trainingscompute. Het aantal parameters alléén kan de kwaliteit in productie niet bepalen.
Waarom het SpaceX-trainingssignaal mogelijk belangrijker is dan 2.1T
De meer verstrekkende onthulling kan de aanvulling met SpaceX-bedrijfsgegevens zijn. Een hoogwaardige engineeringscorpus kan technisch redeneren, ontwerp, debuggen, optimalisatie en langlopende agentwerkzaamheden verbeteren, waar taakverdeling en kwaliteit na training vaak zwaarder wegen dan ruwe schaal.
Deze richting is consistent met xAI’s strategie met vrijgegeven modellen. Het Grok 4.6-trainingsrapport beschrijft een langere aanvullende trainingsrun met hoogwaardige engineeringdata, gevolgd door gesuperviseerde fine-tuning en reinforcement learning op het gebied van coderen, STEM, webontwikkeling, kerneloptimalisatie en computer-aided design.
Dat maakt de Grok 4.7-claim technisch plausibel, niet bewezen. Een echt voordeel zou na release zichtbaar moeten worden in reproduceerbare engineeringtests, taakvoltooiingspercentages, latentie en kosten per succesvol resultaat.
Grok 4.7 vs Grok 4.6-prestaties: wat de basislijn laat zien
Er bestaan nog geen officiële scores voor Grok 4.7. Het verantwoordelijke vergelijkingspunt is xAI’s vrijgegeven evaluatie van Grok 4.6. Het volledige modeloverzicht staat in CometAPI’s Grok 4.6 deep dive; de onderstaande tabel behoudt alleen de meest beslissingsrelevante benchmarkrijen.
Officiële evaluatie
Grok 4.6 High
Grok 4.5 High
GPT-5.6 Sol Max
Claude Fable 5 Max
AA Intelligence Index
61
56
61
62
GDPVal-AA v2
1753
1526
1728
1741
CursorBench v3.2
69.9%
66.7%
67.2%
70.5%
DeepSWE v1.1
65.9%
54.0%
73.0%
70.0%
FrontierCode v1.1 (Extended)
61.3%
56.6%
60.6%
63.6%
Terminal-Bench v3.0
26.0%
15.7%
34.6%
34.1%
Basislijnresultaat: Grok 4.6 toont een echt voordeel ten opzichte van Grok 4.5 in elke getoonde rij. Het evenaart GPT-5.6 Sol op de algemene intelligentie-index, leidt deze groep op GDPVal-AA v2 en ligt nipt vóór GPT-5.6 Sol op FrontierCode. De belangrijkste gepubliceerde hiaten blijven DeepSWE en Terminal-Bench.
Deze resultaten stellen een concreet referentiepunt voor Grok 4.7. Als het grotere model en de engineeringgerichte aanvullende training doorwerken in productie, zou de doorbraak sterker repository-niveau coderen en terminal-taakvoltooiing zijn zonder de kenniswerksterkte van Grok 4.6 te verliezen. Een geloofwaardig stretchdoel is concurrerend worden met de vrijgegeven Claude Fable 5.1 op coderen en langlopende agent-workflows. Dat is een voorspelling om te testen, geen huidige benchmarkclaim.
Grok 4.7 vs Grok 4.6 : verwachte doorbraken en upgrade-advies
De gelekte en door de oprichter genoemde signalen suggereren vijf gebieden waarop Grok 4.7 kan verbeteren. Omdat xAI geen definitieve evaluatiedata heeft gepubliceerd, moet elke verwachting worden vertaald naar een meetbare acceptatietest.
Coderen op repository-niveau
Grok 4.6 is al sterk op CursorBench en FrontierCode, maar de resultaten op DeepSWE en Terminal-Bench laten duidelijk verbeteringsruimte. Grok 4.7 moet een hogere patch-acceptatie, minder regressies en betere commandline-herstelcapaciteit tonen op dezelfde repositories voordat het 4.6 vervangt.
Betrouwbaarheid van agents op lange horizon
Het SpaceX-gegevenssignaal en xAI’s bestaande agent-trainingsrichting duiden op focus op meerfasig engineeringwerk. Meet voltooide workflows, mislukte tool-aanroepen, retries, menselijke interventies en herstel na fouten—niet alleen de kwaliteit van de uiteindelijke tekst.
Kenniswerk en technisch redeneren
Grok 4.6 leidt de vergelijkingsset al op GDPVal-AA v2. Grok 4.7 moet dat voordeel behouden en de transfer naar design reviews, onderzoeksynthese, debuggen, optimalisatie en andere complexe technische taken verbeteren.
Token-efficiëntie
Een groter model kan per succesvolle taak nog steeds goedkoper zijn als het in minder stappen correcte uitkomsten behaalt. Vergelijk totale input, gecachte input, outputtokens, retries en kosten voor hetzelfde geaccepteerde resultaat.
Trade-offs in bediening
Als Grok 4.7 trager is, moeten kwaliteitswinsten de latentie compenseren. Noteer time-to-first-token, duurzame throughput, totale doorlooptijd, foutpercentage en kosten bij realistische gelijktijdigheid.
Grok 4.7-benchmarks: 5 tests om een echte upgrade ten opzichte van Grok 4.6 te verifiëren
Succes in software-engineering: meet opgeloste issues, geslaagde tests, regressiepercentage en patch-acceptatie op representatieve repositories.
Betrouwbaarheid van agents op lange horizon: volg voltooide workflows, mislukte tool-aanroepen, retries, herstel en menselijke interventies bij meerstapsruns.
Overdracht naar echte engineeringtaken: test ontwerp, debuggen, optimalisatie, wetenschappelijk redeneren en CAD-gerelateerde taken met bekendgemaakte beoordelingscriteria.
Token-efficiëntie per succesvol resultaat: vergelijk het totale aantal tokens en de uitgaven die nodig zijn om dezelfde geaccepteerde uitkomst te bereiken.
Latentie en kosten onder productielast: evalueer time-to-first-token, throughput, doorlooptijd, foutpercentage en kosten bij realistische gelijktijdigheid.
Wat ontwikkelaars vóór 12 september moeten doen—en hoe CometAPI past
Pre-launch-checklist voor ontwikkelaars
Bouw een vaste evaluatieset op basis van echt coderen, onderzoek, engineering en agent-workflows.
Voer die uit tegen Grok 4.6 en registreer succesratio, retries, tool-aanroepen, latentie, tokens en totale kosten.
Houd modelselectie configureerbaar en hardcode geen voorlopige Grok 4.7-identificator.
Volg de xAI-releasenotes en de CometAPI-modelpagina voor bevestigde beschikbaarheid.
Verifieer na lancering context, modaliteiten, instellingen voor redeneren, prijzen, ratelimieten en uitrolomvang.
Speel dezelfde evaluatieset opnieuw af vóór het verschuiven van productie-verkeer.
CometAPI biedt een uniforme API-laag om toegang te krijgen tot meerdere AI-modelproviders via één account en integratiepatroon. Er is al een Grok 4.7-volgpagina beschikbaar. CometAPI zal Grok 4.7 integreren zodra xAI het model officieel vrijgeeft en productie-toegang beschikbaar is.
Tot dat moment moet elke voorlopige identificator, prijs of capaciteitsveld als voorlopig worden behandeld. Bevestig vóór het sturen van productie-verkeer dat de route live is, een echt verzoek slaagt, het geretourneerde model de bedoelde versie is en de actuele prijzen zichtbaar zijn in de console.
Prijsverwachting voor Grok 4.7 versus Grok 4.6
Het gepubliceerde standaardtarief voor Grok 4.6 is $2 per 1 miljoen inputtokens en $6 per 1 miljoen outputtokens onder de lang-contextdrempel. De releasenotes van xAI vermelden hogere tarieven voor verzoeken boven 200.000 prompttokens. Prijzen voor Grok 4.7 zijn nog niet officieel aangekondigd.
Gepubliceerde prijsbasis
Input / 1M
Output / 1M
Status
Grok 4.6, prompt onder 200K
$2
$6
Gepubliceerd
Grok 4.6, prompt boven 200K
$4
$12
Gepubliceerde lang-contextlaag
Grok 4.7
Niet aangekondigd
Niet aangekondigd
Bevestigen na officiële lancering
Drie prijsrichtingen blijven plausibel: pariteit met Grok 4.6 om adoptie te versnellen, een premiumlaag als de bedieningskosten materieel hoger zijn, of gescheiden tarieven naar contextlengte en snelheid. Dit zijn planningsscenario’s, geen xAI-voorspelling.
Pre-launch-checklist voor ontwikkelaars
Bouw een vaste evaluatieset op basis van echt coderen, onderzoek, engineering en agent-workflows.
Voer die uit tegen Grok 4.6 en registreer succesratio, retries, tool-aanroepen, latentie, tokens en totale kosten.
Houd modelselectie configureerbaar en hardcode geen voorlopige Grok 4.7-identificator.
Volg de xAI-releasenotes en de CometAPI-modelpagina voor bevestigde beschikbaarheid.
Verifieer na lancering context, modaliteiten, instellingen voor redeneren, prijzen, ratelimieten en uitrolomvang.
Speel dezelfde evaluatieset opnieuw af vóór het verschuiven van productie-verkeer.
Grok 4.7: wat nu in de gaten houden
Vier gebeurtenissen zouden de huidige aftelling veranderen in een verifieerbare productlancering: een officiële xAI-releasepost; modeldocumentatie over context, modaliteiten en instellingen voor redeneren; definitieve API-prijzen en modelidentificatoren; en reproduceerbare benchmark- of productie-evaluaties.
De meest nuttige lanceringsvraag is niet of 2.1T groot klinkt. Het is of Grok 4.7 moeilijke engineering- en agenttaken betrouwbaarder voltooit—en tegen betere kosten per succesvol resultaat—dan de vrijgegeven basislijn.
Veelgestelde vragen
Wanneer wordt Grok 4.7 verwacht te worden uitgebracht?
Musks aftelling van tien dagen op 2 september wijst op ongeveer 12 september 2026. Dit is een afgeleid doel, geen afzonderlijk door xAI gepubliceerde kalenderdatum.
Is Grok 4.7 al gelanceerd?
Grok 4.7 is publiekelijk geteased/aangekondigd maar heeft nog geen volledige officiële API-/modeldocumentatierelease ontvangen.
Is Grok 4.7 een model met 2,1 biljoen parameters?
Musk heeft het beschreven als ongeveer 2.1T parameters. xAI heeft nog geen architectuurdocument gepubliceerd dat actieve parameters of routingdetails bevestigt.
Zal Grok 4.7 beter zijn dan Grok 4.6?
Musk heeft een substantiële verbetering geclaimd, maar er bestaat geen officiële benchmarktabel voor Grok 4.7. Behandel de claim als niet-geverifieerd totdat reproduceerbare resultaten beschikbaar zijn.
Zal Grok 4.7 beschikbaar zijn via CometAPI?
Er bestaat al een CometAPI-volgpagina, maar definitieve beschikbaarheid, identificator, prijzen en ondersteunde formaten moeten na de officiële lancering worden bevestigd.
Conclusie
Het verhaal rond Grok 4.7 is verschoven van een brede schatting begin september naar een concrete aftelling. Musks laatste verklaring wijst op ongeveer 12 september 2026, terwijl eerdere posts een model van ongeveer 2.1T en aanvullende training met substantiële SpaceX-bedrijfsgegevens beschrijven.
Dat zijn ongebruikelijk specifieke signalen vóór release, maar het zijn geen modelkaart, benchmarkpakket of API-contract. Ontwikkelaars moeten Grok 4.6 als meetbare basislijn houden, nu een gecontroleerde evaluatie voorbereiden, en wachten tot xAI en CometAPI productie-toegang bevestigen voordat er beslissingen over migratie of budget worden genomen.