Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Hoe voer je DeepSeek-V4.1-Flash lokaal uit met vLLM, inclusief GPU-vereisten, checkpoint-grootte van 511 GB, setup-commando's, SGLang, Ollama en API-alternatieven.
Deon GoodwinOnderzoeksteam voor AI-modellen en API
DeepSeek-V4.1-Flash is open-weight en kan zelf worden gehost, maar “lokaal” betekent niet “op een gaming-pc”. DeepSeek beschrijft het als een 552B-parameter Mixture-of-Experts-backbone met een Causal Encoder-Decoder-architectuur, met slechts 8B parameters actief tijdens prefill en 16B tijdens generatie. Het volledige model blijft een deploymentdoel op frontier-schaal.
Het huidige vLLM-implementatierecept plaatst het checkpoint op ongeveer 511 GB op schijf en circa 614 GB minimale VRAM, waardoor een server van de klasse 8×H200 of een vergelijkbaar systeem met veel geheugen veel realistischer is dan een consumentenwerkstation.
Voor teams die alleen toegang nodig hebben en geen controle op gewichten-niveau, is de DeepSeek V4.1 Flash API in CometAPI aanzienlijk eenvoudiger dan het onderhouden van een multi-GPU-inferenceserver.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Belangrijkste punten
DeepSeek-V4.1-Flash gebruikt een 552B MoE-backbone met 8B actieve parameters tijdens prefill en 16B tijdens decode; actieve parameters vertegenwoordigen niet de resident-geheugenvereiste.
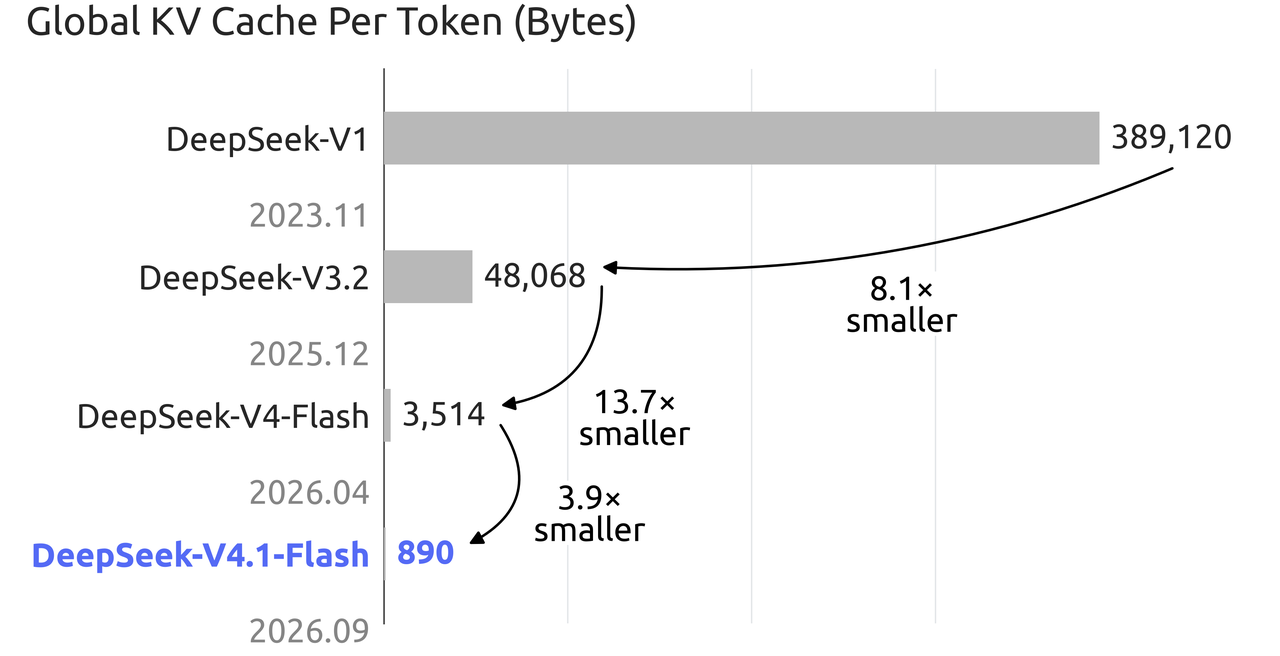
Het contextvenster van 1.048.576 tokens en de globale KV-cache van 890 bytes per token verminderen de cachedruk, maar de modelgewichten domineren nog steeds de capaciteitsplanning.
Het officiële checkpoint is ongeveer 511 GB op schijf. Het vLLM-recept schat ongeveer 614 GB geaggregeerde bruikbare VRAM als het minimale budget voor het laden van het model plus runtime-overhead; dit is een basisinschatting, geen garantie voor elke batchgrootte, contextlengte of multimodale configuratie.
vLLM is het duidelijkste pad voor productie-serving, terwijl SGLang zich richt op geavanceerde gedistribueerde inferentie; de huidige route van Ollama is cloud-gehost in plaats van volledig lokale inferentie.
Zelf hosten is vooral overtuigend voor privacy, air-gapped gebruik, onderzoek op gewichten-niveau of duurzame clusterbenutting; de meeste ontwikkelaars zullen een gehoste API eenvoudiger vinden.
Wat is DeepSeek-V4.1-Flash? Architectuur, parameters en modelgrootte
DeepSeek heeft V4.1-Flash officieel uitgebracht op 10 september 2026 als het kleinste model in zijn nieuwe architectuurfamilie, met native visueel begrip. Ondanks de “Flash”-naam is het geen klein, dense model.
De belangrijkste architecturale verandering is het Causal Encoder-Decoder (CED)-ontwerp. Het model verdeelt de berekening asymmetrisch tussen promptinname en tokengeneratie, waardoor actieve compute afneemt terwijl een zeer grote expertenpool behouden blijft.
Specificatie
DeepSeek-V4.1-Flash
Architectuur
Multimodaal MoE met Causal Encoder-Decoder
Backbone-parameters
552B
Actieve parameters, input
8B
Actieve parameters, output
16B
Transformer-lagen
40: 20 encoder + 20 decoder
Contextvenster
1.048.576 tokens
Globale KV-cache
890 bytes/token
Modaliteiten
Tekst + afbeeldingsinput, tekstoutput
Licentie voor gewichten
MIT
Aanbevolen sampling
Temperature 1.0; top_p 0.95 of 1.0
Officiële gewichten
Hugging Face
Primaire lokale serveeropties
vLLM, SGLang, DeepSeek-referentie-inferentie
Het onderscheid tussen actieve parameters en resident parameters is essentieel. MoE-routing vermindert de hoeveelheid berekening per token, maar de server heeft nog steeds toegang nodig tot de expertgewichten die geselecteerd kunnen worden. Daarom kan een model met “8B actief” nog steeds honderden gigabytes aan opslag en acceleratorgeheugen vereisen.
DeepSeek’s officiële KV-cachegrafiek toont de globale cache die daalt van 3.514 bytes per token in V4 Flash naar 890 bytes per token in V4.1 Flash, een afname van ongeveer 3,9×. Dat is relevant voor inferentie met een miljoen tokens, maar het elimineert niet de veel grotere geheugenvereiste die door de modelgewichten zelf wordt gecreëerd.
Hoe goed is DeepSeek-V4.1-Flash voordat u het uitrolt?
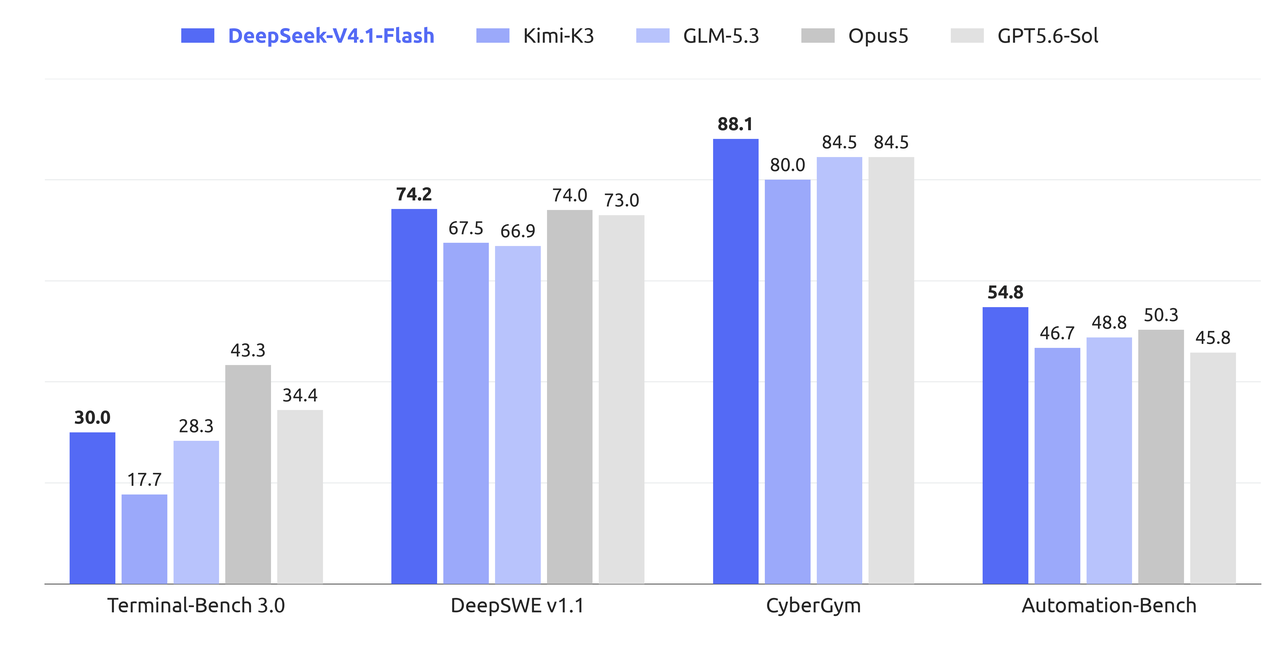
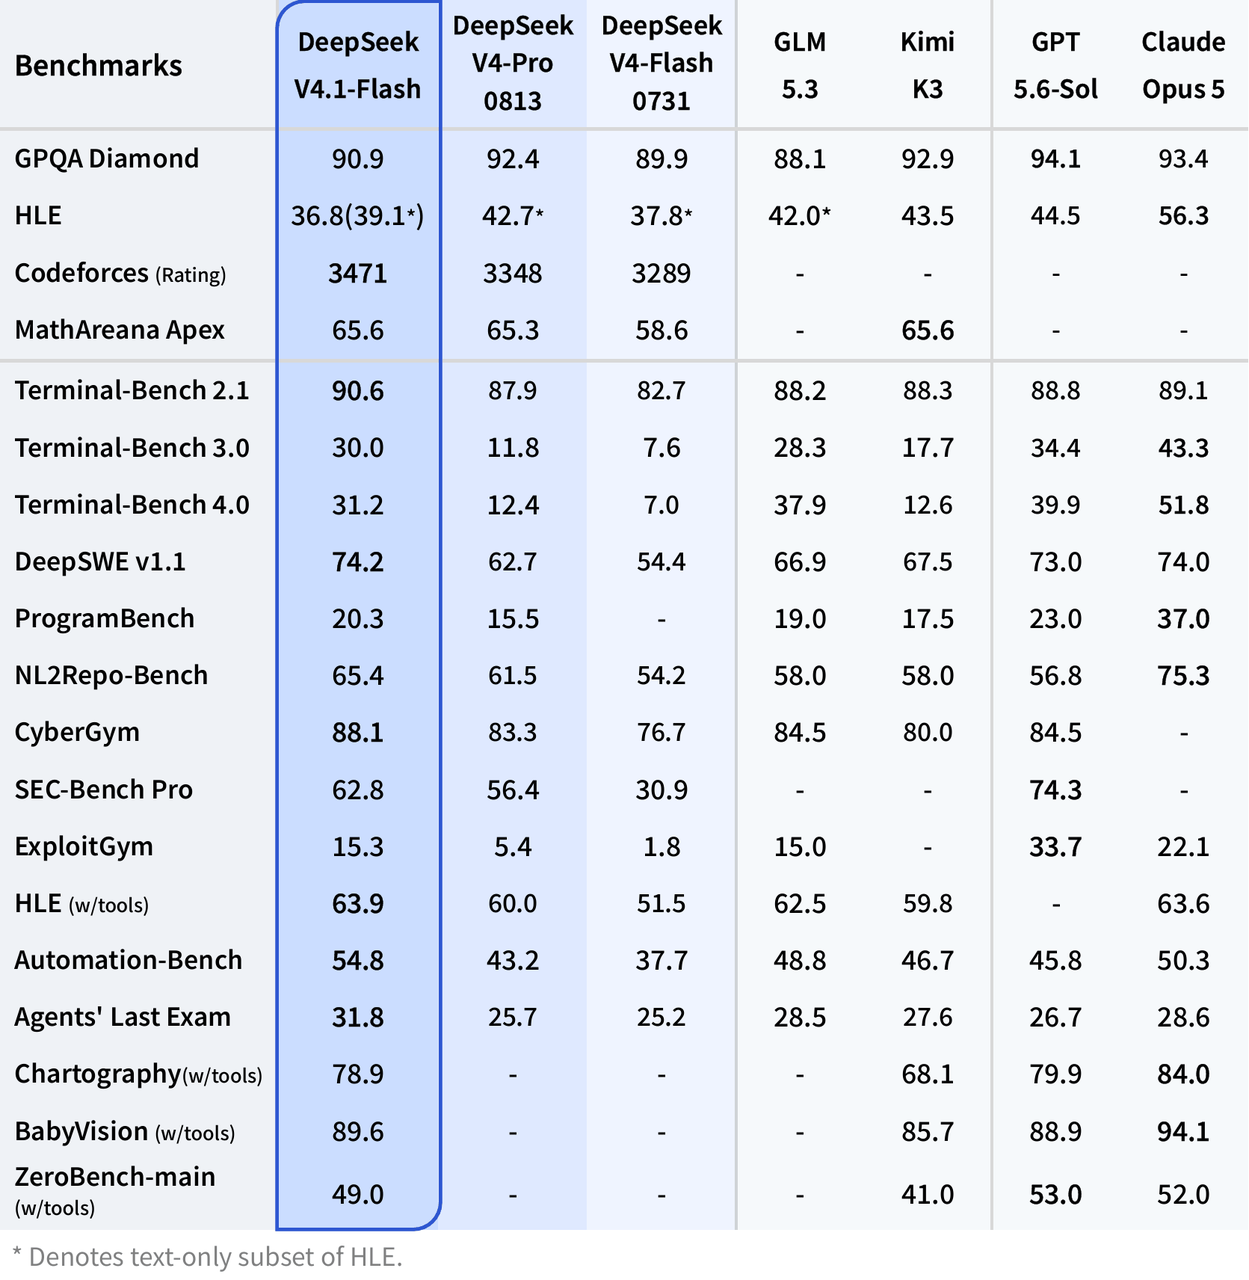
DeepSeek’s gepubliceerde benchmarktabel positioneert V4.1-Flash primair als een grote upgrade in agent-gestuurde coding, terminalbediening, automatisering en software-engineeringworkloads. Dit zijn door de leverancier gerapporteerde benchmarkresultaten, dus ze moeten worden beschouwd als referentiemetingen en niet als gegarandeerde applicatieprestaties.
Voor reproduceerbaarheid beveelt de officiële modelkaart temperature 1.0 en top_p 0.95 aan, terwijl de reasoning-inspanning en tokenbudgetten per evaluatie variëren. De cijfers hieronder zijn door de leverancier uitgevoerde referentieresultaten, geen hardware-neutrale prestatiegaranties; benchmark-specifieke harnessdetails moeten worden geraadpleegd voordat u ze reproduceert.
Benchmark
DeepSeek V4.1 Flash
DeepSeek V4 Pro 0813
DeepSeek V4 Flash 0731
GPQA Diamond
90.9
92.4
89.9
Codeforces Rating
3471
3348
3289
MathArena Apex
65.6
65.3
58.6
Terminal-Bench 2.1
90.6
87.9
82.7
Terminal-Bench 3.0
30.0
11.8
7.6
Terminal-Bench 4.0
31.2
12.4
7.0
DeepSWE v1.1
74.2
62.7
54.4
NL2Repo-Bench
65.4
61.5
54.2
CyberGym
88.1
83.3
76.7
Automation-Bench
54.8
43.2
37.7
Agents' Last Exam
31.8
25.7
25.2
Het patroon is belangrijker dan één enkele score. V4.1-Flash leidt niet elke benchmark, maar de sprong ten opzichte van V4 Flash 0731 is vooral groot bij Terminal-Bench, DeepSWE, automatisering en cybersecurityworkloads. Dit maakt lokale implementatie bijzonder relevant voor private codingagents, analyse op repository-schaal, interne automatisering en air-gapped agentinfrastructuur.
Kunt u DeepSeek-V4.1-Flash echt lokaal draaien?
Ja, maar het woord “lokaal” behoeft kwalificatie. Het nieuwste vLLM-recept voor DeepSeek-V4.1-Flash splitst het checkpoint op in ongeveer een halve terabyte en raadt een veel groter VRAM-budget aan zodra runtime-overhead is meegerekend.
Component
Geschatte opslaggrootte
Routed + DSpark-experts
259,5 GiB
Engram-tabellen
183,1 GiB
Attention, dense projecties en routers
6,9 GiB
Embeddings, LM-head en normalisaties
3,9 GiB
UE8M0-blokschalen
21,9 GiB
Volledige checkpoint
~476 GiB / ~511 GB
Door vLLM aanbevolen minimale VRAM-budget
~614 GB
De belangrijkste verrassing is dat V4.1-Flash intern al zwaar gecomprimeerd is. Gewichten van routed experts gebruiken lage-precisieformaten, dus het officiële checkpoint is niet simpelweg een enorm BF16-model dat wacht op een gemakkelijke 4-bitconversie.
DeepSeek-V4.1-Flash hardwarevereisten
Hardwareconfiguratie
Praktische status
Opmerkingen
1× RTX 4090 / 5090
Nee
Ver onder de geheugenvraag van het model
2–4 consumentengpu’s
Nee voor het officiële volledige checkpoint
Geaggregeerde VRAM blijft onvoldoende
128 GB-werkstation
Nee
Actieve parameters bepalen niet het resident geheugen voor de gewichten
256 GB-werkstation
Nee voor officiële serving-route
Nog altijd ruim onder de footprint van het officiële checkpoint
512 GB systeem-RAM + GPU-offload
Experimenteel
Community-/offloadgebied, niet gelijk aan geverifieerde productie-serving
4× datacenter-gpu’s met veel geheugen
Hardware-afhankelijk
Mogelijk met voldoende grote moderne accelerators; controleer het runtimerecept
8× H200
Ja, gedocumenteerde klasse
Rond 1,128 GB geaggregeerde HBM
GB200 NVL4-klasse systeem
Ja
vLLM noemt een tray van 768 GB als passend voor het model
Belangrijk: 8B actieve parameters betekent niet 8 GB VRAM. “Actief” beschrijft hoeveel van het MoE-netwerk deelneemt aan de berekening per token. De volledige expertset moet nog steeds ergens worden opgeslagen en toegankelijk zijn voor de inferentie-engine.
Welke runtime moet u gebruiken voor DeepSeek-V4.1-Flash?
Ondersteund via huidige DeepSeek-V4.1-implementatiebuilds
Hogeprestatie-gedistribueerde inferentie
DeepSeek reference inference
Officiële TP8-referentie-implementatie
Architectuuronderzoek en validatie
Transformers
Modelintegratie beschikbaar op Hugging Face
Ontwikkeling en experimenten; hardware nog steeds vereist
Ollama
Officiële library-route gebruikt momenteel :cloud
Handige cloud-aanroep, niet gelijk aan zelfhosten
Voor productie-zelfhosting is vLLM momenteel het duidelijkste startpunt. SGLang-deploymenteleidraad biedt een ander ondersteund pad voor geavanceerde gedistribueerde inferentie.
Hoe draait u DeepSeek-V4.1-Flash lokaal met vLLM?
Dit is de praktische route voor een multi-GPU Linux-server. Alle onderstaande commando-voorbeelden zijn opnieuw geformatteerd als taalspecifieke codeblokken met beknopte Engelse beschrijvingen.
Stap 1: Controleer uw omgeving
Linux.
Docker.
NVIDIA Container Toolkit.
Enkele honderden gigabytes vrije SSD-ruimte.
Een ondersteunde multi-GPU-configuratie.
Ongeveer 614 GB geaggregeerd bruikbaar acceleratorgeheugen voor het huidige officiële gewichtsprofiel.
Een snel netwerk als het model niet al lokaal in cache staat.
Stap 2: Download de DeepSeek-V4.1-Flash-gewichten
De officiële gewichten worden gehost in de DeepSeek-V4.1-Flash Hugging Face-repository onder de MIT-licentie.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Zorg dat het bestandssysteem waarop ~/.cache/huggingface staat aanzienlijk meer dan 511 GB vrij heeft. Tijdelijke bestanden en extra engine-artefacten kunnen de piekschijfgebruik verhogen.
Stap 3: Start DeepSeek-V4.1-Flash met vLLM
Volgens het huidige vLLM-recept vereist DeepSeek-V4.1-ondersteuning een voldoende recente vLLM-image. Een tekst-only startconfiguratie met acht GPU’s kan er zo uitzien:
Er zijn hier twee bewuste keuzes. Ten eerste schakelt --language-model-only de vision-encoder uit voor tekst-only workloads. Ten tweede is starten op 131.072 tokens veiliger dan meteen het volledige contextvenster van één miljoen tokens inschakelen. Zodra de server stabiel is, kunt u dit verhogen:
--max-model-len 1048576
De juiste instelling voor tensor-parallelisme hangt af van de accelerator-topologie; kopieer --tensor-parallel-size 8 dus niet blind naar elke server.
Stap 4: Test het lokale DeepSeek-V4.1-Flash-endpoint
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Stap 5: Roep uw lokale DeepSeek-V4.1-Flash-server aan met Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Hoe schakelt u lokaal de denkmodus van DeepSeek-V4.1-Flash in?
V4.1-Flash ondersteunt expliciete reasoning-regelaars via zijn chattemplate. Een voorbeeld:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Als het model weinig of geen finale content lijkt te retourneren met een kleine waarde voor max_tokens, controleer dan of de denkmodus het generatiebudget verbruikt voordat u aanneemt dat de deployment defect is.
Hoe draait u DeepSeek-V4.1-Flash met referentiecode?
DeepSeek bevat ook een minimale TP8-inferentie-implementatie in de modelrepository. Die is primair bedoeld als leesbare referentiecode en niet als een high-throughput productieserver.
cd inference
python -m pip install -r requirements.txt
Deze route is nuttig om CED, MoE-routing, Engram-geheugen, speculatieve decodering en aanverwante implementatiedetails te inspecteren. Voor normale productie-serving zijn vLLM of SGLang eenvoudiger te bedienen.
Kunt u DeepSeek-V4.1-Flash lokaal draaien met Ollama?
Niet in dezelfde zin als het draaien van een normaal 7B- of 32B-Ollama-model. Ollama stelt V4.1-Flash momenteel beschikbaar via:
ollama run deepseek-v4.1-flash:cloud
Het belangrijke deel is :cloud. De huidige Ollama-bibliotheekvermelding gebruikt een cloud-route, dus dit commando is niet gelijk aan het downloaden van de volledige modelgewichten en het volledig op uw eigen machine uitvoeren van inferentie.
DeepSeek-V4.1-Flash lokaal deployen vs API: wat is logischer?
Dimensie
Lokale DeepSeek-V4.1-Flash
Gehoste API
Initiële hardware
Zeer hoog
Geen
Acceleratormemory
~614 GB praktisch officieel doel
Beheerd door aanbieder
Modelcontrole
Volledig
Beperkt
Data blijft on-prem
Ja
Nee
Gewichten wijzigen
Ja
Nee
Onderhoud
Uw verantwoordelijkheid
Door de aanbieder beheerd
Opzetcomplexiteit
Hoog
Laag
Schalen
Vereist infrastructuur
API-gestuurd
Best voor
Air-gapped, privaat, onderzoek, clusters met hoge bezetting
De meeste ontwikkelaars en productie-apps
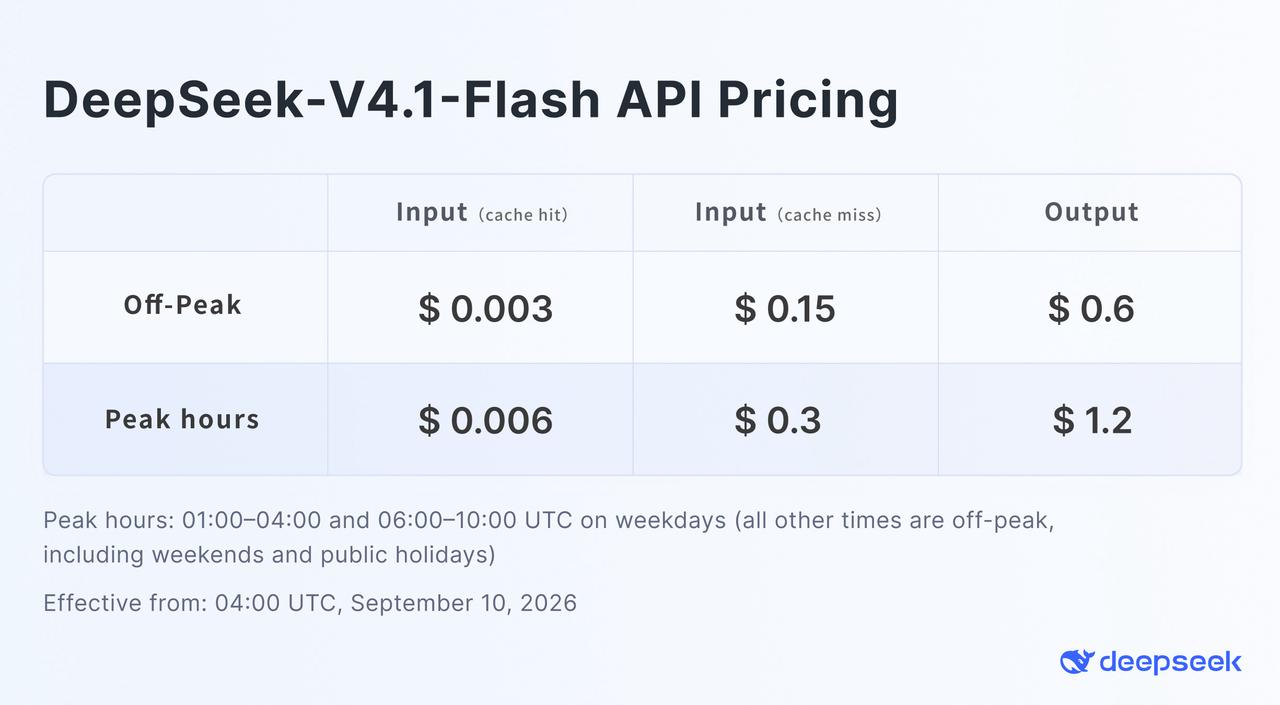
DeepSeek’s officiële off-peak-prijzen worden getoond in de V4.1-Flash-prijsgrafiek. Voor ontwikkelaars die de gewichten niet fysiek hoeven te bezitten, biedt de DeepSeek V4.1 Flash API in CometAPI een OpenAI-compatibel alternatief.
Het volgende voorbeeld gebruikt de modelidentifier van CometAPI. Dit is niet de identifier die door de officiële API van DeepSeek wordt gebruikt.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
De praktische beslissing is eenvoudig: lokale deployment wordt overtuigend wanneer privacy, air-gapped gebruik, experimenten op gewichten-niveau, voorspelbare zware benutting of regelgeving zwaarder wegen dan infrastructuurkosten. Voor gewone applicatieontwikkeling vermijdt een gehoste endpoint honderden gigabytes aan modelbeheer en multi-GPU-orkestratie.
Welke problemen kunt u tegenkomen bij lokaal draaien van DeepSeek-V4.1-Flash?
De server raakt vóór de generatie zonder geheugen
Het volledige checkpoint, niet het getal 8B/16B actieve parameters, bepaalt het grootste deel van de geheugenvereiste. Controleer tensor-parallelisme, GPU-geheugenbenutting, vision-loading en beschikbare HBM.
DeepSeek-V4.1-Flash heeft lang nodig om te starten
Een checkpoint van een halve terabyte kost tijd om te downloaden, te mappen, te initialiseren en te sharden. Lange engine-ready timeouts zijn normaal voor dit type model.
De respons is leeg of eindigt met finish_reason=length
De denkmodus kan het generatiebudget verbruiken. Verhoog max_tokens, verlaag reasoning effort, of schakel de denkmodus uit voor eenvoudige verzoeken.
Tool-calls worden niet correct geparsed
Zorg ervoor dat de server de DeepSeek V4.1-tokenizer, tool-call parser, reasoning parser en auto-tool-choice-flags gebruikt.
Vision-input werkt niet
Als u met --language-model-only hebt gestart, hebt u de visuele encoder bewust uitgeschakeld. Start opnieuw met multimodale ondersteuning ingeschakeld voordat u afbeeldingen test.
Moet u DeepSeek-V4.1-Flash lokaal draaien?
DeepSeek-V4.1-Flash is ongewoon interessant vanuit zelfhostperspectief omdat de architectuur de compute per token en KV-cachekosten aanzienlijk verlaagt, maar het verandert een open-weight model op frontier-schaal niet in een desktopmodel.
Voor een onderzoekslab, enterprise AI-platform, private coding-agentstack of air-gapped omgeving maken vLLM en SGLang zelfhosten technisch realistisch. Voor een ontwikkelaar met één of twee GPU’s is het geen praktisch doel voor volledige modeldeployment. In dat geval biedt DeepSeek V4.1 Flash via CometAPI toegang tot het model zonder van serving een groot infrastructuurproject te maken.
FAQ
Is DeepSeek-V4.1-Flash open source?
De modelgewichten en repository zijn uitgebracht onder de MIT-licentie, die breed gebruik, wijziging en herdistributie toestaat, onder de licentievoorwaarden.
Kan ik DeepSeek-V4.1-Flash draaien op een RTX 4090 of RTX 5090?
Niet het officiële volledige model. Een enkele consumentengpu heeft slechts een fractie van het geheugen dat het volledige checkpoint vereist.
Betekent 8B actieve parameters dat DeepSeek-V4.1-Flash slechts 8 GB VRAM nodig heeft?
Nee. Het 8B-cijfer beschrijft de parameters die deelnemen tijdens promptverwerking. Het volledige expertnetwerk en ondersteunende status moeten nog steeds worden opgeslagen en toegankelijk zijn.
Hoeveel VRAM heeft DeepSeek-V4.1-Flash nodig?
Het huidige vLLM-recept gebruikt ongeveer 614 GB als planningsfiguur voor het officiële checkpoint plus runtime-overhead. De werkelijke behoefte varieert met hardware, batchgrootte, context, vision-ondersteuning en servingconfiguratie.
Hoe groot is DeepSeek-V4.1-Flash op schijf?
De huidige vLLM-onderverdeling plaatst het checkpoint op ongeveer 476 GiB, of circa 511 GB.
Kan DeepSeek-V4.1-Flash lokaal een 1M-tokencontext draaien?
De architectuur ondersteunt tot 1.048.576 tokens, maar praktisch geheugengebruik hangt ook af van batchgrootte, runtime-buffers, vision-status en andere overhead.
Kan ik DeepSeek-V4.1-Flash lokaal draaien met Ollama?
De huidige Ollama-vermelding gebruikt een :cloud-route, wat niet hetzelfde is als het volledig op uw eigen machine draaien van de complete gewichten.
Is vLLM of SGLang beter voor DeepSeek-V4.1-Flash?
Beide richten zich op hogeprestatie-serving. vLLM heeft momenteel een bijzonder gedetailleerd V4.1-specifiek recept, terwijl SGLang ook geschikt is voor geavanceerde gedistribueerde deployments.
Wat is de makkelijkste manier om DeepSeek-V4.1-Flash te gebruiken zonder lokale hardware?
Gebruik een gehoste API. DeepSeek biedt een eigen API, terwijl CometAPI een OpenAI-compatibel DeepSeek-V4.1-Flash-endpoint biedt naast andere AI-modellen.