Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Leer hoe u MiniMax M3.1 Flash lokaal kunt uitvoeren. Verken de 428B/23B MoE-architectuur, GPU-vereisten, vLLM- en SGLang-installatie, benchmarks en API-alternatieven.
Deon GoodwinOnderzoeksteam voor AI-modellen en API
MiniMax M3.1 Flash brengt open-weight AI naar veeleisende codeer- en agent-workflows, maar lokaal draaien vereist serieuze hardware. De 428B-parameter MoE-architectuur activeert slechts 23B parameters per token, wat de berekening vermindert zonder dat de volledige modelopslag vervalt. Ontwikkelaars met ondersteunde multi-GPU-systemen kunnen het model inzetten met vLLM of SGLang. Voor wie infrastructuurbeheer wil overslaan, biedt de MiniMax M3.1 Flash API in CometAPI een eenvoudigere start.
Belangrijkste punten
Hardware is de grootste hindernis. De gepubliceerde vLLM-configuraties gebruiken vier ondersteunde Blackwell- of AMD MI355X-GPU’s, of acht H100/H200-GPU’s.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Lange context brengt geheugenkosten met zich mee. Het model ondersteunt tot één miljoen tokens, maar praktische limieten hangen af van beschikbare GPU-geheugen en gelijktijdigheid.
Implementatie is hardwarespecifiek. Gebruik een compatibele inferentie-engine, kwantisatie-indeling en acceleratorconfiguratie in plaats van een generiek installatiecommando.
Benchmarks zijn slechts een vertrekpunt. Evalueer codeernauwkeurigheid, voltooiing van agenttaken, latency en throughput onder uw eigen workloads.
Lokale en gehoste inferentie dienen verschillende behoeften. Zelf-hosting geeft meer infrastructuurcontrole, terwijl API-toegang de setupcomplexiteit en onderhoudslast verlaagt.
Wat is MiniMax M3.1 Flash?
MiniMax M3.1 Flash accepteert tekst, afbeeldingen en video en genereert tekst. Het is ontworpen voor code, automatisering, computerinteractie en security-workflows. De weights worden gedistribueerd onder de MiniMax Community License. Lees vóór commerciële dienstverlening de licentie bij de checkpoint en controleer de toepasselijke voorwaarden.
Specificaties van MiniMax M3.1 Flash
Specificatie
MiniMax M3.1 Flash
Ontwikkelaar
MiniMax
Modelfamilie
Native multimodal MoE
Totale parameters
Circa 428B
Actieve parameters
Circa 23B per token
Maximale context
1.048.576 tokens (modelcapaciteit)
Invoertypen
Tekst, afbeeldingen en video (route-afhankelijk)
Uitvoer
Tekst
Attention
MiniMax Sparse Attention in elke laag
Kwantisatie
MXFP8 dense-lagen / NVFP4-experts
Draft-decoding
DSpark geïntegreerde draft head
Redeneerinspanning
Low, medium, high, xhigh, max
Gerapporteerde snelheid
200+ tokens/s onder gunstige omstandigheden; P50 170+ tokens/s
Licentie
MiniMax Community License
Gedocumenteerde inferentie
vLLM, SGLang
Typische topologie
4 ondersteunde Blackwell- of MI355X-GPU’s; 8 H100/H200-GPU’s
Hoe gebruikt MiniMax M3.1 Flash zijn 428B/23B-architectuur?
Een Mixture-of-Experts (MoE)-model routeert elk token via geselecteerde experts. In MiniMax M3.1 Flash zijn circa 23B parameters actief per token, terwijl de volledige parameterpool circa 428B bedraagt. Spaarzame activatie vermindert de berekening; het verandert de checkpoint niet in een dense 23B-model.
Wat is er veranderd in MiniMax M3.1 Flash?
Sparse attention: Toegepast door het hele model om attentiewerk bij lange inputs te verminderen; het voordeel hangt af van de serving-kernels en de prompt.
Mixed-precision weights: MXFP8 voor dense-componenten en NVFP4 voor experts verlagen opslag- en rekeneisen, maar vereisen nog steeds compatibele hardware en kernels.
DSpark-decoding: Een geïntegreerde draft head kan de generatie versnellen in ondersteunde recepten; resultaten hangen af van tokenacceptatie en workload.
Vermogensbewuste serving: Scheduling op infrastructuurniveau kan de benutting verbeteren, maar is geen functie die u automatisch krijgt door de weights te downloaden.
Welke hardware is nodig voor MiniMax M3.1 Flash?
Begroot GPU-geheugen in vier delen: checkpoint-weights, key-value (KV)-cache voor vorige tokens, runtime-buffers en ruimte voor workload. De onderstaande schattingen dekken alleen ruwe parameteropslag. Mixed precision, kwantisatieschalen, multimodale componenten en serving-overhead veranderen de werkelijke vereiste.
Gevalideerde GPU-topologieën
Accelerators
Gepubliceerde topologie
Opmerkingen
NVIDIA GB200/GB300/B200/B300
4 GPU’s, tensor parallel
Blackwell NVFP4-native pad
NVIDIA H100/H200
8 GPU’s, tensor parallel
FP8-caches en Marlin MoE-pad
AMD MI355X
4 GPU’s, tensor parallel
Vereist ondersteunde ROCm- en AITER-instellingen
24–32 GB consumenten-GPU
Geen referentierecept voor volledige checkpoint
Onvoldoende voor eenvoudig single-GPU laden
Alleen-CPU workstation
Geen gevalideerde praktische inzet
Offloading-experimenten zijn geen productie-richtlijn
Memory-schatting: Ruwe opslag voor 428B parameters is ongeveer 856 GB bij BF16, 428 GB bij 8-bit of 214 GB bij geïdealiseerde 4-bit. De officiële checkpoint mixt formaten, dus deze cijfers zijn geen runtime-VRAM-vereisten. Reserveer ruimte voor kwantisatieschalen, KV-cache, runtime-buffers en gelijktijdigheid; gebruik de werkelijke checkpoint-bestanden en het recept voor uw GPU om het systeem te dimensioneren.
Reserveer NVMe-ruimte voor de checkpoint, tijdelijke downloads en een rollback-kopie.
Welke implementatiemethode moet u kiezen?
Voor een ondersteund lokaal cluster is vLLM een praktische start met referentieconfiguraties en een vertrouwde API-integratie; SGLang past bij teams die serving willen aanpassen na compatibiliteitscontrole, terwijl CometAPI een gehoste route biedt voor prototyping en modelswitching.
Vereiste
Lokale vLLM
Lokale SGLang
CometAPI
Weights en GPU’s
Weights downloaden; ondersteunde GPU’s bedienen
Weights downloaden; ondersteunde GPU’s bedienen
Door provider beheerde inferentie; geen lokale weights
Blackwell / AMD MI355X
Hardwarespecifieke recepten
Hardwarespecifieke recepten
Hardware beheerd door provider
H100/H200
Gedocumenteerd acht-GPU-recept
Controleer de actuele supportmatrix
Hardware beheerd door provider
Decodering en parallelisme
DSpark op ondersteunde paden; tensor- en gedistribueerde serving
Hardwarespecifieke decodering; tensor- en expert-parallelisme
Beperkt tot opties die de route blootstelt
Controle en gegevensverwerking
Uw omgeving; u beheert schaalbaarheid
Uw omgeving; u beheert schaalbaarheid
Externe provider; provider beheert schaalbaarheid
Kies het framework met een gevalideerd recept voor uw hardware en vergelijk vervolgens latency en throughput met dezelfde prompts, precisie en gelijktijdigheid.
Hoe voert u MiniMax M3.1 Flash lokaal uit met vLLM?
De volgende stappen gaan uit van een Linux-host met vier compatibele NVIDIA Blackwell-GPU’s, een ondersteunde driver/CUDA-omgeving en toegang tot de officiële checkpoint. Gebruik een gevalideerde vLLM-build; een gewone installatie op niet-ondersteunde GPU-hardware kan mislukken, zelfs als de pakketinstallatie slaagt.
Zorg ervoor dat het geïnstalleerde wheel en de CUDA-runtime overeenkomen met uw GPU-familie. Als een projectspecifieke development-build vereist is, volg dan de referentie-installatienotities voordat u de launch-argumenten gebruikt.
Gebruik indien nodig een passende Hugging Face-toegangstoken, behoud de mapstructuur en verifieer de volledige shard-download voordat u de server start.
Wacht tot de server het laden heeft voltooid en meldt dat hij klaar is voordat u een verzoek verzendt. Het bovenstaande commando beperkt de context tot 32.768 tokens en gelijktijdige sequenties tot vier voor een eerste rooktest. Deze verlaagde limieten zijn geen benchmarkinstellingen; pas ze aan nadat u het geheugengebruik en het aanvraaggedrag op uw hardware hebt gemeten.
Als de bediende identifier afwijkt van de mapnaam, roep dan /v1/models aan en gebruik de exact geretourneerde ID. Een succesvolle tekstrespons valideert alleen basisinferentie; test vision, tool-calls, gelijktijdigheid en lange context afzonderlijk.
Stap 5: Integreer met een OpenAI-compatibele Python-client
Het voorbeeld luistert op 127.0.0.1 voor lokale tests. Plaats vóór het aansluiten van externe clients toegangscontrole voor de endpoint en configureer client-time-outs, begrensde retries en monitoring.
H100/H200-variant: gebruik het acht-GPU Hopper-recept
Op acht H100/H200-GPU’s gebruikt u het Hopperspecifieke FP8-cache en het Marlin MoE-pad in plaats van de Blackwell NVFP4-configuratie. Onderstaand commando volgt het officiële vLLM Hopper-recept met context en gelijktijdigheid teruggebracht tot 32K en vier sequenties voor een eerste test. Het schakelt video-input uit, conform dat recept. Houd deze endpoint achter uw bestaande toegangscontrole.
SGLang biedt hardwarespecifieke M3.1-deploymentrecepten en OpenAI-compatibele serving. In de snapshot van 23 oktober bevat de documentatie speciale development container-images, dus ga er niet van uit dat een generieke SGLang-installatie alle modelspecifieke ondersteuning bevat.
Pull het speciale container-image
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Volg daarna het SGLang MiniMax M3.1 cookbook voor uw accelerator. Het pullen van een image downloadt alleen de runtime; u moet nog steeds een container starten met GPU-toegang en de bijpassende serving-configuratie erin starten. Gebruik het volledige hardwarespecifieke commando uit het cookbook, wacht op gereedheid en vraag vervolgens de modellijst van de endpoint op voordat u een testverzoek verstuurt. De gedocumenteerde NVIDIA- en AMD-paden gebruiken verschillende afhankelijkheden en moeten afzonderlijk worden geconfigureerd.
Hoe presteert MiniMax M3.1 Flash op benchmarks?
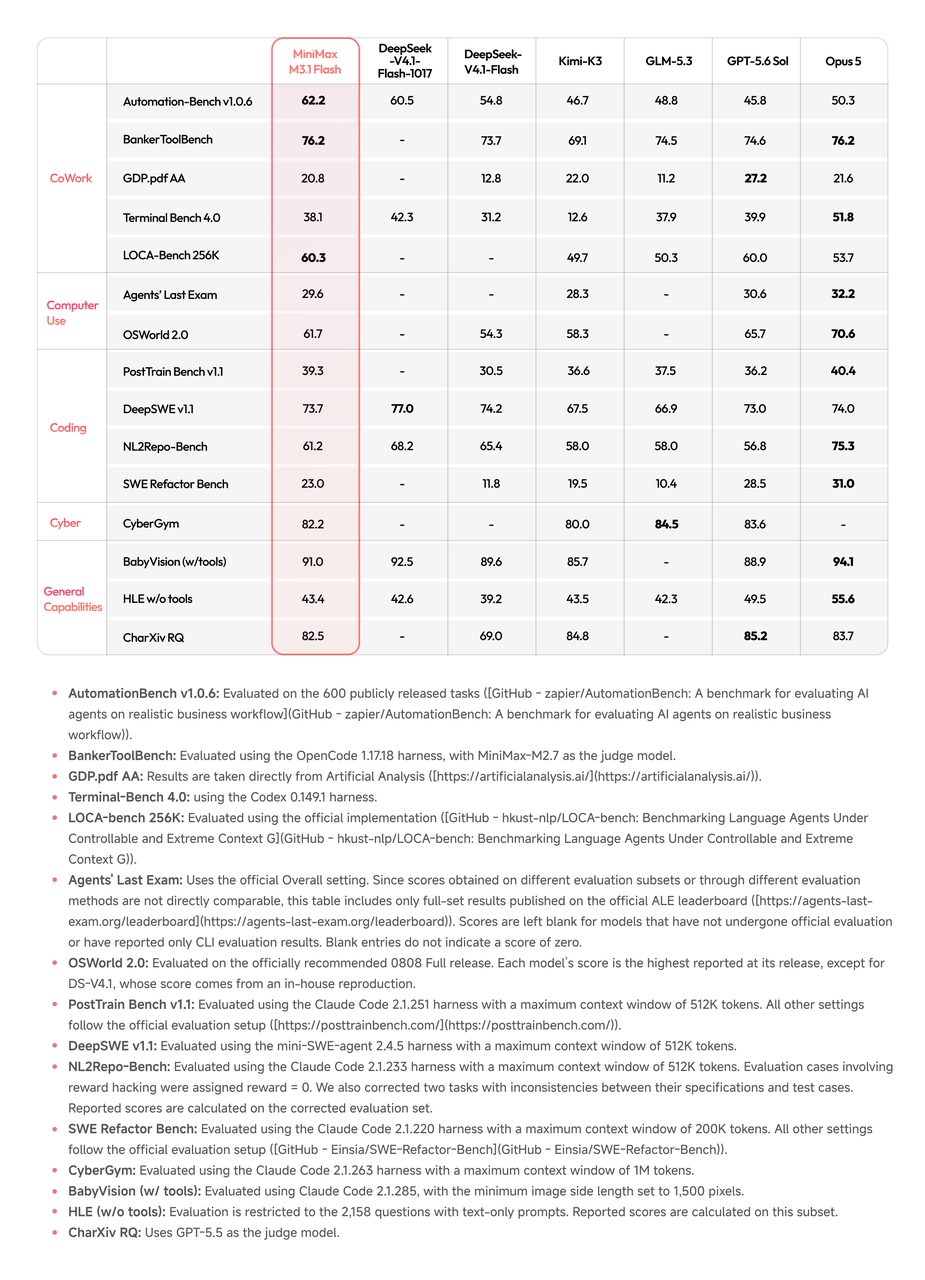
Zodra uw endpoint de basiscontroles doorstaat, gebruikt u gepubliceerde benchmarks om te bepalen welke workloads u hierna test. De onderstaande cijfers zijn door de leverancier gepubliceerde evaluaties, geen metingen van uw lokale deployment.
Benchmark
M3.1 Flash
DeepSeek V4.1 Flash 1017
Kimi K3
Automation-Bench v1.0.6
62.8
60.5
46.7
DeepSWE v1.1
73.7
77.0
67.5
Terminal Bench 4.0
38.1
42.3
12.6
OSWorld 2.0
61.7
N.v.t.
58.3
NL2Repo-Bench
61.2
68.2
58.0
BabyVision with tools
91.0
92.5
85.7
In deze vergelijking leidt MiniMax de genoemde modellen op Automation-Bench, terwijl DeepSeek op verschillende codeerbenchmarks leidt. Lees de modelkaart en evaluatie-instellingen voordat u conclusies trekt, en test de prompts en tools die uw applicatie daadwerkelijk gebruikt. Scores van verschillende benchmarkversies of setups zijn niet direct vergelijkbaar.
Hoe kunt u de prestaties van MiniMax M3.1 Flash optimaliseren?
Beheer context en gelijktijdigheid
Verhoog na het eerste succesvolle verzoek één laadvariabele tegelijk: invoerlengte, uitvoerlengte of gelijktijdige verzoeken. Noteer piekgeheugen en responstijd voor elke run. Bewaar de laatst stabiele instellingen als rollback-punt, zodat een mislukt experiment niet uw nieuwe baseline wordt.
Kies de redeneerinspanning bewust
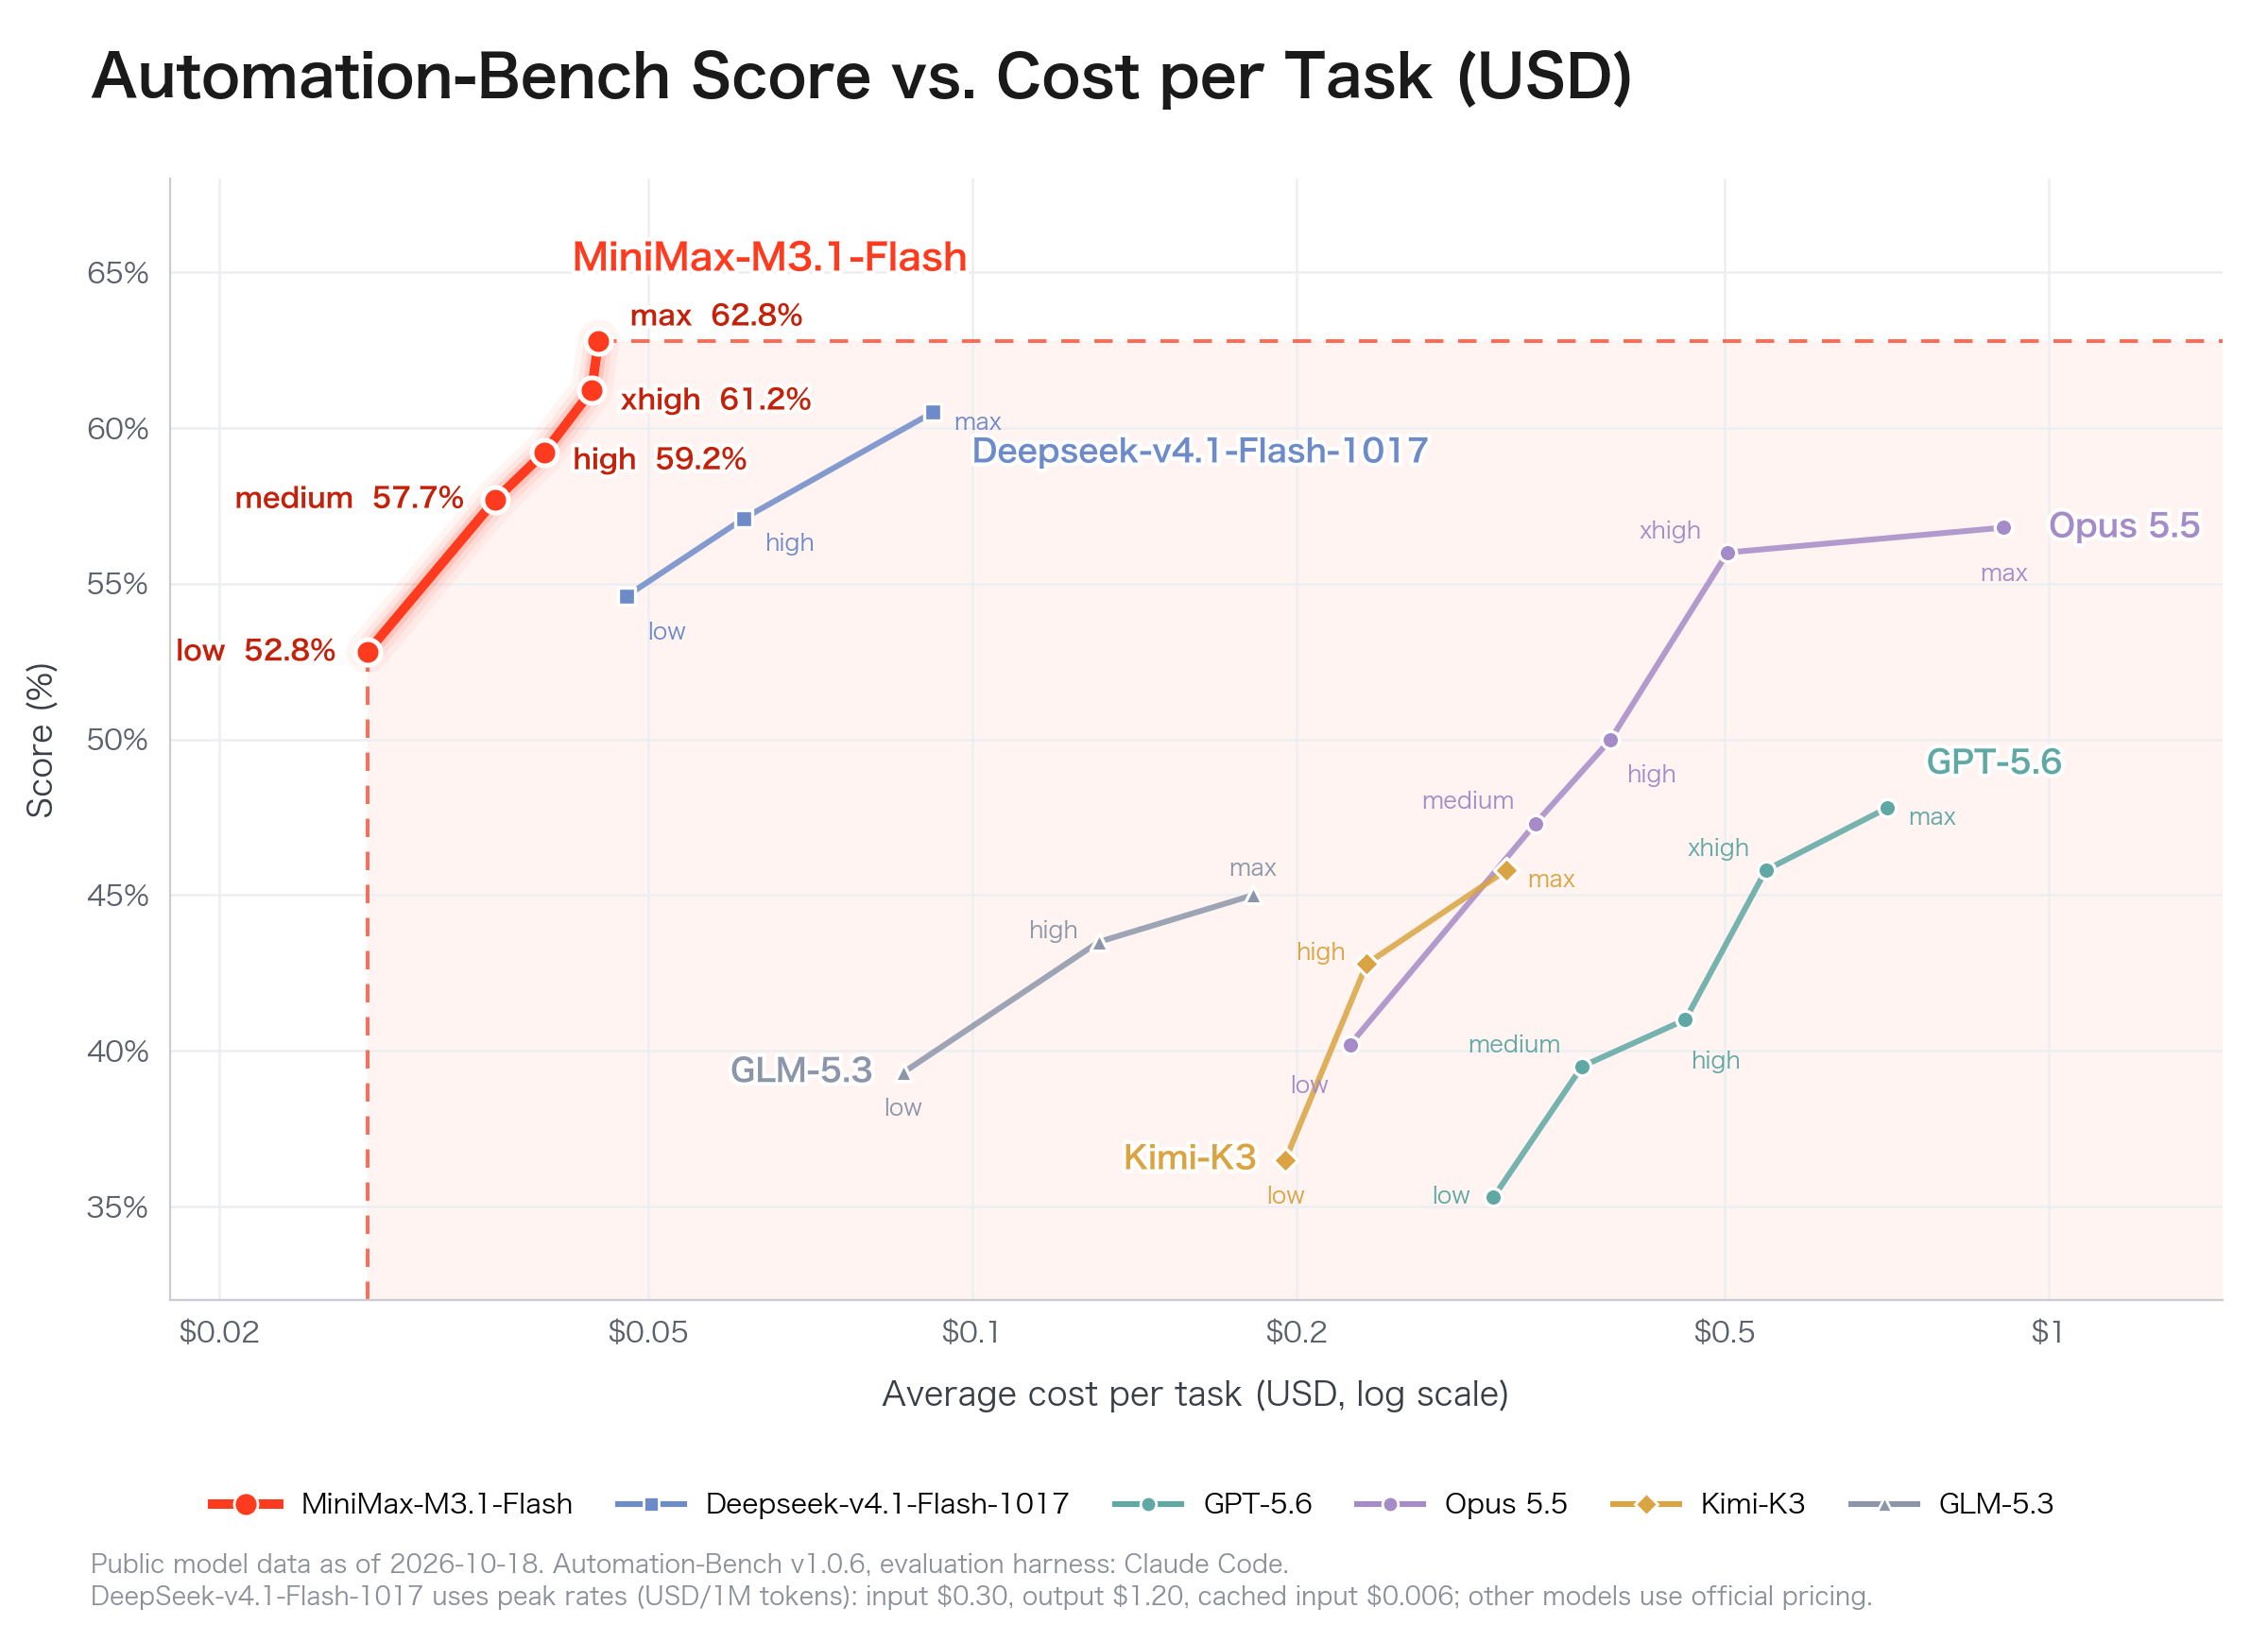
M3.1 Flash ondersteunt low, medium, high, xhigh en max. Hogere instellingen kunnen veeleisende taakscores verbeteren, maar vereisen vaak meer redeneertokens en langere latency. Gebruik taakkwaliteit en verbruikte compute samen.
Voor lokale vLLM-verzoeken toont het recept reasoning-effort-instellingen onder chat_template_kwargs. Controleer zowel het eindantwoord als een eventueel afzonderlijk geretourneerd redeneerveld bij het valideren van uw client, omdat gehoste en lokale endpoints deze velden anders kunnen blootstellen.
Volg kosten per voltooide taak
Voor agents is tokens per seconde niet genoeg. Leg tijd tot eerste token, uitvoersnelheid, acceptatiegraad voor speculatieve decodering, gelijktijdige throughput, mislukte tool-aanroepen, geheugengebruik en kosten per voltooide taak vast. Een tragere respons met minder mislukte tools kan betere totale economie opleveren.
Hoe gebruikt u de MiniMax M3.1 Flash API in CometAPI?
Teams die geen dedicated acceleratorinfrastructuur nodig hebben, kunnen een OpenAI-compatibele gehoste endpoint gebruiken. Dit elimineert checkpoint-download en GPU-operaties, maar verplaatst de verzoekverwerking buiten de zelfgehoste omgeving.
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Bevestig de modelidentifier in uw CometAPI-console voordat u dit voorbeeld uitvoert. Gebruik de gateway wanneer een gemeenschappelijke API over providers uw applicatie helpt; vergelijk de actuele offerte met directe toegang voor uw verwachte gebruik.
Prijzen van de MiniMax M3.1 Flash API
Prijs per miljoen tokens
MiniMax officiële API
CometAPI
Input
$0,15
$0,80
Output
$0,60
$3,20
Cached input
$0,015
Bevestig actuele routeprijs
MiniMax directe API-tarieven in de lanceringaankondiging van 19 oktober 2026 zijn $0,15 input, $0,60 output en $0,015 cached input per miljoen tokens. Controleer voor CometAPI de actieve modelroute, input/output-tarieven, cachingregels en eventuele accountkorting voordat u de uitgaven inschat. Vergelijk de totale kosten voor uw verwachte tokenmix en retries.
Welke problemen kunnen zich voordoen bij het draaien van MiniMax M3.1 Flash?
Out of memory tijdens laden of verzoeken
Als het laden van de weights faalt: Controleer de mislukte fase in het opstartlog, bevestig dat de checkpoint compleet is en verifieer dat de GPU-topologie en kwantisatie-backend overeenkomen met het recept. Als de weights het beschikbare geheugen overschrijden, gebruik dan een configuratie met voldoende capaciteit; het verkorten van een verzoek kan een weight-laadfout niet verhelpen.
Als weights laden maar cache-allocatie bij startup faalt: Controleer de cache-instellingen en beschikbaar geheugen, verlaag vervolgens de geconfigureerde context of gelijktijdigheid volgens het recept.
Als de server start maar een verzoek zonder geheugen komt te zitten: Probeer opnieuw met een korte prompt en één verzoek tegelijk, verhoog daarna invoerlengte, uitvoerlengte en gelijktijdigheid afzonderlijk terwijl u het geheugen monitort.
Onverenigbare kwantisatie- of attention-kernels
NVFP4-executie verschilt tussen Blackwell-, Hopper- en AMD-hardware. Stem versies van inferentie-engine, kwantisatie-backends, CUDA/ROCm-versies en acceleratorfamilies op elkaar af in plaats van vlaggen willekeurig te hergebruiken.
Configuratie van sparse-attention-cache
Als startup een niet-ondersteunde cache-indeling meldt, vergelijk dan de volledige cacheconfiguratie met het hardwarespecifieke recept. Het huidige vLLM-recept vereist --block-size 128 voor de MSA sparse/index-cache. Als startup een cache-indeling- of block-size-fout meldt, vergelijk dan de volledige configuratie met het recept voor uw hardware.
Onverwachte modelidentifiers
Een lokaal pad en een modelnaam van een externe gateway zijn niet per se identiek. Vraag de lokale /v1/models-respons op en vermijd hardgecodeerde aannames van een andere endpoint.
Slechte waargenomen throughput
Maak onderscheid tussen trage promptverwerking en trage tokengeneratie. Vergelijk runs met dezelfde invoerlengte en uitvoerlimiet en controleer daarna GPU-benutting en interconnectgedrag voordat u de batchgrootte verhoogt. Een door een provider gerapporteerde snelheidswaarde is geen baseline voor uw lokale cluster.
Conclusie
Kies uw eerste implementatiepad op basis van de hardware die u vandaag kunt bedienen. Gebruik de vLLM-walkthrough voor een ondersteund lokaal cluster, het hardwarespecifieke SGLang-cookbook voor een alternatieve servingstack, of een gehoste API wanneer u zich op applicatie-integratie wilt richten. Behoud de configuratie die voldoet aan uw kwaliteits- en latencydoelen tegen duurzame operationele kosten.
De betrouwbaarste manier om een serving-methode te kiezen is te optimaliseren voor correct afgerond werk per dollar en per minuut, niet alleen piektokens per seconde.
FAQ
Hoe maak ik een deployment reproduceerbaar na een upgrade van de runtime?
Pin de checkpoint-revisie, runtime-image of pakketversies, driverstack en launch-instellingen. Voer vóór elke upgrade dezelfde kleine acceptatieset uit en houd de vorige werkende configuratie beschikbaar voor rollback.
Hoe moet ik retries afhandelen wanneer een agent tools aanroept?
Schei het opnieuw proberen van het model af van het herhalen van een tool-actie. Gebruik idempotentiesleutels voor acties die data wijzigen, controleer of de eerste poging is geslaagd en valideer complete tool-argumenten vóór uitvoering.
Kan ik schakelen tussen een lokale endpoint en CometAPI zonder het gedrag van de applicatie te wijzigen?
Houd endpoint, inloggegevens en model-ID configureerbaar. Test streaming, tool-calls, redeneervelden en multimodale input op beide routes en bevestig uw gegevensrouteringsvereisten voordat u fallback inschakelt.
Wat moet ik testen voordat ik multimodale input accepteer?
Test representatieve afbeeldingen en video’s, inclusief lage kwaliteit en niet-ondersteunde bestanden. Controleer preprocessing, groottelimieten, antwoordkwaliteit en time-outs afzonderlijk; een geslaagd tekstverzoek valideert het multimodale pad niet.
Hoe weet ik of een deployment klaar is voor echte gebruikers?
Stel doelen vast voor taakslagen, geldige tool-calls, latency, fouten en kosten. Test realistisch verkeer, verifieer monitoring en fallback-gedrag en breid pas uit vanaf een kleine uitrol zolang die doelen standhouden.