Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
TLDR Claude Haiku 5.5 noemt het het goedkoopste, snelste en meest capabele kleine model dat het ooit heeft uitgebracht. Ontworpen voor grootschalige, latentiegevoelige workloads zoals classificatie, extractie, routing, samenvatting en subagent-taken, levert het een contextvenster van 1 miljoen tokens, tot 128K outputtokens, en adaptief denken met instelbare inspanningsniveaus.
Gemiddeld kost het circa 75% minder om te draaien dan Haiku 4.5, terwijl het grote winst boekt op agent- en computer-use-benchmarks. Ontwikkelaars kunnen het gebruiken via de officiële Claude API (claude-haiku-5-5), Amazon Bedrock, Google Cloud, Microsoft Foundry of kosten-geoptimaliseerde gateways zoals CometAPI (vanaf $0.08 / $0.40).
Belangrijkste punten
Release & positionering: Gelanceerd op 7 oktober 2026 als het kleine, high-throughput model in de Claude 5.5-familie—ideaal voor realtime support, documentverwerking en gedelegeerde agent-stappen.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Kernspecificaties: 1M-tokencontext, 128K maximale output (300K via Batch API beta), adaptief denken (standaard medium inspanning), tekst + afbeelding input → tekst output, kennisafkapdatum juni 2026.
Prijsvoordeel: $0.10 input / $0.50 output per miljoen tokens voor prompts tot 100K (≈90% goedkoper dan Haiku 4.5 bij de meeste requests); hogere tier boven 100K. Cache-reads vanaf $0.01. CometAPI biedt ≈20% lagere Standard-tarieven.
Prestatiesprong: Grote vooruitgang t.o.v. Haiku 4.5 (bijv. OSWorld 72,4% vs 15,7%, Terminal-Bench 39,2% vs 0%, GDPval-AA 1620 vs 735 Elo) en tegelijk concurrerend met of beter dan GPT-6 Luna op veel tests.
Features voor ontwikkelaars: Effort-parameter (low–max), promptcaching, Batch API (50% korting), computer-/browsergebruik (beta SDK-ondersteuning). Temperature/top_p/top_k moeten worden weggelaten, anders treedt een 400-fout op.
Wat is Claude Haiku 5.5 en waarom het ertoe doet in 2026
Claude Haiku 5.5 is Anthropics nieuwste model in de lichtgewichtlaag van de Claude-familie. In tegenstelling tot de duurdere Opus 5.5- en Sonnet 5.5-modellen die zijn geoptimaliseerd voor complexe redenering en langlopende agents, is Haiku 5.5 speciaal gebouwd voor grootschalige, kostenbewuste en latentie-kritische workloads. Anthropic omschrijft het als “het goedkoopste, snelste en meest capabele kleine model dat we ooit hebben uitgebracht.”
Typische productiegebruiksscenario’s zijn:
Ticketclassificatie en -routing in customer support
Veldextractie en samenvatting van lange documenten
Compactie van conversatiegeschiedenis voor grotere modellen
Database-achtige queries en gestructureerde datataken
Snelle subagents die beperkte code-, tool- of browserstappen afhandelen terwijl een sterker model orkestreert
Omdat het aanzienlijk goedkoper en sneller is dan zijn voorganger, terwijl het veel van de kwaliteitskloof op praktische agenttaken verkleint, herontwerpen veel teams pipelines zodat Haiku 5.5 het merendeel van de aanvragen afhandelt en alleen moeilijke gevallen opschaalt naar Sonnet of Opus. Vroege klantfeedback van Asana, HubSpot, Box en anderen benadrukt 30%+ latentie-reducties en meetbare nauwkeurigheidsverbeteringen op grootschalige interne evaluaties.
De grotere context- en outputlimieten, gecombineerd met adaptief denken, maken Haiku 5.5 veel bruikbaarder voor echte productiesystemen dan eerdere kleine modellen die agressieve truncatie of vaste thinking-budgetten vereisten.
Antwoorden en voltooiingscontroles
Lees contentblokken per type, in plaats van aan te nemen dat content[0] het zichtbare antwoord is. Inspecteer stop_reason voordat je output accepteert: max_tokens duidt op een afgebroken generatie en refusal vereist een expliciete toepassingsrespons. Voor requests met tools: verwerk tool-use-blokken en geef toolresultaten terug in native formaat in plaats van ze als een afgerond tekstantwoord te behandelen.
Wat is er veranderd ten opzichte van de Claude Haiku 4.5 API?
Capaciteit, gedrag en prijswijzigingen
Dimensie
Haiku 4.5
Haiku 5.5
Sonnet 5.5
Contextvenster
200K
1M
1M
Maximale output
64K
128K
128K
Adaptieve effort
Nee
Ja
Ja
Anthropic input / MTok
$1.00
$0.10
$2.00
Anthropic output / MTok
$5.00
$0.50
$10.00
Positionering
Legacy snel model
Routinewerk op schaal
Complexere taken
De prijzen voor Haiku 5.5 in deze vergelijking gelden voor prompts tot 100.000 tokens; grotere prompts kosten meer. Dit zijn Anthropic Standard-tarieven, geen CometAPI-tarieven. De vergelijking is een routeringsuitgangspunt, geen claim dat de modellen identiek presteren.
Voor Haiku 4.5-integraties zijn de belangrijkste implementatiewijzigingen adaptief denken in plaats van een handmatig budget, effort-controls, selectieve parsing van contentblokken en bijgewerkte tokenaantallen. Dezelfde tekst kan ongeveer 30% meer inputtokens gebruiken. Tel representatieve prompts opnieuw in plaats van Haiku 4.5-tokenramingen te hergebruiken. De migratiesectie zet deze wijzigingen om in een deployment-checklist.
Anthropic rapporteert de bovenstaande scores in zijn samenvatting van de lancering-benchmarks. Het zijn gerapporteerde evaluatieresultaten, geen live tests van de CometAPI-voorbeelden in deze gids. OSWorld’s 72,4% is gedeeltelijke puntentoekenning, geen strikte taakvoltooiingsratio.
De Haiku 5.5 system card beschrijft de evaluatiecondities. Standaardevaluaties van Haiku 5.5 gebruiken adaptief denken op max effort en standaard sampling tenzij anders vermeld; de productstandaard is medium. OSWorld gebruikt 82 offline taken, geen internettoegang, 1080p-resolutie en een limiet van 500 acties. Terminal-Bench 4.0 gebruikt Claude Code in bare-modus, geen internet-egress en 10 trials per taak voor Haiku 5.5; Sonnet’s setup verschilt. HLE- en Chartography-rijen hierboven zijn zonder tools. GDPval-AA rapporteert een Elo-rating op basis van Artificial Analysis-evaluaties. Gebruik de relevante harness-, effort- en toolinstellingen bij het vergelijken van resultaten.
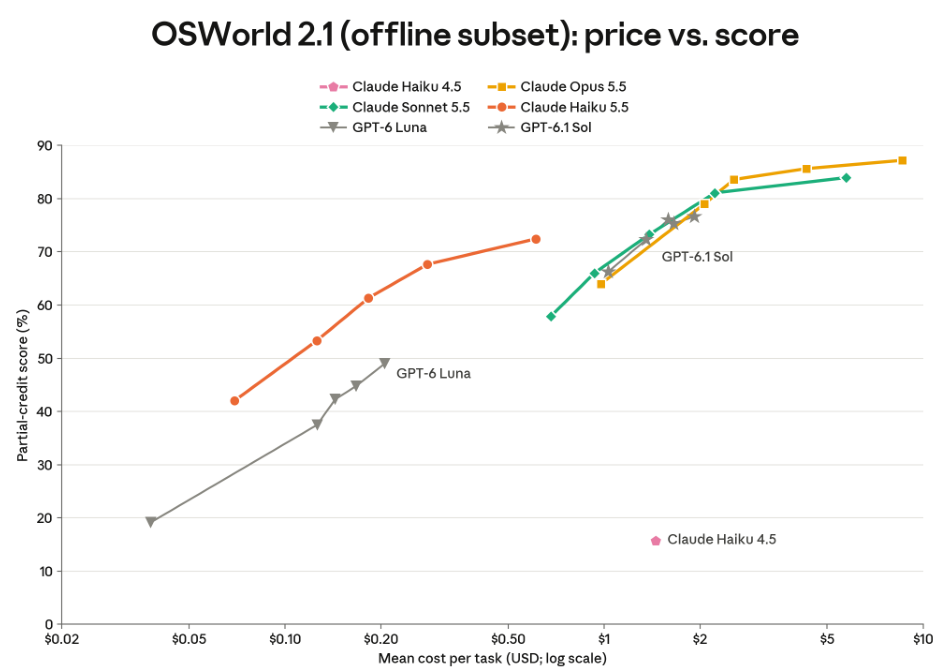
Anthropic’s originele OSWorld-grafiek laat de relatie zien tussen effort, kosten per taak en gedeeltelijke-punten-score. Het meet geen API-latentie en garandeert niet dezelfde prestaties op jouw workload.
De scores wijzen op aanzienlijk sterkere computer-use- en algemene taakprestatie dan Haiku 4.5, maar ze garanderen niet dezelfde resultaten in jouw toepassing. Voer een representieve evaluatieset uit voordat je productietraffic toewijst.
De benchmarktabel en meegeleverde grafiek worden behouden als modelvergelijkingen. Het zijn gerapporteerde evaluaties in plaats van live tests van de CometAPI-voorbeelden. Gebruik dezelfde taakverdeling, effort- en toolinstellingen bij het evalueren van een toepassing; een benchmarkscore bewijst geen gateway-latentie of jouw eigen succeskans.
Claude Haiku 5.5 API gebruiken via CometAPI
Maak een key en kies de native route
Maak een CometAPI-account, bevestig toegang tot claude-haiku-5-5 en genereer een server-side API-sleutel. Stel COMETAPI_KEY in je omgeving in. Houd de sleutel buiten source control en browsercode. Anthropic- en CometAPI-sleutels behoren tot verschillende providers; gebruik de CometAPI-sleutel voor elk voorbeeld in deze bijgewerkte gids.
CometAPI ondersteunt Claude’s native Messages- en content-block-formaat. Gebruik de Anthropic SDK met de CometAPI root basis-URL. Native Messages is de voorkeursroute in deze gids voor Claude-specifiek denken en contentblokken. De compatibele Chat Completions-route is een optie voor een bestaande OpenAI-stijl applicatie. Bevestig ondersteuning voor geavanceerde velden op de exacte gatewayroute.
Stuur een minimale request en verifieer het resultaat
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
    timeout=60.0,
    max_retries=2,
)

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket: I cannot log in."}],
)
if response.stop_reason != "end_turn":
    raise RuntimeError(f"Unaccepted completion: {response.stop_reason}")
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Sla het Python-voorbeeld op als example.py en voer python example.py uit. Een succesvolle checkpoint is een afgeronde respons met zichtbaar tekst en usage-velden. Een authenticatiefout betekent dat de sleutel moet worden gecontroleerd; een model/route-fout betekent dat de model-ID, endpoint of accounttoegang moet worden gecontroleerd.
Gebruik hetzelfde native formaat vanuit JavaScript
npm install @anthropic-ai/sdk
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com",
  timeout: 60_000,
  maxRetries: 2,
});
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 2048,
  output_config: {effort: "low"},
  messages: [{role: "user", content: "Extract product, quantity and price: 3 laptops at $900 each."}],
});
if (response.stop_reason !== "end_turn") {
  throw new Error("Unaccepted completion: " + response.stop_reason);
}
for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
Gebruik een ondersteunde Node.js-release. Sla het bestand op als example.mjs, stel COMETAPI_KEY in en voer node example.mjs uit. Noteer de SDK-versie die je valideert voor deployment.
Pas een bestaande OpenAI-compatibele applicatie aan
Als je applicatie al Chat Completions gebruikt, installeer het openai-pakket en configureer de afzonderlijke client hieronder. Deze route retourneert choices in plaats van native contentblokken. Houd route-specifieke parsing gescheiden en test denken, afbeeldingen en tools voordat je op gatewayvertaling vertrouwt.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    messages=[
        {"role": "system", "content": "Be concise and helpful."},
        {"role": "user", "content": "Explain API rate limits."},
    ],
)
print(response.choices[0].message.content)
Afbeeldingen naar de Claude Haiku 5.5 API sturen
Gebruik een afbeelding samen met een instructie die het bewijs en de gewenste output specificeert. De officiële vision-interface accepteert image-contentblokken met base64-data, een afbeeldings-URL of een ondersteunde geüploade bestandsreferentie. Dit voorbeeld leest een lokale PNG, plaatst de afbeelding voor de vraag en vraagt om waarden die kunnen worden vergeleken met de bron.
Analyseer een echte lokale PNG via de native Anthropic Messages API.
import os
import base64
from pathlib import Path
import anthropic

# Replace dashboard.png with a real PNG file you are authorized to analyze.
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode("ascii")
anthropic_client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
response = anthropic_client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64", "media_type": "image/png", "data": image_data
            }},
            {"type": "text", "text": (
                "Read the visible dashboard metrics. List anomalies with their "
                "labels and values, and state when text is unreadable."
            )},
        ],
    }],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Gebruik de MIME-typen die overeenkomen met het daadwerkelijke bestand. Controleer leesbaarheid, afbeeldingsafmetingen en requestgrootte-limieten vóór indiening; vermijd het verzenden van hoge-resolutie media die niet helpen bij de taak. Voor CometAPI: wijzig de sleutel en root basis-URL zoals getoond in het Messages-voorbeeld, en verifieer ondersteuning voor afbeeldingen op de exacte route.
Het redeneren van Claude Haiku 5.5 beheren
Haiku 5.5 gebruikt standaard adaptief denken. De officiële thinking-configuratie legt uit wanneer disabled wordt geaccepteerd en hoe thinking-blokken worden geretourneerd. Stel effort in via output_config.effort; hergebruik legacy budget_tokens niet.
Effort
Goede starttoepassing
Trade-off
low
Korte classificatie, eenvoudige extractie
Gewoonlijk lagere tokengebruik en latentie
medium
Supportantwoorden, routine agentwerk
Gebalanceerde standaard
high
Multi-step documentanalyse
Mogelijk meer redenering
xhigh
Moeilijke evaluaties
Meer verwerking en kosten
max
Redeneringsintensieve gevallen
Hoogste potentiële redeneringsuitgaven
Configureer adaptief denken met low effort.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)response = anthropic_client.messages.create( model="claude-haiku-5-5", max_tokens=4096, thinking={"type": "adaptive"}, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Classify as billing, technical, or account: cannot log in."}],)for block in response.content: if block.type == "text": print(block.text)
Ontwikkelaars kunnen thinking uitschakelen bij low, medium en high effort, maar niet bij xhigh of max. Denken verbruikt gefactureerde outputtokens en het max_tokens-budget, zelfs wanneer de tekst verborgen is. Een leeg thinking-veld kan nog steeds een signatuur bevatten; het bewijst niet dat er geen redenering heeft plaatsgevonden. Laat geretourneerde contentblokken ongewijzigd wanneer je toolconversaties voortzet.
Voorbeeldverzoek met denken uitgeschakeld
Stuur een native requestbody met thinking uitgeschakeld.
Streaming levert zichtbare tekst incrementeel en verbetert de responsiviteit in interactieve applicaties. Behandel gestreamde tekst als voorlopig totdat de request succesvol is afgerond.
Stream zichtbare tekst met de Anthropic Python SDK.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)with anthropic_client.messages.stream( model="claude-haiku-5-5", max_tokens=4096, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Explain API caching."}],) as stream: for text in stream.text_stream: print(text, end="", flush=True)
Prijzen van de Claude Haiku 5.5 API
Vergelijk token-tarieven en promptlengte-banden
Tarieven gecontroleerd op 8 oktober 2026. De tabel vergelijkt Anthropic Standard-prijzen met gepubliceerde CometAPI-tarieven, in USD per miljoen tokens. De band wordt bepaald door promptlengte: tot 100.000 tokens versus meer dan 100.000. Langere verzoeken gebruiken de toepasselijke hogere band, niet slechts een opslag op de overtollige tokens. Accountbilling, gecachte usage en optionele tools moeten afzonderlijk worden verrekend.
Token-categorie
Anthropic ≤100K
CometAPI ≤100K
Anthropic >100K
CometAPI >100K
Input
$0.10
$0.08
$0.50
$0.40
Output
$0.50
$0.40
$2.50
$2.00
Cache-lezen
$0.01
$0.008
$0.05
$0.04
5-min cache-schrijven
$0.125
$0.10
$0.625
$0.50
1-uur cache-schrijven
$0.20
$0.16
$1.00
$0.80
De oorspronkelijke momentopname van tarieven uit het artikel blijft hierboven behouden. Controleer de huidige CometAPI-vermelding en accountbilling vóór aankoop of deployment; de vermelding van het starttarief voor input is geen volledige offerte voor elke promptlengte-band, cache-operatie of optionele tool.
Voorbeeld: kosten van 100.000 supportverzoeken
Ga uit van 100.000 maandelijkse requests, elk met 2.000 inputtokens en 300 gefactureerde outputtokens, inclusief eventuele gegenereerde thinking. Elke prompt komt in aanmerking voor de band tot 100K. Caching, toolkosten en retries uitgesloten.
Component
Gebruik
Anthropic
CometAPI
Input
200M tokens
$20.00
$16.00
Output
30M tokens
$15.00
$12.00
Totaal
100,000 requests
$35.00
$28.00
Onder deze aannames is het illustratieve verschil $7 per maand, of 20%. Productiekosten hangen af van requestlengtes, verborgen redenering, caching en retry-gedrag.
Gebruik de huidige tokenaantallen van het model in de berekening. Kosten = inputtokens × toepasselijk inputtarief / 1.000.000 + gefactureerde outputtokens × toepasselijk outputtarief / 1.000.000, plus afzonderlijk toepasselijke cache-, tool- en retry-kosten. Thinking-tokens maken deel uit van de gefactureerde output.
Kosten verlagen zonder kwaliteitsverlies bij geaccepteerde taken
Optimalisatie
Actie
Voordeel
Effort-afstemming
Gebruik low waar kwaliteit dit toelaat
Lager redenerings-overhead
Promptreductie
Verwijder redundante conversatiegeschiedenis
Minder inputtokens
Promptcaching
Houd hergebruikte context stabiel
Lagere herhaalde inputkosten
Streaming
Render tokens zodra ze binnenkomen
Beter ervaren responsiviteit
Schemacontrole
Wijs ongeldige records vroeg af
Minder naverwerking downstream
Modelrouting
Schakel complexe taken door
Betere kosten-kwaliteitsbalans
Batchverwerking
Batch in aanmerking komende offline requests
Potentieel extra besparingen
Selecteer niet automatisch de laagste effort. Een goedkopere individuele call kan de totale kosten verhogen als deze meer retries veroorzaakt. Evalueer nauwkeurigheid, p50/p95-latentie, tokengebruik en kosten per succesvolle taak.
Voor promptcaching: hergebruik een stabiele prefix en inspecteer cache-creatie en cache-read-usage in plaats van uit te gaan van een hit. Haiku 5.5 heeft een minimum cachebare prompt van 512 tokens op de gedocumenteerde Claude API. Het wijzigen van effort kan gecachte prefixen ongeldig maken; houd instellingen stabiel binnen een conversatie. Een 1M-contextvenster is een capaciteitsplafond, geen aanbeveling om elk document bij elke beurt te verzenden.
Houd een stabiele herbruikbare prefix voor caching aan, verkort onnodige inputs en benchmark effort-wijzigingen. Streaming verbetert de ervaren responsiviteit in plaats van automatisch het gefactureerde gebruik te verlagen. Vergelijk kosten per geaccepteerde taak over de volledige workflow, inclusief retries en toolcalls.
Migratiegids van Claude Haiku 4.5 naar Haiku 5.5
Werk de integratie en requestindeling bij
Onderdeel
Migratieactie
Model-ID
Vervang door claude-haiku-5-5
Thinking
Vervang handmatig budget_tokens door adaptief denken
Effort
Gebruik output_config.effort indien nodig
Sampling
Laat temperature, top_p en top_k weg; elke top_k-waarde wordt niet ondersteund
Response-parser
Verwerk meerdere typen contentblokken
Outputbudget
Laat voldoende ruimte voor redenering en eindoutput
Prefill
Verwijder niet-ondersteunde assistant-prefilling
Caching
Test prompts opnieuw bij wijzigen van effort
Toolintegraties
Verifieer ondersteunde toolversies
Voor de hier gebruikte CometAPI-route: behoud COMETAPI_KEY en de native basis-URL, terwijl je de model-ID en requestconfiguratie wijzigt. Vervang legacy enabled thinking met een budget door adaptief denken en effort. Verwijder assistant-prefilling en laat samplingparameters weg. Behoud het onderscheid tussen Claude’s native content-array en de compatibele route’s choices-respons.
Behoud status en herbereken budgetten
De officiële Haiku 5.5-migratiegids meldt ongeveer 30% meer inputtokens voor identieke tekst dan Haiku 4.5. Tel representatieve prompts opnieuw en retune limieten voordat je verkeer verplaatst. Geretourneerde thinking-blokken werken alleen in het account dat ze heeft geproduceerd of een gekoppeld account; een accountwijziging kan die blokken stilzwijgend verwijderen. Behoud een append-only conversatieprefix in plaats van eerdere berichten te wijzigen na generatie. Inspecteer stop_reason, inclusief max_tokens en refusal, en verwerk ze expliciet voordat je output accepteert.
Tel representatieve prompts opnieuw met het doermodel en stel max_tokens, latentielimieten en kostenramingen voor requests opnieuw af. Test opgeslagen conversaties tegen het account en de gatewayroute die ze opnieuw zullen afspelen; ga er niet van uit dat getekende thinking-blokken overdraagbaar zijn tussen niet-verwante accounts of herschreven conversatieprefixen.
Conclusie
Claude Haiku 5.5 vertegenwoordigt een echte kantelpunt voor kostenefficiënte, high-throughput AI. Door aanzienlijk betere agent- en computer-use-prestaties te leveren tegen ongeveer een tiende van de eerdere Haiku-prijs voor de meerderheid van de requests, heeft Anthropic grootschalige inzet van capabele kleine modellen praktisch gemaakt. Of je nu de officiële API aanroept, routeert via Amazon Bedrock, of een unified gateway zoals CometAPI gebruikt voor extra besparingen en operationele eenvoud, de combinatie van snelheid, capaciteit en prijs opent nieuwe productmogelijkheden die voorheen oneconomisch waren.