Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Hoe gebruik je de Qwen3.8-Omni-Flash API met Python, cURL, afbeeldingen, audio en video, inclusief productierichtlijnen en beschikbaarheidscontroles van CometAPI.
Deon GoodwinOnderzoeksteam voor AI-modellen en API
Gebruik Qwen3.8-Omni-Flash om opnames samen te vatten, afbeeldingen te interpreteren en video’s met gesproken inhoud te analyseren. Het accepteert tekst, afbeeldingen, audio en video en retourneert tekst. Het ondersteunt een contextvenster van 1M tokens, tool calling, websearch, contextcaching en instelbare redeneringsinspanning. Ontwikkelaars kunnen het aanroepen via de OpenAI-compatibele interface van Alibaba Cloud Model Studio. Ontwikkelaars die de Qwen3.8-Omni-Flash API in CometAPI evalueren, moeten vóór publicatie van productierijpe integratie-instructies de huidige endpointstatus in de modelcatalogus of het dashboard bevestigen.
Belangrijkste punten
Gebruik model-ID qwen3.8-omni-flash voor de standaard niet-realtime API.
Het model accepteert invoer van tekst, afbeelding, audio en video en produceert tekst als uitvoer.
Het officiële contextvenster is 1M tokens, met een gedocumenteerde maximale output van 131.072 tokens.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Thinking is standaard ingeschakeld; kies low, medium of xhigh redeneringsinspanning op basis van de taakcomplexiteit.
Gebruik gestructureerde, bewijsgerichte prompts voor media-analyse en verifieer modelspecifieke beschikbaarheid bij de provider vóór uitrol.
Wat biedt de Qwen3.8-Omni-Flash API?
Uitleg over de Qwen3.8-Omni-Flash API
Met Qwen3.8-Omni-Flash kunt u een vergaderopname samenvatten, kerninformatie uit een screenshot halen of een video analyseren samen met de gesproken inhoud. Stuur tekst, afbeeldingen, audio en video in dezelfde aanvraag en ontvang vervolgens een tekstantwoord dat het relevante bewijs verbindt. Begin met een concrete taak en specificeer de gewenste output, zoals actiepunten, tijdstempels of een lijst met discrepanties.
De officiële documentatie bevestigt ondersteuning voor Chat Completions en Responses API. De onderstaande voorbeelden beginnen met een basiscall en tonen vervolgens invoer van afbeeldingen, audio en video; regelknoppen voor redenering en tool-ondersteunde workflows komen later aan bod.
Officiële specificatie van Qwen3.8-Omni-Flash
Waarde
Model ID
qwen3.8-omni-flash
Invoer
Tekst, afbeelding, audio, video
Uitvoer
Tekst
Contextvenster
1M tokens
Maximale invoer, zonder thinking
991.808 tokens
Maximale invoer, met thinking
983.616 tokens
Maximale output
131.072 tokens
Thinking
Standaard ingeschakeld
Aanbevolen redeneringsinspanning
low / medium / xhigh
Function calling
Ondersteund
Web search
Ondersteund
Context caching
Ondersteund
Multikanaals audio
Ondersteund
API's
Chat Completions / Responses
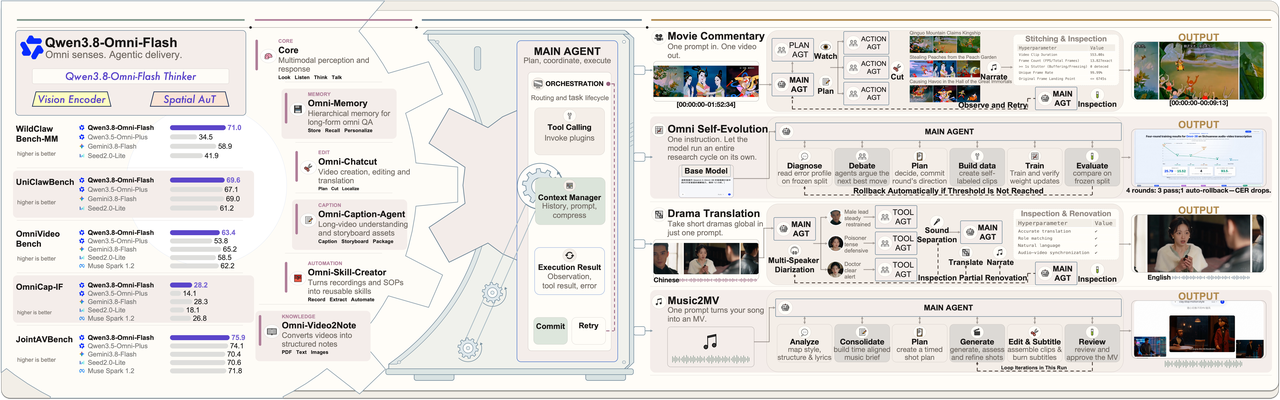
Qwen3.8-Omni-Flash en de toepassingen in productie. Bron: officieel lanceringsartikel van Alibaba Cloud.
Vergelijking van Qwen3.8-Omni-Flash met andere multimodale API's
Het praktische verschil zit niet alleen in benchmarkprestaties. Qwen3.8-Omni-Flash combineert lang contextvenster, native audio- en videobegrip, redeneringscontrole, tool calling, websearch en multikanaals audio in één API-georiënteerd model.
Mogelijkheid
Qwen3.8-Omni-Flash API in CometAPI
Typische tekst/VL-API
Specifieke ASR-API
Tekstinvoer
Ja
Ja
Beperkt
Afbeeldingsinvoer
Ja
Vaak
Nee
Audio-invoer
Ja
Verschilt
Ja
Video-invoer
Ja
Verschilt
Nee
Gezamenlijke audio-videoredenering
Ja
Verschilt
Nee
1M context
Ja
Verschilt
n.v.t.
Tool calling
Ja
Vaak
Meestal niet
Redeneringscontrole
Ja
Verschilt
Nee
Ruimtelijke/multikanaals audio
Ja
Zeldzaam
Verschilt
Primaire uitvoer
Tekst
Tekst
Transcript
Deze tabel is een vergelijking op categorieniveau, geen benchmark tegenover een genoemde concurrerende product. “Typisch” en “verschilt” beschrijven gangbare API-patronen; teams moeten eindpunten met naam vergelijken voordat ze een aankoop- of architectuurbeslissing nemen.
In de door de leverancier gerapporteerde agentvergelijking steeg OmniVideoBench van 63,4 naar 67,8 in agentmodus, terwijl het tokengebruik per query daalde van 145.736 naar 79.117. De officiële test vergelijkt statische inferentie met een agentmodus met Qwen Code en merkt op dat de agentmodus context over beurten heen bewaart. Dit zijn door de leverancier gerapporteerde resultaten, geen onafhankelijke productiebenchmark.
Hoe richt u de Qwen3.8-Omni-Flash API in en hoe roept u deze aan?
Een Qwen3.8-Omni-Flash API-sleutel verkrijgen
Maak een API-sleutel aan in Alibaba Cloud Model Studio / Qianwen AI Platform en bewaar deze in een omgevingsvariabele. De API-sleutel en het endpoint moeten tot dezelfde ondersteunde regio behoren.
Bash — stel de Alibaba Cloud Model Studio API-sleutel in voor de huidige shell:
export DASHSCOPE_API_KEY="your-api-key"
PowerShell — stel de API-sleutel in voor de huidige sessie:
$env:DASHSCOPE_API_KEY="your-api-key"
Ondersteunde regio’s zijn onder andere Beijing, Singapore, Hong Kong, Tokyo, Frankfurt en Virginia. Gebruik de API-sleutel en het werkruimte-specifieke endpoint uit dezelfde regio. De officiële endpoint-gids raadt speciale werkruimtedomeinen aan. In het onderstaande Singapore-voorbeeld moet {WorkspaceId} worden vervangen door de werkruimte-ID die in uw Model Studio-console wordt weergegeven. Bestaande DashScope-domeinen blijven werken, maar nieuwe voorbeelden zouden het aanbevolen werkruimte-endpoint moeten gebruiken.
Endpoint — OpenAI-compatibele basis-URL van de werkruimte in Singapore:
Uw eerste Qwen3.8-Omni-Flash API-aanroep uitvoeren
Omdat Alibaba Cloud een OpenAI-compatibele interface aanbiedt, kan de standaard OpenAI Python SDK worden gebruikt met een andere basis-URL en model-ID.
Bash — installeer of update de OpenAI Python SDK:
pip install -U openai
Python — stuur een basisaanvraag voor Chat Completions:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DASHSCOPE_API_KEY"],
    base_url="https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1",
)

response = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the advantages of native omnimodal models.",
    }],
)

print(response.choices[0].message.content)
cURL — roep hetzelfde compatibele endpoint direct aan:
Hoe gebruikt u multimodale input met de Qwen3.8-Omni-Flash API?
Afbeeldingen verzenden naar de Qwen3.8-Omni-Flash API
Afbeeldingen kunnen met tekst in hetzelfde bericht worden gecombineerd. Dit patroon is nuttig voor dashboardinterpretatie, documentbegrip, visuele QA, screenshots en multimodale agents.
Python — combineer een afbeelding-URL met een taakspecifieke instructie:
response = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{
        "role": "user",
        "content": [
            {
                "type": "image_url",
                "image_url": {"url": "https://example.com/dashboard.jpg"},
            },
            {
                "type": "text",
                "text": "Identify the main metrics and summarize any anomalies.",
            },
        ],
    }],
)

print(response.choices[0].message.content)
Audio verzenden naar de Qwen3.8-Omni-Flash API
Audio-invoer is nuttig voor vergadersamenvattingen, spraakbegrip, analyse van geluidevents en gecombineerde audio-visuele redenering. Vraag voor lange opnames om een gestructureerde output, zoals sprekers, beslissingen, actiepunten, openstaande vragen en tijdstempels.
Videoprompts moeten het bewijs en de gewenste outputstructuur definiëren. Een generiek “beschrijf deze video” verzoek verspilt vaak context aan irrelevante details, terwijl een taakgerichte vraag het model laat focussen op gebeurtenissen, tijdstempels, gesproken inhoud, on-screen tekst en discrepanties.
Prompt — vraag om chronologisch, met tijdstempels onderbouwd bewijs:
Analyze this product demonstration video.

Return:
1. A chronological summary.
2. Important visual steps with timestamps.
3. Spoken instructions.
4. Product names or UI text visible on screen.
5. Any discrepancy between the narration and the demonstrated action.
Python — stuur een video-URL samen met de gestructureerde prompt:
Het lanceringsartikel meldt dat agentische long-video-begrip de berekening kan focussen op relevante segmenten, waardoor het tokengebruik met ongeveer 45,7% daalt in het genoemde OmniVideoBench-experiment. Beschouw deze reductie als een door de leverancier gerapporteerd resultaat voor die evaluatieopzet, niet als een gegarandeerde besparing voor elke werklast.
Hoe stelt u de redeneringsinspanning in en streamt u Qwen3.8-Omni-Flash-antwoorden?
De redenering van Qwen3.8-Omni-Flash beheren
Qwen3.8-Omni-Flash ondersteunt low, medium en xhigh redeneringsinspanning, waarbij xhigh als standaard is gedocumenteerd. De compatibele API accepteert ook gemapte waarden; gebruik de modelspecifieke documentatie in plaats van aan te nemen dat elke OpenAI-redeneringswaarde een onderscheidend gedrag heeft.
Complexe redenering, agents, moeilijke multimodale taken
Python — kies de redeneringsdiepte expliciet:
response = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{
        "role": "user",
        "content": "Analyze the causes of the inconsistencies in this report.",
    }],
    reasoning_effort="medium",
)
Voor toepassingen met hoog volume stelt u de redeneringsdiepte expliciet in, in plaats van elke eenvoudige aanvraag op de hoogste inspanning te laten staan. Reserveer diepere redenering voor workflows waarbij extra analyse de uitkomst daadwerkelijk verbetert.
Qwen3.8-Omni-Flash-antwoorden streamen
Streaming vermindert de waargenomen latentie in interactieve applicaties en laat de UI antwoordinhoud weergeven zodra die binnenkomt.
Python — itereer over incrementele Chat Completions-uitvoer:
stream = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{
        "role": "user",
        "content": "Analyze this multimodal task and propose a workflow.",
    }],
    reasoning_effort="medium",
    stream=True,
)

for chunk in stream:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
Hoe krijgt u toegang tot Qwen3.8-Omni-Flash via CometAPI?
Qwen3.8-Omni-Flash API gebruiken in CometAPI
CometAPI biedt een OpenAI-compatibele integratielaag voor meerdere providers. Publieke modelpagina’s kunnen echter veranderen wanneer nieuwe endpoints worden uitgerold. Bevestig dat Qwen3.8-Omni-Flash API in CometAPI is ingeschakeld voor uw account voordat u het volgende voorbeeld als uitvoerbare productiecode behandelt.
Endpoint — OpenAI-compatibele basis-URL van CometAPI:
https://api.cometapi.com/v1
Bash — stel de CometAPI-sleutel pas in nadat u accounttoegang hebt bevestigd:
export COMETAPI_KEY="your-cometapi-key"
Python — conditioneel integratievoorbeeld:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="qwen3.8-omni-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the following content.",
    }],
)

print(response.choices[0].message.content)
Controleer vóór productieve uitrol de huidige modelidentifier, ondersteuning voor media-invoer, beschikbaarheid en prijzen in CometAPI, omdat recent vrijgegeven modeleindpunten kunnen veranderen naarmate de providerondersteuning wordt bijgewerkt.
Welke parameters en productiepraktijken zijn het belangrijkst?
Essentiële Qwen3.8-Omni-Flash API-parameters
Parameter
Doel
Praktische richtlijn
model
Selecteert model
Gebruik qwen3.8-omni-flash
messages
Conversatie en multimodale invoer
Gebruik getypeerde contentblokken voor media
stream
Incrementele uitvoer
Aanbevolen voor interactieve apps
reasoning_effort
Redeneringsdiepte
Kies low / medium / xhigh expliciet
enable_thinking
Thinking-gedrag
Geef de voorkeur aan reasoning_effort voor dit model; controleer modelspecifieke compatibiliteit voor gebruik
preserve_thinking
Redeneringsstatus gesprek
Doorgeven via extra_body; behouden redeneren verhoogt het gebruik van invoertokens
use_multichannel
Multikanaals audio
Alleen inschakelen wanneer kanaalinformatie ertoe doet
max_tokens
Outputcontrole
Voor productie begrenzen
Beste gebruiksscenario’s voor de Qwen3.8-Omni-Flash API
Het model is het nuttigst wanneer de relatie tussen modaliteiten ertoe doet. Goede kandidaten zijn vergaderintelligentie, langvormige videoanalyse, mediazoekopdrachten, multimodale onderzoeksagents, extractie uit trainingsvideo’s, analyse van klantenondersteuningsopnames en workflows waarbij audio-visueel bewijs tools activeert.
Gebruik Qwen3.8-Omni-Flash wanneer de relatie tussen modaliteiten ertoe doet, niet alleen wanneer uw applicatie toevallig meerdere bestandstypen bevat.
Veelvoorkomende Qwen3.8-Omni-Flash API-fouten
Probleem
Waarschijnlijke oorzaak
Oplossing
401 Unauthorized
Ongeldige of ontbrekende sleutel
Controleer de omgevingsvariabele en API-sleutel
Model niet beschikbaar
Regio-, provider- of uitrolmismatch
Verifieer modelbeschikbaarheid in de gekozen regio en provideraccount
Media kan niet worden opgehaald
Media-URL niet toegankelijk
Gebruik een ondersteunde, bereikbare mediabron
Hoge latentie
Hoge redeneringsinspanning voor eenvoudige taak
Test medium of low redenering
Onverwachte tokenkosten
Grote media of behouden geschiedenis
Snoei de context en inspecteer de behouden conversatiestatus
Ruimtelijke cues genegeerd
Multikanaalsmodus uitgeschakeld
Schakel use_multichannel in
Matig videovoorstel
Te brede prompt
Specificeer gebeurtenissen, tijdstempels en outputformaat
Zeer grote respons
Ontbrekende outputbeperkingen
Stel expliciete responstlengte en schema in
Voor productiesystemen voegt u ook aanvraag-timeouts toe, retries met exponentiële backoff, gebruikslogging, validatie van gestructureerde output en waarborgen rondom extern aangeleverde media-URL’s.
Kosten en latentie optimaliseren voor de Qwen3.8-Omni-Flash API
De grootste besparingen komen meestal van het beheersen van mediavolume en redeneringsdiepte, in plaats van het micro-optimaliseren van een korte systeemprompt. Gebruik low voor extractie en classificatie, medium voor routinematige analyse en xhigh alleen wanneer extra redenering gerechtvaardigd is.
Beperk bij lange video de vraag en vraag om bewijs met tijdstempels. Gebruik waar passend ondersteunde caching voor herhaalde grote contexten. Vermijd het meeslepen van onnodige eerdere redenering of media door een lang gesprek wanneer dit niet meer bijdraagt aan de volgende beurt.
Veelgestelde vragen
Ondersteunt Qwen3.8-Omni-Flash afbeeldingen?
Ja. Het accepteert afbeeldingen naast tekst, audio en video.
Ondersteunt Qwen3.8-Omni-Flash audio?
Ja. Audio is een native invoermodaliteit en kan worden gebruikt voor transcriptie, vergaderanalyse, begrip van geluidevents en multimodale redenering.
Genereert Qwen3.8-Omni-Flash audio?
De hier gedocumenteerde standaard niet-realtime qwen3.8-omni-flash API retourneert tekst. Qwen3.8-Omni-Flash-Realtime is een apart realtime product.
Wat is het contextvenster van Qwen3.8-Omni-Flash?
Het gedocumenteerde contextvenster is 1 miljoen tokens.
Wat is de maximale output van Qwen3.8-Omni-Flash?
Alibaba Cloud documenteert momenteel een maximale outputlengte van 131.072 tokens.
Is Qwen3.8-Omni-Flash compatibel met de OpenAI SDK?
Ja. Alibaba Cloud biedt een OpenAI-compatibele interface, zodat de standaard OpenAI Python-client kan worden gebruikt met de juiste basis-URL.
Kan Qwen3.8-Omni-Flash video met geluid analyseren?
Ja. Gezamenlijk audio-videobegrip is een van de belangrijkste use-cases van het model.
Ondersteunt Qwen3.8-Omni-Flash function calling?
Ja. Aangepaste function calling wordt ondersteund.
Kan ik Qwen3.8-Omni-Flash via CometAPI gebruiken?
Controleer de huidige CometAPI-modelpagina en uw accountdashboard. Publiceer uitvoerbare CometAPI-voorbeelden pas nadat het endpoint en de vereiste mediamodaliteiten voor het doelaccount zijn bevestigd.
Conclusie
Qwen3.8-Omni-Flash is het meest overtuigend wanneer een applicatie moet redeneren over wat zij leest, ziet en hoort, in plaats van elke modaliteit als een afzonderlijke preprocessing-pijplijn te behandelen. Het lange contextvenster, het native audio- en videobegrip, de redeneringsbesturing, function calling, websearch en OpenAI-compatibele interfaces maken het bijzonder geschikt voor multimodale agents, vergaderintelligentie, langvideo-analyse en media-automatisering.
Voor directe toegang biedt Alibaba Cloud Model Studio het native Qwen API-oppervlak. Voor teams die een multi-provider gateway gebruiken, kan CometAPI een uniforme integratieroute bieden nadat het modeleindpunt, de modaliteiten en prijzen zijn bevestigd voor het doelaccount. In beide gevallen hangt de productiekwaliteit af van doelgerichte beheersing van mediacontext, redeneringsinspanning, conversatiestatus, outputbeperkingen en foutafhandeling.