Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
MiniMax M3.1 Flash-handleiding: prestaties en kosten voor agenten
Verken de prestaties van MiniMax M3.1 Flash, benchmarks, API-prijzen, inferentiesnelheid en kosten per agenttaak. Vergelijk programmeer- en automatiseringsmogelijkheden.
Deon GoodwinOnderzoeksteam voor AI-modellen en API
MiniMax M3.1 Flash is een snel AI-model ontworpen voor autonome agents, software-engineering, computergebruik en complexe workflow-automatisering. Officieel uitgebracht op 19 oktober 2026, combineert het een contextvenster van 1 miljoen tokens met configureerbare redeneerintensiteit en lagere inferentiekosten.
MiniMax meldt tot 200+ outputtokens per seconde, een kostenreductie van 70% voor agent-workloads vergeleken met zijn voorganger, en concurrerende prestaties op Automation-Bench, DeepSWE en OSWorld. Met $0,15 per miljoen invoertokens en $0,60 per miljoen uitvoertokens maakt het model meertraps AI-agentworkflows goedkoper.
Key Takeaways
MiniMax M3.1 Flash-prestaties: Door de leverancier gerapporteerde benchmarks omvatten Automation-Bench 62,8, DeepSWE v1.1 73,7 en OSWorld 2.0 61,7, wat de capaciteiten voor agentautomatisering, coderen en computergebruik benadrukt.
MiniMax M3.1 Flash API-prijzen: Officiële tarieven zijn $0,15/M input, $0,60/M output en $0,015/M gecachte input. CometAPI-tarieven zijn $0,80/M input en $3,20/M output per 21 oktober 2026, zonder gepubliceerd cachetarief op de modelpagina.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
MiniMax M3.1 Flash-inferentiesnelheid: MiniMax meldt 200+ tokens/s onder gunstige omstandigheden en P50-doorvoer boven 170 tokens/s, wat responsieve agentworkflows ondersteunt.
MiniMax M3.1 Flash agent-efficiëntie: Vijf redeneerinspanningsniveaus stellen ontwikkelaars in staat het evenwicht te bewaren tussen taakvoltooiing, latentie en totale AI-agentkosten.
MiniMax M3.1 Flash API-toegang: Ontwikkelaars hebben toegang tot het uitgebracht model via MiniMax of kunnen CometAPI-integratie verkennen met providerspecifieke modelidentifiers en prijzen.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash is een next-gen taalmodel geoptimaliseerd voor agentisch redeneren, coderen, toolgebruik en autonome workflow-executie. MiniMax introduceerde M3.1 Flash officieel op 19 oktober 2026.
In plaats van zich uitsluitend te richten op conversatie-intelligentie of geïsoleerde scores, richt het zich op de totale kosten van het voltooien van taken via herhaald redeneren, tool-calls en meertraps executie. MiniMax associeerde de vroege ontwikkeling ook met Space Bunny, een anoniem uitgerold model waarvan wordt gezegd dat het meer dan 200 biljoen tokens heeft verwerkt vóór de aankondiging; dit is een gerapporteerde gebruikswaarde, geen gepubliceerd aantal trainingstokens.
Voor ontwikkelaars die autonome code-assistenten, enterprise AI-collega’s en browsergebaseerde agents bouwen, biedt M3.1 Flash drie relevante voordelen: grote contextcapaciteit, snelle generatie en lage tokenkosten.
Tekst, afbeelding en video via MiniMax's OpenAI-compatibele API; bevestig ondersteuning bij andere providers
Uitvoermodaliteit
Tekst
Regelingen voor redeneren
Low, medium, high, xhigh, max
Gerapporteerde uitvoersnelheid
Tot 200+ tokens/s
Gerapporteerde P50-snelheid
170+ tokens/s
Toegangskanalen
MiniMax API, M Plan, MiniMax Code
Open gewichten
Aangekondigd voor toekomstige release
M3.1-specifiek aantal parameters
Niet vastgesteld in de aankondiging
Een groot contextvenster is waardevol voor coding op repository-schaal en documentzware workflows, maar garandeert geen perfecte recall. Productie-agents moeten nog steeds selectieve retrieval, gestructureerde tool-responses en contextcompressie gebruiken.
Vijf instellingen voor redeneerinspanning laten ontwikkelaars intensieve computation reserveren voor complexe planning en debugging in plaats van maximale inspanning te leveren voor elke classificatie, extractie of eenvoudige toolselectiestap. Omdat één agentrequest tientallen modelaanroepen kan triggeren, kunnen kleine besparingen over routinestappen de totale kosten materieel verlagen.
How Does MiniMax M3.1 Flash Perform on Benchmarks?
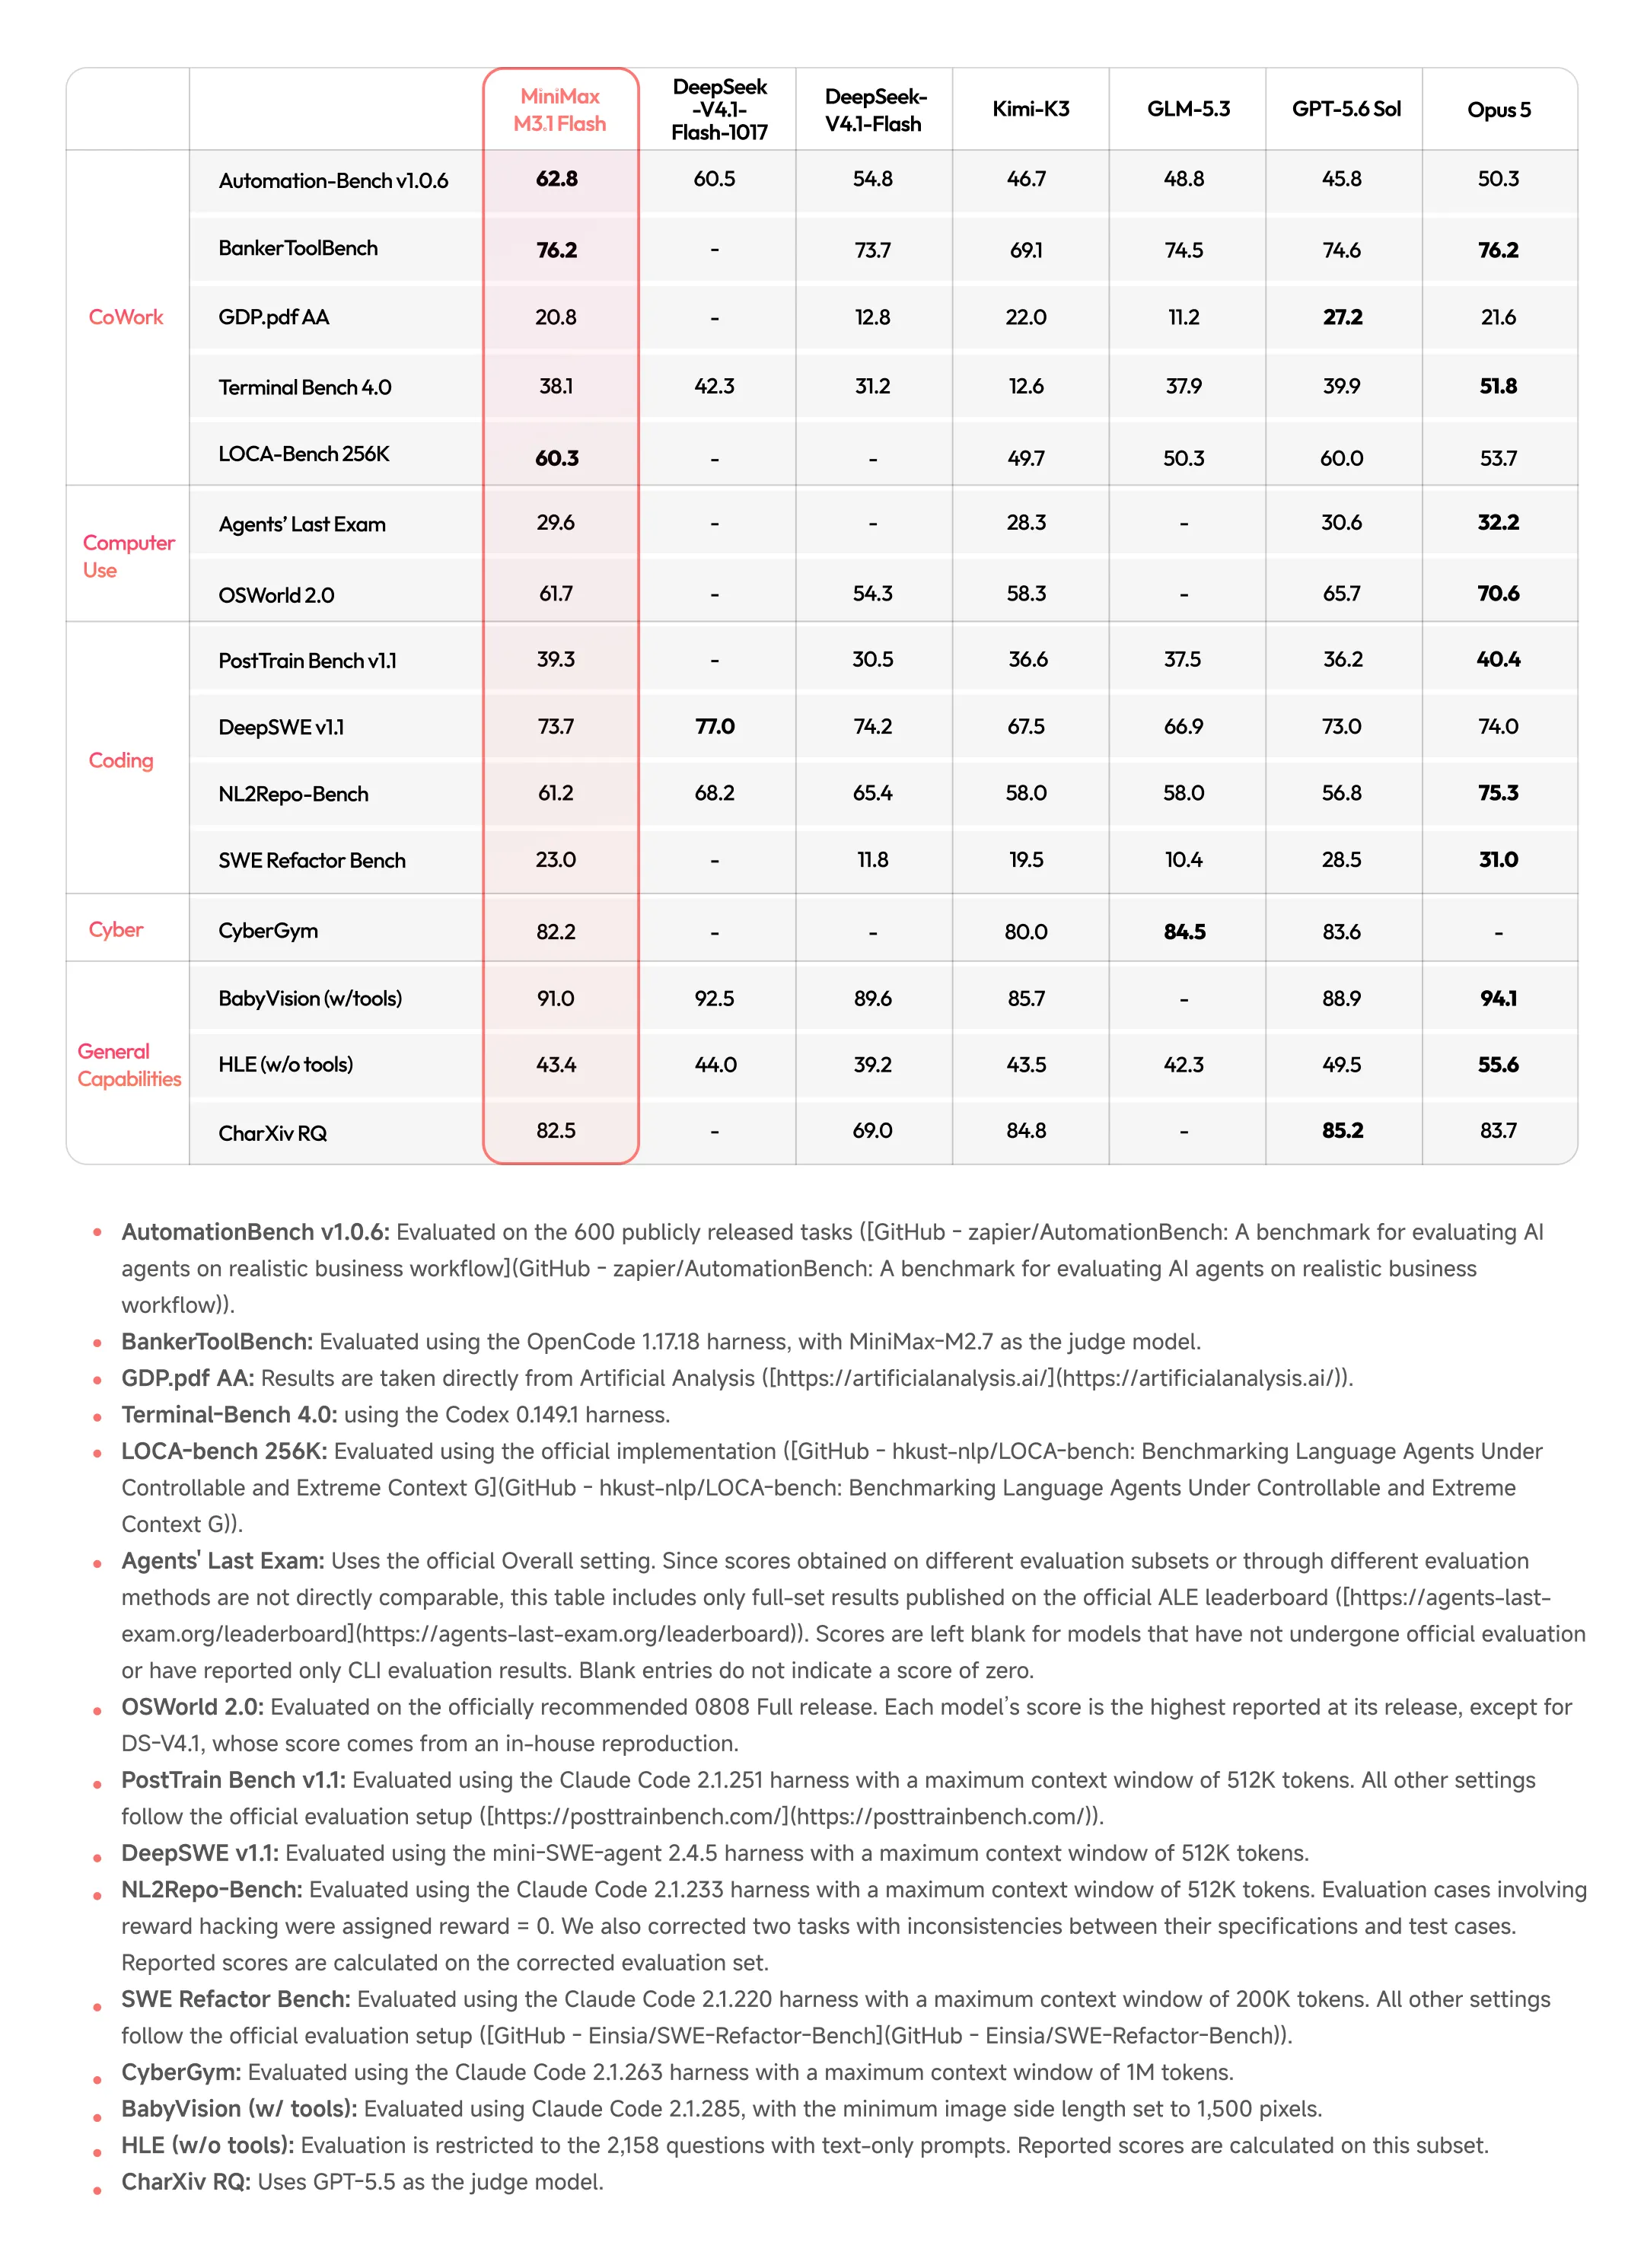
MiniMax rapporteert benchmarkresultaten die zakelijke automatisering, software-engineering, computergebruik, cybersecurity en multimodale redenering bestrijken. Dit zijn door de leverancier gerapporteerde evaluaties en geen vervanging voor onafhankelijk testen van een echte deployment.
MiniMax's officiële benchmarkvergelijking, inclusief evaluatienotities. Scores zijn door de leverancier gerapporteerd en vertegenwoordigen geen uniforme onafhankelijke test.
Officiële benchmarkresultaten
M3.1 Flash
Wat het meet
Automation-Bench v1.0.6
62.8
Meertraps bedrijfsautomatisering
BankerToolBench
76.2
Financiële redenering en tools
LOCA-Bench 256K
60.3
Agent-executie met lange context
DeepSWE v1.1
73.7
Autonome software-engineering
Terminal Bench 4.0
38.1
Probleemoplossing via terminal
OSWorld 2.0
61.7
Desktop-/computerinteractie
Agents’ Last Exam
29.6
Complexe economische taken
CyberGym
82.2
Cybersecurity-probleemoplossing
BabyVision with tools
91.0
Visueel redeneren met tools
HLE without tools
43.4
Uitdagende kennis en redeneren
Automation-Bench v1.0.6 gebruikt 600 publieke taken. BankerToolBench gebruikt OpenCode 1.17.18 met MiniMax-M2.7 als judge; Terminal Bench 4.0 gebruikt Codex 0.149.1. DeepSWE v1.1 gebruikt mini-SWE-agent 2.4.5 met een 512K contextlimiet. OSWorld gebruikt de 0808 Full release: de tabel combineert de hoogste releasescore van elk model, behalve DeepSeek V4.1, die MiniMax intern reproduceerde. Deze verschillende setups beperken directe conclusies over modellen heen.
Voor bedrijfsautomatisering krijgen Automation-Bench en BankerToolBench prioriteit; voor coding-agents, bekijk DeepSWE en terminalgebaseerde resultaten. OSWorld evalueert interacties met een computeromgeving in plaats van alleen instructies te genereren. Eén aggregatescore kan taak-specifieke analyse niet vervangen.
How Fast Is MiniMax M3.1 Flash?
Agentsystemen doen vaak veel sequentiële modelcalls, dus doorvoer alleen kan responsiviteit niet beschrijven.
Snelheidsmetriek
Gerapporteerde prestaties
Dagelijkse piekdoorvoer voor output
200+ tokens/s
Medianedoorvoer voor output (P50)
170+ tokens/s
Verbetering van online inferentie
Bijna 3× vs prior generation
Kostenreductie van agent-workload
70% vs predecessor
Deze door de leverancier gerapporteerde snelheid- en workloadkosten beschrijven MiniMax's lanceringsevaluatie, geen gegarandeerde doorvoer of besparingen voor elke applicatie. Serving-hardware, gelijktijdigheid, promptlengtes en variabiliteit tussen herhalingen zijn niet volledig gespecificeerd in de aankondiging.
End-to-end latentie omvat ook first-token vertraging, redeneer-overhead, toeltijd, retries en afhankelijkheden tussen stappen. Een snellere generator kan zijn voordeel verliezen als een agent meer aanroepen nodig heeft om dezelfde taak te voltooien.
How Much Does MiniMax M3.1 Flash API Cost?
MiniMax kondigde vlakke standaardtarieven aan voor M3.1 Flash zonder een apart hoger long-context tier in de initiële prijsbeschrijving. Ondertussen biedt de MiniMax M3.1 Flash Preview API in CometAPI een aparte prijsstructuur met 20% korting ten opzichte van de weergegeven referentietarieven.
Prijscategorie
Officiële M3.1 Flash
CometAPI Preview (≤512K)
CometAPI Preview (>512K)
Invoertokens / 1M
$0.15
$0.24
$0.48
Uitvoertokens / 1M
$0.60
$0.96
$1.92
Gecachete invoer / 1M
$0.02
$0.05
$0.10
Prijsstructuur
Flat rate
Korte-context tier
Lange-context tier
De officiële MiniMax API-prijzen maken M3.1 Flash bijzonder aantrekkelijk voor agent-workloads. Uitvoertokens kosten vier keer het standaard invoertarief, terwijl gecachete invoer een tiende kost. Herhaalde instructies en toolgeschiedenissen kunnen daardoor een belangrijk optimalisatiedoel worden.
CometAPI's Preview-prijzen beginnen bij $0,24 per miljoen invoertokens en $0,96 per miljoen uitvoertokens, wat een 20% korting vertegenwoordigt ten opzichte van de weergegeven Preview-referentieprijzen. Deze tarieven blijven echter hoger dan de nieuw aangekondigde officiële M3.1 Flash-prijzen omdat de twee aanbiedingen verschillende prijsbaselines hanteren.
Voor ontwikkelaars is het belangrijkste onderscheid dat CometAPI een uniforme integratie-ervaring biedt, terwijl de officiële release momenteel lagere gepubliceerde tokenprijzen biedt. Verifieer vóór deployment de actieve modelversie, contextlengte-tier en factureringsregels om de kosten van autonome agentworkflows nauwkeurig te schatten.
Illustratieve berekeningen, geen geobserveerde facturering. Gaat ervan uit dat gecachte reads in aanmerking komen voor het aangekondigde cachetarief; exclusief kosten voor tools, zoekopdrachten, browser, infrastructuur en menselijke review.
Reasoning Effort and Task Cost
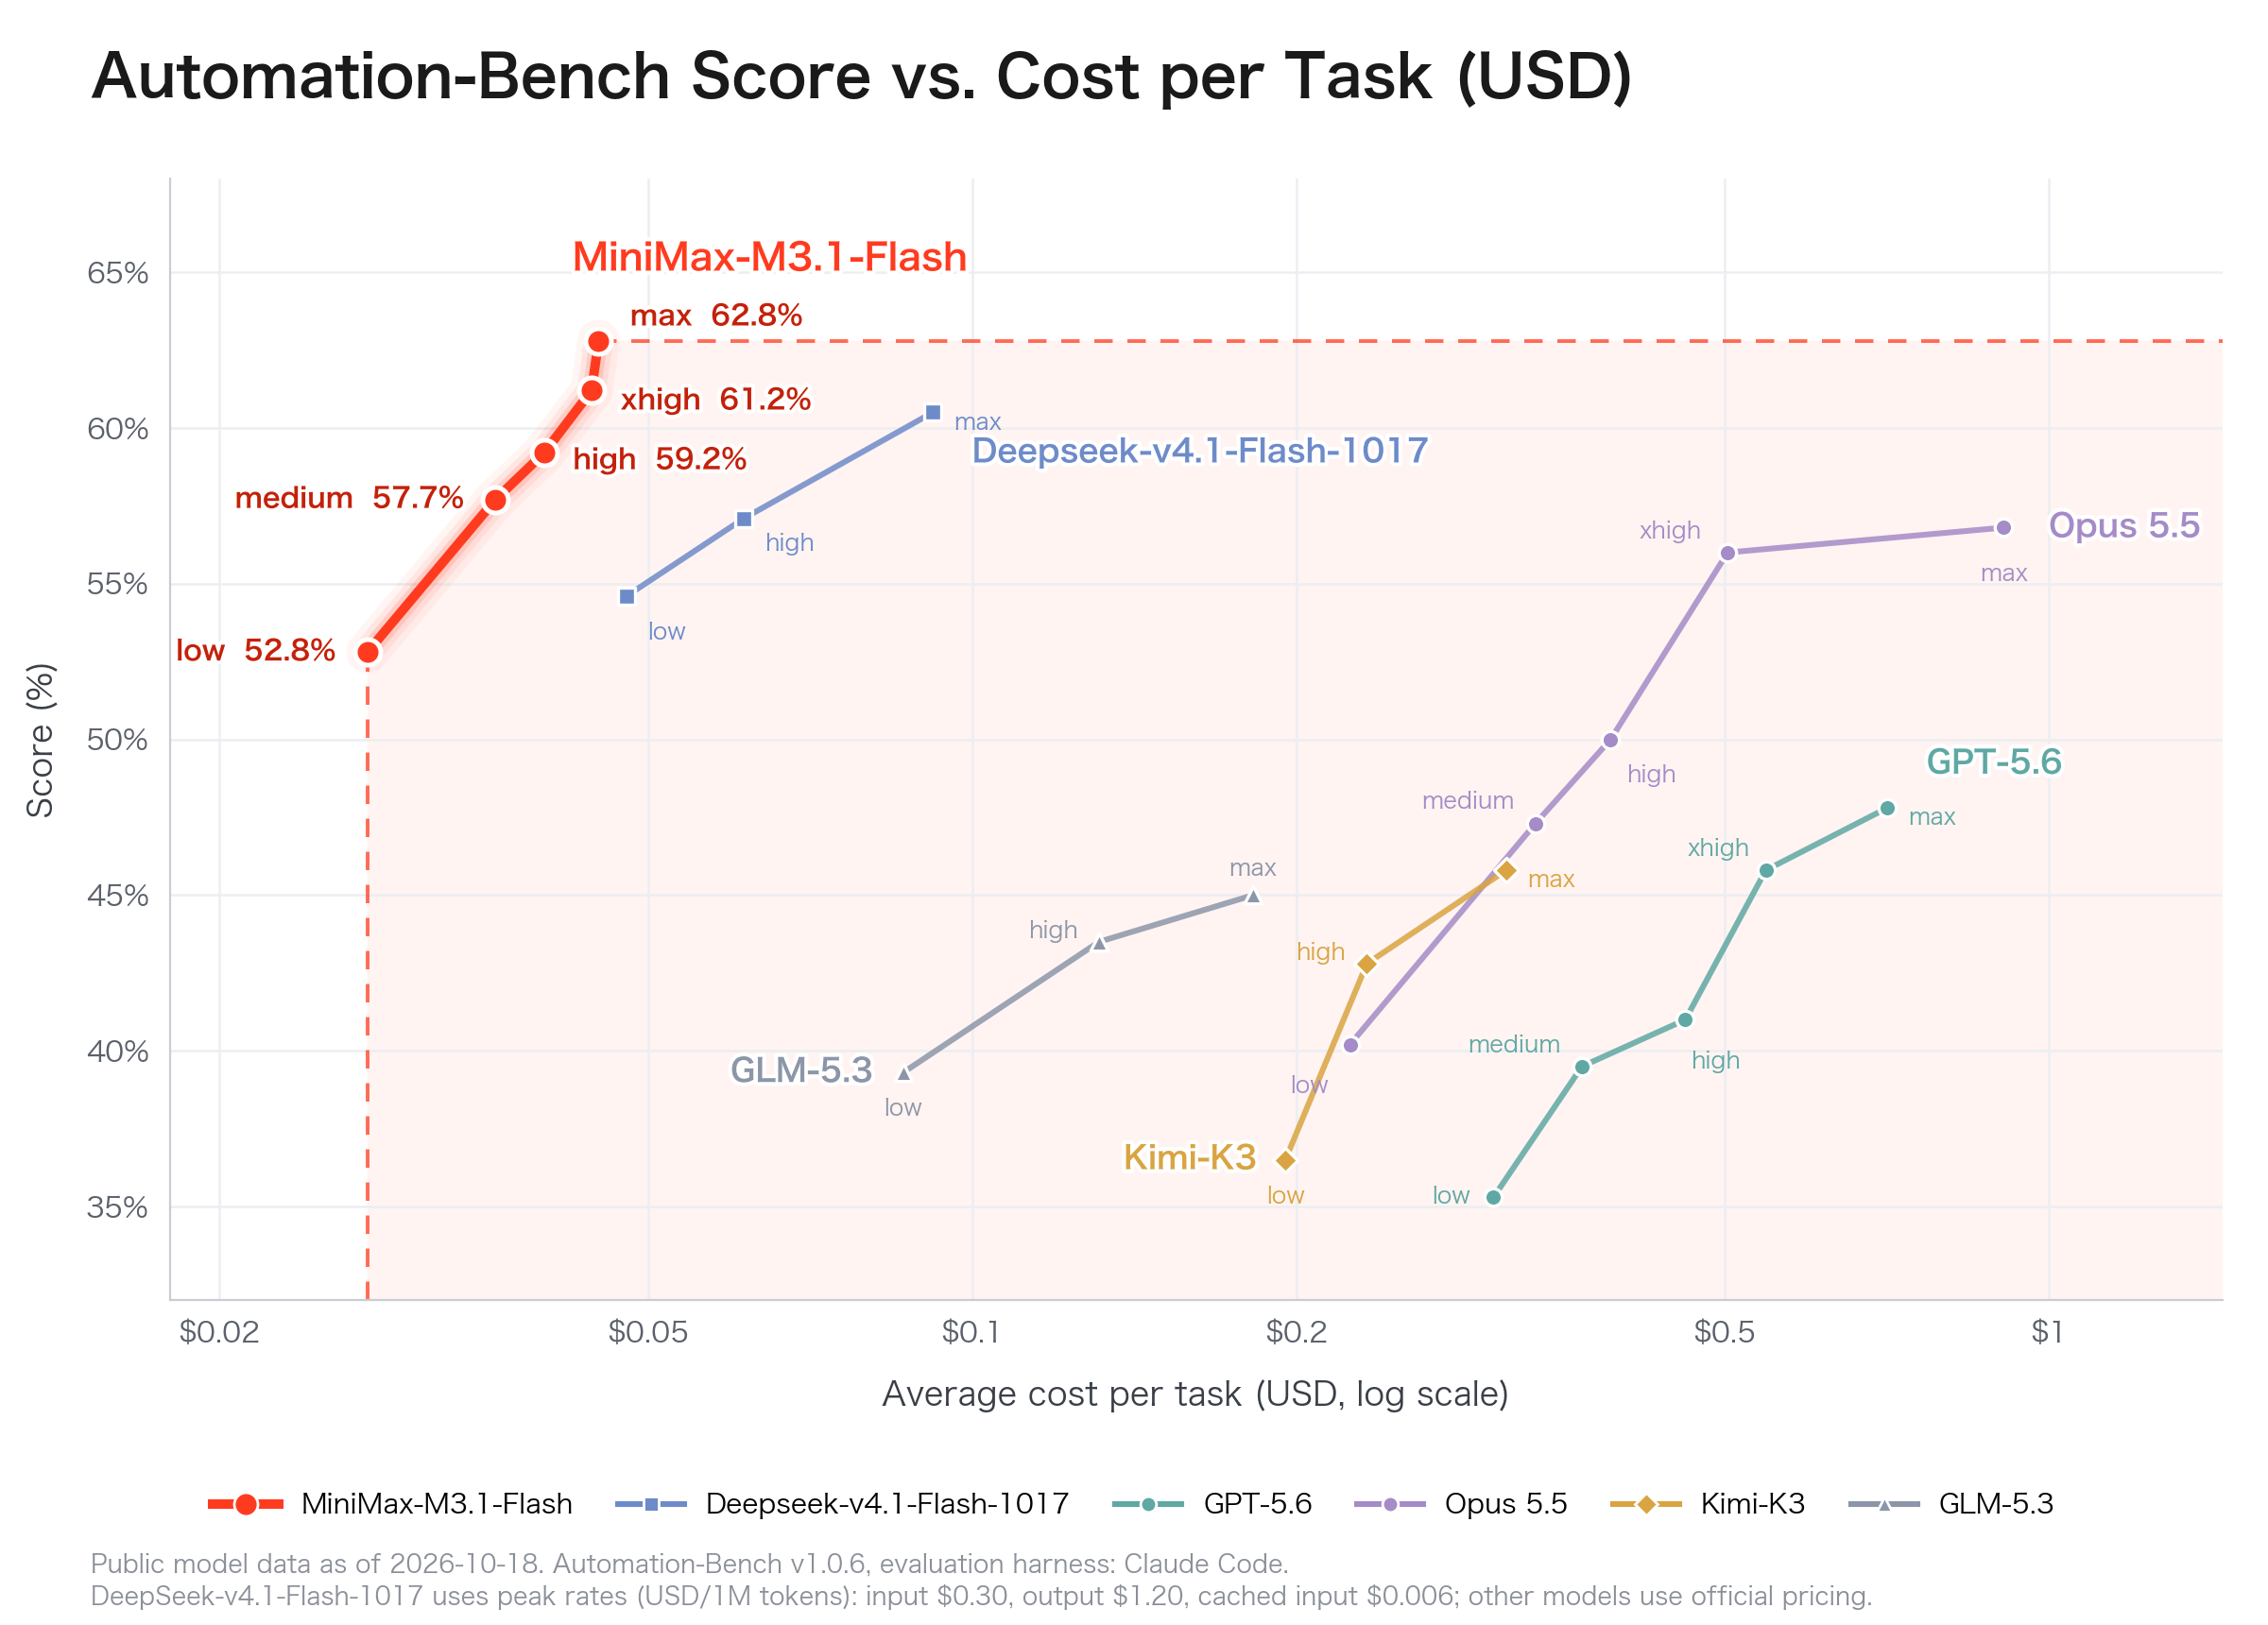
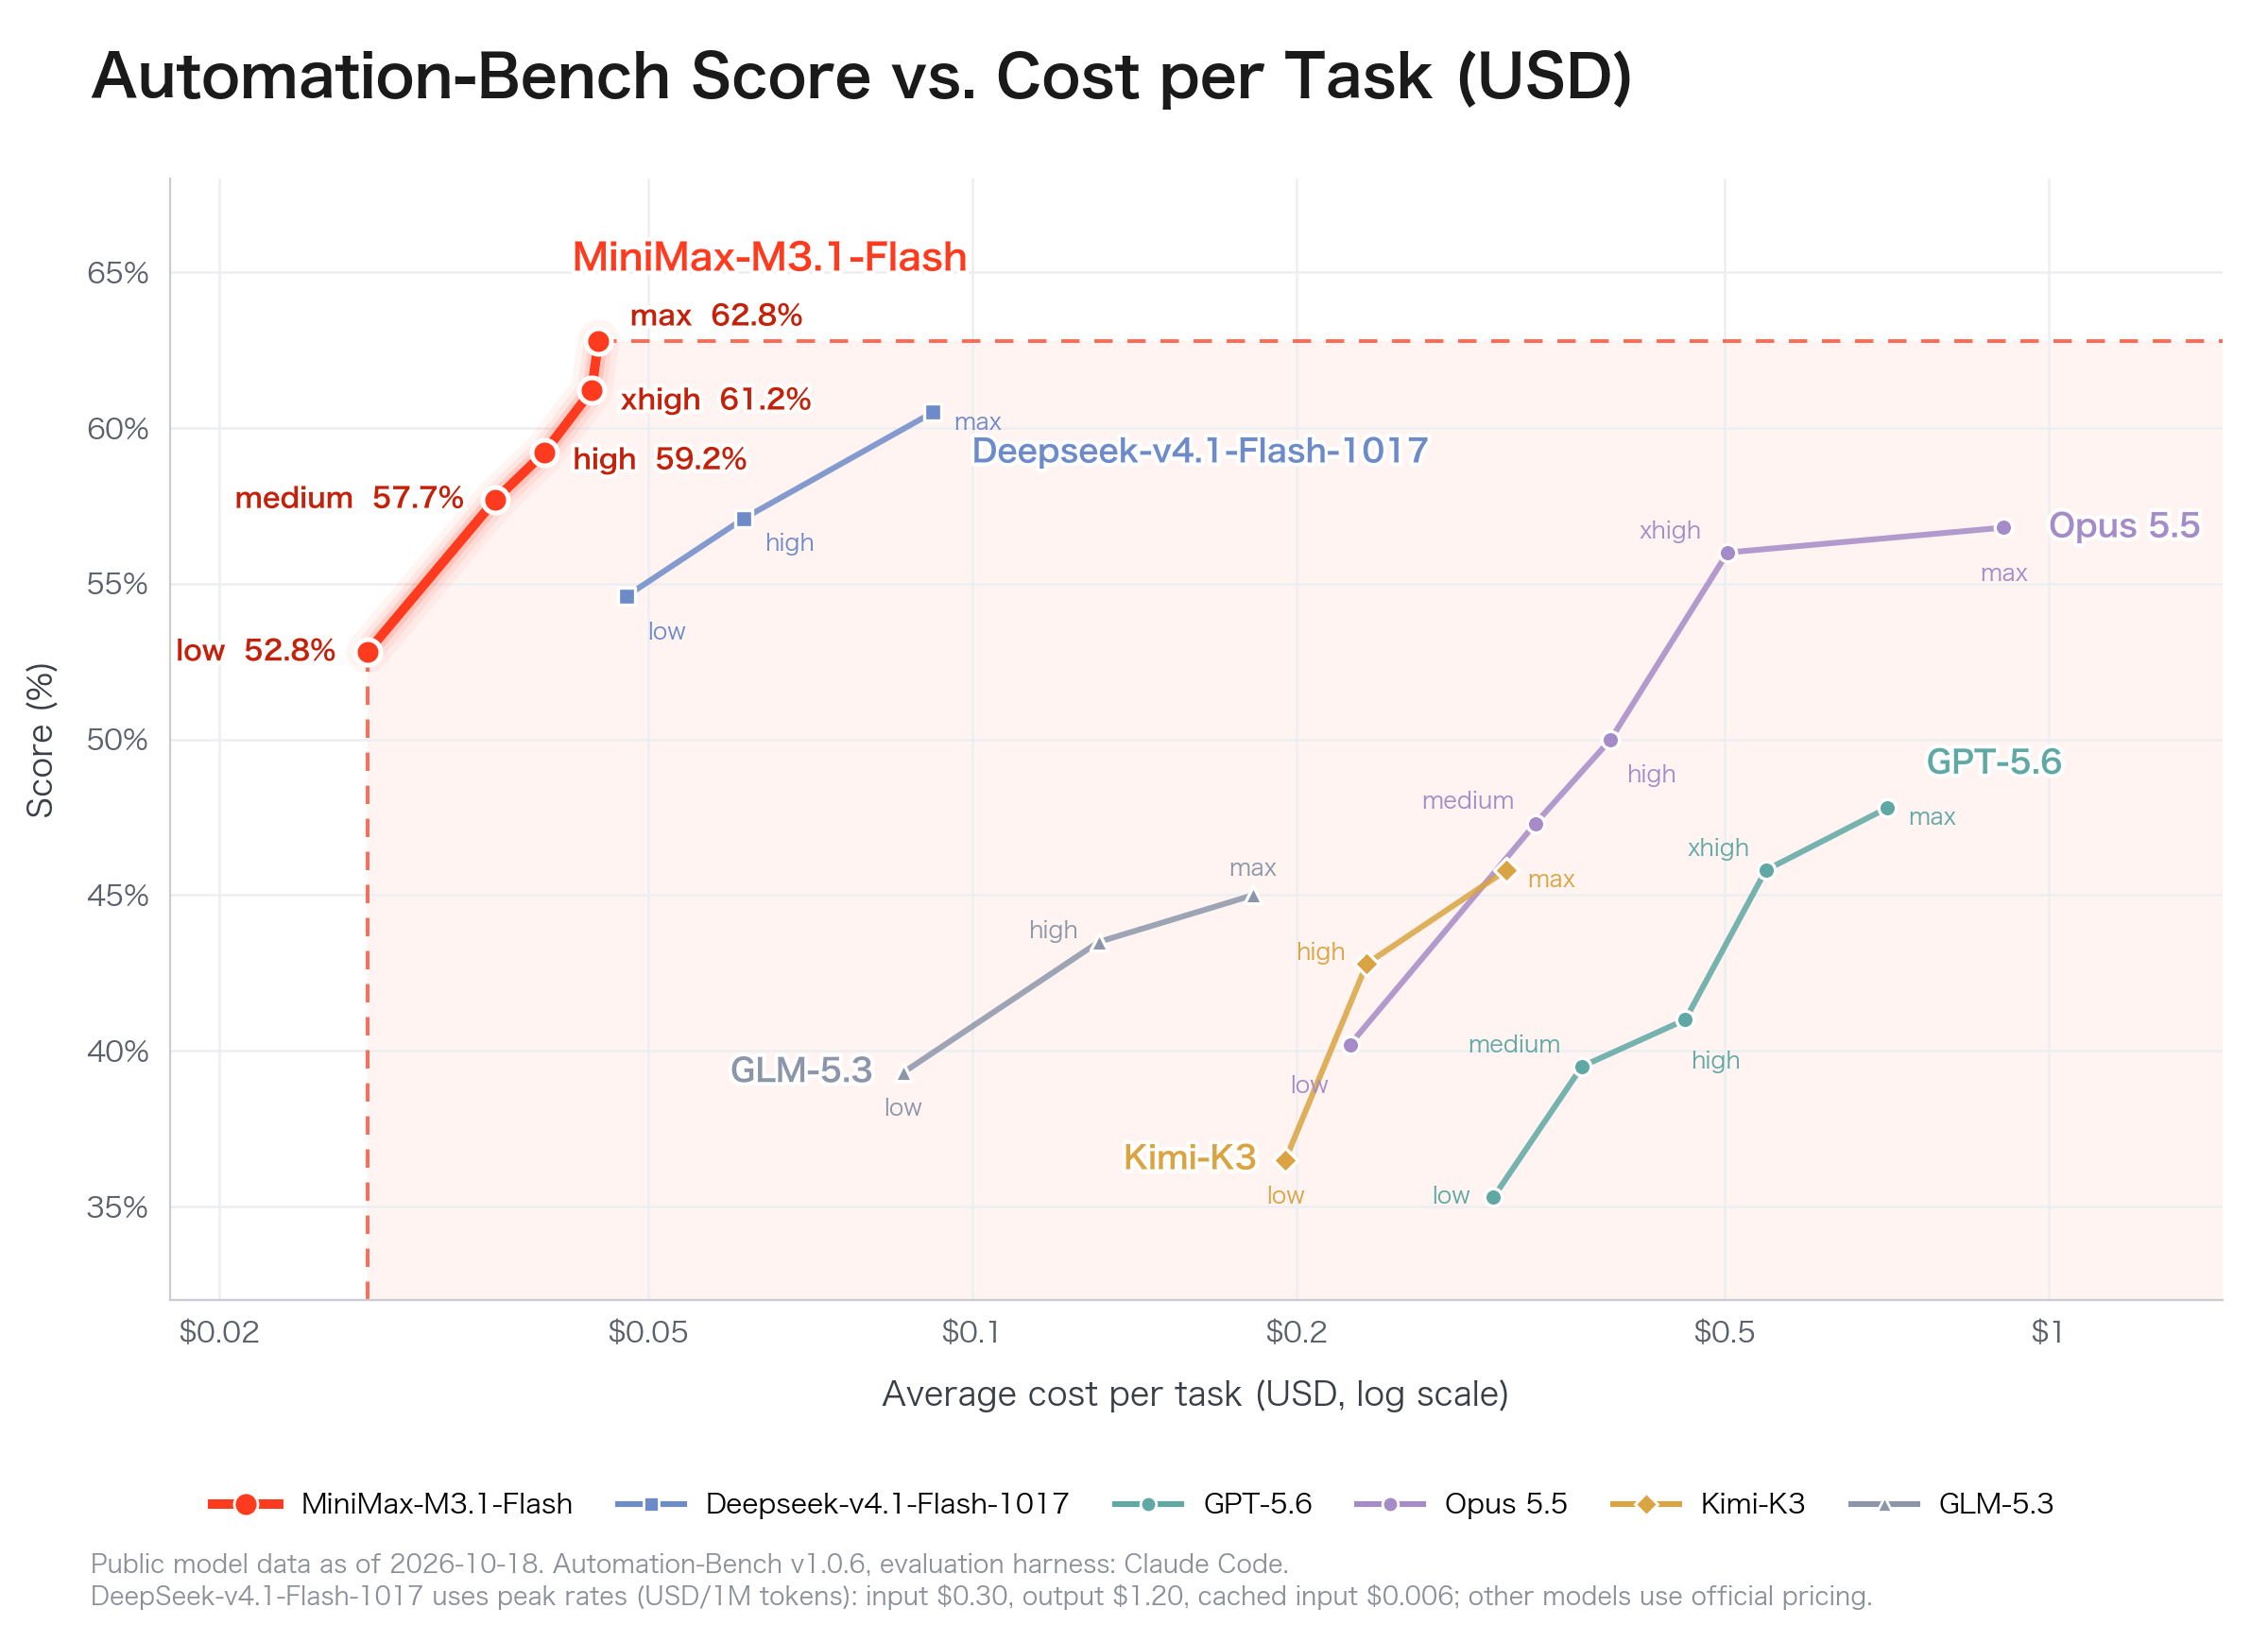
MiniMax’s Automation-Bench-kostenanalyse verbindt redeneerinspanning met benchmarksucces en inferentiebesteding per taak.
MiniMax's officiële score-versus-kosten diagram voor Automation-Bench. De horizontale as is logaritmisch; exacte dollarbedragen worden niet afgedrukt voor de individuele MiniMax-punten.
De officiële notities bij het diagram specificeren Automation-Bench v1.0.6 met de Claude Code-harnas en publieke modeldata per 18 oktober 2026. DeepSeek gebruikt piek-tokenprijzen; de andere modellen gebruiken officiële prijzen. Hardwaredetails en betrouwbaarheidsintervallen bij herhaalde runs zijn niet gespecificeerd.
Redeneerinspanning
Gelabelde Automation-Bench-score
Low
52.8%
Medium
57.7%
High
59.2%
Xhigh
61.2%
Max
62.8%
De huidige officiële vergelijkingstabel en het max-inspanningspunt tonen beide 62,8. De kostenkromme vergelijkt inspanningsinstellingen binnen de setup van de leverancier; het stelt geen vaste dollarkosten vast voor een productie-agent.
De gelabelde score stijgt met 10 procentpunten van low naar max inspanning. Vergelijk voor deployment medium en hogere inspanning op een vaste taakset, waarbij mislukte pogingen en retries worden meegeteld in de totale uitgaven. Kies de instelling die aan de kwaliteitseis voldoet tegen de laagste gemeten kosten per geaccepteerde taak.
How Can Developers Access MiniMax M3.1 Flash Through CometAPI?
Ontwikkelaars kunnen toegang krijgen tot de MiniMax M3.1 Flash API in CometAPI. De publieke catalogus gecontroleerd op 20 oktober 2026 toont de model-ID minimax-m3.1-flash, hoewel de URL een preview-suffix behoudt. Gebruik de model-ID die voor je account beschikbaar is, in plaats van een API-identifier af te leiden uit de pagin URL.
Stuur een POST-aanvraag naar https://api.cometapi.com/v1/chat/completions met Authorization: Bearer YOUR_COMETAPI_KEY en Content-Type: application/json. Stel in de JSON-body model in op minimax-m3.1-flash (indien ingeschakeld voor je account) en geef een messages array op. Zie de CometAPI-documentatie voor-aanvraagdetails.
Waarom CometAPI gebruiken? De uniforme API-sleutel, compatibele aanvraagindeling en gebruikdashboard kunnen het werken met modellen van verschillende providers vereenvoudigen. Voor MiniMax M3.1 Flash weeg je dat integratiegemak af tegen de providerspecifieke prijzen hierboven en verifieer je de functies die beschikbaar zijn voor je account.
Which AI Agents Benefit Most From MiniMax M3.1 Flash?
Gebruiksscenario
Waarom het mogelijk past
Implementatieoverweging
Enterprise-automatisering
Sterke Automation-Bench-resultaten
Valideer tools en herpogingen
Code-assistenten
Concurrerende DeepSWE-prestaties
Voer tests uit en beoordeel patches
Klantenondersteuning
Lage input- en cacheprijzen
Monitor de nauwkeurigheid
Onderzoeksagents
1M contextvenster
Controleer bewijs en bronnen
Computer-use agents
OSWorld-capaciteit
Omgaan met UI-wijzigingen en herstel
Security code review
CyberGym-resultaat
Onafhankelijke verificatie
De voordelen zijn het sterkst wanneer een agent genoeg taken correct voltooit om kosten voor retries, orkestratie en review te compenseren. Productiegebruik moet zowel modelniveau- als workflowniveau-prestaties meten.
Is MiniMax M3.1 Flash the Best Value for AI Agents?
MiniMax M3.1 Flash is een sterke optie voor kosten-gevoelige agents met herhaalde context en gestructureerde tools, maar de laagste tokenprijs levert niet altijd de laagste kosten per succesvolle taak op. Mislukte calls, extra retries en menselijke interventie kunnen besparingen tenietdoen. Evalueer acceptatiegraad, end-to-end tijd, totale kosten per succesvolle taak en de mate van menselijke interventie.
FAQ
Waarom kan MiniMax M3.1 Flash een leeg antwoord teruggeven?
Op MiniMax's eigen OpenAI-compatibele API verbruiken thinking tokens het generatiebudget. Een limiet die te klein is kan een request beëindigen met finish_reason ingesteld op length voordat zichtbare antwoordtekst is geproduceerd. Inspecteer de finish reason en token usage, verhoog het completion budget wanneer passend, en behandel reasoning_content apart van het uiteindelijke antwoord. Bevestig dezelfde response-semantiek op een route van derden.
Hoe moet de tool-call geschiedenis van MiniMax M3.1 Flash worden opgeslagen?
Bewaar het volledige assistant-bericht, inclusief tool-calls en reasoning content, voordat je de bijpassende toolresultaten toevoegt. Alleen het zichtbare antwoord opslaan kan informatie verwijderen die nodig is voor de volgende stap. Behoud tool-call IDs en berichtvolgorde, en valideer het replay-gedrag via het daadwerkelijke provider endpoint. MiniMax's richtlijnen voor gesprekshistorie beschrijven de vereisten van de native API.
Hoe kunnen teams routeringswijzigingen van MiniMax M3.1 Flash detecteren?
Houd een kleine regressiesuite bij met vaste inputs, verwachte outputstructuur en tool-call-asserties. Noteer de aangevraagde model ID, geretourneerde modelidentifier indien aanwezig, provider, timestamp en gefactureerde usage. Voer deze opnieuw uit na providerupdates; een stabiel alias alleen toont niet aan dat het onderliggende checkpoint of gedrag ongewijzigd is.
Hoe moet een MiniMax M3.1 Flash-migratie worden gefaseerd?
Begin met read-only of gereplayde taken, routeer vervolgens een klein deel van live verkeer terwijl je een geteste fallback behoudt. Definieer rollback-drempels voor ongeldige tool-calls, timeouts en niet-succesvolle taken voordat je het verkeer verhoogt. Bekijk voorbeelden van regressies in plaats van alleen op gemiddelde scores te vertrouwen, omdat een klein aantal kostbare fouten lagere tokenprijzen kan overschaduwen.
Conclusion
MiniMax M3.1 Flash verbetert de economie van autonome AI-agents via goedkope tokens, configureerbaar redeneren, een groot contextvenster en sterke gerapporteerde automatiserings- en coderesultaten. Het belangrijkste voordeel is de balans tussen prestaties, latentie en taakkosten—niet absolute superioriteit op elke benchmark.
Ontwikkelaars moeten werkelijke workflowvoltooiingspercentages en totale agentkosten valideren, en vervolgens de MiniMax M3.1 Flash-route kiezen waarvan de actieve configuratie, ondersteunde functies en facturering aan hun vereisten voldoen.