Technische specificaties van Qwen3.8-Flash
| Specificatie | Qwen3.8-Flash |
|---|---|
| Aanbieder | Alibaba / Qwen |
| Modelfamilie | Qwen3.8 |
| Model-ID | qwen3.8-flash |
| Modeltype | Multimodaal redenatiemodel |
| Invoermodaliteiten | Tekst, afbeelding, video |
| Uitvoermodaliteit | Tekst |
| Contextvenster | 1,000,000 tokens |
| Maximale output | 128,000 tokens |
| Maximaal redenatiebudget | 262,144 tokens |
| Denkmodus | Ondersteund |
| Functieaanroepen | Ondersteund |
| Ingebouwde tools | Ondersteund |
De huidige API-documentatie van Qwen vermeldt qwen3.8-flash als een productie-Qwen3.8-model met een contextvenster van 1M tokens en 128K maximale output. Het ondersteunt tekst-, afbeelding- en video-invoer, functieaanroepen, ingebouwde tools en gestructureerde output.
Voor visuele workloads omvatten de gedocumenteerde limieten tot 16 megapixels per afbeelding, tot 2,048 afbeeldings-URL's of 250 Base64-afbeeldingen, en tot 64 video's, met video's tot twee uur.
Wat is Qwen3.8-Flash?
Qwen3.8-Flash is Alibaba's kostenefficiënte multimodale redenatiemodel binnen de Qwen3.8-familie, ontworpen voor coderen, agent-workflows, lange-contextanalyse en visueel begrip. Het biedt dezelfde 1M-token contextklasse als Qwen3.8-Max, maar met aanzienlijk lagere API-kosten. Qwens eigen ontwikkelaarsrichtlijnen bevelen Qwen3.8-Flash expliciet aan wanneer gebruikers vergelijkbare mogelijkheden willen tegen een lagere prijs, terwijl Qwen3.8-Max wordt gepositioneerd als de sterkere optie voor redeneren.
Het model is vooral interessant omdat "Flash" niet betekent dat het om een eenvoudig klein model gaat. Het productiemodel in de API combineert lange-contextredeneren, multimodale invoer, toolgebruik en gestructureerde output in een relatief voordelig eindpunt.
Wat zijn de belangrijkste kenmerken van Qwen3.8-Flash?
- 1M-token context: Qwen3.8-Flash kan extreem lange documenten en codebases verwerken, wat het geschikt maakt voor repository-analyse en langdurige agent-sessies.
- Multimodaal begrip: De API accepteert tekst, afbeeldingen en video, waardoor ontwikkelaars code, screenshots, grafieken, documenten en video in één workflow kunnen combineren.
- Redeneringsmodus: Het model ondersteunt Qwens denkmodus, met een gedocumenteerd maximaal redenatiebudget van 262,144 tokens.
- Agent- en toolondersteuning: Functieaanroepen en ingebouwde tools worden ondersteund, inclusief mogelijkheden zoals webzoekopdrachten, code-uitvoering en gerelateerde door Qwen gehoste tools.
- Gestructureerde output: Ontwikkelaars kunnen gestructureerde antwoorden vragen, waardoor het model eenvoudiger te integreren is in applicaties die JSON of schema-gebonden resultaten vereisen.
- Begrip van lange video’s: De visuele API-documentatie vermeldt video-invoer tot twee uur, waardoor Qwen3.8-Flash nuttig is voor videoanalyse en niet alleen voor kortdurende afbeelding-beschrijvingstaken.
Wat zijn de beste toepassingsscenario's voor Qwen3.8-Flash?
Programmeren en software-engineering
Het 1M-token contextvenster is nuttig voor grote repositories, lange debugsessies en analyse van meerdere bestanden. De ondersteuning voor functieaanroepen en redeneren maakt het model ook geschikt voor code-agents in plaats van alleen codeaanvulling.
Agent-workflows
Qwen3.8-Flash ondersteunt functieaanroepen en ingebouwde tools, zodat een applicatie het model informatie kan laten ophalen, code kan laten uitvoeren of met externe systemen kan laten interacteren.
Analyse van lange documenten
Een context van één miljoen tokens maakt het model geschikt voor grote contracten, technische documentatie, onderzoekscollecties en enterprise-kennisbanken, waar anders herhaald chunking nodig zou zijn.
Video- en visuele analyse
Qwen3.8-Flash accepteert zowel afbeeldingen als video. De huidige visuele API-limieten staan video’s tot twee uur toe, wat relevant is voor vergaderopnames, tutorials, colleges, demonstraties en analyse van langvormige visuele content.
Kostengevoelige productie-AI
Dit is arguably het grootste commerciële voordeel van het model. Qwen raadt Flash expliciet aan als het goedkopere alternatief voor Qwen3.8-Max, waardoor het geschikt is voor applicaties met hoog volume waar vlaggenschip-redenatie niet bij elk verzoek nodig is.
Wat zijn de beperkingen van Qwen3.8-Flash?
Qwen3.8-Flash moet niet worden gezien als het best presterende model in de Qwen3.8-familie, alleen omdat het het 1M-contextvenster deelt met Qwen3.8-Max.
De primaire afweging is mogelijkheden versus kosten: Qwen zelf raadt Qwen3.8-Max aan wanneer de sterkste redenatieprestaties vereist zijn.
Een tweede aandachtspunt is dat een 1M-contextvenster niet betekent dat elk verzoek één miljoen tokens moet bevatten. Grote contexten verhogen de verwerkingsbehoefte, en ontwikkelaars zouden ophalen, caching en contextbeheer moeten gebruiken wanneer de volledige context niet nodig is.
Tot slot moeten ontwikkelaars het gehoste qwen3.8-flash onderscheiden van het open-weight Qwen3.8-Flash-Next. Dat laatste is de architectuurpreview en heeft afzonderlijk gedocumenteerde gewichten en architectuur; het productiemodel in de API moet worden gedocumenteerd volgens zijn eigen API-specificaties.
Is Qwen3.8-Flash geschikt voor productie-API-toepassingen?
Ja, vooral wanneer de applicatie multimodale redenering, lange context, toolgebruik en relatief lage tokenkosten nodig heeft.
Het is een geschiktere productiekandidaat dan Flash-Next wanneer de eis simpelweg is om een gehoste Qwen-API aan te roepen, omdat qwen3.8-flash expliciet wordt aangeboden als productiemodel in Qwens API-documentatie met gedefinieerde limieten voor context, output, tools en multimodaliteit.
Voor maximale redenatiekwaliteit blijft Qwen3.8-Max de meer geschikte keuze. Voor workloads met hoog volume waar kosten en doorvoer zwaarder wegen, is Qwen3.8-Flash de voordeligere optie.
Qwen3.8-Flash API-parameters
Een standaard OpenAI-compatibel verzoek kan parameters gebruiken zoals:
| Parameter | Doel |
|---|---|
| model | qwen3.8-flash |
| messages | Conversatie en multimodale invoer |
| temperature | Controle over sampling |
| max_tokens | Maximale gegenereerde output |
| stream | Streamingantwoorden |
| tools | Functie-/tooldefinities |
| tool_choice | Gedrag voor toolselectie |
| response_format | Configuratie voor gestructureerde output |
| enable_thinking | Schakelt de redenatiemodus in bij ondersteunde Qwen-API's |
De quickstartdocumentatie gebruikt de OpenAI SDK met de modelidentifier qwen3.8-flash. Het voorbeeld schakelt redeneren in met extra_body={"enable_thinking": True}.
Hoe gebruik je de qwen3.8-flash-API in CometAPI
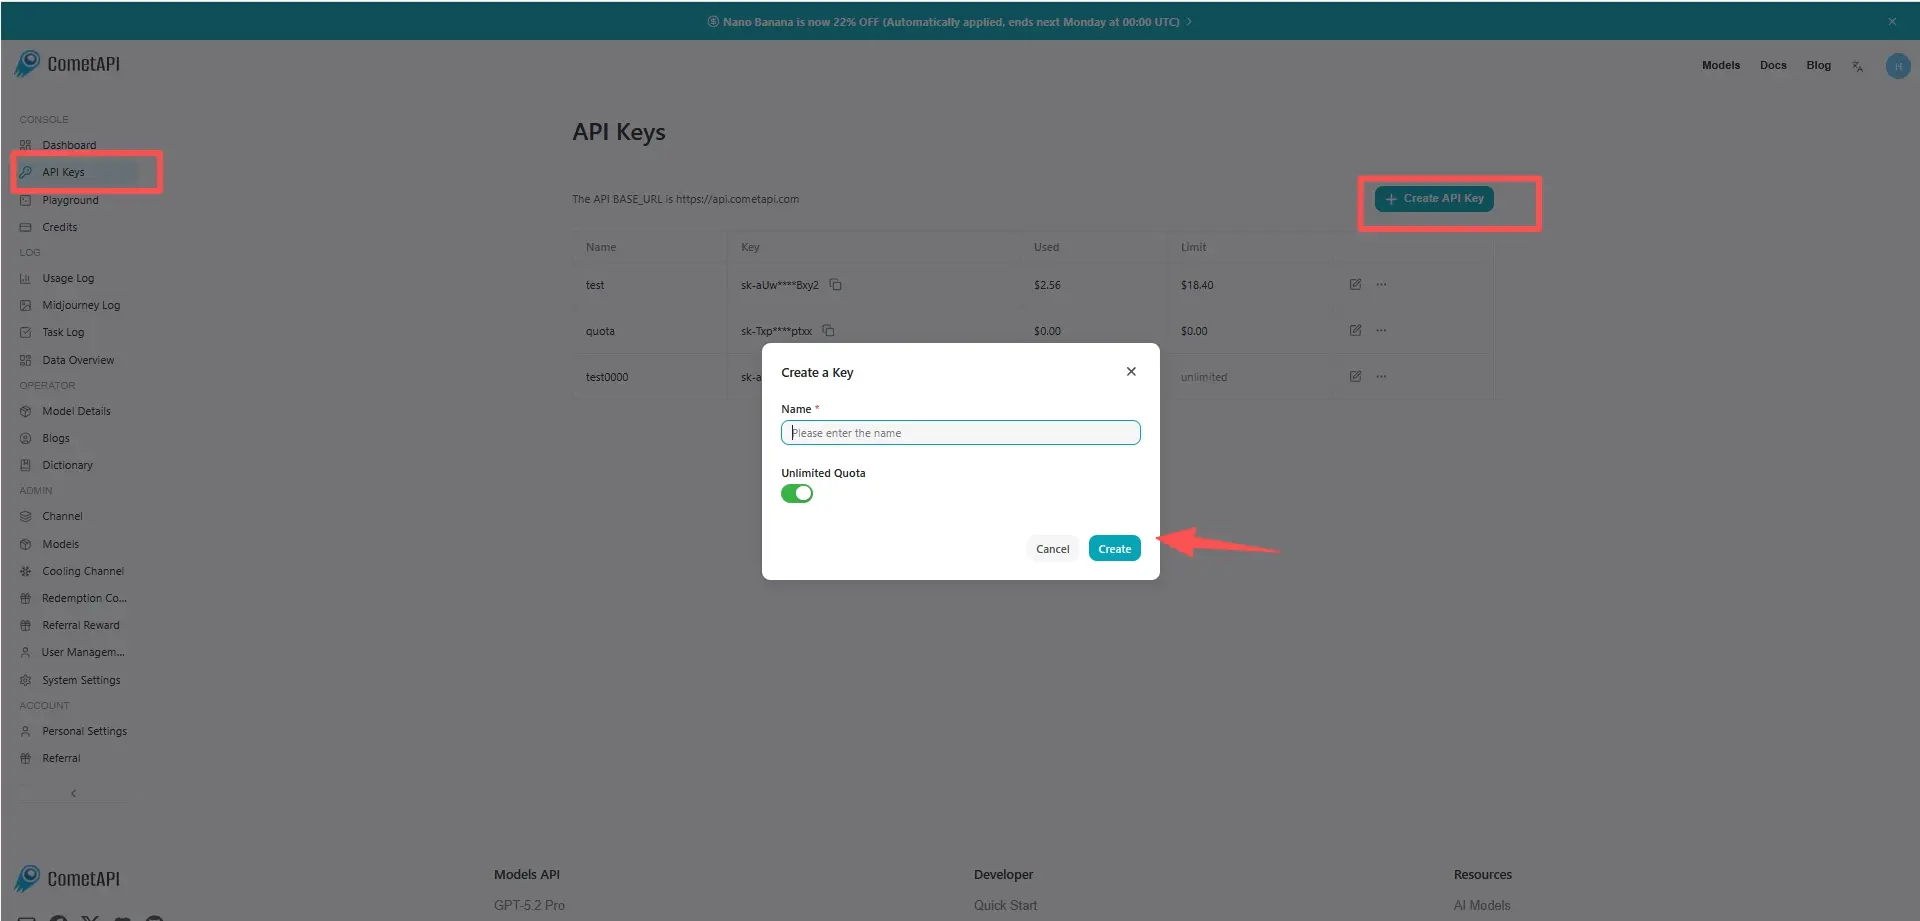
Stap 1: API-toegang verkrijgen
Log in op cometAPI. Als je nog geen gebruiker bent, registreer je dan eerst. Meld je aan bij je CometAPI-console. Verkrijg de toegangssleutel (API key) voor de interface. Klik op "Add Token" bij de API-token in het persoonlijke centrum, haal de tokensleutel op: sk-xxxxx en dien in.
Stap 2: Verzoeken verzenden naar de qwen3.8-flash-API
Selecteer het "qwen3.8-flash"-eindpunt om het API-verzoek te verzenden en stel de request body in. De requestmethode en request body zijn te vinden in de API-documentatie op onze website. Onze website biedt ook Apifox-tests voor jouw gemak. Vervang <YOUR_API_KEY> door je echte CometAPI-sleutel uit je account.
Voer je vraag of verzoek in het content-veld in—dit is waar het model op reageert. Verwerk de API-respons om het gegenereerde antwoord te verkrijgen. Het ondersteunt AI SDK, OpenAI Chat Completions, OpenAI Responses en met Anthropic Messages compatibele interfaces.
Stap 3: Antwoorden verwerken
De API retourneert gestructureerde kandidaatantwoorden, waaronder gegenereerde tekst, citaties, veiligheidsmetadata en optionele tooluitvoer. Voor multimodale verzoeken kan de berichtinhoud worden gestructureerd met tekst- en afbeeldingsinvoer wanneer het geselecteerde CometAPI-eindpunt de visiecapaciteit van het model aanbiedt.