Technische specificaties van GLM-5.3-Flash
| Specificatie | GLM-5.3-Flash |
|---|---|
| Provider | Z.ai (Zhipu AI) |
| Modelfamilie | GLM-5 |
| Modeltype | Natief multimodaal Mixture-of-Experts-model |
| Totaal aantal parameters | 320B |
| Actieve parameters | 18B |
| Architectuur | Hybride sparse + lineaire attention |
| Contextvenster | 1,048,576 tokens (1M) |
| Maximale output | 131,072 tokens |
| Invoermodaliteiten | Tekst, afbeeldingen, video |
| Uitvoermodaliteit | Tekst |
| Redeneren | Ondersteund |
| Visuele verwerking | Ondersteund |
| Functieaanroepen | Ondersteund |
| Toolgebruik | Ondersteund |
| Web zoeken | Ondersteund via ondersteunde API-integraties |
| Open gewichten | Ja |
| Licentie | MIT |
| Release | 26 augustus 2026 |
Z.ai beschrijft GLM-5.3-Flash als het eerste natief multimodale model in de GLM-5-familie. Het bevat 320B totale parameters maar activeert slechts 18B parameters per inferentiestap. Het model introduceert een hybride architectuur die sparse en lineaire attention combineert en gebruikt mHC om schaalefficiëntie te verbeteren.
Wat is GLM-5.3-Flash?
GLM-5.3-Flash is Z.ai's op efficiëntie gerichte lid van de GLM-5-generatie, ontworpen om redeneren op frontierniveau en agentic coding-capaciteiten te combineren met aanzienlijk lagere inferentiekosten.
Het belangrijkste onderscheid met een conventioneel "Flash"-model is dat Flash niet betekent dat het een klein model is. GLM-5.3-Flash bevat 320B totale parameters, maar zijn MoE-architectuur activeert slechts 18B parameters per token. Dit stelt Z.ai in staat om veel lagere inferentiecomputatie te targeten terwijl een grote parameterpool voor modelcapaciteit behouden blijft.
Het is ook het eerste GLM-5-model met native multimodale capaciteit. Het model ondersteunt visuele input naast tekst en is gepositioneerd voor coderen, browserinteractie, documentbegrip, visueel coderen en agentic workflows.
Z.ai zegt dat GLM-5.3-Flash is getraind vanuit een nieuw getraind basismodel en geen simpel gecomprimeerde versie is van GLM-5.2. De training gebruikt een multimodaal pre-trainingscorpus van 30 biljoen tokens, terwijl de architectuur opnieuw is ontworpen rond capaciteit en inferentie-efficiëntie.
Belangrijkste kenmerken van GLM-5.3-Flash
- 320B MoE met 18B actieve parameters: GLM-5.3-Flash combineert een zeer grote totale parametercapaciteit met een relatief kleine actieve parameterfootprint, waardoor het model aanzienlijk efficiënter is te serven dan een dense 320B-model.
- Natieve multimodale verwerking: In tegenstelling tot eerdere GLM-5-modellen verwerkt GLM-5.3-Flash visuele input native. De modelkaart bevat voorbeelden van beeldbegrip en identificeert het model als multimodaal.
- 1M-token context: Het model is ontworpen voor long-context toepassingen die grote repositories, uitgebreide documenten, lange agenttrajecten en complexe multi-stap workflows omvatten. Cloudflare en Vercel vermelden beide een contextvenster van 1,048,576 tokens.
- Hybride sparse + lineaire attention: GLM-5.3-Flash is het eerste GLM-model dat sparse attention en lineaire attention combineert. Z.ai zegt dat deze architectuur de long-context serving-kosten verlaagt terwijl precieze long-context-capaciteiten behouden blijven.
- Agentic coderen en toolgebruik: Het model is geoptimaliseerd voor software-engineering, terminaltaken, browserinteractie en toolgestuurde workflows. De gerapporteerde Terminal-Bench 2.1-score is 84.3.
- Open-gewichten-deployment: De MIT-gelicentieerde gewichten kunnen worden gedeployed met Transformers, vLLM, SGLang, TokenSpeed en KTransformers, waardoor ontwikkelaars opties krijgen voor self-hosting en inferentie-optimalisatie.
Benchmarkprestaties van GLM-5.3-Flash
GLM-5.3-Flash heeft een bijzonder sterk profiel op coding- en agentic-benchmarks.
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Opmerkingen |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 81.0 | Terminal / agentic coderen |
| DeepSWE v1.1 | 63.4 | 46.2 | Software-engineering |
| AutomationBench | 48.8 | 26.2 | Automatisering van computergebruik |
| Toolathlon-Verified | 78.4 | 59.9 | Toolgebruik-capaciteit |
| NL2Repo-Bench | 56.3 | 48.9 | Natuurlijke-taal-naar-repository coderen |
| Agent's Last Exam | 26.3 | 20.4 | Agentic redeneren |
| Humanity's Last Exam | 55.3 | — | Met tools |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | Productiviteit / kenniswerk |
| OfficeQA-Pro | 62.4 | — | Multimodale productiviteit |
| CharXiv RQ | 89.4 | — | Multimodaal redeneren |
De officiële evaluatiesectie op Hugging Face vermeldt 84.3 op Terminal-Bench 2.1, 63.4 op DeepSWE en 55.3 op HLE. Z.ai's lanceringmateriaal rapporteert aanvullende resultaten, waaronder AutomationBench, Toolathlon, NL2Repo en GDPval.
Artificial Analysis geeft GLM-5.3-Flash momenteel een Intelligence Index van 57, waarmee het op #3 staat van 108 modellen in de huidige vergelijkingsset.
Deze cijfers moeten nog steeds worden geïnterpreteerd met benchmark-specifieke kanttekeningen: verschillende resultaten zijn door de leverancier gerapporteerd, evaluatiekaders verschillen, en benchmarkscores moeten niet worden behandeld als een universele rangschikking van modelkwaliteit.
GLM-5.3-Flash vs GLM-5.3 vs GLM-5.2
| Kenmerk | GLM-5.3-Flash | GLM-5.3 | GLM-5.2 |
|---|---|---|---|
| Modelgeneratie | GLM-5 | GLM-5 | GLM-5 |
| Positionering | Efficiënt multimodaal / agentic model | High-end algemeen redeneermodel | Vorige generatie algemeen model |
| Natieve visuele verwerking | Ja | Nee | Afhankelijk van model |
| Totaal aantal parameters | 320B | Grotere vlaggschipconfiguratie | Grootschalig model |
| Actieve parameters | 18B | — | — |
| Context | 1M | 200K-klasse deployment | 200K-klasse deployment |
| Hybride sparse/lineaire attention | Ja | Nee | Nee |
| Agentic coderen | Uitstekend | Uitstekend | Sterk |
| Open gewichten | Ja | Afhankelijk van deployment | Afhankelijk van deployment |
| Belangrijkste voordeel | Capaciteit per eenheid inferentiecompute | Maximale GLM-5-redeneercapaciteit | Volwassen en voordeligere GLM-generatie |
Het belangrijkste onderscheid is dat GLM-5.3-Flash niet simpelweg GLM-5.3 in kleiner formaat is. Z.ai zegt dat het begint met een nieuw getraind basismodel en een herontworpen hybride attention-architectuur, mHC en multimodale pre-training introduceert.
GLM-5.3-Flash vs DeepSeek V4 Flash — Vergelijkingssamenvatting
| Dimensie | GLM-5.3-Flash (Z.ai / Zhipu) | DeepSeek V4 Flash (DeepSeek) | Voordeel |
|---|---|---|---|
| Releasedatum | 26 augustus 2026 | Preview april 2026; belangrijke checkpoint (0731) 31 juli 2026 | — |
| Totaal / actieve parameters | 320B / 18B | 284B / 13B | GLM iets groter |
| Contextvenster | 1M tokens | 1M tokens | Gelijk |
| Max output | ~131K tokens | Tot 384K tokens | DeepSeek |
| Modaliteiten | Natief multimodaal (tekst + afbeelding + video-invoer) | Primair tekst (experimentele vision-varianten beschikbaar) | GLM |
| Architectuur-highlights | Hybride sparse + lineaire attention (~3× lagere attention compute, ~4.4× kleinere KV cache vs volledige GLM-5.3) | Compressed Sparse Attention (CSA) + Heavily Compressed Attention (HCA) | Beide sterk |
| Licentie | MIT (gewichten op Hugging Face) | MIT (gewichten beschikbaar) | Gelijk |
| Standaard API-prijzen ($ / 1M tokens) | Input $0.15 / Output $0.50 (gecachete input ~$0.03) | Gangbaar bereik $0.14–$0.44 input / $0.28–$1.32 output (piek/off-peak varieert) | GLM goedkoper |
| Promoprijzen bij lancering | ~$0.075 input / $0.25 output (tijdelijk, ~begin september 2026) | Geen gelijkwaardige promotie | GLM |
| AA Intelligence Index | 57 (door leverancier gerapporteerd) | ~50 (onafhankelijke meting) | GLM |
| Terminal-Bench 2.1 | 84.3 | 82.7 | GLM |
| DeepSWE | 63.4 | 54.4 | GLM |
| SWE-bench Verified | Nog beperkte onafhankelijke data | ~79% (sterke onafhankelijke resultaten) | DeepSeek |
| Belangrijkste sterke punten | Lagere prijs, natief multimodaal, leidt op meerdere agentic/coding-scores, efficiënte long context | Volwassenere onafhankelijke validatie, uitstekende coding/agent-track record, zeer efficiënte long-context-architectuur, sterk ecosysteem | — |
| Belangrijkste zwakke punten | Nieuwere release (sommige scores nog door leverancier gerapporteerd); gemiddelde snelheid | Zwakkere multimodale ondersteuning; hogere effectieve prijzen op veel routes | — |
| Het best voor | Algemeen gebruik, multimodale workloads, kostengevoelige projecten, gebalanceerde agent-capaciteiten | Puur coding-agents, long-context tekstredeneren, scenario's die bewezen onafhankelijke benchmarks nodig hebben | — |
One-sentence summary:
Per eind augustus 2026 loopt GLM-5.3-Flash momenteel voorop in prijs, multimodale capaciteit en meerdere overlappende benchmarks, en biedt het een betere algemene waarde. DeepSeek V4 Flash blijft een zeer betrouwbare keuze voor coding-gerichte agents dankzij sterkere onafhankelijke validatie en long-context-efficiëntie. Test beide op uw specifieke workloads voordat u beslist.
Gebruiksscenario's voor GLM-5.3-Flash
1. Agentic software-engineering
GLM-5.3-Flash is bijzonder geschikt voor coding-agents die repositories moeten inspecteren, meerdere bestanden wijzigen, terminalcommando's uitvoeren, tests draaien en itereren op implementatie.
De Terminal-Bench 2.1-score van 84.3 en het DeepSWE-resultaat van 63.4 tonen aan dat software-engineering een van de sterkste toepassingsgebieden is.
2. Visueel coderen
Omdat GLM-5.3-Flash natief multimodaal is, kunnen ontwikkelaars screenshots, diagrammen en andere visuele input toevoegen naast coderingsinstructies. Dit is nuttig voor UI-implementatie, visuele debugging en design-to-code-workflows.
3. Lang-context documentanalyse
Het 1M-token contextvenster maakt het model geschikt voor grote technische documentatiesets, repositories, lange rapporten en meerfasige agentgeschiedenissen.
4. Browser- en computer-use-agents
De toolgebruik- en multimodale capaciteiten maken het model geschikt voor workflows met browsers, grafische interfaces en externe tools.
5. Enterprise kenniswerk
GLM-5.3-Flash kan grote hoeveelheden gestructureerde en ongestructureerde informatie verwerken en tools gebruiken om multi-stap taken uit te voeren, waardoor het geschikt is voor documentanalyse, onderzoeksassistentie en workflowautomatisering.
6. Zelfgehoste AI-infrastructuur
De MIT-licentie en publiek beschikbare gewichten maken GLM-5.3-Flash aantrekkelijk voor organisaties die controle nodig hebben over deployment, gegevensverwerking en inferentie-infrastructuur.
GLM-5.3-Flash API-parameters
| Parameter | Beschrijving |
|---|---|
| model | Providerspecifieke modelidentificatie |
| messages | Gestructureerde conversatie-input |
| prompt | Enkele prompt-input op ondersteunde API's |
| max_tokens / max_completion_tokens | Limiet voor outputtokens |
| temperature | Stuurt sampling-willekeurigheid |
| tools | Tool-/functie-definities |
| stream | Schakelt streamingoutput in |
| reasoning | Regelt redeneringsinspanning op ondersteunde gateways |
| Image content | Ondersteund |
| Function calling | Ondersteund |
| Context | Tot 1M tokens |
Vercel AI Gateway documenteert momenteel een maximum van 131,000 outputtokens, waarbij reasoning-tokens meetellen voor de outputlimiet.
Hoe de GLM-5.3-Flash API te gebruiken in CometAPI
Stap 1: API-toegang verkrijgen
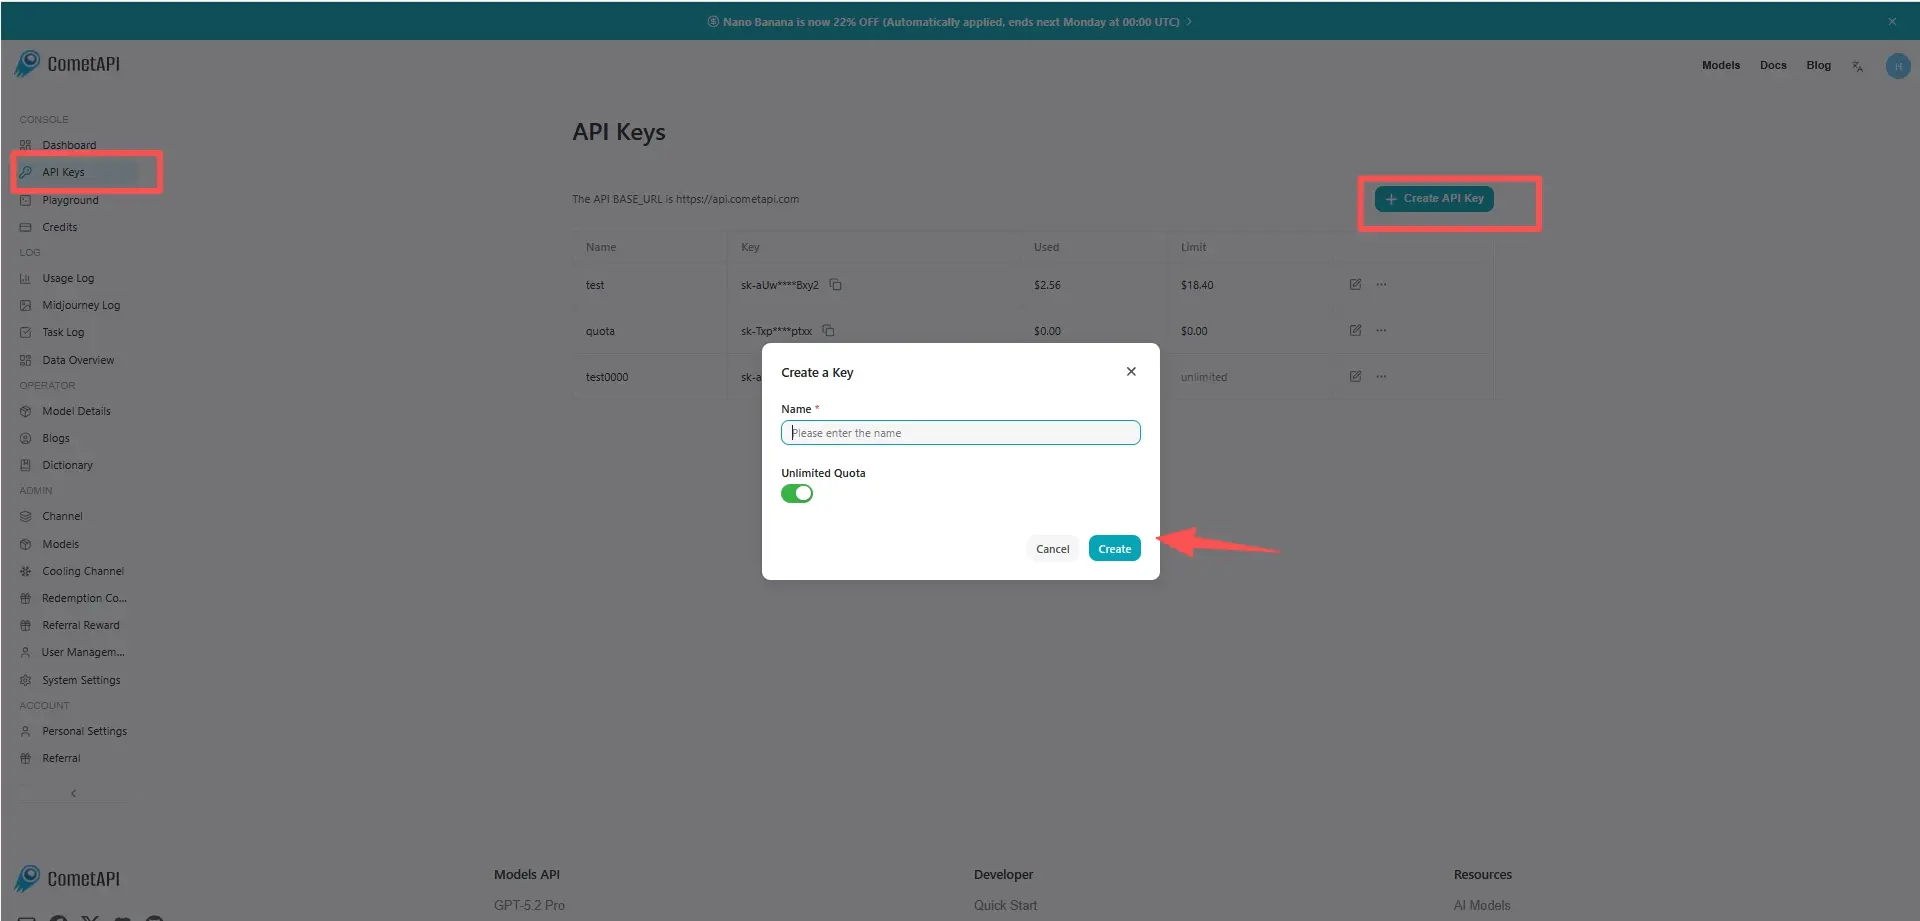
Log in op cometAPI. Als u nog geen gebruiker bent, registreer dan eerst. Meld u aan bij uw CometAPI-console. Verkrijg de toegangssleutel API key van de interface. Klik op “Add Token” bij de API-token in het persoonlijk centrum, verkrijg de tokensleutel: sk-xxxxx en dien in.
Stap 2: Verzoeken verzenden naar de GLM-5.3-Flash API
Selecteer het “GLM-5.3-Flash”-endpoint om het API-verzoek te versturen en stel de request body in. De requestmethode en request body zijn te vinden in onze website-API-doc. Onze website biedt ook Apifox-test voor uw gemak. Vervang <YOUR_API_KEY> door uw daadwerkelijke CometAPI-sleutel uit uw account.
Voeg uw vraag of verzoek in het content-veld in—hierop reageert het model. Verwerk de API-respons om het gegenereerde antwoord te verkrijgen.
Stap 3: Antwoorden verwerken
De API retourneert gestructureerde kandidaat-antwoorden, inclusief gegenereerde tekst, bronvermeldingen, veiligheidsmetadata en optionele tooloutputs. Voor multimodale verzoeken kan de berichtinhoud worden gestructureerd met tekst- en afbeeldinginput wanneer het geselecteerde CometAPI-endpoint de vision-capaciteit van het model exposeert.
Het exacte CometAPI-endpoint, de ondersteunde parameters en de huidige beschikbaarheid moeten worden gehaald uit de live CometAPI API-documentatie, in plaats van af te leiden uit Z.ai's native API.
Voor CometAPI moet de integratie de model-ID gebruiken die wordt getoond op het live CometAPI-modelendpoint, in plaats van automatisch providerspecifieke ID's van Z.ai, Cloudflare of Vercel te kopiëren.
Beperkingen van GLM-5.3-Flash
- Grote modelfootprint: Hoewel slechts 18B parameters actief zijn, bevat het vrijgegeven model ongeveer 321B parameters, waardoor self-hosting aanzienlijk veeleisender is dan het deployen van een conventioneel 7B–70B model.
- Inferentiesnelheid is niet noodzakelijk "flash" in absolute zin: Artificial Analysis meet momenteel ongeveer 50 outputtokens/seconde in zijn vergelijkingsomgeving, waarmee het model ruim onder de snelste kleine modellen ligt.
- Zeer lange context verhoogt infrastructuureisen: Een context van 1M tokens is nuttig maar kan geheugen- en servingcomplexiteit verhogen.
- Benchmarkprestaties variëren per taak: GLM-5.3-Flash is vooral sterk in agentic coding- en tool-use-benchmarks, maar geen enkele benchmark bewijst universele superioriteit over frontier-proprietary modellen.
- Multimodale output is beperkt: De native multimodale capaciteit van het model is primair aan de inputzijde; de standaardoutput is tekst in plaats van gegenereerde afbeeldingen of video.