Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Muse Wonder, Claude Opus 5.5 en GPT-6 Sol zijn krachtige modellen die zijn gepositioneerd voor coding- en agent-workflows. Meta’s nieuwe Muse Wonder legt nadruk op persistente geheugenfuncties en langdurige uitvoering; Opus 5.5 leidt de aangehaalde samengestelde Intelligence Index; GPT-6 Sol heeft in deze vergelijking de laagste standaardtarieven voor short-context invoer en uitvoer, terwijl de long-context-laag apart geprijsd is. Kies op basis van representatieve taakkwaliteit, betrouwbaarheid en totale kosten, niet op één enkele leaderboardscore.
Key Takeaways
Algemene intelligentie: Claude Opus 5.5 scoort 58 tegenover 52 voor Muse Wonder op de gerapporteerde Intelligence Index v4.3.
Langetermijn-coding: Muse Wonder noteert 78.8 op DeepSWE 1.1 en 53.1 op SWE-Marathon; Opus 5.5 registreert 74.2 en 46.3 in Meta’s tabel.
Goedkoop redeneren: GPT-6 Sol start bij $2 invoer / $10 uitvoer per miljoen tokens via OpenAI’s short-context standaard-API.
Geheugengerichte agents: Muse Wonder introduceert Active Memory en Active Focus.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Beschikbaarheid telt: Muse Wonder Full is een apart, restrictiever product dan de voor ontwikkelaars toegankelijke standaard Muse Wonder.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol in één oogopslag
Kies Muse Wonder voor persistente agents en langlopende engineering, Claude Opus 5.5 voor brede coding- en terminal-intensieve werkzaamheden, en GPT-6 Sol voor lagere standaard short-context tokenkosten.
Beslissingsfactor
Muse Wonder
Claude Opus 5.5
GPT-6 Sol
Begin met testen voor
Persistente agents en uitgebreide engineering
Terminal-intensieve coding en professionele workflows
Budgetgevoelige coding en automatisering
Contextvenster
1,048,576 tokens
1M tokens
1,050,000 tokens
Gepubliceerde sterke punten
DeepSWE 78.8; SWE-Marathon 53.1
Intelligence Index 58; ProgramBench 70.5
Standaard invoer/uitvoer $2/$10 per 1M tokens
Standaardinvoer / -uitvoer per 1M tokens
$4 / $20
$4 / $20
$2 / $10; short-context-laag
Toegang via provider
Meta Model API; Full is een afzonderlijk abonnementsproduct
Dit overzicht vat de gedateerde specificaties en gepubliceerde resultaten samen die hieronder worden onderzocht. Benchmark-rijen gebruiken verschillende evaluatiemethoden, en lage tokenprijzen betekenen niet automatisch lagere kosten per geslaagde taak. Standaard Muse Wonder en Muse Wonder Full zijn verschillende toegangsopties.
Specificaties gecontroleerd op 13 oktober 2026. Ondersteunde modaliteiten en functies zijn afhankelijk van het gekozen endpoint en het release-oppervlak, inclusief de beschikbaarheid van audio. Modelniveau-capaciteiten garanderen niet dat elke gateway-route alles ondersteunt.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Overzicht en specificaties
Muse Wonder: Persistente agent-workflows
Meta introduceerde Muse Wonder en Muse Wonder Full op 12 oktober 2026. Standaard Muse Wonder legt de nadruk op langlopende professionele taken, persistent agentgeheugen en herstel na obstakels. Active Memory is bedoeld om nuttige eerdere context op te halen, terwijl Active Focus is ontworpen om voortgang te behouden over meerstapswerk. Meta noemt coderen, onderzoek, financiële analyse en persoonlijke assistentie als kernscenario’s.
Claude Opus 5.5: Professioneel coderen en toolgebruik
Claude Opus 5.5 richt zich op coderen, redeneren en professionele workflows met meerdere tools. Anthropic bracht het uit op 22 september 2026. Het contextvenster is één miljoen tokens, terwijl de hieronder gerapporteerde coderingsresultaten sterktes laten zien die per benchmark variëren.
GPT-6 Sol: Kostenbewust redeneren
GPT-6 Sol beoogt sterke redenering en toolgebruik te combineren met relatief betaalbare inferentie. Het ondersteunt programmatische workflows via OpenAI’s API-ecosysteem. De standaard short-context-tarieven zijn lager dan de vermelde tarieven voor Claude Opus 5.5, al hangen de end-to-end-kosten ook af van retries en het gebruik van redeneertokens.
OpenAI beschrijft GPT-6 Sol als een model voor complexe coding- en agentische workflows; de releaseaankondiging bevat de evaluatieresultaten die hieronder worden gebruikt. Dit artikel vergelijkt de opgegeven modelversies, niet elk nieuwer model in het assortiment van elke leverancier.
Architectuur en redeneringsinstellingen
De hier aangehaalde bronnen bieden geen vergelijkbaar overzicht van parameteraantallen en architectuur voor alle drie de modellen. Er is daarom geen rechtvaardiging voor een dense-versus-mixture-of-experts-ranglijst. Active Memory en Active Focus beschrijven Meta’s agentmogelijkheden; zij zijn geen vervanging voor een bekendgemaakte neurale architectuur. GPT-6 Sol biedt configureerbare redeneerinspanning, terwijl gerapporteerde scores voor Meta en Claude ook afhangen van inspanning en evaluatie-instellingen. Beschouw die instellingen als onderdeel van de vergeleken configuratie, niet als uitwisselbare maatstaven voor compute.
Vergelijkingsresultaat: Alle drie bieden grote contextvensters en ontwikkelaars-API’s. Muse Wonder documenteert bredere modelniveau-invoermodaliteiten; Opus 5.5 en GPT-6 Sol leggen de nadruk op tekst- en afbeeldingsworkflows. Contextcapaciteit en functiebeschikbaarheid moeten nog steeds worden gecontroleerd op het geselecteerde endpoint.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Prestaties
Gepubliceerde benchmarks en bronbeperkingen
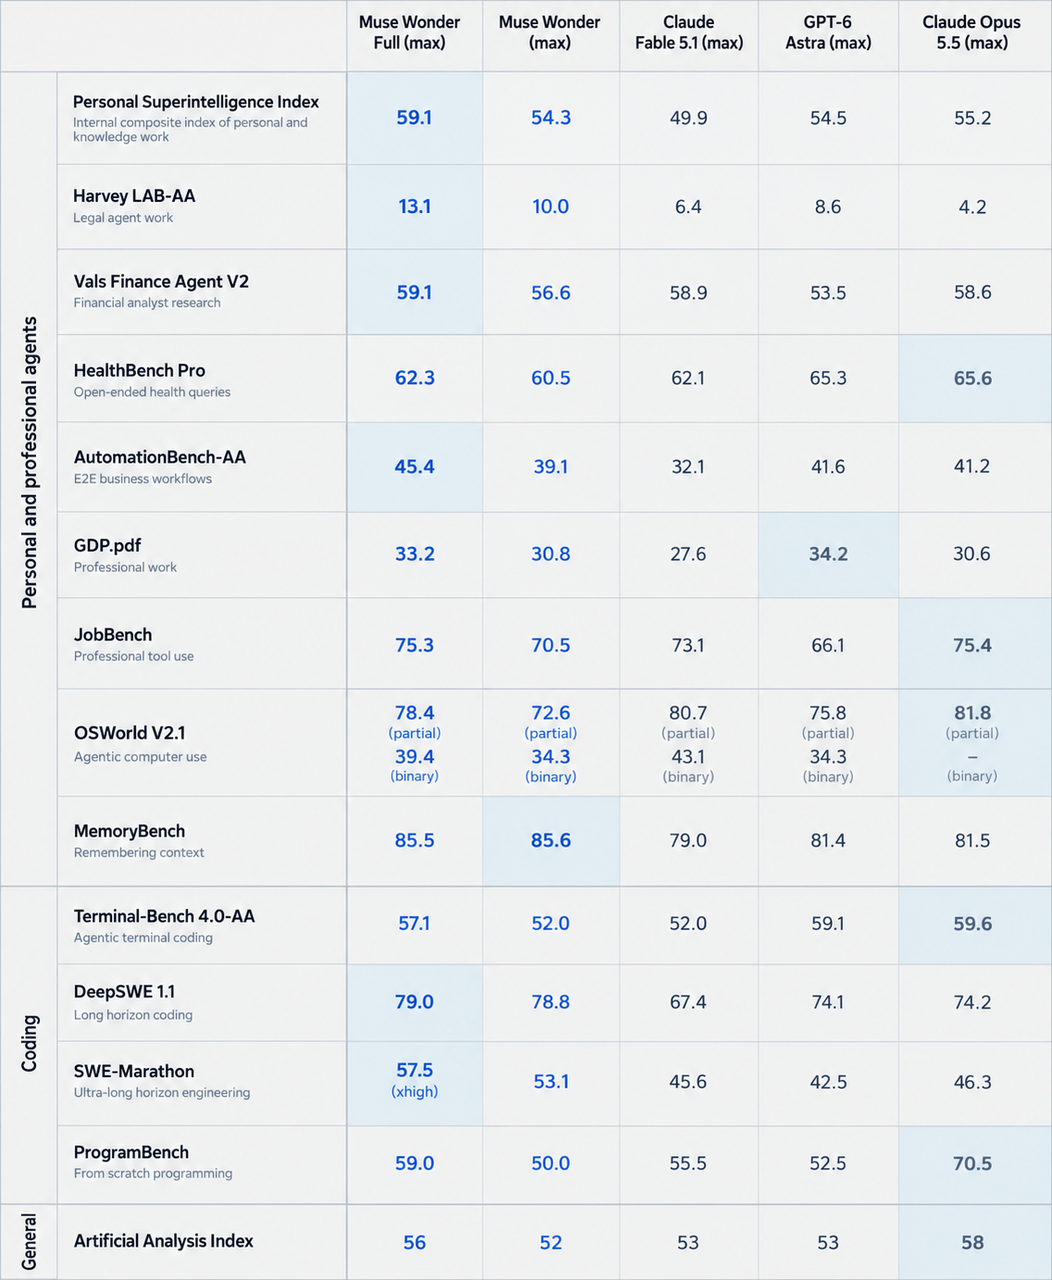
Meta’s officiële modelkaart biedt directe vergelijkingen tussen Muse Wonder en Claude Opus 5.5. OpenAI publiceert GPT-6 Sol-resultaten afzonderlijk, waardoor de drie modellen niet op één volledig gecontroleerde leaderboard geplaatst kunnen worden zonder evaluatieharnassen, versies en instellingen te harmoniseren.
Benchmark
Muse Wonder
Claude Opus 5.5
Hogere score
Artificial Analysis Intelligence Index v4.3
52
58
Opus
Personal Superintelligence Index
54.3
55.2
Opus
Harvey LAB-AA
10.0
4.2
Muse
Vals Finance Agent V2
56.6
58.6
Opus
AutomationBench-AA
39.1
41.2
Opus
JobBench
70.5
75.4
Opus
MemoryBench
85.6
81.5
Muse
Terminal-Bench 4.0-AA
52.0
59.6
Opus
DeepSWE 1.1
78.8
74.2
Muse
SWE-Marathon
53.1
46.3
Muse
ProgramBench
50.0
70.5
Opus
De officiële modelkaart-methodologie onderscheidt interne tests, evaluaties door derden en door providers gerapporteerde concurrentscores. De tabel reproduceert de gerapporteerde waarden; hij vormt geen uniforme, onafhankelijk gecontroleerde proef over alle rijen.
Originele benchmark-scorekaart uit Meta’s Muse Wonder-modelkaart, gereproduceerd zonder hertekenen. Het extra OpenAI-model in deze officiële afbeelding is GPT-6 Astra, niet GPT-6 Sol. De omliggende tabellen identificeren de modellen die relevant zijn voor dit artikel.
Evaluatievoorwaarden
DeepSWE v1.1 omvat 113 taken over 91 repositories en vijf talen, beoordeeld via functionele en regressietests met pass@1; Meta’s scorekaart gebruikt Datacurve-resultaten voor Muse Wonder en Opus 5.5. SWE-Marathon gebruikt projecttests en rapporteert pass@1 van Abundant AI; agentframeworks variëren, en de score van Wonder Full is gemarkeerd als xhigh. ProgramBench gebruikt mini-swe-agent en meet roll-outs die ten minste 95% van de verborgen tests halen, waarbij internet na de setup is uitgeschakeld. MemoryBench is Meta’s interne conversatietest met 64K–100K tokens, beoordeeld door een LLM-jurylid. Deze omgevingen en metriek moeten niet worden samengevoegd tot één algemene nauwkeurigheidsscore.
Coderen en software-engineering
Muse Wonder leidt op de gerapporteerde DeepSWE 1.1- en SWE-Marathon-resultaten. Claude Opus 5.5 leidt op Terminal-Bench 4.0-AA en ProgramBench. Deze splitsing suggereert dat langetermijn-engineering, command-line-toolgebruik en programmareconstructie verschillende vaardigheden aanspreken.
GPT-6 Sol-resultaten en vergelijkbaarheid tussen bronnen
Gepubliceerde OpenAI-evaluatie
GPT-6 Sol
Gerapporteerde instelling
DeepSWE 1.1
68.8%
Maximum reasoning
AutomationBench 1.0.6
33.2%
xhigh reasoning
Agents' Last Exam V1
56.4%
Maximum reasoning
OSWorld 2.0 offline
60.5%
xhigh reasoning
OpenAI’s gepubliceerde evaluatieresultaten rapporteren de bovenstaande scores. Het OSWorld-resultaat is partiële beloning op de offline set v2026.08.08, niet een strikte taakvoltooiingsratio. OpenAI merkt op dat evaluaties hun onderzoeksomgeving of API gebruikten; productieconfiguraties kunnen verschillen.
De gerapporteerde DeepSWE-scores impliceren een verschil van 10.0 procentpunt tussen Muse Wonder en GPT-6 Sol, en 5.4 punten tussen Opus 5.5 en GPT-6 Sol. Dit zijn rekenkundige verschillen tussen publicaties, geen gecontroleerde schattingen van een puur modelvoordeel. Verschillende agentsetups, prompts, inspanningsniveaus en toolbudgetten kunnen het resultaat beïnvloeden.
Geheugen en langlopende agents
Muse Wonder richt zich op agents die eerdere beslissingen moeten onthouden, context moeten herstellen en onderbroken werk moeten voortzetten. Active Memory kan een onderzoeksassistent helpen projectspecifieke feiten te onthouden, terwijl Active Focus iteratieve actie ondersteunt wanneer een eerder plan niet slaagt. Deze productmogelijkheden vervangen geen statusverificatie, permissies, audittrails of verplichte menselijke bevestiging voor gevoelige acties.
Muse Wonder Full-prestaties
Muse Wonder Full is een aparte productkeuze. Meta biedt de standaard Muse Wonder via zijn API, terwijl Full is voorbehouden aan Power Usage- en Maximum Usage-abonnementen in Muse Code. Een hogere score maakt Full niet tot een API-vervanging voor het standaardmodel.
De door Meta gerapporteerde resultaten voor Wonder Full zijn 56 op de Intelligence Index, 59.1 op Personal Superintelligence, 13.1 op Harvey LAB-AA en 45.4 op AutomationBench-AA. Het scoort ook 79.0 op DeepSWE 1.1, 57.5 op SWE-Marathon, 85.5 op MemoryBench en 75.3 op JobBench. Deze gepubliceerde resultaten beschrijven het apart toegankelijke Full-product; het zijn geen nieuwe metingen uit een vergelijking met een gemeenschappelijk harnas.
Vergeleken met de standaard Muse Wonder-scores hierboven, verbetert Full op zeven van deze acht gerapporteerde maten; MemoryBench is iets lager met 85.5 versus 85.6. Opus 5.5 leidt nog steeds de gerapporteerde Intelligence Index met 58.
Latentie en betrouwbaarheid
Het aangehaalde bewijs biedt geen gematchte vergelijking van de latentie van de drie modellen. Meet tijd tot eerste bruikbare output, mediane en 95e-percentiel doorlooptijd van taken, time-outfrequentie en voltooiing zonder interventie. Houd taakinput, toolpermissies, gelijktijdigheid en acceptatiecriteria constant; leg inspanningsinstellingen en retrybudgetten vast. Snellere tokengeneratie alleen bewijst niet dat een meerstapstaak sneller wordt voltooid.
Vergelijkingsresultaat: Muse Wonder leidt de aangehaalde tests voor duurzame engineering, terwijl Opus 5.5 leidt in de aangehaalde terminal- en programmareconstructietests. GPT-6 Sol blijft een kandidaat met lagere tokenprijzen, maar de beschikbare publicaties bewijzen geen gelijkwaardige kwaliteits- of snelheidsrangschikking in een identieke omgeving voor alle drie.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Kosten
Officiële API-tokenprijzen
Prijs per 1M tokens
Muse Wonder
Claude Opus 5.5
GPT-6 Sol
Standaardinvoer
$4
$4
$2
Standaarduitvoer
$20
$20
$10
Gecachte invoer
$0.20
$0.20
$0.20
Invoer voor lange context
$4
$4
$4
Uitvoer voor lange context
$20
$20
$15
Gecachte invoer lange context
$0.20
$0.20
$0.40
Meta publiceert $4 invoer, $20 uitvoer en $0.20 gecachte invoer per miljoen tokens. Anthropic vermeldt Opus 5.5 op $4 invoer, $20 uitvoer en $0.20 cache-treffers per miljoen tokens. OpenAI’s prijstabel vermeldt GPT-6 Sol op $2/$10 voor short-context invoer/uitvoer en $4/$15 voor long context; tarieven voor gecachte invoer variëren ook per laag. Pas de relevante contextlaag per verzoek, verwerkingsmodus en endpoint-voorwaarden toe voordat u een workload schat.
Voor GPT-6 Sol worden verzoeken met meer dan 272,000 invoertokens tegen hogere tarieven gefactureerd:
Invoertokens: 2× het standaardtarief, stijgend van $2 naar $4 per miljoen tokens.
Gecachte invoertokens: 2× het standaardtarief, stijgend van $0.20 naar $0.40 per miljoen tokens.
Uitvoertokens: 1.5× het standaardtarief, stijgend van $10 naar $15 per miljoen tokens.
Deze hogere tarieven gelden voor het volledige verzoek, niet alleen voor de tokens boven 272,000. Een verzoek met 272,001 invoertokens valt dus in de long-context-prijslaag voor alle invoer-, gecachte invoer- en uitvoertokens.
Ter vergelijking: Muse Wonder en Claude Opus 5.5 leggen geen gelijkwaardige long-context-premie op onder hun standaard API-tarieven.
Dit onderscheid is vooral belangrijk voor analyse van grote documenten, repository-brede coding en langlopende AI-agents, waar GPT-6 Sol’s short-context-prijsvoordeel kan verkleinen naarmate verzoeken groter worden.
CometAPI-prijzen en facturatievoorwaarden
Ten tijde van de review vermeldde CometAPI Opus 5.5 op $3.20 invoer / $16 uitvoer en GPT-6 Sol op $1.60 invoer / $8 uitvoer per miljoen tokens. Dit zijn CometAPI’s onafhankelijke tarieven en mogen niet worden verward met de officiële providerprijzen hierboven. Bevestig de toepasselijke route, contextlaag en accountfacturatievoorwaarden voordat u kosten raamt; prijzen en voorwaarden kunnen wijzigen.
Kosten per geaccepteerde taak
Bereken kosten per geaccepteerde taak als de totale gefactureerde model- en tooluitgaven, inclusief belaste retries en fallbacks, gedeeld door het aantal outputs dat aan vooraf gedefinieerde acceptatiecriteria voldoet. Registreer menselijke beoordelingstijd apart of converteer die met een expliciet uurtarief. Volg mislukte verzoeken en daadwerkelijke kosten onafhankelijk: mislukking op zich bepaalt niet of een verzoek in rekening is gebracht.
Vergelijkingsresultaat: GPT-6 Sol heeft de laagste vermelde standaard short-context invoer- en uitvoertarieven, terwijl Muse Wonder en Opus 5.5 dezelfde basisprijzen hanteren. De werkelijke kosten per geaccepteerde taak hangen af van de gekozen facturatieroute, cachegebruik, contextlagen, toolkosten, retries en beoordelingsinspanning.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Vergelijking en selectie
Selectie op basis van capaciteit en workload
Voor brede coding- en terminal-workflows: begin met Claude Opus 5.5 omdat het de aangehaalde Intelligence Index, Terminal-Bench en ProgramBench aanvoert. Valideer het op refactoring, toolexecutie en consistentie op programmaniveau.
Voor uitgebreide engineeringprojecten: begin met Muse Wonder omdat de gerapporteerde DeepSWE- en SWE-Marathon-resultaten sterker zijn dan die van Opus 5.5. Meet taakvoltooiing, herstel na obstakels en totale taakkosten.
Voor persistente persoonlijke agents: begin met Muse Wonder omdat het Active Memory en Active Focus biedt en een hogere gerapporteerde MemoryBench-score heeft dan Opus 5.5. Test geheugen, correcties, continuïteit en projectisolatie.
Voor meerstaps tool-workflows: evalueer alle drie de modellen. Muse biedt Active Focus, Opus benadrukt toolorkestratie en GPT-6 Sol ondersteunt Responses API-tools. Vergelijk de complete agentstack, inclusief toolpermissies, retries en statehandling.
Voor professionele documenten en analyses: evalueer Muse Wonder of Claude Opus 5.5. Muse heeft gespecialiseerde sterke punten, terwijl Opus de sterkere aangehaalde verzamelde index heeft. Gebruik representatieve documenten en taakspecifieke acceptatiecriteria.
Voor grootschalige, kostengevoelige automatisering: begin met GPT-6 Sol omdat het de laagste vermelde standaard short-context invoer- en uitvoertarieven heeft. Controleer kosten per geaccepteerde taak, contextlagen, latentie en retries.
Voor Meta’s hoogste optie: evalueer Muse Wonder Full indien toegankelijk. Het heeft hogere gerapporteerde scores op verschillende gespecialiseerde taken, maar is apart van het standaard API-model. Bevestig abonnementstoegang en geschiktheid voordat u test.
Professioneel coderen
Claude Opus 5.5 is een goede standaardkeuze voor teams die een brede engineeringassistent nodig hebben, vooral waar toolexecutie, refactoring en consistentie op programmaniveau belangrijk zijn. De gerapporteerde voordelen op Terminal-Bench en ProgramBench versterken dat argument, al moeten teams de volledige agentstack valideren in plaats van alleen het model.
Automatisering op grote schaal
GPT-6 Sol is aantrekkelijk wanneer verzoeken talrijk zijn en kostengevoeligheid hoog is. Zelfs een bescheiden kwaliteitsverschil kan acceptabel zijn voor laagrisico-, eenvoudig controleerbare taken zoals het opstellen van documentatie, het extraheren van gestructureerde velden of het uitleggen van code. Volg bij lange autonome runs kwaliteit, tokens, latentie en retries samen.
Checklist voor productie-evaluatie
Productie-evaluatie moet zes metriek traceren: correctheid, gemeten door geaccepteerde antwoorden of geslaagde tests; betrouwbaarheid, gemeten door taken die zonder menselijke redding worden voltooid; latentie, gemeten door doorlooptijd van taken; tokengebruik, gemeten door totaal gefactureerde invoer en uitvoer; agentefficiëntie, gemeten door tooraanroepen en corrigerende retries; en effectieve kosten, berekend als totale uitgaven gedeeld door geaccepteerde taken.
Vergelijkingsresultaat: Zet Muse Wonder op de shortlist voor persistente-agent- en uitgebreide-engineeringtaken, Opus 5.5 voor brede coding-workflows met sterke terminal-eisen, en GPT-6 Sol wanneer tokenkosten een belangrijke beperking zijn. Promoveer een kandidaat pas nadat deze voldoet aan taakspecifieke kwaliteits- en betrouwbaarheidsdrempels.
Waar krijgt u toegang tot Muse Wonder, Claude Opus 5.5 en GPT-6 Sol?
Officiële provider-toegang
Gebruik Meta Model API voor standaard Muse Wonder, Anthropic API voor Opus 5.5 of OpenAI API voor GPT-6 Sol. Muse Wonder Full is beschikbaar via de opgegeven Muse Code-abonnementsplannen en niet als drop-in vervanging voor het standaard API-model. Controleer accounttoegang, gebruikslimieten en ondersteunde requestfuncties voor de door u gekozen route.
CometAPI-toegang
Een uniforme gateway kan authenticatie, facturatie en routing vereenvoudigen. Gebruik een krachtiger model voor complexe architectuurreviews en een goedkoper model voor repetitieve, laagrisico-tekstopgaven. De modelidentifier en het ondersteunde requestformaat moeten altijd worden gecontroleerd ten opzichte van het beoogde API-endpoint.
Ontwikkelaars kunnen Claude Opus 5.5 API in CometAPI en GPT-6 Sol API in CometAPI gebruiken om representatieve workloads te evalueren. Bevestig het ondersteunde API-oppervlak voor elk model in plaats van aan te nemen dat een gedeelde gateway alle requestformaten uitwisselbaar maakt.
De in dit artikel genoemde CometAPI-routes dekken Opus 5.5 en GPT-6 Sol. Dit artikel stelt geen CometAPI-route vast voor Muse Wonder of Wonder Full; gebruik de bevestigde providerroute bij het evalueren van die producten.
Conclusie
Geen enkel model wint op elke workload. Muse Wonder is de sterkste kandidaat om te testen op persistente-agentgedrag en langlopende engineeringtaken. Claude Opus 5.5 is een sterke kandidaat voor brede coding-, terminal-intensieve workflows en kenniswerk, en leidt de Artificial Analysis Intelligence Index-waarde die door Meta is gerapporteerd. GPT-6 Sol biedt de laagste standaard short-context tokenprijzen en is aantrekkelijk voor kostengevoelige automatisering. Productteams moeten de uiteindelijke keuze maken op basis van geaccepteerde-taakkwaliteit, betrouwbaarheid, latentie, retries, toolgebruik en totale kosten op representatieve workloads.
Veelgestelde vragen
Hoe kunnen teams Muse Wonder, Opus 5.5 en GPT-6 Sol eerlijk testen?
Gebruik een achtergehouden set echte taken met vaste acceptatiecriteria, identieke inputartefacten en gedocumenteerde toolpermissies. Noteer elke modelversie, inspanningsinstelling, agentframework, time-out en tokenbudget. Voer herhaalde proeven uit waar outputs variëren, rapporteer mislukkingen én successen, en scheid een vergelijking met gemeenschappelijk harnas van een vergelijking van best-geconfigureerde systemen. Dit levert bewijs op dat van toepassing is op uw workflow in plaats van op de benchmarksetup van een ander team.
Kan een API-gateway de status van een agent behouden bij het overschakelen tussen modellen?
Een gedeeld gateway-adres garandeert op zichzelf geen draagbare conversatiestatus, tool-call-ID’s of opgeslagen-responsverwijzingen. Houd een canoniek, applicatiezijde register bij van berichten, tooloutputs en gevalideerde taakstatus. Test de status- en toolsemantiek van elke route voordat u een lopende job naar een ander model routeert; anders kan een goedkopere fallback informatie verliezen die nodig is om correct te voltooien.
Hoe moeten teams budgetteren voor herhalingen en menselijke beoordeling?
Definieer een geaccepteerd resultaat vóór het testen en deel vervolgens de totale gefactureerde model- en tooluitgaven door geaccepteerde resultaten. Rapporteer beoordelingsarbeid apart of neem die op met een vermeld uurtarief. Tel mislukte pogingen, corrigerende aanroepen en fallback-modellen, en vergelijk zowel typische als dure taken. Zo voorkomt u dat een lagere tokenprijs wordt gezien als een gegarandeerde reductie van de kosten van bruikbaar werk.
Wat moet een geheugengevoelige agent-evaluatie omvatten?
Test of de agent relevante feiten herinnert, correcties verwerkt, verouderde instructies negeert en afzonderlijke projecten gescheiden houdt. Neem vertraagde follow-ups en tegenstrijdige updates op in plaats van slechts één lange prompt. Controleer geheugengedrag op applicatieniveau én op modelniveau, omdat persistentie, retrieval en verwijdering afhangen van het geïmplementeerde systeem.