Choose your path
API Blog
Gemini API Free Tier 2026: Gratis modellen, limieten en prijsgids
Voorbehoud: mijn kennis reikt tot okt 2024. Controleer altijd de actuele pagina’s hieronder voor 2026-updates. Wat is in 2026 gratis bij de Gemini API - Waar te controleren: - Modellen en prijzen: https://ai.google.dev/pricing - Modelcatalogus (beschikbaarheid per regio/variant): https://ai.google.dev/models - Rate limits: https://ai.google.dev/gemini-api/docs/rate-limits - Werkwijze om gratis modellen/tiers te vinden: 1) Open ai.google.dev/pricing en filter op “Gemini API” (niet Vertex AI). 2) Zoek per model/variant (bijv. 1.5 Pro, 1.5 Flash, 1.5 Flash-8B, Vision) naar vermeldingen als “no-cost tier”, “free quota” of “evaluatiegebruik”. 3) Let op voetnoten: gratis tiers zijn vaak beperkt tot ontwikkel/evaluatie, met lagere RPM/TPM/RPD en zonder SLA. 4) Controleer of multimodale features (beeld/audio/video) een apart gratis contingent hebben. Begrijp de limieten: RPM, TPM en RPD - RPM (requests per minute): maximaal aantal API-aanroepen per minuut. Overschrijding geeft meestal HTTP 429. - TPM (tokens per minute): totaal aantal verwerkte tokens per minuut (prompt + completion). Kan limiteren zelfs als RPM laag is maar prompts/langere antwoorden groot zijn. - RPD (requests per day): dagquotum aan verzoeken. Kan dagelijks resetten op UTC. - Scope en gedrag: - Limieten kunnen gelden per API-sleutel, per project of per account; zie de rate-limit documentatie. - Sommige endpoints hebben aparte limieten (streaming, batch, media-upload). - Bij 429: implementeer exponentiële backoff en eventueel jitter; verlaag batch-grootte en tokens. - Waar te zien/aan te passen: - AI Studio “Usage/Quotas” (https://aistudio.google.com/). - Aanvraag voor verhoging via support/quotaverhogingsformulier gelinkt vanaf de rate-limits pagina. Python: snelle setup - Installatie: - pip install google-generativeai - API-sleutel: - Haal een sleutel in AI Studio: https://aistudio.google.com/app/apikey - Stel in als omgevingsvariabele GOOGLE_API_KEY of geef door aan de client. - Voorbeeld: - import os, google.generativeai as genai - genai.configure(api_key=os.environ["GOOGLE_API_KEY"]) - model = genai.GenerativeModel("gemini-1.5-pro") (kies gewenste modelnaam van de modelcatalogus) - resp = model.generate_content("Schrijf een korte samenvatting over …") - print(resp.text) - Tips: - Beperk tokens met generation_config (bijv. max_output_tokens, temperature). - Gebruik streaming voor lage latentie: model.generate_content(..., stream=True) en itereren over chunks. - Afhandeling 429/5xx: retry met exponentiële backoff (max retries), respecteer Retry-After indien aanwezig. Billing en gebruik - Twee paden: - Gemini API (AI Studio keys, ai.google.dev): beheer sleutel, usage en eventueel facturatie vanuit AI Studio. Prijzen: ai.google.dev/pricing. - Vertex AI (Google Cloud): gebruik Vertex AI’s generatieve endpoints; facturatie via Cloud Billing. Prijzen: https://cloud.google.com/vertex-ai/pricing - Basisstappen Gemini API: 1) Maak API-sleutel (AI Studio). 2) Controleer pricing en gratis tier voor jouw model/gebruik. 3) Bekijk Usage/Quota in AI Studio om verbruik en limieten te monitoren. 4) Als betaalde toegang vereist is, volg de in AI Studio gelinkte billing-activatie of koppel aan een Cloud Billing-account indien gevraagd. - Basisstappen Vertex AI: 1) Maak/selekteer een Google Cloud-project en activeer Billing: https://console.cloud.google.com/billing 2) Activeer Vertex AI API in API Library. 3) Stel quota’s in/aanvraag verhoging via IAM & Admin → Quotas. - Kosteninschatting (algemeen): - Totale kosten ≈ (input tokens × prijs_in/1K) + (output tokens × prijs_out/1K) + eventuele multimodale toeslagen (beeld/audio/video). - Streaming en tool/function calling worden doorgaans op tokenbasis afgerekend; check prijsnotities voor uitzonderingen. - Meet tokens lokaal vooraf of lees usage-metrics in AI Studio/Cloud Console. Google vs. CometAPI: prijsvergelijking - Zo vergelijk je eerlijk: - Modeldekking: welke modellen/versies en context window-groottes. - Prijs per 1K input- en outputtokens, aparte tarieven voor multimodaal (beeld/audio/video). - Gratis tier: aantal gratis requests/tokens per dag/maand; beperkingen (RPM/TPM/RPD). - Rate limits en schaalbaarheid: standaardquotum, aanvraag voor verhogingen, burst-gedrag, 429-beleid. - SLA/ondersteuning: uptime, latency, enterprise features (VPC, data residency, compliance). - Data policies: opslag, training-opt-out, PII-behandeling. - Extra kosten: opslag/transcoding van media, batch jobs, fine-tuning, content-safety. - Praktische aanpak: 1) Verzamel actuele tariefbladen: - Google Gemini API: https://ai.google.dev/pricing - Vertex AI (indien relevant): https://cloud.google.com/vertex-ai/pricing - CometAPI: officiële pricingpagina/verkoperportaal (controleer datum en valuta). 2) Normaliseer naar prijs per 1K tokens en noteer inclusieve/exclusieve posten (bijv. beeld per stuk of per resolutie). 3) Reken drie profielen door: - Kort: 300 in / 200 out tokens. - Gemiddeld: 1.5K in / 800 out. - Lang: 6K in / 2K out + 1 afbeelding. 4) Toets tegen jouw verwacht RPM/TPM/RPD en test met rate-limit-aware retries. - Voorbeeldformule (invullen met actuele prijzen): - Kosten = (in_tokens/1000 × prijs_in) + (out_tokens/1000 × prijs_out) + media_toeslagen Waar je actuele info vindt (2026) - Gratis modellen/tiers en tarieven: https://ai.google.dev/pricing - Rate limits/quotas en verhogingen: https://ai.google.dev/gemini-api/docs/rate-limits - AI Studio API-sleutels/usage: https://aistudio.google.com/app/apikey en Usage-sectie - Vertex AI prijzen/quotas: https://cloud.google.com/vertex-ai/pricing en Cloud Console Quotas - CometAPI: officiële website/pricingpagina van CometAPI Wil je dat ik een kosten- en limietenblad invul als je je doelmodel(s), verwachte tokens per call en gewenste RPM/TPM/RPD opgeeft?
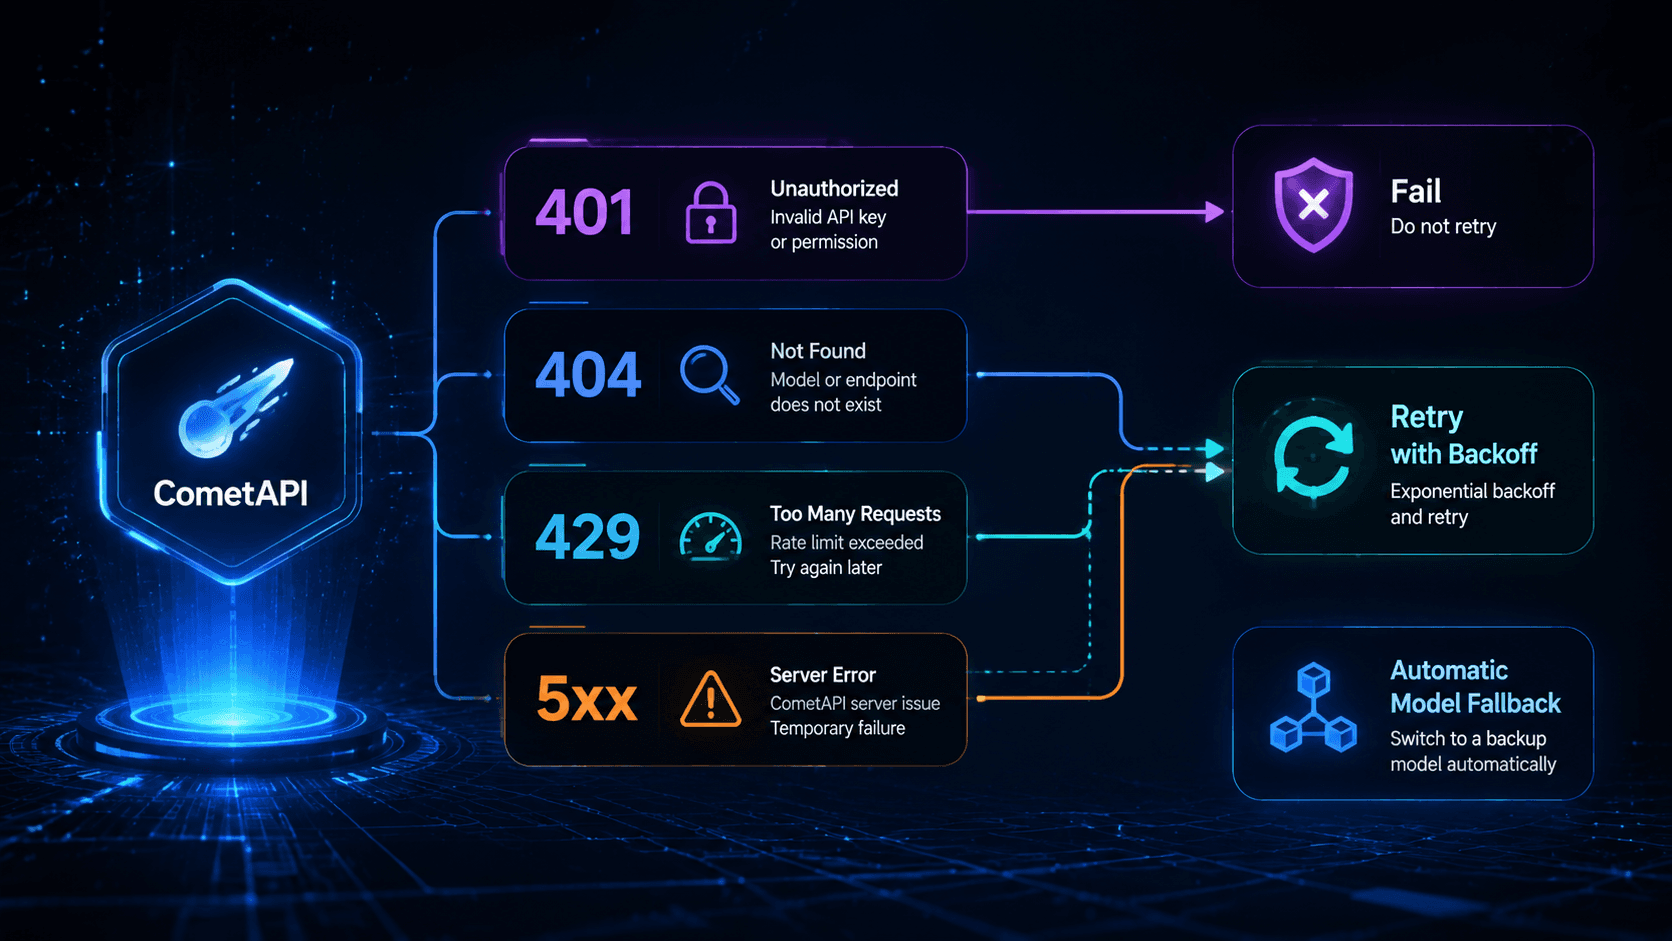
CometAPI 401-, 404-, 429- en 5xx-fouten: opnieuw proberen of afbreken?
Bepaal wanneer CometAPI 401-, 404-, 429- en 5xx-fouten moeten leiden tot falen, tot een nieuwe poging met backoff, of tot het activeren van een automatische modelfallback.
6 beste spraak-naar-tekst-API's in 2026: prijzen, latentie en geschiktheid voor productie
Hieronder een beknopte, praktijkgerichte vergelijking. Prijzen en latency zijn indicatief en variëren per model/regio; raadpleeg altijd de officiële prijspagina’s voor actuele tarieven. - OpenAI (Whisper API) - Prijs: doorgaans laag per minuut (pay‑as‑you‑go); goedkoper dan de meeste hyperscalers voor standaard ASR. - Latency: batchtranscripties snel; real‑time beperkt beschikbaar en afhankelijk van route/integratie. - Talen: ~50+ (multilingual). - Diarisatie: niet native in de API; vereist extra verwerking/third‑party. - Totale productiekost: gunstig voor basistranscriptie; kosten stijgen bij nood aan eigen diarisation, kwaliteitscontrole en herverwerking. - Deepgram - Prijs: laag tot midden (± $0.004–$0.012/min afhankelijk van model/feature). - Latency: zeer laag voor streaming (snelle eerste woorden); geschikt voor real‑time use‑cases. - Talen: 30–40+ (afhankelijk van model). - Diarisatie: native beschikbaar. - Totale productiekost: vaak voordelig voor real‑time en hoge volumes; extra features (vertaling, summarization) verhogen de totale kost. - AssemblyAI - Prijs: midden (± $0.015/min standaard; streaming hoger); add‑on features worden apart afgerekend. - Latency: laag voor streaming; batch snel en schaalbaar. - Talen: uitgebreid meertalig (100+ voor kern-ASR bij recente uitrol). - Diarisatie: native beschikbaar. - Totale productiekost: transparant maar feature‑gebaseerd; totale kost hangt sterk af van ingeschakelde modules (redactie, topics, sentiment, etc.). - Google Cloud Speech‑to‑Text - Prijs: standaard laag (± $0.006/min); enhanced/telephony hoger (± $0.024/min). - Latency: betrouwbaar laag voor streaming; batch schaalbaar. - Talen: 100+. - Diarisatie: native beschikbaar. - Totale productiekost: voorspelbaar bij grote volumes; kosten kunnen oplopen met premium modellen, egress en opslag. - AWS Transcribe - Prijs: midden (± $0.024/min standaard); extra suites (Call Analytics) apart geprijsd. - Latency: laag voor streaming; batch schaalbaar in alle regio’s. - Talen: 30+ (region‑afhankelijk). - Diarisatie: native beschikbaar. - Totale productiekost: solide voor enterprise; additionele AWS‑componenten (S3, Kinesis, egress) tellen mee in TCO. - ElevenLabs - Prijs: vooral abonnements/tegoed‑model (primair TTS); STT/ASR dekking en tarieven variëren per plan. - Latency: zeer laag voor TTS; STT latentie afhankelijk van route (niet primair ASR‑vendor). - Talen: TTS: breed meertalig; STT: beperkter/plan‑gebonden. - Diarisatie: niet gericht op ASR-diarisatie (meestal niet native). - Totale productiekost: optimaal voor spraaksynthese/voice‑branding; minder geschikt als kern‑ASR met diarisation. Samengevat per criterium: - Prijs (laag → hoog): OpenAI/Deepgram ≈ Google (standaard) OpenAI (breed) > Deepgram/AWS (breed maar beperkter) > ElevenLabs (TTS breed, ASR beperkter). - Diarisatie: Deepgram/AssemblyAI/Google/AWS: ja; OpenAI: nee (custom nodig); ElevenLabs: doorgaans nee/NVT. - Totale productiekost: wordt bepaald door ASR‑tarief + ingeschakelde features (diarisatie, vertaling, redactie) + infrastructuur (opslag/egress) + kwaliteitsproces. Voor pure transcriptie op schaal zijn Deepgram en Google (standaard) vaak het voordeligst; voor uitgebreide analytics zijn AssemblyAI/ AWS/Google met native features en tooling aantrekkelijk; voor TTS/voice‑apps is ElevenLabs het meest kost‑efficiënt.
Verbinding maken met de Gemini API via een Single Access
Hoe je de unieke sterke punten van de frontiermodellen van de Gemini API benut zonder te verdrinken in SDK-onderhoud

Integreer CometAPI met Promptfoo: alles wat je moet weten
Integreer CometAPI met Promptfoo: Leer hoe u de 500+ AI-modellen van CometAPI met Promptfoo integreert voor krachtige. Toegang via CometAPI — 500+ modellen.
Hoe je AI-API-kosten vóór de lancering kunt inschatten
AI-API-kosten voor de lancering inschatten: Leer precies hoe de prijsstelling bij OpenAI, Anthropic, Google Gemini en meer werkt. Beschikbaar via CometAPI.

CometAPI vs directe provider-API's: wanneer een geünificeerde AI-API-gateway gebruiken in 2026
CometAPI vs directe provider-API's: Ontdek CometAPI vs directe API's zoals OpenAI en Anthropic. Beschikbaar via CometAPI — concurrerende prijzen, 500+ modellen.

Wat kan CometAPI vandaag voor u doen?
Ontdek hoe CometAPI ontwikkelaars en bedrijven helpt toegang te krijgen tot 500+ AI-modellen via één OpenAI-compatibele API. Kom meer te weten over multimodale AI, automatiseringsworkflows, kostenoptimalisatie, gebruiksscenario's, codevoorbeelden