Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Gemini API Free Tier 2026: Gratis modellen, limieten en prijsgids
Voorbehoud: mijn kennis reikt tot okt 2024. Controleer altijd de actuele pagina’s hieronder voor 2026-updates.
Wat is in 2026 gratis bij de Gemini API
- Waar te controleren:
- Modellen en prijzen: https://ai.google.dev/pricing
- Modelcatalogus (beschikbaarheid per regio/variant): https://ai.google.dev/models
- Rate limits: https://ai.google.dev/gemini-api/docs/rate-limits
- Werkwijze om gratis modellen/tiers te vinden:
1) Open ai.google.dev/pricing en filter op “Gemini API” (niet Vertex AI).
2) Zoek per model/variant (bijv. 1.5 Pro, 1.5 Flash, 1.5 Flash-8B, Vision) naar vermeldingen als “no-cost tier”, “free quota” of “evaluatiegebruik”.
3) Let op voetnoten: gratis tiers zijn vaak beperkt tot ontwikkel/evaluatie, met lagere RPM/TPM/RPD en zonder SLA.
4) Controleer of multimodale features (beeld/audio/video) een apart gratis contingent hebben.
Begrijp de limieten: RPM, TPM en RPD
- RPM (requests per minute): maximaal aantal API-aanroepen per minuut. Overschrijding geeft meestal HTTP 429.
- TPM (tokens per minute): totaal aantal verwerkte tokens per minuut (prompt + completion). Kan limiteren zelfs als RPM laag is maar prompts/langere antwoorden groot zijn.
- RPD (requests per day): dagquotum aan verzoeken. Kan dagelijks resetten op UTC.
- Scope en gedrag:
- Limieten kunnen gelden per API-sleutel, per project of per account; zie de rate-limit documentatie.
- Sommige endpoints hebben aparte limieten (streaming, batch, media-upload).
- Bij 429: implementeer exponentiële backoff en eventueel jitter; verlaag batch-grootte en tokens.
- Waar te zien/aan te passen:
- AI Studio “Usage/Quotas” (https://aistudio.google.com/).
- Aanvraag voor verhoging via support/quotaverhogingsformulier gelinkt vanaf de rate-limits pagina.
Python: snelle setup
- Installatie:
- pip install google-generativeai
- API-sleutel:
- Haal een sleutel in AI Studio: https://aistudio.google.com/app/apikey
- Stel in als omgevingsvariabele GOOGLE_API_KEY of geef door aan de client.
- Voorbeeld:
- import os, google.generativeai as genai
- genai.configure(api_key=os.environ["GOOGLE_API_KEY"])
- model = genai.GenerativeModel("gemini-1.5-pro") (kies gewenste modelnaam van de modelcatalogus)
- resp = model.generate_content("Schrijf een korte samenvatting over …")
- print(resp.text)
- Tips:
- Beperk tokens met generation_config (bijv. max_output_tokens, temperature).
- Gebruik streaming voor lage latentie: model.generate_content(..., stream=True) en itereren over chunks.
- Afhandeling 429/5xx: retry met exponentiële backoff (max retries), respecteer Retry-After indien aanwezig.
Billing en gebruik
- Twee paden:
- Gemini API (AI Studio keys, ai.google.dev): beheer sleutel, usage en eventueel facturatie vanuit AI Studio. Prijzen: ai.google.dev/pricing.
- Vertex AI (Google Cloud): gebruik Vertex AI’s generatieve endpoints; facturatie via Cloud Billing. Prijzen: https://cloud.google.com/vertex-ai/pricing
- Basisstappen Gemini API:
1) Maak API-sleutel (AI Studio).
2) Controleer pricing en gratis tier voor jouw model/gebruik.
3) Bekijk Usage/Quota in AI Studio om verbruik en limieten te monitoren.
4) Als betaalde toegang vereist is, volg de in AI Studio gelinkte billing-activatie of koppel aan een Cloud Billing-account indien gevraagd.
- Basisstappen Vertex AI:
1) Maak/selekteer een Google Cloud-project en activeer Billing: https://console.cloud.google.com/billing
2) Activeer Vertex AI API in API Library.
3) Stel quota’s in/aanvraag verhoging via IAM & Admin → Quotas.
- Kosteninschatting (algemeen):
- Totale kosten ≈ (input tokens × prijs_in/1K) + (output tokens × prijs_out/1K) + eventuele multimodale toeslagen (beeld/audio/video).
- Streaming en tool/function calling worden doorgaans op tokenbasis afgerekend; check prijsnotities voor uitzonderingen.
- Meet tokens lokaal vooraf of lees usage-metrics in AI Studio/Cloud Console.
Google vs. CometAPI: prijsvergelijking
- Zo vergelijk je eerlijk:
- Modeldekking: welke modellen/versies en context window-groottes.
- Prijs per 1K input- en outputtokens, aparte tarieven voor multimodaal (beeld/audio/video).
- Gratis tier: aantal gratis requests/tokens per dag/maand; beperkingen (RPM/TPM/RPD).
- Rate limits en schaalbaarheid: standaardquotum, aanvraag voor verhogingen, burst-gedrag, 429-beleid.
- SLA/ondersteuning: uptime, latency, enterprise features (VPC, data residency, compliance).
- Data policies: opslag, training-opt-out, PII-behandeling.
- Extra kosten: opslag/transcoding van media, batch jobs, fine-tuning, content-safety.
- Praktische aanpak:
1) Verzamel actuele tariefbladen:
- Google Gemini API: https://ai.google.dev/pricing
- Vertex AI (indien relevant): https://cloud.google.com/vertex-ai/pricing
- CometAPI: officiële pricingpagina/verkoperportaal (controleer datum en valuta).
2) Normaliseer naar prijs per 1K tokens en noteer inclusieve/exclusieve posten (bijv. beeld per stuk of per resolutie).
3) Reken drie profielen door:
- Kort: 300 in / 200 out tokens.
- Gemiddeld: 1.5K in / 800 out.
- Lang: 6K in / 2K out + 1 afbeelding.
4) Toets tegen jouw verwacht RPM/TPM/RPD en test met rate-limit-aware retries.
- Voorbeeldformule (invullen met actuele prijzen):
- Kosten = (in_tokens/1000 × prijs_in) + (out_tokens/1000 × prijs_out) + media_toeslagen
Waar je actuele info vindt (2026)
- Gratis modellen/tiers en tarieven: https://ai.google.dev/pricing
- Rate limits/quotas en verhogingen: https://ai.google.dev/gemini-api/docs/rate-limits
- AI Studio API-sleutels/usage: https://aistudio.google.com/app/apikey en Usage-sectie
- Vertex AI prijzen/quotas: https://cloud.google.com/vertex-ai/pricing en Cloud Console Quotas
- CometAPI: officiële website/pricingpagina van CometAPI
Wil je dat ik een kosten- en limietenblad invul als je je doelmodel(s), verwachte tokens per call en gewenste RPM/TPM/RPD opgeeft?
Deon GoodwinOnderzoeksteam voor AI-modellen en API
De gratislaag van de Gemini API is in oktober 2026 beschikbaar voor geselecteerde modellen, waaronder Gemini 3.8 Flash, Gemini 3.6 Flash, Gemini 3.5 Flash-Lite en Gemini 3.1 Flash-Lite. Je kunt starten zonder facturering in te stellen, maar de aan je project toegewezen quota bepalen hoeveel je daadwerkelijk kunt draaien.
Begin met Gemini 3.8 Flash voor veeleisende codeer- en redeneerscenario’s, of met een Flash-Lite-model voor routinematige extractie en classificatie. Controleer vóór gebruik met echte klantgegevens de toepasselijke gegevensvoorwaarden. Als je betaalde capaciteit nodig hebt, vergelijk dan Google’s eigen tarieven met CometAPI’s apart gefactureerde toegang.
Belangrijkste punten
Gemini 3.8 Flash is de nieuwste hier besproken Flash-optie, met multimodale invoer en instelbare redeneringsinspanning.
blijft een ondersteunde optie voor bestaande integraties; en richten zich op lichtere workloads.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Gebruik deze samenvatting voor een snel antwoord en lees daarna de gids voor context, voorbeelden en implementatiedetails.
Gemini 3.6 Flash
Gemini 3.5 Flash-Lite
Gemini 3.1 Flash-Lite
Gemini 4 Argon vereist betaalde API-toegang. Gratis beschikbaarheid in een ander Google-product betekent niet dat je via de API gratis toegang hebt.
Controleer quota in AI Studio. Het contextvenster van een model verschilt van de verzoek- en token-toewijzing van je project.
Vergelijk de toegangsroutes. Google’s gratis quota en CometAPI’s prijzen, credits en accountlimieten staan los van elkaar.
Is de Gemini API gratis in 2026?
Google biedt gratis invoer- en uitvoertokens voor geselecteerde Gemini API-modellen, onderhevig aan projectniveauquota. Je kunt starten zonder facturering in te schakelen. Dit is een quotagebaseerde gratislaag, geen eenmalige promotiecredit.
Belangrijk onderscheid: Google AI Studio, de Gemini API en consumentabonnementen voor Gemini zijn afzonderlijke toegangservaringen. Dat een model in de ene interface beschikbaar is, betekent niet per se dat het via een andere interface gratis beschikbaar is.
Welke Gemini API-modellen zijn in oktober 2026 gratis?
De vier onderstaande modellen zijn nuttige startpunten voor tekst- en multimodale toepassingen. Ze vormen geen uitputtende lijst van alle endpoints die voor gratis toegang in aanmerking komen. Volg de modellinks om CometAPI-toegang te verkennen; Google-specificaties zijn onder de tabel gelinkt.
Model
Model-ID
Een praktische starttoepassing
Gemini 3.8 Flash
gemini-3.8-flash
Complexe codering, redeneren en toolgestuurde workflows
Gemini 3.6 Flash
gemini-3.6-flash
Bestaande Flash-toepassingen en algemene automatisering
Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite
Documentverwerking en lichte agenttaken
Gemini 3.1 Flash-Lite
gemini-3.1-flash-lite
Classificatie, vertaling en rechttoe-rechtaan extractie
Alle vier accepteren tekst-, afbeeldings-, video-, audio- en PDF-invoer en produceren tekst. Hun gepubliceerde invoerlimiet is 1,048,576 tokens, met tot 65,536 uitvoertokens. Deze modellimieten garanderen niet dat je gratis project een verzoek van die omvang kan versturen.
Audio, embeddings en afbeeldingsgeneratie: toegang en limieten
Google vermeldt ook gratis toegang voor geselecteerde gespecialiseerde modellen, zoals Gemini 3.8 Live, Gemini 3.8 Flash TTS en Gemini Embedding 2. Zie de prijsvermelding voor het exacte model en endpoint voordat je integreert: een afbeelding of audioclip begrijpen is een andere mogelijkheid dan een afbeelding of stemrespons genereren.
API-methoden, verzoekformaten en limieten variëren per functionaliteit. Raadpleeg de documentatie voor het specifieke model en de bewerking die je wilt gebruiken.
Gratis toegang geldt niet voor elk Gemini-model of elk generatie-endpoint. Gemini 4 Argon vereist betaalde Gemini API-toegang, terwijl premium endpoints voor beeld- en videogeneratie hun eigen toelatingsregels hebben. Controleer het exacte model en de bewerking voordat je een functie integreert, in plaats van aan te nemen dat ze dezelfde gratis toewijzing delen.
Hoe presteert Gemini 3.8 Flash?
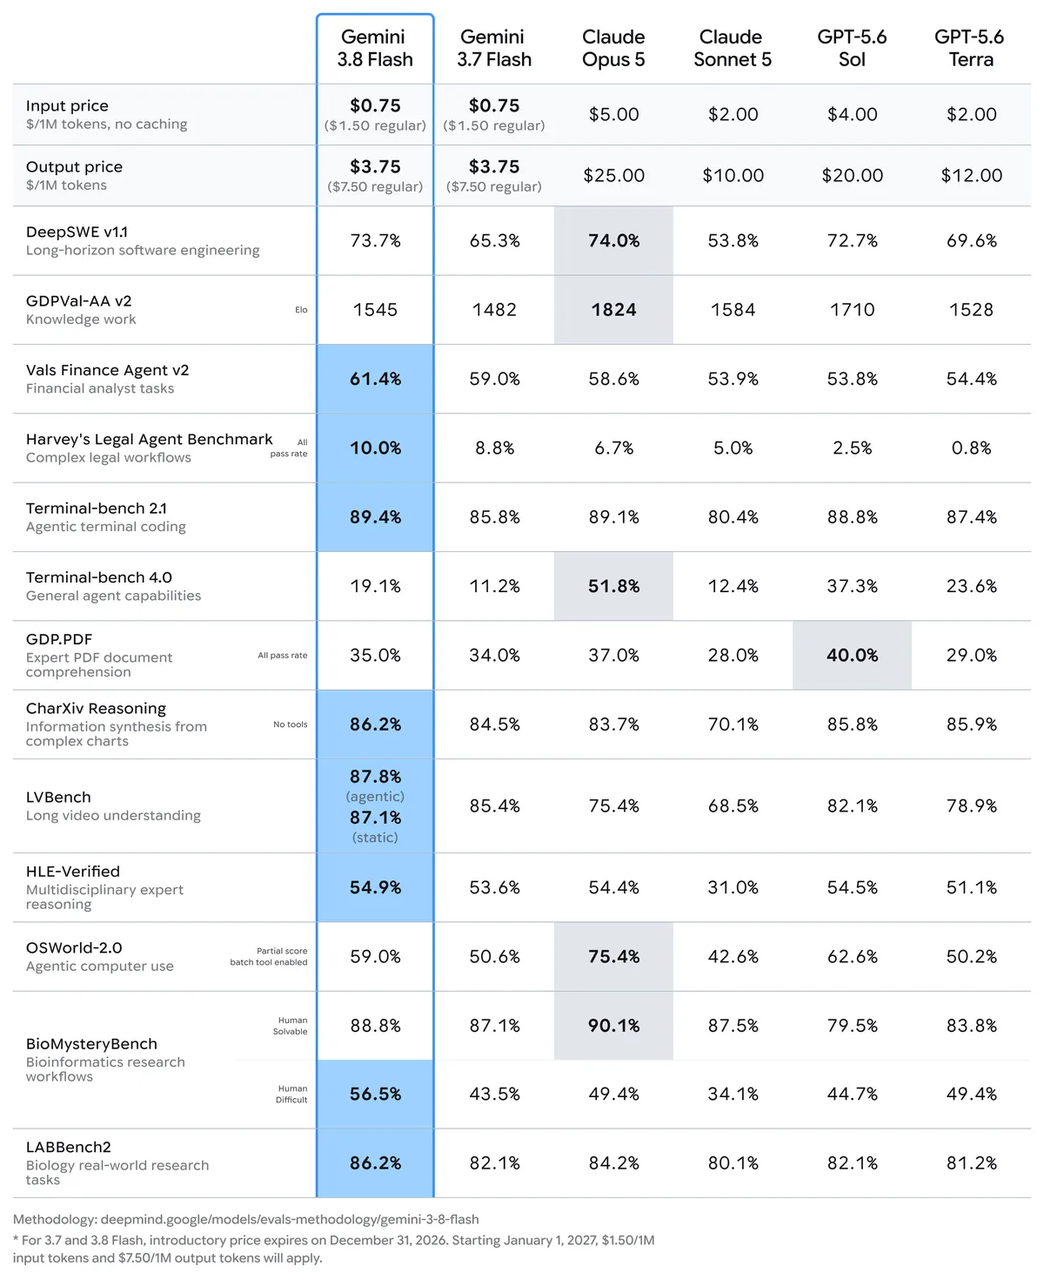
Google’s gepubliceerde evaluatie vergelijkt Gemini 3.8 Flash met Gemini 3.7 Flash en andere modellen. Het rapporteert 73.7% op DeepSWE v1.1, vergeleken met 65.3% voor 3.7 Flash—een stijging van 8.4 procentpunt. Op HLE-Verified stijgt de gerapporteerde score van 53.6% naar 54.9%.
Gebruik deze resultaten om een model te kiezen om te testen en evalueer het vervolgens aan de hand van voorbeelden uit je eigen toepassing. Voor een documentextractor kunnen correcte velden en stabiele opmaak van de output belangrijker zijn dan een codeerbenchmark. Voor een codeerassistent: meet of de voorgestelde wijziging werkt, hoe lang het duurt en hoeveel tokens deze verbruikt.
Wat zijn de ratelimieten van de Gemini API-gratislaag in 2026?
De grootste misvatting over de gratislaag van Gemini is dat elke account hetzelfde vaste aantal verzoeken ontvangt.
Open Google AI Studio, kies het project achter je API-sleutel en bekijk de actieve limieten voor je geselecteerde model. Google’s handleiding voor ratelimieten legt de quotadimensies uit; het dashboard toont de toewijzing die op jouw account van toepassing is.
RPM (requests per minute): Beperkt hoeveel verzoeken je per minuut kunt versturen. Let op korte pieken en parallelle workers die te veel verzoeken tegelijk versturen.
TPM (input tokens per minute): Beperkt het volume aan invoertokens dat je per minuut kunt versturen. Grote prompts, gespreksgeschiedenis en documenten kunnen deze toewijzing gebruiken, zelfs als het aantal verzoeken laag is.
RPD (requests per day): Beperkt je totale dagelijkse aantal verzoeken. Plan je workload rond de dagelijkse toewijzing en het resetmoment.
Een invoerlimiet van een miljoen tokens beschrijft de maximaal ondersteunde invoergrootte van het model. Het garandeert niet dat een project in de gratislaag genoeg TPM-capaciteit heeft om in één verzoek een miljoen tokens in te dienen. Contextcapaciteit en ratelimietcapaciteit moeten afzonderlijk worden beoordeeld.
Dagelijkse verzoekquota worden om middernacht Pacific Time gereset. Meerdere sleutels binnen één project delen de gebruikslimieten, dus een extra sleutel aanmaken voegt geen capaciteit toe. Voor specialistische modellen of bewerkingen kunnen andere limieten gelden.
429-fouten van de Gemini API afhandelen
Lees de foutbody voordat je opnieuw probeert. In de huidige Interactions API kan een 429 onderscheid maken tussen een kortetermijnlimiet voor verzoeken of tokens en een uitgeputte dagelijkse quota. Bij een kortetermijnlimiet: vertraag de queue en gebruik exponentiële backoff met jitter. Bij dagelijkse uitputting: wacht op de reset of wijzig het capaciteitsplan van de applicatie. Een 503 duidt in plaats daarvan op tijdelijke onbeschikbaarheid van de service. Zie Google’s API-foutreferentie.
Hoe verhouden de prijzen van Google en CometAPI zich?
Wanneer facturering voor de Gemini API start
Het opgebruiken van je gratis quota schakelt je project niet automatisch over naar betaald gebruik. Zonder een actief factureringsaccount krijgen verzoeken die de beschikbare gratis toewijzing overschrijden te maken met toegangs- of capaciteitsbeperkingen in plaats van standaardkosten voor betaalde tokens.
Om betaalde capaciteit te gebruiken, moet je facturering koppelen. Als je account is toegewezen aan een prepaidabonnement, moet je ook tegoed toevoegen, vanaf $5 of het lokale equivalent. Controleer je toegewezen plan en uitgaveninstellingen in AI Studio voordat je upgrade. Saldi en gebruiksregistratie kunnen met vertraging worden bijgewerkt, dus een getoond prepaid-saldo is geen onmiddellijke uitgavenstop.
Google’s Cloud-welkomsttegoed van $300 staat los van de gratislaag van de Gemini API. Accounts die na 2 maart 2026 zijn geopend, kunnen dat tegoed niet gebruiken voor Gemini API- of AI Studio-kosten. Bekijk de factureringsgids voor de regels die op jouw account van toepassing zijn.
Tokenprijzen van Google en CometAPI
De tabel vergelijkt Google’s standaard tokenprijzen met CometAPI’s gepubliceerde modeltarieven, gecontroleerd op 26 oktober 2026. Alle bedragen zijn USD per één miljoen tokens; uitvoer omvat factureerbare redenering waar van toepassing. Google’s gratis invoer en uitvoer gelden alleen voor in aanmerking komende verzoeken binnen de toewijzing van het project.
Model
Google gratis invoer/uitvoer
Google betaalde invoer/uitvoer
CometAPI invoer/uitvoer
Gemini 3.8 Flash
Free
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.6 Flash
Free
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.5 Flash-Lite
Free
$0.30 / $2.50
Controleer het huidige catalogustarief
Gemini 3.1 Flash-Lite
Free
$0.25 / $1.50
$0.20 / $1.20
Gemini 4 Argon
Not available
$2.00 / $10.00
$1.60 / $8.00
De hierboven genoemde introductieprijzen voor Flash van Google eindigen op 31 december 2026; 3.8 Flash en 3.6 Flash gaan dan naar $1.50 invoer en $7.50 uitvoer. De introductieprijs van Argon eindigt op 30 november 2026, waarna deze $4 invoer en $20 uitvoer wordt. CometAPI-tarieven moeten onafhankelijk worden gecontroleerd wanneer die promoties veranderen. Tools, caching, opslag, belastingen en andere services kunnen extra kosten toevoegen.
Een klein workloadvoorbeeld
Stel dat je 1,000 tekstverzoeken verstuurt, elk met 2,000 invoertokens en 500 uitvoertokens. Dat zijn twee miljoen invoertokens en een half miljoen uitvoertokens. Tegen de bovenstaande tarieven kost Gemini 3.8 Flash $3.375 via Google, of ongeveer $3.38, en $2.70 via CometAPI. Een in aanmerking komende workload in Google’s gratislaag kost $0 alleen als deze binnen de beschikbare quota past. Dit zijn schattingen van tokenkosten, geen gemeten facturen.
Hoe kun je de gratislaag van de Gemini API gaan gebruiken?
Je hebt een in aanmerking komend Google-account en -regio nodig, een API-sleutel en Python met pip beschikbaar. Het onderstaande voorbeeld volgt Google’s huidige stappenplan voor aan de slag gaan en gebruikt de Interactions API.
Maak een sleutel en installeer de SDK
Kopieer of maak in Google AI Studio een API-sleutel voor een project dat geen betaalde facturering heeft ingeschakeld. Installeer de SDK en stel vervolgens de sleutel in je terminalomgeving in. Bewaar de sleutel op je server in plaats van deze in browsercode in te sluiten.
pip install -U google-genai
Op macOS of Linux:
export GEMINI_API_KEY="your_api_key"
In Windows PowerShell:
$env:GEMINI_API_KEY="your_api_key"
Verstuur een verzoek en controleer het resultaat
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explain vector databases in 100 words."
)
print(interaction.output_text)
Sla dit op als een Python-bestand en voer het uit vanuit dezelfde omgeving. Een succesvol verzoek print een korte uitleg. Controleer vervolgens het gebruiksdashboard van AI Studio om te bevestigen welk project en model het verkeer ontvangen. Als het mislukt, inspecteer dan de foutcode en verifieer de sleutel, modeltoegang, quota en factureringsstatus voordat je de code wijzigt.
Hoe kunnen ontwikkelaars Gemini API-modellen via CometAPI gebruiken?
CometAPI biedt een aparte toegangsroute voor ondersteunde Gemini-modellen en andere AI-providers.
Kies deze route wanneer een gedeelde interface over providers je toepassing vereenvoudigt. Gebruik een CometAPI-sleutel met de bijbehorende endpoint en verifieer vervolgens de ondersteunde model-ID en accountlimieten. Google’s gratis quota worden niet overgedragen naar deze service. Het volgende voorbeeld gebruikt de OpenAI-compatibele interface gedocumenteerd door CometAPI.
pip install -U openai
Stel COMETAPI_KEY in je omgeving in met dezelfde shellspecificieke methode als hierboven, en voer vervolgens uit:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the benefits of RAG."
    }]
)
print(response.choices[0].message.content)
Bevestig vóór productie dat de beoogde model-ID wordt ondersteund door je CometAPI-account. Google-native identifiers en providerspecifieke aliassen komen niet gegarandeerd overeen voor elk model.
Welke privacybeperkingen zijn van toepassing op de gratislaag van de Gemini API?
Volgens Google’s Aanvullende Servicevoorwaarden voor de Gemini API kunnen prompts en outputs van onbetaalde services worden gebruikt om Google-producten te verbeteren, en kunnen menselijke beoordelaars ze bekijken. Dien geen gevoelige, vertrouwelijke of persoonlijke informatie in bij onbetaalde services. Betaalde API-services hebben andere gegevensgebruiksvoorwaarden.
Regionale regels zijn belangrijk: bepalingen voor gegevensgebruik van betaalde services zijn van toepassing op bepaalde onbetaalde gebruiken in de EER, Zwitserland en het VK, maar het beschikbaar maken van een API-client voor gebruikers in die regio’s vereist Betaalde services. Dat zijn afzonderlijke voorwaarden. Controleer de actuele voorwaarden voor jouw gebruikers en uitrol voordat je live gaat.
Hoe kun je het gebruik van de gratislaag van de Gemini API optimaliseren?
Bouw rond de quota die je hebt gemeten. Houd een kleine set representatieve taken bij en noteer taalsucces, latentie, invoer- en uitvoertokens en retries. Verander vervolgens één onderdeel van de workload tegelijk:
Routeer op moeilijkheid. Test Flash-Lite op routinematige extractie en gebruik alleen een groter model waar dit het resultaat verbetert.
Trim de invoer. Stuur het relevante documentgedeelte en de noodzakelijke gespreksgeschiedenis in plaats van telkens alles opnieuw te versturen.
Beheer de generatie. Vraag een nuttige uitvoerlengte aan en pas de redeneringsinspanning alleen aan waar het model en de API dit ondersteunen.
Herbruik werk. Sla herhaalde applicatieresultaten op en controleer modelspecifieke geschiktheid voor caching voordat je aanneemt dat API-caching gratis is.
Budgetteer gelijktijdigheid. Plaats workers achter een gedeelde queue zodat onafhankelijke taken geen vermijdbare piek veroorzaken.
Monitor tot slot kwaliteit én verbruik. Een goedkoper model dat vaak faalt of meerdere pogingen vereist kan meer werk creëren dan een iets duurdere optie die in één keer slaagt.
Een nuttige interne evaluatiemaatstaf is:
Effectieve kosten per succesvolle taak = Totale inferentiekosten / Aantal succesvolle taken
Voor experimenten in de gratislaag is een extra operationele maatstaf: succesvolle taken per beschikbaar quotavenster.
Veelgestelde vragen
Hoe kan ik bepalen of een quotaprobleem wordt veroorzaakt door verzoekpieken of grote documenten?
Vergelijk de tijdstempels van fouten met het aantal verzoeken en het volume aan invoertokens. Een piek van korte prompts wijst op verzoekfrequentie; enkele lange documenten kunnen de tokencapaciteit uitputten zelfs bij lage RPM. Inspecteer in de Interactions API de machineleesbare foutcode en onderscheid uitputting van de dagelijkse quota van een kortetermijnlimiet. Log tokenverbruik en gelijktijdigheid van workers samen, zodat je het relevante deel van de queue kunt aanpassen.
Wat moet ik doen als een verzoek time-out krijgt nadat ik het heb ingediend?
Een time-out vertelt je niet altijd of een externe bewerking is voltooid. Controleer voor een interactie waarvoor je een ID hebt de status voordat je een andere dure taak start. Gebruik een taak-ID op applicatieniveau rond je workflow en dedupliceer downstreamacties, met name e-mails, databaseschrijfacties en toolaanroepen. Een nieuwe poging tot tekstgeneratie mag niet stilzwijgend een bedrijfsactie herhalen. Google’s documentatie over Interactions beschrijft het ophalen van interacties en uitvoeringsstaten.
Hoe moet ik Flash en Flash-Lite vergelijken voor documentextractie?
Gebruik voor beide modellen dezelfde documenten, vereiste velden en acceptatieregels. Neem ruisrijke scans, ontbrekende velden en dubbelzinnige waarden op. Beoordeel de feitelijke veldnauwkeurigheid en de geldigheid van de output, en tel vervolgens het aantal retries en handmatige correcties. Een model dat minder tokens produceert kan nog steeds meer inspanning vergen als de fouten een nieuw verzoek vereisen. Houd een apart achtergehouden set documenten aan zodat promptwijzigingen niet alleen worden beoordeeld op voorbeelden die je al hebt getuned.
Wat moet ik controleren voordat ik een applicatie overschakel van Google naar CometAPI?
Test het exacte endpoint, de model-ID, het berichtformaat en de features die je applicatie gebruikt. Een compatibel chat-completions-verzoek garandeert geen identieke ondersteuning voor bestanden, tools, caching of instellingen voor reasoning. Vergelijk teruggegeven gebruiksvelden en foutafhandeling evenals de tekstrespons, en bekijk het gegevensbeleid van de intermediair en de upstreamprovider. Begin met een kleine, niet-gevoelige workload voordat je de rest van je verkeer verplaatst.
Hoe kan ik een integratie stabiel houden terwijl modellen en prijzen veranderen?
Houd model-ID’s, endpointinstellingen en prijsveronderstellingen in configuratie. Noteer model en datum bij evaluatieresultaten, monitor aankondigingen van afschaffing en voer representatieve taken opnieuw uit voordat je een model wijzigt. Stel budgetalerts in en herzie promotietarieven voordat hun einddatum verstrijkt. Houd een geteste fallback aan voor essentiële workloads, in plaats van ervan uit te gaan dat een gratis quota of een bepaald modelalias onbeperkt beschikbaar blijft.
Conclusie
De gratislaag van de Gemini API is een nuttige manier om een applicatie te valideren voordat je voor capaciteit betaalt. Kies een model voor de taak, meet de aan je project beschikbare quota en controleer de gegevensvoorwaarden voordat je productie-invoer gebruikt.
Begin voor een eerste experiment met één klein verzoek en bevestig dit in AI Studio. Meet vervolgens een representatieve workload. Als gratis capaciteit de beperkende factor wordt, vergelijk dan Google’s betaalde API met CometAPI met dezelfde prompts, kwaliteitsvereisten en volledige tokenkosten.