Bouwen met CometAPIHeb je één API voor meerdere modellen nodig?Test de workflow in Playground en maak daarna een API-sleutel aan wanneer het model en de kosten passen bij je use case.
Claude Haiku 5.5 is het snelste kleine model van Anthropic op standaardsnelheid voor taken met hoog volume en hoge latentiegevoeligheid. Het combineert een contextvenster van 1 miljoen tokens, een standaarduitvoerlimiet van 128K, adaptief redeneren en basisprijzen vanaf $0.10 per miljoen invoertokens en $0.50 per miljoen uitvoertokens. Tarieven stijgen wanneer een prompt meer dan 100,000 tokens bevat. Voor complexe code en uitgebreide agenttaken blijven Sonnet 5.5 en Opus 5.5 sterkere keuzes. CometAPI Standard-prijzen liggen 20% onder de officiële tarieven, vanaf $0.08 per miljoen invoertokens en $0.40 per miljoen uitvoertokens. De CometAPI-modelpagina is live en meldt productie-API-toegang.
Key Takeaways
Officiële release: 7 oktober 2026; Claude API-model-ID: claude-haiku-5-5.
Starttarieven API: $0.10 invoer en $0.50 uitvoer per miljoen tokens voor prompts tot 100K tokens. CometAPI: $0.08 invoer en $0.40 uitvoer per miljoen tokens, 80% van de officiële Standard-prijzen.
Context en uitvoer: 1M tokens context en 128K tokens standaarduitvoer.
Gecontroleerd op duidelijkheid, bronvermelding en actuele API-terminologie.
Focus: classificatie, documentextractie, routering, ondersteuning en gedelegeerde agenttaken.
De nieuwere tokenizer kan voor dezelfde tekst circa 30% meer tokens tellen; evalueer kosten per geaccepteerde taak in plaats van alleen prijs per token.
What Is Claude Haiku 5.5?
Claude Haiku 5.5 is het lichtgewicht lid van de huidige Claude-familie van Anthropic, ontwikkeld voor grote aanvraagvolumes waarbij responsiviteit en operationele kosten centraal staan. De primaire toepassingen omvatten documentverwerking, conversatie-ondersteuning, informatie-extractie en compacte subagent-taken. Het modeloverzicht van Anthropic bevestigt de lanceringsdatum, mogelijkheden en platformidentifiers.
Claude Haiku 5.5 is het eerste Haiku-model met configureerbare inspanningsniveaus, waardoor ontwikkelaars binnen hetzelfde model kunnen afwegen tussen diepte van redeneren, latentie en tokengebruik.
What Are the Key Features of Claude Haiku 5.5?
Adaptive thinking and adjustable effort
Haiku 5.5 kan beslissen wanneer en hoeveel het redeneert, terwijl de inspanningsparameter ontwikkelaars een manier biedt om responskwaliteit, latentie en tokenverbruik in balans te brengen. De standaardinspanning is gemiddeld. Voor eenvoudige classificatie kan lage inspanning de voorkeur hebben; voor ambigue extractie of tool-planningsstappen kan een hogere instelling gerechtvaardigd zijn.
Large-context processing
Een contextvenster van 1M tokens maakt het mogelijk om lange documenten en substantiële conversatiegeschiedenis in één request te plaatsen. Ontwikkelaars moeten nog steeds retrieval, truncatie en caching toepassen waar passend: lange contexten kunnen onnodige kosten en nauwkeurigheidstrade-offs introduceren, vooral boven de 100K-prijsdrempel.
Low-cost high-throughput processing
De nieuwe starttarieven van $0.10/$0.50 maken herhaalde korte requests aanzienlijk goedkoper dan de vorige Haiku-generatie op basis van prijs per token. Toch documenteert Anthropic een gewijzigde tokenizer: identieke tekst levert circa 30% meer tokens op dan op Haiku 4.5. Werkelijke besparingen op taakniveau kunnen daarom kleiner zijn dan de headline-tariefdalingen suggereren.
Computer use and delegated agent tasks
Gepubliceerde evaluaties tonen sterkere prestaties op computerinteractie en tool-ondersteunde taken dan het voorgaande Haiku-model. Hierdoor is Haiku 5.5 nuttig voor begrensde agentstappen, maar succesvolle automatisering blijft afhankelijk van sterke toolmachtigingen, foutherstel en menselijke goedkeuring voor risicovolle acties.
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic rapporteert aanzienlijke winst op professionele kennistaken, computergebruik, coderen en redeneren. De onderstaande resultaten gebruiken de gerapporteerde evaluatie-instellingen; scores van verschillende benchmarks moeten niet worden samengevoegd tot één “intelligentiescore.”
Benchmark
Haiku 4.5
Haiku 5.5
Sonnet 5.5
GDPval-AA v2.1 (Elo)
735
1,620
1,840
AA-Briefcase v1.1 (Elo)
614
1,578
1,824
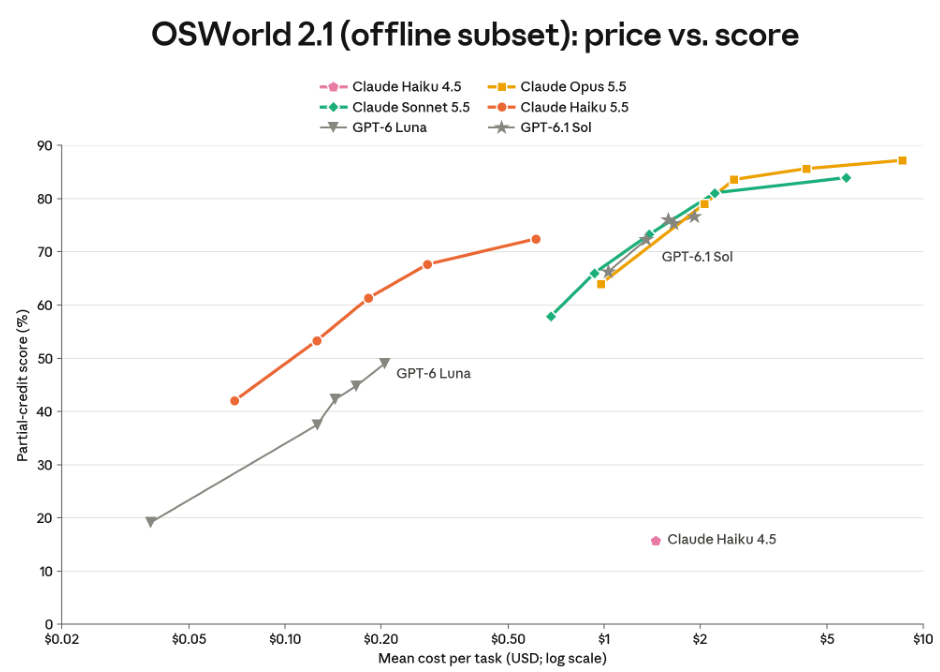
OSWorld 2.1, offline subset, partial credit
15.7%
72.4%
83.9%
Humanity's Last Exam, no tools
10.2%
45.9%
56.9%
Humanity's Last Exam, with tools
18.7%
57.4%
64.5%
Terminal-Bench 4.0
0.0%
39.2%
70.6%
Chartography, no tools
6.4%
46.4%
61.6%
De standaard Haiku 5.5-evaluatieconfiguratie in de system card gebruikt adaptief denken op maximale inspanning, standaard sampling en vijf pogingen, tenzij anders aangegeven; het product heeft standaard gemiddeld, dus de headline-scores zijn geen garanties voor de standaardinstellingen. OSWorld gebruikt 82 offline taken, geen internettoegang, 1080p en een limiet van 500 acties. De 72.4% is een gedeeltelijke score; het strikte slagingspercentage is 37.1%. GDPval-AA en AA-Briefcase worden door Anthropic gerapporteerd op basis van onafhankelijk uitgevoerde Artificial Analysis-evaluaties.
Terminal-Bench 4.0 gebruikt Claude Code in --bare-modus met ingeschakelde waarborgen. Haiku 5.5 gebruikt maximale inspanning, geen fallbackmodel en geen uitgaande internettoegang, met 10 pogingen per taak; Sonnet 5.5 gebruikt vijf pogingen en een fallback voor sommige gemarkeerde requests. Haiku 4.5 gebruikt een vast denkbudget van 63,999 tokens. Deze configuratieverschillen zijn belangrijk bij de interpretatie van 39.2% versus 70.6%.
De gepubliceerde benchmarkresultaten van Anthropic leveren de bovenstaande scores. OSWorld gebruikt de offline subset; Humanity's Last Exam scheidt runs met en zonder tools, en Chartography is zonder tools. Dit zijn door de leverancier gerapporteerde resultaten, geen onafhankelijke metingen onder een uniforme configuratie. Anthropic geeft evaluatiedetails in de Haiku 5.5 system card; reproduceer de relevante instellingen voor inspanning, tools, scaffold en budget voordat je je eigen resultaten vergelijkt. De lanceringssamenvatting specificeert geen volledige uniforme testomgeving voor elke rij.
De officiële evaluatiegrafiek van Anthropic hierboven is overgenomen uit de system card. Het levert extra bewijs over de geëvalueerde configuraties; het is geen nieuwe benchmark die speciaal voor dit artikel is geproduceerd.
Benchmark Interpretation
De verbetering op OSWorld suggereert dat Haiku 5.5 aanzienlijk nuttiger is geworden voor gestructureerde grafische taken. Toch wijst Sonnet 5.5's 70.6% versus Haiku 5.5's 39.2% in Terminal-Bench op een aanhoudend voordeel van grotere modellen bij agentisch coderen. Selecteer modellen op basis van faalkosten en moeilijkheidsgraad van de daadwerkelijke workflow.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
Dimension
Haiku 4.5
Haiku 5.5
Sonnet 5.5
Context
200K
1M
1M
Max standard output
64K
128K
128K
Standard input / MTok
$1
$0.10 up to 100K; $0.50 over
$2
Standard output / MTok
$5
$0.50 up to 100K; $2.50 over
$10
Reasoning
Extended thinking with a fixed token budget
Adaptive; medium default
Adaptive; high default
Relative latency
Fast
Fastest at standard speed
Fast
Coding depth
Bounded tasks
Stronger subagents
More complex coding
Typical use
Legacy small-model deployments
High-volume workflows
Complex production workflows
Gedeelde specificaties: alle drie de modellen accepteren tekst- en afbeeldingsinvoer en produceren tekstuele uitvoer. Ze zijn toegankelijk via de Claude API en ondersteunde partnerplatformen; modelidentifiers en accounttoegang zijn afhankelijk van de aanbieder. De geciteerde productdocumentatie stelt geen parameteraantallen of gedetailleerde architecturen vast.
Haiku 5.5 is een logische eerste keuze voor verifieerbare en repetitieve taken. Sonnet 5.5 wordt aantrekkelijker waar sterker oordeel herhaalde mislukte calls, tool-retries of menselijke correcties voorkomt. Opus 5.5 is een optie voor bijzonder veeleisende meerstapsopdrachten.
De relatieve latentielabels verwijzen naar standaardsnelheidsmodi. De kwalificatie van snelheid door Anthropic sluit Opus Fast Mode uit van de claim van snelste model. Architectuurdetails zoals parameteraantal worden niet vastgesteld door deze productlagen. Tekst- en afbeeldingsinvoer met tekstuele output is iets anders dan beeldgeneratie.
De capaciteitsvergelijking volgt de modelspecificaties van Anthropic. Platformtoegang hangt af van de gekozen aanbieder en het account; geen modeltier impliceert een gepubliceerd parameteraantal.
Workload Selection
Workload
Practical default
Why
Email classification
Haiku 5.5
Korte, herhaalde, verifieerbare beslissingen
Document field extraction
Haiku 5.5
Kostenefficiënte gestructureerde verwerking
Support triage
Haiku 5.5
Snelle reacties en escalatie
Coding subagents
Haiku 5.5
Goedkope zoeksessies in bestanden en begrensde edits
Complex debugging
Sonnet 5.5
Sterkere prestaties op codebenchmarks
High-stakes multi-step reasoning
Opus 5.5
Capabelder model voor veeleisende taken
Mixed workload
Haiku + Sonnet
Routeren op basis van complexiteit en vertrouwen
How Much Does Claude Haiku 5.5 Cost?
Waarom wordt Haiku 5.5 aangeprezen als “ongeveer 75% goedkoper” als de tokenprijs 90% lager is?
De 90% heeft betrekking op de verlaging in Standard-tarieven voor invoer en uitvoer voor prompts tot 100,000 tokens; langere prompts krijgen een 50% verlaging. Anthropic meldt dat Haiku 5.5 gemiddeld ongeveer 75% goedkoper is in gebruik, rekening houdend met de mix van requestlengtes van het eerdere model en wijzigingen in het tokenverbruik per taak. Tokenisatie is één factor: dezelfde invoer kan als circa 30% meer tokens tellen, dus kostenramingen moeten worden gebaseerd op tellingen met het nieuwe model.
De officiële prijsinformatie van Anthropic kent twee promptlengte-banden. De tarieven in de eerste tabel zijn officiële USD-prijzen per miljoen tokens; de onderstaande CometAPI-vergelijking past 20% korting toe op de officiële Standard-invoer- en -uitvoertarieven.
Rate category
Prompt up to 100K
Prompt over 100K
Input
$0.10
$0.50
Output
$0.50
$2.50
5-minute cache write
$0.125
$0.625
1-hour cache write
$0.20
$1.00
Cache read
$0.01
$0.05
Batch input (50% off)
$0.05
$0.25
Batch output (50% off)
$0.25
$1.25
Officiële Standard-, cache- en Batch-tarieven zijn hierboven weergegeven, gecontroleerd op 8 oktober 2026. Promptlengte bepaalt welke prijsband geldt; de hogere band is van toepassing op het hele request en niet alleen op de tokens boven 100K. De onderstaande CometAPI Standard-tarieven zijn gelijk aan de overeenkomstige officiële Standard-tarieven vermenigvuldigd met 0,8. Deze vergelijking veronderstelt niet dat de gatewaykorting stapelt met Batch- of cachingkortingen.
Prompt length
Token category
Official Standard / MTok
CometAPI / MTok
Up to 100K tokens
Input
$0.10
$0.08
Up to 100K tokens
Output
$0.50
$0.40
Over 100K tokens
Input
$0.50
$0.40
Over 100K tokens
Output
$2.50
$2.00
Example: 100,000 short requests per month
Ga uit van 2,000 invoertokens en 500 uitvoertokens per request; elk request blijft onder de 100K-drempel. Negeer promptcaching, tools en retries, en veronderstel voor de illustratie identieke tokenaantallen tussen modellen.
Model / provider
Input/month
Output/month
Total/month
Haiku 4.5 — official Standard
$200
$250
$450
Haiku 5.5 — official Standard
$20
$25
$45
Sonnet 5.5 — official Standard
$400
$500
$900
Haiku 5.5 — CometAPI
$16
$20
$36
In dit voorbeeld gebruiken 100,000 requests 200 miljoen invoertokens en 50 miljoen uitvoertokens. CometAPI-invoer kost 200 × $0.08 = $16 en uitvoer kost 50 × $0.40 = $20, samen $36 per maand versus de officiële $45: een besparing van $9, ofwel 20%. Het scenario sluit caching, tools en retries uit en gebruikt vaste tokenaantallen; meet kosten per geaccepteerde taak op representatieve input omdat de nieuwere tokenizer tokenaantallen verandert.
De vergelijking van $450 naar $45 is een illustratie met vaste tokens van een tariefdaling van 90%, niet een belofte van 90% besparing voor gelijkwaardige echte workloads. In de lanceringsaankondiging meldt Anthropic circa 75% lagere gemiddelde gebruikskosten na rekening te houden met requestlengtes en wijzigingen in tokenverbruik. Tel representatieve input opnieuw en meet kosten per voltooide taak voordat je je eigen besparingen inschat.
Where Can You Access Claude Haiku 5.5?
Official access and cloud platforms
Haiku 5.5 is beschikbaar via de Claude API en ondersteunde platformen op Amazon Web Services, Google Cloud en Microsoft Azure, volgens de beschikbaarheidsaankondiging van Anthropic. De directe Claude API-model-ID is claude-haiku-5-5; Amazon Bedrock gebruikt anthropic.claude-haiku-5-5. Gebruik credentials die door je gekozen aanbieder zijn uitgegeven en controleer de actuele accounttoegangsvereisten.
Third-party access through CometAPI
De CometAPI-modelpagina vermeldt claude-haiku-5-5 als beschikbaar, met Standard-tarieven vanaf $0.08 per miljoen invoertokens en $0.40 per miljoen uitvoertokens voor prompts tot 100K, 20% onder de overeenkomstige officiële tarieven. Gebruik een door CometAPI uitgegeven sleutel met het endpoint en het requestformaat van CometAPI; dit is een aparte toegang ten opzichte van directe toegang tot de Anthropic API. Controleer de live pagina voor beschikbaarheid, prijsbanden en integratiedetails.
Bij het wisselen van aanbieder of upgraden van Haiku 4.5: verifieer model-ID’s, tel tokens opnieuw en test responslimieten en conversatieafhandeling. Raadpleeg voor implementatiedetails en breaking changes de migratiegids van Anthropic.
Migration Validation
Werk de model-ID bij en valideer requestvelden die specifiek zijn voor het endpoint.
Tel tokens opnieuw met de geüpdatete tokenizer, inclusief stabiele prefixen en tooldefinities.
Test instellingen voor adaptief denken, latentie-verdelingen en parsing van response-blokken.
Controleer tool-calls, foutherstel en eventuele accountbeperkingen voor opgeslagen thinking-blokken.
Vergelijk p50/p95-latentie, geaccepteerde-taakratio en totaal factureerbare tokens.
Gebruik gefaseerde uitrol en een rollback-pad voor bedrijfskritische workflows.
Assistant prefill is banned
De Haiku 5.5-migratiegids legt het gedrag van de tokenizer, ID’s en requestcompatibiliteit uit. Laat temperature, top_p en top_k weg. Indien expliciet opgegeven, moet temperature 1 zijn en top_p 0.99; elke top_k-waarde, of het gelijktijdig opgeven van zowel temperature als top_p, resulteert in een 400-fout.
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5 is geen universele vervanging voor grotere modellen. Complex coderen en redeneren over lange horizons blijven betekenisvolle differentiators voor Sonnet en Opus. Langere prompts kosten ook meer, dus het 1M-tokenvenster moet selectief worden gebruikt. Adaptief redeneren introduceert variatie in gegenereerde tokens en latentie; benchmarks vormen geen garanties voor een individuele bedrijfsworkflow.
Risicogevoelige automatisering moet gestructureerde output valideren, permissies voor externe tools beperken, auditlogs bijhouden en review vereisen vóór verstrekkende acties. Routeer onzekere taken naar sterkere modellen in plaats van uitsluitend te vertrouwen op de lagere basistokenprijs van Haiku.
Conclusion
Voor verwerking op grote schaal met meetbare acceptatiecriteria is Claude Haiku 5.5 een aantrekkelijke upgrade: lagere instapprijzen, grotere context, adaptief redeneren en sterkere gepubliceerde evaluaties. Voor complex programmeren en ambigue besluitvorming kunnen Sonnet 5.5 of Opus 5.5 betere totale economie leveren door retries en correcties te verminderen. De winnende strategie is het benchmarken van de volledige workflow en het routeren van requests op basis van moeilijkheid.
FAQ
How does Haiku 5.5's 100K pricing boundary affect a cached workflow?
Promptlengte bepaalt welke prijsband geldt; schat de kosten niet op basis van alleen nieuwe tekst en ga er niet van uit dat alleen de overtollige tokens het hogere tarief gebruiken. Tel het request voor het geselecteerde model, inclusief geschiedenis en tooldefinities, en reconcilieer vervolgens invoer, cache-schrijven, cache-lezen en uitvoer met de relevante band. Vergelijk facturen op representatieve gecachete requests voordat je een productiebudget vaststelt.
Can Haiku 5.5 thinking blocks be replayed across accounts?
Ze werken alleen in het account dat ze heeft geproduceerd of in een daarmee gelinkt account. Als een niet-gerelateerd account een opgeslagen thinking-block verzendt, verwijdert de API het voordat het model het ziet; het request kan nog steeds slagen zonder die redenering. Zie de officiële migratiegids. Bewaar de conversatieblokken en gebruik het oorspronkelijke of gelinkte account wanneer je een tool-workflow voortzet. Een gateway- of accountwissel moet expliciet worden getest; overeenkomende modelnamen garanderen niet dat opgeslagen thinking-blokken bruikbaar blijven.
Why can Haiku 5.5 truncate a response that Haiku 4.5 completed?
De nieuwere tokenizer kan voor dezelfde tekst meer tokens tellen, waardoor een ongewijzigde max_tokens-limiet minder equivalente output kan bevatten. Adaptief denken kan ook uitvoerbudget verbruiken. Inspecteer stop_reason en usage, tel prompts opnieuw met het nieuwe model en stel outputtoelagen bij op echte taken in plaats van legacy-limieten te kopiëren.
How should Haiku 5.5 routing thresholds be selected?
Gebruik een gelabelde steekproef uit de eigen workload om geaccepteerde-taakratio, correctiekosten en latentie te meten. Routeer requests die expliciete validatie niet doorstaan of de geteste taakscope overschrijden naar een sterker model. Stel de drempel af op totale workflowkosten, inclusief retries en escalatie, en monitor na wijzigingen in prompts, tools of inspanning.