Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Google annonserte Gemini 4 Argon 30. september 2026 som en frontier-modell for komplekse, langvarige arbeidsflyter. De publiserte resultatene viser et tydelig mønster: sterk ytelse i profesjonelt kunnskapsarbeid, oppgaver med lang kontekst og utvalgte programvareingeniør-evalueringer, med svakere resultater på enkelte terminal- og databruksbenchmarker. Google innfører modellen gjennom en trinnvis utrulling. Uavhengig av dette rapporterer CometAPI katalogtilgjengelighet fra 1. oktober; kontokvalifisering og en vellykket testforespørsel bør sjekkes før produksjonssetting. Den mest nyttige ytelseshistorien er hvor gevinstene oppstår.
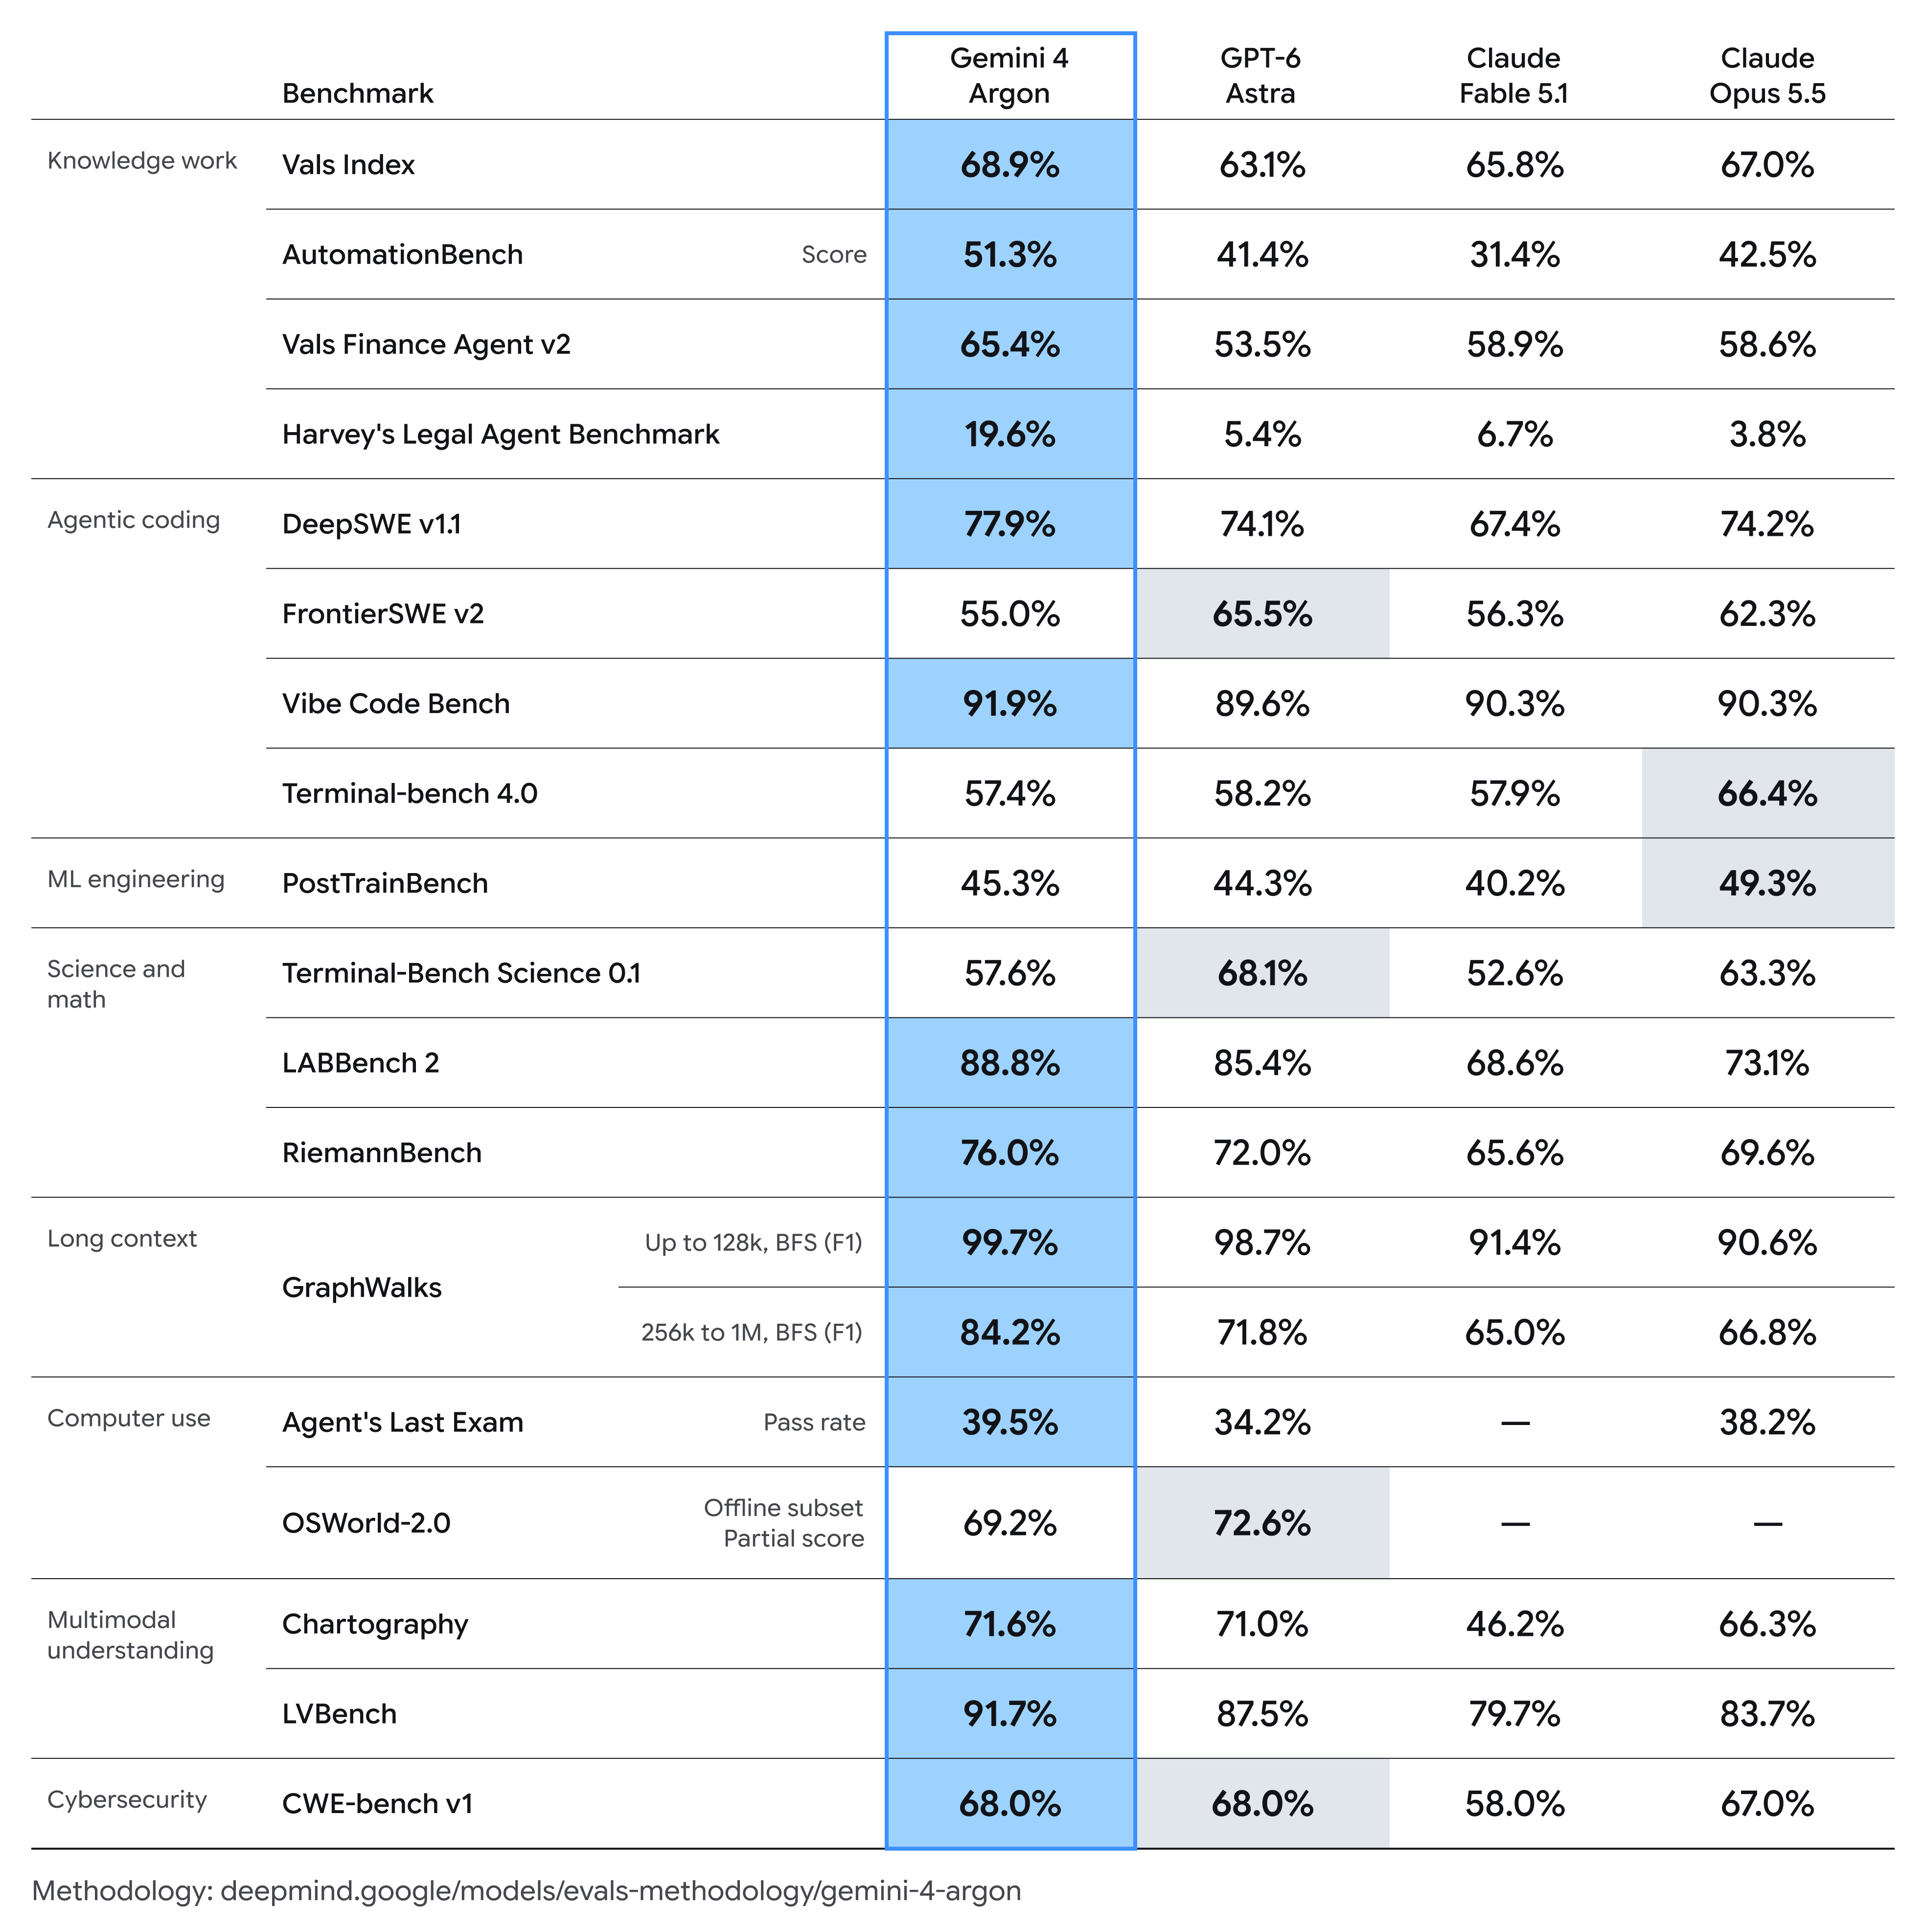
Argon oppnår 68.9% på Vals Index, 65.4% på Vals Finance Agent v2, 77.9% på DeepSWE v1.1, 91.7% på LVBench og 84.2% på GraphWalks ved 256K–1M kontekst. Samtidig ligger den bak konkurrerende frontier-modeller på FrontierSWE v2, Terminal-Bench 4.0, Terminal-Bench Science og OSWorld-2.0.
Resultatene støtter et arbeidslast-spesifikt syn på Argon. De sterkeste poengene klustrer rundt profesjonelt kunnskapsarbeid, svært lang kontekst og utvalgte multimodale og programvareingeniør-evalueringer. Andre modeller beholder fordeler på flere tester for terminal- og databruk.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
Ytelse i Gemini 4 Argon: referansetester og begrensninger - CometAPI
Key Takeaways
Gemini 4 Argon er sterkest i virksomhetsrettet kunnskapsarbeid, resonnering med lang kontekst, multimodal forståelse og flere langt-horisont-kodingsevalueringer.
Den maksimale utdata-grensen på 1 million token gir mer generasjonsrom for lange resonneringsforløp; den etablerer ikke en offentlig spesifikasjon for inndatakontekst.
Argon leder flere publiserte resultater innen kunnskapsarbeid og lang kontekst, men GPT-6 Astra og Claude Opus 5.5 ligger foran på utvalgte koding- og databruksevalueringer.
Benchmarkpoeng beskriver bestemte modell- og agentkonfigurasjoner. Metrikker, inndataforhold og evalueringsinnstillinger er like viktige som prosentsatsene i overskriftene.
Googles utrulling og CometAPI-tilgang er separate tilgjengelighetsutsagn. Verifiser aktiv rute, modellidentifikator og kontoberettigelse før du migrerer trafikk.
What Is Gemini 4 Argon?
Gemini 4 Argon er Google DeepMind sin nye frontier Gemini-modell, bygget rundt krevende arbeidsflyter som krever resonnering over mange trinn snarere enn svar på én kort prompt.
Googles offisielle posisjonering vektlegger programvareingeniørarbeid i virkeligheten, virksomhetsrettet kunnskapsarbeid som jus og finans, defensiv cybersikkerhet, multimodal forståelse og langvarige agentdrevne oppgaver.
Dette er en viktig forskjell fra de nylige Flash-utgivelsene. Gemini 3.8 Flash API i CometAPI er designet som en rimelig arbeidshest for agentdrevne arbeidsflyter i stor skala. Argon representerer i stedet frontlinjen i Googles stack, med prioritet på dybde og utholdende utførelse.
Model Specifications
Spesifikasjon
Gemini 4 Argon
Utvikler
Google DeepMind
Lansert
September 30, 2026
Modellfamilie
Gemini 4
Posisjonering
Frontier-resonnering og modell med lang horisont
Maksimal utdata
1,000,000 tokens
Langkontekst-evaluering
Testet gjennom 256K–1M på GraphWalks
Offentlig inndatakontekstgrense
Ikke formelt spesifisert i en standard offentlig API-spesifikasjon ved lansering
Multimodal forståelse
Ja; inkluderer diagrammer, dokumenter og evaluering av lange videoer
Agentdreven koding
Ja
Databruk
Evaluert
Cybersikkerhet
Spesialiserte defensive kapabiliteter
Google offentlig API-modell-ID
Ikke annonsert i Googles innledende offentlige dokumentasjon; CometAPI bruker gemini-4-argon som katalogidentifikator.
Output Budget and Trade-offs
Google annonserer en maksimal utdata-grense på 1 million token for Argon, opp fra den tidligere 64K-grensen sitert i lanseringskunngjøringen. Dette gir rom for lengre resonneringsforløp. Det bør ikke tolkes som et garantert totalbudsjett for en hel agentøkt med flere kall, eller som bevis på at alle oppgaver vil bli bedre.
Maksimal utdata er ikke det samme som intelligens. Å gi en modell flere utdata-token gjør den ikke automatisk mer kapabel; det fjerner én potensiell flaskehals. Modellen må fortsatt bruke budsjettet produktivt.
Det er også en kostnads- og latensavveiing. En modell som faktisk genererer hundretusener av token kan bli dyr og treg selv om den nominelle prisen per token ser attraktiv ut.
Utvalgte benchmarkresultater gjengitt fra artikkelen. Sammenlign modeller innen hver rad; metrikker og evalueringsforhold varierer. Dette diagrammet erstatter den dekorative gradientgrafikken og representerer ikke uavhengig testing.
En maksimal utdata-grense og et vindu for inndatakontekst beskriver ulike kapasiteter. GraphWalks-evalueringsområdet er evidens om de testede inndataene, ikke en erstatning for en offentlig API-spesifikasjon.
How Does Gemini 4 Argon Perform on Benchmarks?
Google DeepMinds ytelsestabell dekker agentarbeidsflyter, profesjonelt kunnskapsarbeid og multimodale oppgaver. Verdiene nedenfor gjengir den publiserte sammenligningen. De måler oppgaveytelse, ikke token-gjennomstrømming eller responssensitivitet/latens; “—” betyr at et resultat ikke er rapportert i denne sammenligningen.
Med mindre annet er angitt, bruker Argon-resultatene ett forsøk og den høyeste thinking-innstillingen. Resultater for andre modeller kommer generelt fra leverandørrapporter, med benchmark-spesifikke unntak. LVBench bruker 1 FPS for Gemini, 800 rammer for GPT-6 Astra, 300 for Fable 5.1 og 600 for Opus 5.5. Disse inndataene er ikke identiske, så sammenlign de rapporterte konfigurasjonene i stedet for å behandle hver rad som en kontrollert omkjøring.
Evaluation Conditions and Limitations
Tabellen er nyttig, men den skal ikke tolkes som en uavhengig universell toppliste.
Benchmarkutvalget er Googles utvalg.
De benchmark-spesifikke evalueringsinnstillingene varierer på tvers av rader, inkludert agentrammeverk, tidsbudsjetter, verktøy og inndataprøvetaking.
Den offisielle metodikken identifiserer leverandørrapporterte konkurrentresultater som standard, med benchmark-spesifikke topplister og egenberegnede unntak.
Den høyeste benchmark-innstillingen gjenspeiler ikke nødvendigvis en standard produksjonskonfigurasjon for inferens.
Et benchmarktall alene avslører ikke tokenbruk, verktøykall, omkjøringer, forløpt tid eller menneskelig inngripen.
For produksjonssystemer er ofte en bedre metrikk kostnad per vellykket fullført oppgave, snarere enn pris per token eller én benchmarkprosent.
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Det tydeligste mønsteret i Argons resultater vises i profesjonelt, flertrinns kunnskapsarbeid.
På Vals Index når Argon 68.9%, sammenlignet med 67.0% for Claude Opus 5.5. Det numeriske gapet er beskjedent, men mønsteret blir mer tydelig i spesialiserte arbeidsflyter.
Vals Finance Agent v2: 65.4%, 6.5 poeng over den sterkeste konkurrenten vist i Googles tabell.
AutomationBench: 51.3%, 8.8 poeng over Claude Opus 5.5.
Harvey's Legal Agent Benchmark: 19.6%, sammenlignet med 6.7% for den nest høyeste rapporterte modellen.
Ytelsesprofilen antyder at Argon drar mest nytte når modellen må samle informasjon, bevare tilstand, resonnere på tvers av flere stadier og produsere et profesjonelt artefakt fremfor å svare på et lukkert spørsmål.
Den lave absolutte poengsummen for juridisk agent er også viktig. Et resultat på 19.6% avslører ikke hvor mange kriterier eller komplette arbeidsflyter som feilet. Den nyttige konklusjonen er at Argon viser en stor relativ forbedring på denne evalueringen, samtidig som resultatet ikke etablerer pålitelig automatisering av juridisk arbeid.
Long-Context Reasoning
Argons mest slående fordel kan være 256K–1M-versjonen av GraphWalks.
Gemini 4 Argon: 84.2%
GPT-6 Astra: 71.8%
Claude Opus 5.5: 66.8%
Claude Fable 5.1: 65.0%
Det er en 12.4-poengs fordel over den nærmeste modellen i den publiserte sammenligningen.
Gapet er mye mindre ved kortere kontekster: på GraphWalks opp til 128K scorer Argon 99.7% og GPT-6 Astra 98.7%. Dette antyder at Argon degraderer mindre bratt enn de sammenlignede modellene på denne spesifikke evalueringen av svært lang kontekst.
Hva Google ikke har offentliggjort, er nok arkitekturinformasjon til å tilskrive denne forskjellen en spesifikk oppmerksomhetsmekanisme, gjenfinning, treningsoppskrift eller strategi ved inferens. Påstander som “Gemini 4 introduserer en ny oppmerksomhetsarkitektur” vil derfor gå utover det offentlige bevisgrunnlaget.
Coding Performance
Den offisielle benchmark-tabellen støtter ikke et enkelt ja.
Argon presterer svært godt på noen former for koding og taper tydelig på andre. På DeepSWE v1.1 når den 77.9%, mot 74.2% for Claude Opus 5.5 og 74.1% for GPT-6 Astra. Vibe Code Bench-scoren er også sterk på 91.9%.
FrontierSWE v2: 55.0% for Argon vs. 65.5% for GPT-6 Astra.
Terminal-Bench 4.0: 57.4% for Argon vs. 66.4% for Claude Opus 5.5.
Terminal-Bench Science 0.1: 57.6% for Argon vs. 68.1% for GPT-6 Astra.
Denne todelingen er viktig for utviklere. Argon virker spesielt sterk når koding blir en lang ingeniørarbeidsflyt med betydelig kontekst og planlegging, mens terminaltung utførelse forblir mer konkurransepreget. En benchmark for depotmigrering og en interaktiv terminalbenchmark bør ikke behandles som utskiftbare mål på “kodingsferdighet.”
Defensive Cybersecurity
Cybersikkerhet er et kjerneområde for utrulling. Googles defensive cybersikkerhetsposisjonering inkluderer autonom sårbarhetsoppdagelse, validering og patching. Dette er en leverandørkapabilitetspåstand; resultatet på CWE-bench nedenfor måler sårbarhetsutbedring i sin egen evaluering.
På CWE-bench v1 scorer Argon 68%, delt med GPT-6 Astra og litt foran Claude Opus 5.5 på 67%.
Google fremhever også sterkere sikringer mot misbruk, indirekte prompt-injeksjon, risikofylt agentatferd og kompromittering av kjøremiljø. Dette gjør Argon like mye til en agent-sikkerhetsutgivelse som en konvensjonell modelloppgradering.
Multimodal Understanding
Argon scorer 71.6% på Chartography og 91.7% på LVBench for forståelse av lange videoer. LVBench-resultatet er 4.2 prosentpoeng over GPT-6 Astra i Googles tabell. Fordi modellene mottar ulike konfigurasjoner for rammeprøvetaking, er dette en sammenligning av rapporterte oppsett snarere enn en ren modellfordel.
Dette er viktig fordi mange profesjonelle arbeidsflyter ikke er tekst-only. En finansiell forskningsagent kan måtte inspisere et diagram; en virksomhetsassistent kan kombinere rapporter, PDF-er og skjermbilder; et videoanalysesystem kan måtte bevare hendelser over en lang sekvens fremfor å prosessere individuelle rammer uavhengig.
Argons kombinasjon av multimodal persepsjon og utholdende resonnering er derfor mer relevant enn multimodal støtte alene.
Science and Mathematics Performance
Resultatene er blandede, men generelt sterke. Argon når 88.8% på LABBench 2 og 76.0% på RiemannBench, foran de sammenlignede modellene i Googles tabell. På Terminal-Bench Science 0.1 når imidlertid GPT-6 Astra 68.1% sammenlignet med Argons 57.6%.
Den forskjellen peker mot et bredere mønster: Argon synes sterkere i resonnering over vitenskapelig informasjon enn i enhver form for verktøydrevet vitenskapelig utførelse.
Computer-Use Performance
På Agent's Last Exam scorer Argon en binær bestått-rate på 39.5%, foran GPT-6 Astra på 34.2% og Claude Opus 5.5 på 38.2%. På OSWorld-2.0s frakoblede delsett er delscoren 69.2%, under GPT-6 Astras 72.6%. OSWorld-verdien er ikke en fullstendig oppgavesuksessrate, og manglende Claude-oppføringer impliserer ikke null kapasitet.
Dataene viser dermed ikke en generell fordel i databruk. For produksjonsutrulling bør benchmarktall suppleres med oppgavenivåtesting av navigasjonsnøyaktighet, feilklikk, omprøvingsfrekvens, utilsiktede handlinger, tid til fullføring og andel menneskelige korreksjoner.
Gemini 4 Argon vs GPT-6 Astra and Claude
Dimensjon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
Claude Fable 5.1
Kunnskapsarbeid
Svært sterk
Sterk
Svært sterk
Sterk
Langkontekst-benchmark
Sterkeste publiserte resultat
Sterk
Moderat–sterk
Moderat
Koding med lang horisont
Svært sterk
Svært sterk
Svært sterk
Sterk
Terminalkoding
Konkurransedyktig
Sterk
Sterkest i utvalgt test
Konkurransedyktig
Vitenskapelige terminalagenter
Konkurransedyktig
Sterkest i utvalgt test
Sterk
Konkurransedyktig
Multimodal forståelse
Svært sterk
Svært sterk
Sterk
Konkurransedyktig
Databruk
Konkurransedyktig
Sterk
Blandet / begrenset sammenligning
Begrenset sammenligning
Cybersikkerhet
Delt på topp på CWE-bench v1
Delt på topp
Svært nær
Lavere
Argon skiller seg ut i denne sammenligningen for lang kontekst, dokumenttunge og profesjonelle agentoppgaver. Utviklere kan sammenligne den med GPT-6 Astra, Claude Opus 5.5 og Claude Fable 5.1 via CometAPI.
Performance-based selection
De kvalitative etikettene over oppsummerer den utvalgte benchmark-tabellen, ikke en universell rangering. Foretrekk Argon for en pilot når arbeidet ligner på dens ledende evalueringer; test Astra og Opus på terminaltunge arbeidslaster før du velger standard.
Specifications and deployment constraints
Denne ytelsessammenligningen etablerer ikke en arkitekturfordel eller en generell pris–ytelse-vinner. Argons parameterantall og arkitektur er ikke spesifisert i de gjennomgåtte Google-lanseringsmaterialene. Dens offentlige inndatakontekstgrense krever offisiell API-dokumentasjon. CometAPI rapporterer en gemini-4-argon-rute; bekreft støttede parametere og kontoaksess uavhengig av Googles bredere utrulling. Sammenlign hver rutes grenser og faktiske oppgavekostnader før utrulling.
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI rapporterer modellen som tilgjengelig under gemini-4-argon. Bruk kontodashbordet til å opprette en API-nøkkel, velg den identifikatoren i playground, og kjør en testforespørsel før integrasjon. Dets OpenAI-kompatible eksempel bruker base-URL https://api.cometapi.com/v1. Bekreft modellens støttede endepunkt og parametere i kontodokumentasjonen; et katalogmerke alene verifiserer ikke en vellykket kall.
Opprett en CometAPI-konto og generer en API-nøkkel i dashbordet.
Velg gemini-4-argon og valider en representativ forespørsel i playground.
Konfigurer den kompatible klienten med CometAPI-base-URL, nøkkelen din og modellidentifikatoren; bekreft det støttede forespørselsskjemaet og fakturering før utrulling.
CometAPI and official pricing
Google annonserte introduksjonspriser på $2 per million inndata-token og $10 per million utdata-token, med bufrede inndata priset 95% under inndata-satsen. Etter introduksjonsperioden er de annonserte satsene $4 for inndata og $20 for utdata per million token. Dette er Googles annonserte satser, ikke CometAPI-priser eller bekreftelse på umiddelbar generell API-tilgang.
Faktureringsgrunnlag
Gemini 4 Argon-API i CometAPI
Offisiell kunngjøring fra Google
Sammenligning
Inndata / 1M token
$3.20
$4.00 etter introduksjonsperiode
20% under annonsert sats etter intro
Utdata / 1M token
$16.00
$20.00 etter introduksjonsperiode
20% under annonsert sats etter intro
Conclusion
Gemini 4 Argons benchmark-profil er mer interessant enn en enkel topplistepåstand.
De sterkeste resultatene i denne sammenligningen klustrer rundt profesjonelt kunnskapsarbeid, lang kontekst og utholdende agentutførelse. Dette mønsteret er nyttig for arbeidslastvalg, men identifiserer ikke underliggende arkitektur eller beviser hvilken mekanisme som forårsaket gevinstene.
De rapporterte resultatene innen finans, jus, lange videoer og programvareingeniørarbeid støtter en fokusert pilot for disse arbeidslastene. Om den samme fordelen vedvarer i produksjon avhenger av inndatamiksen, agentrammeverket, inferensinnstillingene og verifikasjonskravene.
Samtidig viser resultatene at ytelsen til frontier-modeller i økende grad blir spesialisert. Argon kan lede DeepSWE mens den ligger bak på FrontierSWE; lede Agent's Last Exam mens den ligger bak på OSWorld; og lede LABBench mens den ligger bak på Terminal-Bench Science. Disse benchmarkene belaster ulike deler av et agentsystem.
For utviklere er den viktigste lærdommen at modellvalg i økende grad må skje på arbeidslastnivå snarere enn på merke- eller familienivå.
FAQ
How should developers validate Gemini 4 Argon on their own workloads?
Bygg et representativt oppgavesett med eksplisitte akseptkriterier. Hold verktøy, tidsgrenser, inndatapreparering og omprøvingspolicyer sammenlignbare på tvers av modeller. Registrer fullførte oppgaver, totale token, forløpt tid og menneskelige korreksjoner. Start med en liten pilot og undersøk feilsaker før du ruter produksjonstrafikk.
Can Gemini 4 Argon's benchmark percentages be averaged into one score?
Nei. Tabellen kombinerer ulike metrikker, inkludert F1, bestått-rater og delscore. Bruk oppgavespesifikke kriterier i stedet for å snitte alle prosenter.
Should a Gemini 4 Argon agent always use its full output budget?
Nei. Velg det minste testede budsjettet som møter dine kvalitets- og pålitelighetskrav. Den maksimale utdata-grensen er et tak, ikke et mål.
How should teams evaluate Gemini 4 Argon access through CometAPI?
Start med en tilgjengelighetssjekk på kontonivå og en liten forespørsel ved bruk av den dokumenterte CometAPI-ruten. Mål responskvalitet, latens, grenser og fakturerte token, og anvend deretter de samme aksepttestene som brukes for alternative modeller. Behandle CometAPIs tilgangspåstand separat fra Googles bredere utrulling, og hold rutingen konfigurerbar til ruten møter kravene dine.