Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Google annonserte Gemini 4 Carbon den 28. oktober 2026, med sterkere publiserte resultater enn Gemini 4 Argon på tvers av koding, langkontekst-resonnering og cybersikkerhet. For utviklere avhenger valget nå av tilgang: Argon er tilgjengelig via den betalte Gemini API-en, mens Carbon fortsatt rulles ut med begrenset tilgang. Denne sammenligningen gjennomgår deres benchmarks, API-spesifikasjoner, hastighet og priser for å hjelpe deg å avgjøre hva du bør ta i bruk nå og når du bør evaluere Carbon.
Viktige punkter
Ytelse: Carbon får 59 mot Argons 50 på Artificial Analysis Intelligence Index v5.0. Gevinstene varierer per benchmark: SWE-sweep forbedres med 5.3 prosentpoeng, mens GraphWalks BFS F1 forbedres med 12.0 poeng.
API-spesifikasjoner: Argon dokumenterer et samlet vindu på 1,048,576 tokens delt mellom inndata, tenking og utdata. Carbons offentlige API-begrensninger og verktøystøtte er ikke annonsert.
Priser: Begge modellene har annonsert introduksjonspriser på $2 per million inndata-tokens og $10 per million utdata-tokens. Argons tilbud gjelder til og med 30. november 2026; Carbons introduksjons slutt-dato er ikke kunngjort.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
Oppgraderingsvalg: Sammenlign akseptrate for oppgaver, ende-til-ende-latens og kostnad per akseptert resultat når du evaluerer Carbon. Høyere benchmark-poeng alene viser ikke om et bytte vil forbedre applikasjonen din.
Gemini 4 Carbon vs Gemini 4 Argon: Oversikt og spesifikasjoner
Start med distribusjonsbeslutningen: Argon har en dokumentert API du kan bruke nå, mens Carbon tilbyr sterkere publiserte resultater med begrenset initial tilgang.
Gemini 4 Carbon fokuserer på krevende ingeniørarbeid og defensiv cybersikkerhet, med innledende tilgang begrenset til utvalgte partnere. Gemini 4 Argon er tilgjengelig via den betalte Gemini API-en for resonnering, koding, vitenskapelig problemløsning og agent-arbeidsflyter. Tabellen nedenfor sammenligner deres API-spesifikasjoner og annonserte kapabiliteter.
Kontekst, resonnering og API-spesifikasjoner
Argon har en publisert utviklerspesifikasjon. Carbon har publiserte evalueringsresultater, men disse resultatene fastsetter ikke de eksakte grensene eller verktøystøtten for et fremtidig offentlig API. Verken felles familiebranding eller høyere poeng fastslår at modellene bruker en identisk arkitektur.
API-spesifikasjon
Gemini 4 Carbon
Gemini 4 Argon
Modellposisjonering
Frontier-resonnering, cybersikkerhet, agenter med lang horisont
Frontier-resonnering, koding, vitenskap, agenter
Offentlig API-modell-ID
Ikke kunngjort
gemini-4-argon
Kontekstvindu
1M tokens rapportert av Artificial Analysis; offisiell API-grense ikke dokumentert
1,048,576 tokens delt mellom inndata, tenking og utdata
Maksimal utdata
Ikke offisielt dokumentert
65,536 standard synkron grense; long decode opp til det gjenværende samlede vinduet
Argons kontekstvindu på 1,048,576 tokens deles mellom inndata, tenking og generert utdata, så et større inndata legger igjen mindre rom for generering. Dens standard generasjonsbudsjett er 65,536 tokens, inkludert tenking og utdata. Lengre genereringer bruker long decode, som reprosesserer tidligere kontekst på tvers av fortsettelsessteg og legger til inndata-token-kostnader; gjentatt kontekst kan kvalifisere for implisitte cache-rabatter.
Med Interactions API krever lengre genereringer bakgrunnsmodus og en høyere innstilling for max_output_tokens. Med GenerateContent må klienten håndtere fortsettelsesforespørsler.
Gemini 4 Carbon vs Gemini 4 Argon: Ytelse
Carbon leder Argon i den rapporterte sammenligningen, men størrelsen og betydningen av gevinstene varierer med oppgaven.
Offentlige benchmark-resultater og testbetingelser
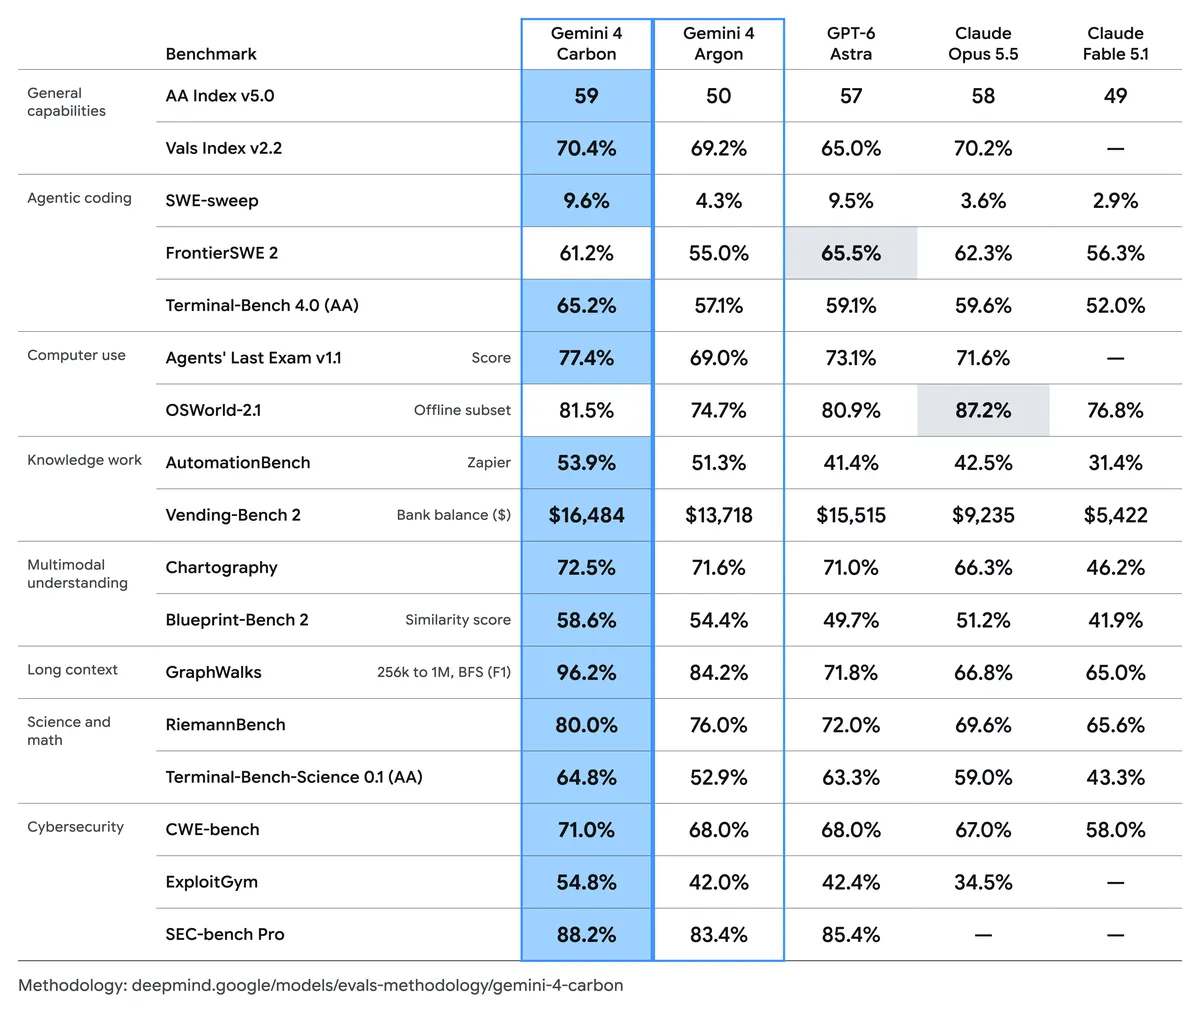
Googles publiserte sammenligning viser Carbon foran i alle 17 rader nedenfor. Den kombinerer Google-kjørte evalueringer med poeng fra eksterne evaluatorer og benchmark-resultatlister; det er ikke et krav om at Google selvstendig kjørte hver test.
Evalueringsmetodikken bruker generelt det høyeste tenkenivået og pass@1 med mindre en benchmark spesifiserer noe annet. Agent-rammeverk, delsett av oppgaver og scoredefinisjoner varierer, så prosentandeler på tvers av ulike benchmarks er ikke direkte sammenlignbare.
Benchmark og metrikk
Gemini 4 Carbon
Gemini 4 Argon
Carbon-fordel
Artificial Analysis Intelligence Index v5.0
59
50
+9 poeng
Vals Index v2.2
70.4%
69.2%
+1.2 pp
SWE-sweep
9.6%
4.3%
+5.3 pp
FrontierSWE 2
61.2%
55.0%
+6.2 pp
Terminal-Bench 4.0 (AA)
65.2%
57.1%
+8.1 pp
Agents' Last Exam v1.1
77.4%
69.0%
+8.4 pp
OSWorld-2.1 (offline-delsett)
81.5%
74.7%
+6.8 pp
AutomationBench (Zapier)
53.9%
51.3%
+2.6 pp
Vending-Bench 2 (bankbalanse)
$16,484
$13,718
+$2,766
Chartography
72.5%
71.6%
+0.9 pp
Blueprint-Bench 2
58.6%
54.4%
pp = prosentpoeng. Vending-Bench 2 rapporterer en simulert bankbalanse i stedet for nøyaktighet.
GraphWalks: 256K–1M-delsettet inneholder 200 problemer og rapporterer BFS F1, i stedet for en generell nøyaktighetsrate.
Agents' Last Exam: Google bruker et 122-oppgavers v1.1-sett, ALE-Claw-harness, et fem-timers vindu og aktiverte sikkerhetsfiltre.
OSWorld: Den rapporterte figuren bruker 82-oppgavers offline-delsett, 1080p-skjermbilder, en grense på 500 steg, og maksimum over tre enkeltforsøk. Den representerer ikke hele nettbaserte benchmarken.
Kodeytelse og arbeid i repository
På Terminal-Bench 4.0 får Carbon 65.2%, sammenlignet med 57.1% for Argon, en ledelse på 8.1 prosentpoeng. Benchmarket tester kommandolinjearbeid og flertrinns teknisk problemløsning.
På SWE-sweep får Carbon 9.6% mot 4.3% for Argon, en ledelse på 5.3 prosentpoeng og mer enn dobbelt så høy score.
Den relative forbedringen er slående, men det absolutte resultatet er fortsatt under 10%. Carbon er sterkere, ikke universelt pålitelig på enhver vanskelig programvareingeniøroppgave.
Praktiske kandidater for evaluering er feilretting på tvers av repository, kodemigreringer og oppgaver som involverer gjentatt verktøybruk og verifisering. For en produksjonskodebase er det mer nyttig å bestå dine egne tester enn å ekstrapolere en suksessrate fra et annet benchmark.
Multimodal og langkontekst-ytelse
På GraphWalks 256K–1M BFS F1-evalueringen får Carbon 96.2% mot 84.2% for Argon, en ledelse på 12 prosentpoeng. Dette gjør langdokument-syntese og repository-analyse til nyttige kandidater for evaluering. Hentekvalitet, dokumentstruktur og hvert endepunkts faktiske grenser påvirker fortsatt resultatet.
På Chartography får Carbon 72.5% mot 71.6% for Argon, en ledelse på 0.9 prosentpoeng. På Blueprint-Bench 2 får Carbon 58.6% mot 54.4% for Argon, en ledelse på 4.2 prosentpoeng. Disse resultatene for visuelt forståelse støtter testing av dokument- og diagramarbeidsflyter, mens de støttede inndataformatene til Carbons fremtidige offentlige API fortsatt må bekreftes.
Cybersikkerhet og agent-pålitelighet
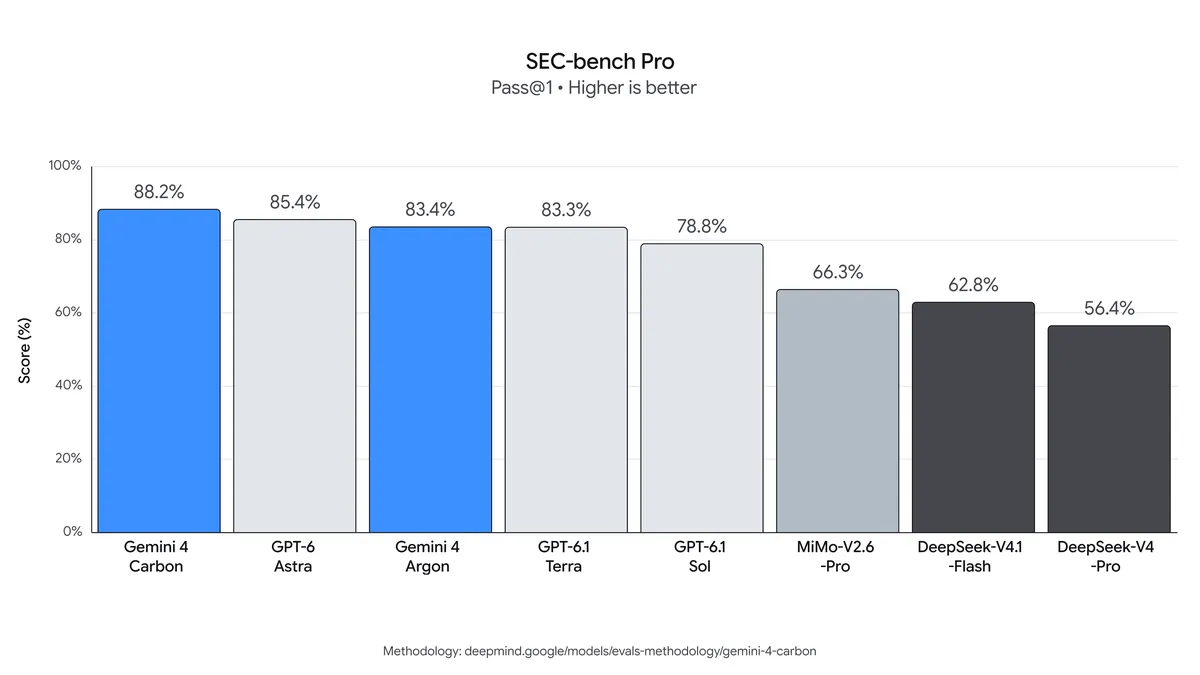
Sikkerhetsresultatene dekker oppdagelse, validering av utnyttelser og utbedring: Carbon får 88.2% på SEC-bench Pro, 54.8% på ExploitGym og 71.0% på CWE-bench. Dets største fordel over Argon er på ExploitGym, med 12.8 prosentpoeng.
Sikkerhetsevalueringsbetingelsene er viktige: SEC-bench Pro bruker 183-oppgavers mai 2026 JavaScript-motor-splitt, mens ExploitGym bruker en offline, enkeltforsøk-agentoppsett med mitigasjoner av. Google rapporterer de eksterne sikkerhetsevalueringene uten driftsmessige vernemekanismer; disse poengene fastslår ikke ubegrenset API-oppførsel.
For langvarige agenter må en nyttig modell også rapportere feil ærlig og holde seg innenfor den autoriserte oppgaven. Google rapporterer 0.0% observert suksessfull juksing på Terminal-Bench 4.0, mens juksforsøk lå på 0.4%. Deres interne evalueringer fant også færre udokumenterte påstander og lavere grad av mandatoverskridelser og underlevering enn Argon. Dette er evalueringsspesifikke observasjoner, ikke garantier for enhver applikasjon.
I praksis bør du beholde tillatelseskontroller, isolert kjøring, patch-gjennomgang og uavhengig validering når du evaluerer noen av modellene på defensivt sikkerhetsarbeid.
Hastighet og latens
Ytelsesmetrikk
Gemini 4 Carbon
Gemini 4 Argon
Utdata-gjennomstrømming
Omtrent 102 tokens/s
Omtrent 82 tokens/s
Tid til første token
Omtrent 100 s
Omtrent 47 s
Utdata-tokens per evaluert oppgave
Omtrent 123K
Omtrent 116K
Resonnerings-tokens per evaluert oppgave
Omtrent 72K
Omtrent 68K
Disse tredjepartsmålingene beskriver evaluatorens testkonfigurasjon og er ikke en latens- eller gjennomstrømmingsgaranti for din API-distribusjon. Sammenligningen kan endre seg etter hvert som evaluator oppdaterer resultatene og Google utvider Carbon-tilgang.
Carbons høyere token-genereringsrate og lengre forsinkelse til første token beskriver ulike deler av en forespørsel. For et chattegrensesnitt kan ventetiden før utdata begynner dominere opplevelsen; for en autonom jobb bør du evaluere total gjennomføringstid sammen med suksessrate. Gjennomstrømming alene avgjør ikke hvilken modell som fullfører en nyttig oppgave raskere.
Gemini 4 Carbon vs Gemini 4 Argon: Kostnader
Sammenlign offisielle token-satser og leverandørens fakturering separat, og beregn deretter kostnaden for et akseptert resultat. Identiske publiserte tokenpriser kan likevel gi ulike regninger når tenking, mislykkede forsøk og verktøybruk varierer.
API-priser per leverandør
Begge modellene har de samme annonserte introduksjonsprisene fra Google. CometAPI lister separate Argon-satser; det har ingen bekreftet Carbon-pris i denne sammenligningen. Alle leverandørpriser nedenfor reflekterer artikkelens status per 29. oktober 2026.
Argons Google-introduksjonsperiode slutter 30. november 2026, med påfølgende satser fra 1. desember. Carbon har ingen annonsert slutt-dato for introduksjonsperioden. Tallene for cachet inndata er beregnet ut fra annonsert 95% rabatt; implementering og kvalifikasjonsdetaljer avventes.
Før du estimerer en regning, bekreft satser, caching-regler, langt-kontekst-kostnader og verktøystøtte for din valgte leverandør og konto. Googles annonserte Carbon-satser fastslår ikke en CometAPI Carbon-pris.
Kostnadseksempel: 1,000 forespørsler
For en forespørsel med 100,000 inndata-tokens og 25,000 totale fakturerbare utdata-tokens, inkludert tenking-tokens, gir introduksjons standardpriser:
Totalt: $0.45 per forespørsel, eller $450 for 1,000 identiske forespørsler.
På de påfølgende satsene koster den samme oppgaven $0.90. Hvis 25,000 kun beskriver det endelige synlige svaret, legg til eventuelle separat tellende tenking-tokens før du estimerer regningen. Eksempelet ekskluderer grounding, eksterne verktøy og andre tjenesteavgifter.
Med de viste CometAPI Argon-satsene koster den samme forespørselen med 100,000 inndata og 25,000 fakturerbare utdata $0.16 + $0.20 = $0.36, eller $360 for 1,000 identiske forespørsler. Dette estimatet ekskluderer cache-effekter, nye forsøk og separate tjenesteavgifter; det estimerer ikke en Carbon-distribusjon via CometAPI.
Kostnad per akseptert oppgave = total modell- og verktøysbruk ÷ aksepterte oppgavefullføringer. Definer akseptkriterier før testing, inkludér mislykkede forsøk og nye forsøk i kostnadene, og før separat tid for menneskelig gjennomgang.
Hvor kan du få tilgang til Gemini 4 Carbon og Gemini 4 Argon?
Offisiell leverandørtilgang
Per 29. oktober 2026 er Argon tilgjengelig via Gemini API og Google AI Studio. Carbon er i utgangspunktet begrenset til utvalgte forsvarere innen cybersikkerhet og betrodde partnere; et allment tilgjengelig utviklerendepunkt og bredere lanseringsdato er ikke bekreftet. Start med ruten som er aktivert for kontoen din og sjekk modellidentifikator og støttede funksjoner.
CometAPI-tilgang
Gemini 4 Argon API i CometAPI gir en ekstra integrasjonsrute for utviklere som bruker et kompatibelt chat-grensesnitt.
For å komme i gang, opprett en CometAPI API-nøkkel, velg modellen gemini-4-argon, og konfigurer applikasjonen til å bruke leverandørens dokumenterte chat-endepunkt. Start med en representativ tekstforespørsel, gjennomgå svaret og sjekk bruk og kostnader før du utvider arbeidsmengden.
CometAPI anvender egne priser. Bekreft støtte for verktøy, tenkekontroller og lange svar på ruten du planlegger å bruke. Et kompatibelt chat-grensesnitt fastslår ikke støtte for alle native Gemini-funksjoner.
Carbons CometAPI-tilgjengelighet og produksjonsmodell-identifikator er ikke bekreftet per 29. oktober 2026. Hold Argon operativt og bytt først etter at leverandøren dokumenterer Carbon-tilgang og integrasjonen din består relevante kontroller.
Bør du velge Gemini 4 Carbon eller Argon?
Arbeidslast
Praktisk startpunkt
Hva som bør valideres
En applikasjon som skal leveres nå
Argon
Akseptrate, endepunktatferd og driftskostnad
Komplisert feilsøking eller kodemigreringer
Evaluer Carbon når tilgang er tilgjengelig
Repository-tester, gjennomgangskvalitet og nye forsøk
Autorisert sårbarhetsforskning
Evaluer Carbon innenfor det tillatte tilgangsprogrammet
Sikkerhetskontroller, funnenes gyldighet og patch-korrekthet
Analyse av store dokumenter eller kodebaser
Argon som baseline; Carbon som kandidat
Bevisnøyaktighet og utelatelser på tvers av identiske kildeinput
Et interaktivt brukergrensesnitt
Benchmark det tilgjengelige Argon-endepunktet først
Første-token-forsinkelse og total tid under reell trafikk
Velge et startpunkt og en oppgraderingskandidat
Velg Argon når du må distribuere nå. Dets tilgjengelige API og dokumenterte kontekst, modaliteter og verktøy lar deg teste hele applikasjonen, inkludert latens og kostnad.
Evaluer Carbon når tilgang er tilgjengelig og arbeidet rettferdiggjør det. Prioriter vanskelige repository-endringer, langkontekst-syntese eller autoriserte defensive sikkerhetsoppgaver. Oppgrader når det gir flere aksepterte patcher eller funn, færre nye forsøk eller mindre gjennomgangsarbeid innenfor latens- og budsjettgrensene dine.
En Argon-baseline og Carbon-oppgraderingssti
Hold Argon-arbeidsflyten operativ mens du bygger et fast sett representative oppgaver. Når Carbon blir tilgjengelig via en støttet rute, kjør de samme oppgavene med sammenlignbare verktøytillatelser og akseptkriterier. Ikke bygg automatisk failover til et begrenset eller udokumentert endepunkt; ta rutingbeslutninger først etter at kompatibilitet og arbeidslastresultater er etablert.
Produksjonsevaluering
Hold evalueringssettet fast når du sammenligner modeller. Registrer modellversjon, tenkenivå, prompt, verktøytillatelser, token-bruk, første-token-forsinkelse, total varighet, og om resultatet bestod gjennomgang. En høyere benchmark-score er nyttig evidens for å velge hva som skal testes; beslutningen om produksjonssetting bør følge resultatene på din arbeidslast.
Inkluder rutineforespørsler og vanskelige tilfeller der feil ville vært kostbart.
Repeter oppgaver og alterner modellrekkefølge for å redusere påvirkningen av tilfeldige utslag.
Mål median- og hale-latens, token-bruk, nye forsøk og aksepterte utfall på tvers av hele arbeidsflyten.
Sett grenser for nye forsøk og eskaleringsbetingelser basert på observerbare valideringsresultater.
Konklusjon
Den nyttige oppgraderingen er den som forbedrer ferdigstilt arbeid. Velg et lite sett representative oppgaver, definer hva som teller som et akseptabelt resultat, og mål modell- og gjennomgangskostnad sammen. Når Carbon blir tilgjengelig for kontoen din, vil de samme oppgavene vise om gevinstene i benchmarks oversettes til nok verdi til å rettferdiggjøre et bytte.
FAQ
Kan en Argon-prompt gjenbrukes uendret med Carbon?
Den kan være et utgangspunkt for evaluering, men er ikke evidens for kompatibel API-oppførsel. Hold oppgaven og akseptkriteriene konsistente, og verifiser Carbons dokumenterte modellidentifikator, forespørselsskjema, verktøyformat og grenser når tilgang er tilgjengelig. Gjenbruk av prompt og integrasjonskompatibilitet er separate spørsmål.
Bør tenkeinnstillinger matches når man sammenligner modellene?
Match dem der endepunktene eksponerer sammenlignbare kontroller, og registrer eventuelle forskjeller. Googles høyeste-tenking benchmark-resultater beskriver en bestemt evalueringsoppsetning; de forutsier ikke kvalitet eller latens for en Argon-distribusjon som kjører på standard middels nivå. Argon thinking controls tilbyr lave, middels og høye nivåer, så sammenlign både det laveste nivået som møter applikasjonens akseptterskel og en maks-kvalitetskonfigurasjon.
Kan en benchmark-ledelse fastslå en produksjonstjenestegaranti?
Nei. Benchmark-ytelse fastslår ikke endepunktets oppetidsgaranti, regional tilgjengelighet, databehandlingsvilkår eller støtteordninger. Gjennomgå disse betingelsene med din valgte leverandør separat, og test forventede forespørrelsesstørrelser og trafikkmønstre før du stoler på noen av modellene for en kritisk arbeidsflyt.