
I det raskt skiftende KI-landskapet utmerker GLM-5.2 fra Z.ai (Zhipu AI) seg som en kraftig åpenvektsmodell optimalisert for agent-basert koding, oppgaver med lang tidshorisont og driftspålitelighet i produksjon. Med et brukbart kontekstvindu på 1M token, doble resonneringsmoduser (High og Max) og sterk ytelse til en brøkdel av kostnaden for lukkede frontmodeller, blir den raskt et førstevalg for utviklere som bygger autonome agenter, IDE-integrasjoner og komplekse programvareingeniørings-arbeidsflyter.
Enten du er en solo-utvikler som prototyper agenter, en CTO som vurderer kostnadseffektiv skalering, eller en KI-produktleder som integrerer multimodal-kapabel resonnering i SaaS, vil mestring av GLM-5.2 API-et åpne betydelige fordeler.
Hva er GLM-5.2?
GLM-5.2 er Z.ai’s (Zhipu AI) nyeste flaggskipmodell med åpne vekter basert på Mixture-of-Experts (MoE), lansert i midten av juni 2026. Med omtrent 753 milliarder totale parametere (omtrent 40B aktive per token), et stabilt kontekstvindu på 1 million token, MIT-lisensiering og sterk ytelse på oppgaver med lang tidshorisont innen koding og agentiske oppgaver, posisjonerer den seg som et konkurransedyktig alternativ til lukkede frontmodeller som GPT-5.5, Claude Opus 4.8 og Gemini-varianter—til en brøkdel av kostnaden for mange arbeidslaster.
GLM-5.2-arkitektur og tekniske spesifikasjoner
GLM-5.2 bygger videre på GLM-familien med nøkkeloppgraderinger for arbeid med lang tidshorisont.
- Parametere: ~753B totalt i MoE-design (aktive parametere ~40B per token). Dette gir massiv kapasitet med effektiv inferens.
- Kontekstvindu: 1 048 576 token (1M). Maksimal utdata typisk opptil 128K–131K token.
- Presisjon: BF16 (med FP8-varianter for lettere utrulling).
- Nøkkelinnovasjon – IndexShare: Gjenbruker én indekserer på tvers av grupper av sparse attention-lag, og kutter FLOPs per token med opptil 2,9x ved 1M kontekst. Dette gjør langkontekst-inferens praktisk mulig uten eksploderende kostnader eller latens.
- Resonneringsmoduser: "High" (balansert) og "Max" (dypest, anbefalt for koding). Tenkingen kan deaktiveres for enkle oppgaver.
- Modaliteter: Primært tekst/kode (ingen innebygd visjon bekreftet i grunnutgaven).
- Lisens: MIT – fullt åpen for nedlasting, modifikasjon og kommersiell bruk.
Denne åpenheten og effektiviteten gjør GLM-5.2 ideell for team som prioriterer dataprivacy, tilpasning eller kostnadskontroll.
GLM-5.2 vs GLM-5.1
| Område | GLM-5.1 | GLM-5.2 | Praktisk forskjell |
|---|---|---|---|
| Kontekstvindu | Rundt 200K på vanlige hostede ruter | 1M | GLM-5.2 passer langt bedre for kontekst på hele prosjekter |
| Resonneringsinnsats | Mindre fleksibel | High og Max | Bedre kontroll over kostnad, latens og kvalitet |
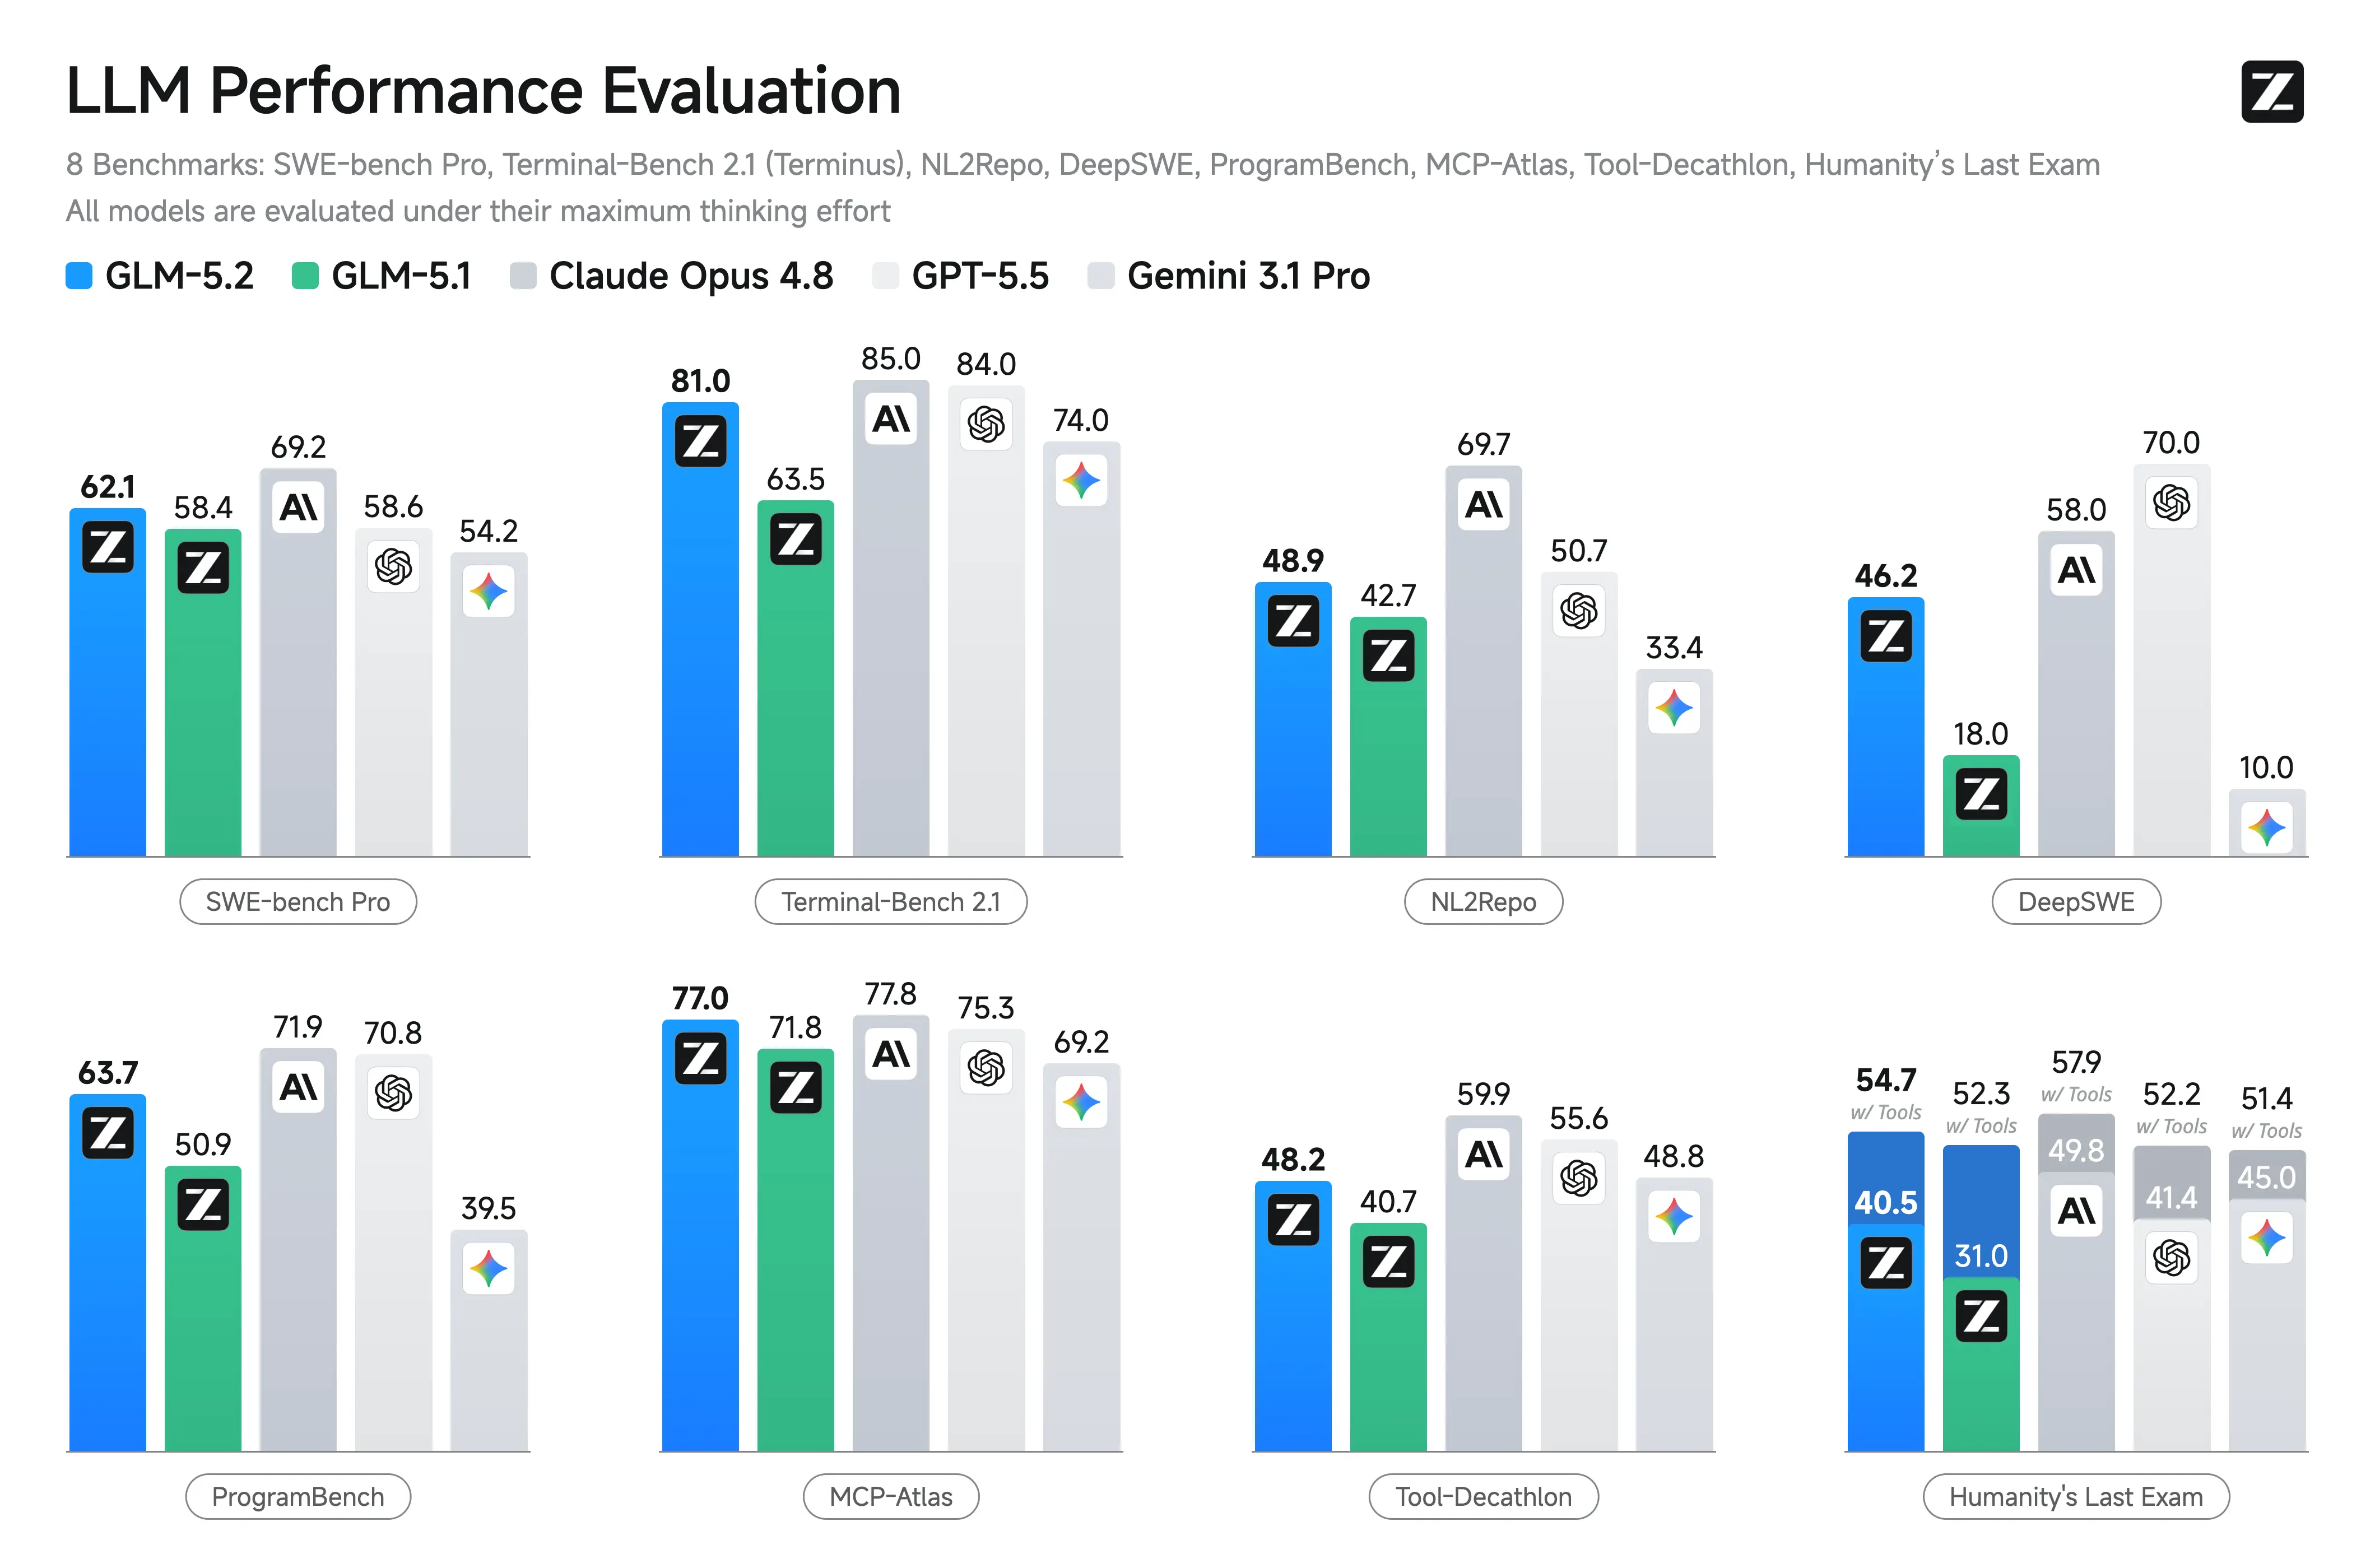
| Terminal Bench 2.1 | 63,5 i den publiserte tabellen | 81,0 | Stor forbedring i terminalbaserte agentoppgaver |
| SWE-bench Pro | 58,4 | 62,1 | Moderat men meningsfull gevinst på repo-nivå koding |
| FrontierSWE | 30,5 | 74,4 | Svært stor forbedring i langhorisont-ingeniøroppgaver |
| Open-weight-holdning | Åpenvekts GLM-familie | Åpenvekts MIT-utgivelse | Tilsvarende åpenhet, sterkere langkontekst-posisjonering |
Hvis din nåværende GLM-5.1-arbeidsflyt mest er korte chatter eller grunnleggende kodegenerering, vil oppgraderingen kanskje ikke endre alt. Hvis arbeidsflyten din omfatter store kodebaser, flertrinns kodeagenter eller langvarig oppgaveutførelse, er GLM-5.2 en langt mer relevant modell.
GLM-5.2 vs Claude Opus, GPT-5.5, Gemini og DeepSeek
Den reneste måten å sammenligne GLM-5.2 på er etter oppgavetype:
| Oppgavetype | GLM-5.2-posisjon |
|---|---|
| Langhorisont-koding | En av de sterkeste åpenvektsalternativene; nær lukkede frontmodeller på utvalgte benchmarks |
| Generell resonnering | Sterk, men ikke alltid foran de beste lukkede modellene |
| Verktøybruk | Sterk MCP-Atlas- og HLE-with-tools-ytelse |
| Matematikkonkurranser | Svært sterk AIME 2026-score i publiserte resultater |
| Visjon | Ikke riktig modell; bruk en visjonsmodell |
| Rimelig masseklassifisering | Vanligvis overdimensjonert; bruk en mindre modell |
| Selvhosting og tilpasning | Sterkere alternativ enn lukkede, kun-API-modeller |
For team er det beste svaret vanligvis ikke "erstatt hver modell med GLM-5.2." Det bedre svaret er "ruter GLM-5.2 til oppgavene der den har en fordel." Det er én grunn til at en samlet API-leverandør som CometAPI kan være praktisk. Den lar deg sammenligne og rute modeller etter arbeidslast uten å bygge om hver integrasjon.
Prising: Rimelig kraft i skala
GLM-5.2 tilbyr overbevisende økonomi, spesielt for token-tunge langkontekst-arbeid.
- API-prising (via Z.ai/OpenRouter/etc.): $1.40 / 1M input-token, $4.40 / 1M output-token. Cache-lesing helt ned til $0.26/1M på enkelte ruter.
- GLM Coding Plan-abonnement (inkluderer full tilgang, ingen ekstra for 5.2):
- Lite: ~$10–12,60/mnd (lett iterasjon).
- Pro: ~$30/mnd.
- Max/Team: Høyere kvoter for tung bruk.
Kostnadsbesparelseseksempel: For en lang agentsesjon med 500K kontekst + utdata kan GLM-5.2 være 4–5x billigere enn Claude-ekvivalenter, samtidig som den håndterer større kontekster nativt.
CometAPI-anbefaling: Få tilgang til GLM-5.2 (og 500+ andre modeller) via CometAPI sin samlede, OpenAI-kompatible endepunkt til konkurransedyktige priser. Én nøkkel, ingen leverandørlåsing, testkreditter ved registrering. Ideelt for å sammenligne GLM-5.2 side om side med Claude/GPT i produksjon. Besøk cometapi for sømløs integrasjon.
1M kontekstvindu: Det fremste fortrinnet
1M-konteksten er "solid" og tapsfri i praksis for arbeid i prosjektstørrelse—langt utover markedsføring. Den muliggjør å ha hele mellomstore til større kodebaser i kontekst, og reduserer oppsummeringsoverhead og feilakkumulering i agenter.
Tips for effektiv bruk:
- Bruk identifikatoren glm-5.2[1m].
- Sett max tokens hensiktsmessig; overvåk i produksjon.
- Kombiner med verktøy/MCP for dynamisk datahenting.
Tidlige tester bekrefter stabilitet forbi 200K, et vanlig sviktpunkt for andre "langkontekst"-modeller.
Grunnytelse og benchmarks
Z.ai og uavhengige rapporter fremhever GLM-5.2s styrker i koding og agentiske scenarier. Den viser betydelige gevinster over GLM-5.1 og konkurransedyktige resultater mot lukkede modeller på oppgaver med lang tidshorisont.
Nøkkel-benchmarks (Z.ai og tredjepartsaggregater):
- Terminal-Bench 2.1: 81,0 (opp fra GLM-5.1s 62,0) – Utmerket for terminal-/agentoperasjoner.
- SWE-bench Pro: 62,1 (snuser på GPT-5.5 med 58,6).
- MCP-Atlas: 77,0 (nær Claude Opus 4.8).
- Humanity’s Last Exam (med verktøy): 54,7.
Andre ledelser: Topper eller nær toppen blant åpne modeller på FrontierSWE, PostTrainBench, SWE-Marathon. Sterk på AIME 2026 (~99,2) og GPQA-Diamond (91,2).
GLM-5.2 API-tilgangsalternativer
Det finnes to vanlige måter å få tilgang til GLM-5.2 fra en applikasjon.
Alternativ 1: Bruk Z.ai direkte
Den direkte veien er å bruke den offisielle Z.ai-API-en. Dette kan være riktig valg når teamet ønsker et direkte forhold til modellleverandøren, kun bruker Z.ai-modeller, eller trenger leverandørspesifikke kontroller så snart de slippes.
Avveiningen er operasjonell. Hvis produktet ditt bruker flere modellsfamilier, kan du måtte vedlikeholde separate SDK-konfigurasjoner, faktureringsflyter, failover-logikk, prisnormalisering og observabilitetskonvensjoner. For et forskningsprosjekt kan det være akseptabelt. For en produksjons-SaaS-plattform kan integrasjonsflaten vokse raskt.
Alternativ 2: Bruk GLM-5.2 via CometAPI
CometAPI gir tilgang til GLM-5.2 gjennom en samlet API-gateway. Den praktiske fordelen er at utviklere kan kalle ulike KI-modeller via ett OpenAI-kompatibelt grensesnitt i stedet for å bygge én integrasjon per leverandør. Du holder koden nær OpenAI SDK-mønsteret, setter modellnavnet til glm-5.2, og ruting går via CometAPI.
Dette er nyttig for oppstartsbedrifter og produktteam som ønsker å:
- Teste GLM-5.2 mot andre modeller uten å bygge om backend
- Holde én API-nøkkel og ett fakturalag for flere modeller
- Gå raskere fra benchmark til prototype til produksjon
- Implementere modellsikkerhet (fallback) eller ruteringsstrategier
- Sammenligne kost og kvalitet på tvers av leverandører
- Bruke velkjente OpenAI-lignende forespørselmønstre
Registrer deg på CometAPI.com for umiddelbare testkreditter og OpenAI-kompatible endepunkter som abstraherer bort leverandørdetaljer.
- Skaff API-nøkkelen din.
- Sett miljøvariabler (beste praksis for sikkerhet):
bash
export GLM_API_KEY="your_key_here"
export BASE_URL="https://api.cometapi.com/v1"  # or direct Z.ai endpoint
Gjør ditt første GLM-5.2 API-kall
cURL-eksempel (rask test):
bash
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $GLM_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [
      {"role": "system", "content": "You are an expert full-stack engineer."},
      {"role": "user", "content": "Write a FastAPI endpoint for user authentication with JWT."}
],
"temperature": 0.7,
"max_tokens": 2048
}'
Vanlige GLM-5.2-bruksområder
GLM-5.2 er en sterk kandidat for arbeidsflyter der lang kontekst, resonnering og verktøybruk kombineres.
| Bruksområde | Eksempelimplementering | Hvorfor GLM-5.2 kan passe |
|---|---|---|
| Utviklerassistent | Analyser feilrapporter, kodesnutter, logger og tester | Krever resonnering på tvers av teknisk kontekst |
| Dokumentintelligens | Gjennomgå kontrakter, retningslinjer, krav eller rapporter | Lange input og strukturert ekstraksjon |
| Forskningsagent | Les kilder, sammenlign påstander, produser sammendrag | Drar nytte av lang kontekst og siteringsdisiplin |
| Kundeservice-copilot | Kombiner sakshistorikk, dokumentasjon, kontodata og policy | Trenger innhenting + verktøykalling |
| KI-produktlederassistent | Syntetiser tilbakemeldinger, spesifikasjoner, bruksdata, roadmap-notater | Lang kontekst og forretningsresonnering |
| Sikkerhetsanalyse | Gjennomgå hendelsesrapporter, varsler og utbedringsplaner | Trenger nøye flertrinnsresonnering |
| Salgsingeniørarbeid | Generer tekniske svar fra dokumentasjon og kundekrav | Nyttig for komplekse B2B-salgssykluser |
Det vanlige mønsteret er ikke "chatbot". Det vanlige mønsteret er arbeidsflyt-komprimering. GLM-5.2 kan redusere tiden mellom rå informasjon og en nyttig beslutning.
Hvem bør bruke GLM-5.2?
GLM-5.2 passer godt for:
- Utviklere som bygger KI-kodeverktøy.
- SaaS-selskaper som legger til depotbevisste assistenter.
- CTO-er som vurderer åpenvektsalternativer til lukkede kodemodeller.
- KI-produktledere som tester langkontekst-arbeidsflyter.
- Foretak med fremtidige behov for selvhosting eller datakontroll.
- Utviklerplattformer som trenger modell-opsjonalitet.
- Team som jobber med store tekniske dokumenter, SDK-er eller kodebaser.
Den er spesielt attraktiv når det er dyrt å feile oppgaven. Hvis en modells feil fører til ødelagte bygg, dårlige migreringer eller bortkastet ingeniørtid, kan kostnaden ved å bruke en sterkere modell raskt forsvares.
Når bør du ikke bruke GLM-5.2
Ikke velg GLM-5.2 som standard for:
- Korte og repetitive klassifiseringsoppgaver.
- Enkelt tekstomskrivning.
- Bilde- eller skjermforståelse.
- Lavelatens autoutfylling der millisekunder teller.
- Arbeidsflyter der en mindre modell allerede fungerer godt.
- Produkter som ikke kan tåle langvarig generering.
Målet er ikke å dyrke det største kontekstvinduet. Målet er å løse oppgaven med riktig profil for kvalitet, kost og latens.
Konklusjon
GLM-5.2 er en av de viktigste åpenvekts-KI-utgivelsene for programvareingeniørteam i 2026. Kombinasjonen av 1M kontekst, sterke kodebenchmarks, High- og Max-resonneringsmoduser, støtte for funksjonskalling og MIT-lisensiering gjør den til et seriøst alternativ for kodeagenter og AI-arbeidsflyter med lang tidshorisont.
For team som vil prøve det raskt, er CometAPI et pragmatisk tilgangslag. Du kan kalle GLM-5.2 gjennom et OpenAI-kompatibelt endepunkt, sammenligne den med andre ledende modeller, overvåke bruk og bygge en ruteringsstrategi uten å bygge om stakken rundt én leverandør. Start med en liten privat evaluering, mål kostnad per løst oppdrag og flytt GLM-5.2 i produksjon kun der dens langkontekst-styrker åpenbart lønner seg.
Klar til å teste GLM-5.2 i din egen app? Utforsk GLM-5.2 på CometAPI, opprett en API-nøkkel og kjør din første OpenAI-kompatible forespørsel på minutter. Bruk den på en reell depotoppgave, ikke en leketekst, og sammenlign resultatet mot din nåværende modellstakk.