Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
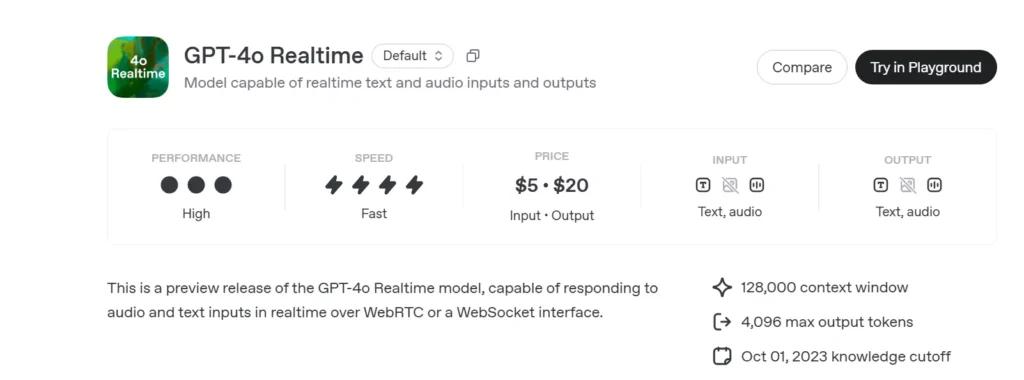
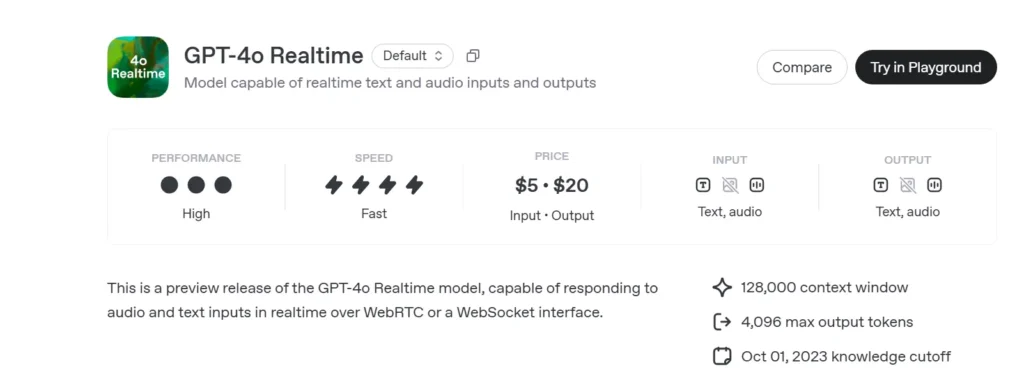
GPT-4o Realtime API: Et multimodalt strømmeendepunkt med lav latens som lar utviklere sende og motta synkronisert tekst, lyd og bildedata over WebRTC eller WebSocket (model=gpt-4o-realtime-preview-, stream=true) for interaktive sanntidsapplikasjoner.
GPT-4o sanntids-API: Et multimodalt strømmeendepunkt med lav latens som lar utviklere sende og motta synkronisert tekst, lyd og bildedata over WebRTC eller WebSocket (modell=gpt-4o-realtime-preview-<date>, stream=true) for interaktive sanntidsapplikasjoner.
Grunnleggende informasjon og funksjoner
OpenAI (modell-ID: ) er den første offentlig tilgjengelige fundamentmodellen som er konstruert for samhandling med Realtime-varianten er avledet fra «omni» GPT-4o-familien, og smelter sammen inn i et enkelt nettverk, slik at utviklere kan bygge stemmeagenter som kommuniserer like flytende som mennesker. Modellen eksponeres gjennom den spesialbygde og er tett integrert med den nye abstraksjon inni (TypeScript og Python).
• Innfødt tale-til-tale: Lydinngang inntas som kontinuerlige strømmer, internt tokenisert, resonnert over og returnert som syntetisert tale. Ingen eksterne STT/TTS-buffere er nødvendig, noe som eliminerer pipeline-forsinkelser på flere sekunder. • Millisekunders forsinkelse: Arkitektonisk beskjæring, modelldestillasjon og en GPU-optimalisert serveringstabel muliggjør ~300–500 ms latens for første token i typiske skydistribusjoner, som nærmer seg menneskelige samtalenormer for turtaking. • Robust instruksjonsfølging: Finjustert på samtaleskript og funksjonskallspor, demonstrerer GPT-4o Realtime en >25 % reduksjon i feil ved oppgaveutførelse sammenlignet med GPT-2024o-grunnlinjen i mai 4. • Deterministisk verktøyanrop: Modellen produserer strukturert JSON i samsvar med OpenAIs funksjonskallende skjema, som tillater deterministisk aktivering av backend-API-er (bookingsystemer, databaser, IoT). Feilbevisste nye forsøk og argumentvalidering er innebygd. • Elegante avbrytelser: En sanntidsdetektor for stemmeaktivitet kombinert med trinnvis dekoding gjør det mulig for agenten å pause talen midt i en setning, innta en brukeravbrudd og gjenoppta eller planlegge responsen sømløst. • Konfigurerbar talehastighet: En ny fart Parameteren (0.25–4× sanntid) lar utviklere skreddersy utdatatempo for tilgjengelighet eller hurtige applikasjoner.
Enhetlig koder-dekoder: GPT-4o Realtime deler omni-arkitekturens enkeltstabeltransformator der lyd-, tekst- og (fremtids)visjonstokener sameksisterer i ett latent rom. Lagvis adaptiv beregning kortlegger lydbilder direkte til senere oppmerksomhetsblokker, og reduserer 20–40 ms per pass.
Hierarkisk lydtokenisering: Rå 16 kHz PCM deles inn i log-mel-patcher → kvantiseres til grovkornede akustiske tokener → komprimeres til semantiske tokener, noe som optimaliserer token per sekund budsjett uten å ofre prosodi.
Lavbit-inferenskjerner: Utplasserte vekter kjører på 4-bit NF4-kvantisering via Triton/TensorRT-LLM-kjerner, noe som dobler gjennomstrømningen versus fp16 samtidig som det opprettholder <1 dB MOS-kvalitetstap.
Strømmingsoppmerksomhet: Roterende innebygginger med glidende vinduer og mellomlagring av nøkkelverdier lar modellen håndtere de siste 15 sekundene av lyd med O(L)-minne, noe som er avgjørende for dialoger med telefonsamtalelengde.
Tekniske detaljer
API-versjon: 2025-06-03-preview
Transportprotokoller:
WebRTCUltralav latens (< 80 ms) for lyd-/videostrømmer på klientsiden
WebSocketServer-til-server-strømming med forsinkelse på under 100 ms
Datakoding:
Opus kodek innenfor RTP pakker for lyd
H.264 / H.265 bildeinnpakninger for video
Streaming: Støtter stream: true å levere inkrementell delvise svar når tokens genereres
Ny stemmepalettIntroduserer åtte nye stemmer—legering, ash, ballade, korall, savner, salvie, shimmerog vers– for mer uttrykks, menneskelig interaksjoner ..
Utviklingen av GPT-4o i sanntid
kan 2024: GPT-4o Omni debuterer med multimodal støtte for tekst, lyd og bilde.
oktober 2024: Realtime API går inn i privat betaversjon (2024-10-01-preview), optimalisert for lyd med lav latens.
desember 2024Utvidet global tilgjengelighet av gpt-4o-realtime-preview-2024-12-17, Og legger hurtigbufring og flere stemmer.
Juni 3, 2025: Siste oppdatering (2025-06-03-preview) ruller ut raffinert stemmepalett og ytelsesoptimaliseringer.
Benchmark ytelse
MMLU: 88.7, og overgår GPT-4s 86.5 på Massiv språkforståelse for flere oppgaver .
Talegjenkjenning: Oppnår bransjeledende ordfeilrater i støyende miljøer, som overgår Hviske grunnlinjer.
Latenstester:
Ende til ende (tale inn → tekst ut): 50–80 ms via WebRTC
Tur-retur lyd (tale inn → tale ut): <100 ms .
tekniske indikatorer
gjennomstrømming: Opprettholder 15 tokens/sek for tekststrømmer; 24 kbps Opus for lyd.
Pris:
tekst5 dollar per 1 million inngangstokener; 20 dollar per 1 million utgangstokener
lyd100 dollar per 1 million inngangstokener; 200 dollar per 1 million utgangstokener.
TilgjengelighetDistribuert globalt i alle regioner som støtter Realtime API.
Slik kaller du GPT-4o Realtime API fra CometAPI
GPT-4o Realtime API-priser i CometAPI:
Input tokens: $2 / M tokens
Output tokens: $8 / M tokens
Nødvendige trinn
Logg på cometapi.com. Hvis du ikke er vår bruker ennå, vennligst registrer deg først
Få tilgangslegitimasjons-API-nøkkelen til grensesnittet. Klikk "Legg til token" ved API-tokenet i det personlige senteret, hent tokennøkkelen: sk-xxxxx og send inn.
Få url til dette nettstedet: https://api.cometapi.com/
Bruksmetoder
Velg "gpt-4o-realtime-preview-2025-06-03"endepunkt for å sende forespørselen og angi forespørselsteksten. Forespørselsmetoden og forespørselsteksten er hentet fra nettstedets API-dokumentasjon. Nettstedet vårt tilbyr også Apifox-testing for enkelhets skyld.
Erstatt med din faktiske CometAPI-nøkkel fra kontoen din.
Sett inn spørsmålet eller forespørselen din i innholdsfeltet – det er dette modellen vil svare på.
. Behandle API-svaret for å få det genererte svaret.
For informasjon om modelltilgang i Comet API, se API-dok.
import openai

openai.api_key = "YOUR_API_KEY"

# Establish a Realtime WebRTC connection

connection = openai.Realtime.connect(
    model="gpt-4o-realtime-preview-2025-06-03",
    version="2025-06-03-preview",
    transport="webrtc"
)

# Stream audio frames and receive incremental text

with open("user_audio.raw", "rb") as audio_stream:
    for chunk in iter(lambda: audio_stream.read(2048), b""):
        result = connection.send_audio(chunk)
        print("Assistant:", result)
Nøkkelparametere:
model: «gpt-4o-forhåndsvisning-i-sanntid-2025»
version: «Forhåndsvisning 2025-06-03»
transport: «webrtc» forum minimal ventetid
stream: true forum inkrementell oppdateringer
Ved å kombinere state-of-the-art multimodal resonnement, en robust ny stemmepalett, og Ultra lavt latensstrømming, GPT-4o sanntid (2025-06-03) gir utviklere muligheten til å bygge virkelig interaktiv, conversational AI-applikasjoner.
OpenAI leverer GPT-4o sanntid med:
• Rekkverk på systemnivå: Retningslinjene er justert for å avvise forespørsler som ikke er tillatt (ekstremisme, ulovlig oppførsel).
• Filtrering av innhold i sanntid: Klassifikatorer under 100 ms screener både brukerinput og modellutput før utslipp.
• Stier for menneskelig godkjenning: Utløses ved verktøyanrop med høy risiko (betalinger, juridisk rådgivning), og utnytter Agents SDKs nye godkjenningsprimitiver.