Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: ytelsestester, funksjoner, priser
Sammenlign GPT-6.1 Terra og DeepSeek V4.1 Flash på benchmark-tester, koding, visuelle evner, kontekst, API-priser og tilgang til CometAPI, for å finne hvilken som er bedre.
TL;DR: GPT-6.1 Terra er det sterkere utgangspunktet når resonneringskvalitet og komplekse visuelle arbeidsflyter betyr mest; DeepSeek V4.1 Flash er attraktivt når token-kostnad, generasjonshastighet eller egenhosting har prioritet. Denne sammenligningen bruker DeepSeeks oppdatering 17. oktober, Flash-1017.
DeepSeek Flash-1017 har lavere token-priser, men kostnaden for en fullført oppgave avhenger også av resonnementslengde, forsøk på nytt og verktøykall.
Sammenligningen nedenfor dekker arkitektur, kontekst, resonnement, koding, visjon, hastighet, prising og distribusjon. Priser og sider med løpende evalueringer ble sjekket 28. oktober 2026.
Viktige punkter
Terra leder den siterte uavhengige Intelligence Index-sammenligningen, noe som gjør den til en logisk første kandidat for krevende resonnement.
DeepSeek har lavere oppgitte token-priser. Sammenlign ende-til-ende-latens og kostnad per vellykket oppgave, inkludert rushtidspriser, cache-bruk, resonnementstokens og forsøk på nytt.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
Evaluer koding etter godkjente patcher og visuelle arbeidsflyter etter fullførte oppgaver. Publiserte benchmarks gir nyttig evidens, men testoppsettene varierer.
Terra er en hostet proprietær modell. DeepSeek tilbyr MIT-lisensierte nedlastbare vekter for egenhosting, med maskinvare- og driftskostnader å ta hensyn til.
CometAPI tilbyr et delt tekstgrensesnitt for testing av begge modellene. Sjekk den faktiske modellversjonen og støtte for verktøy, resonnementskontroller og strukturert utdata før produksjonssetting.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Oversikt og spesifikasjoner
De viktigste spesifikasjonsforskjellene gjelder utdatabegrensninger, resonnementskontroller, verktøykall og distribusjon. Tabellen nedenfor oppsummerer de to modellene.
Proprietær arkitektur; antall parametre ikke oppgitt
552B kausal encoder–decoder MoE; omtrent 8B aktive parametre for inndata og 16B for utdata
Kontekstvindu
1,050,000 tokens
1M tokens
Maksimal utdata
128,000 tokens
384K tokens
Inndatamodaliteter
Tekst, bilder
Tekst, bilder
Utdata-modaliteter
Tekst
Tekst
Resonneringskontroller
none, low, medium, high, xhigh, max
Thinking toggle; low, high, max i Chat Completions
Verktøykall
Støttet via Responses API
Støttet; atferd avhenger av endepunkt og thinking-modus
Åpne vekter
Nei
Ja, MIT-lisens
Arkitektur og modellversjoner
Terra bruker en proprietær arkitektur der antall parametre ikke er offentliggjort. DeepSeek-V4.1-Flash bruker en kausal encoder–decoder MoE-arkitektur, med ulike budsjett for aktive parametre ved innlesing og generering.
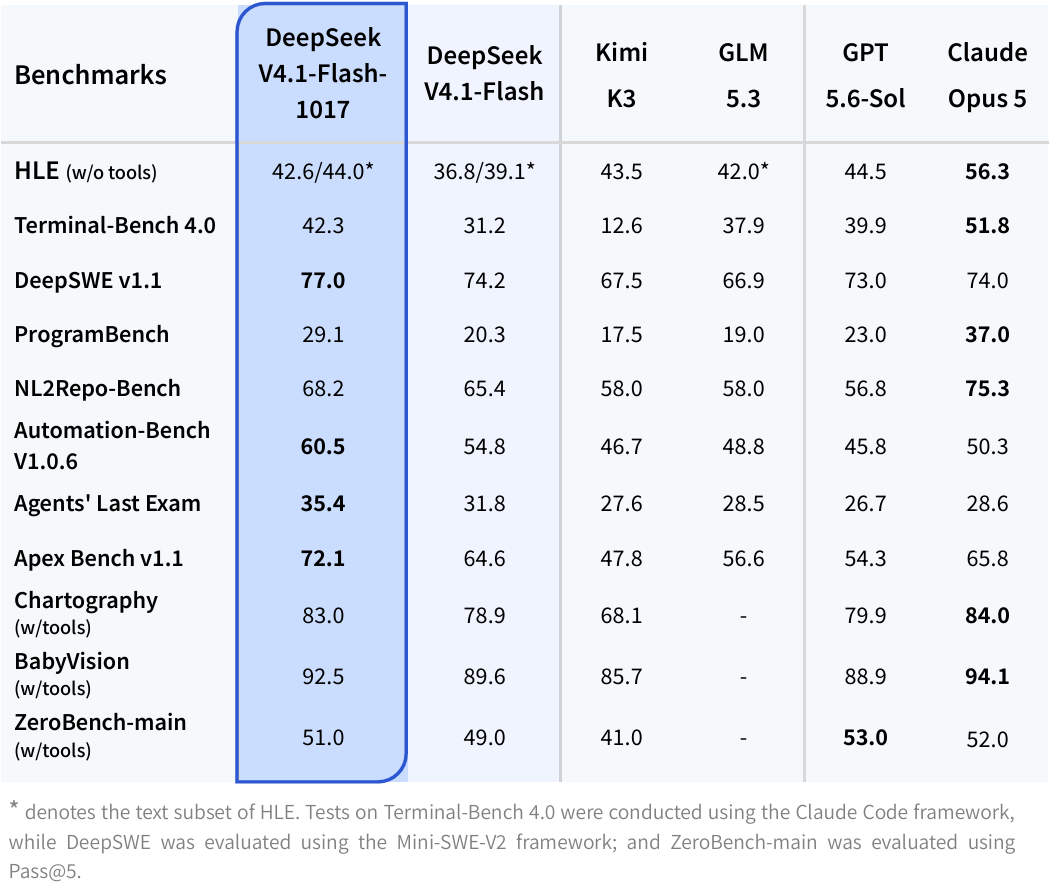
DeepSeeks V4.1 Flash-utgivelse beskriver en Causal Encoder–Decoder-blanding-av-eksperter (MoE) med 552B parametre, med omtrent 8B parametre aktive under inndatabehandling og 16B under utdata-generering. Oppdateringen 17. oktober forbedrer de publiserte resultatene for koding, agenter og visjon.
I denne artikkelen betyr Flash-1017 den oktober-sjekkpunktet. Et generisk API-alias kan senere peke til en annen versjon, så en evalueringslogg bør inkludere modellversjonen som faktisk ble servert.
KV-cache og krav til distribusjon
DeepSeek rapporterer et globalt KV-cache-fotavtrykk på omtrent 890 byte per token, rundt en fjerdedel av DeepSeek-V4-Flash. Dette forbedrer cache-effektiviteten, selv om egenhosting fortsatt krever betydelige ressurser til modellvektene. Terra er tilgjengelig via hostede tjenester, mens DeepSeeks nedlastbare vekter gir et ekstra alternativ for egenhosting.
Resonneringskontroller og verktøykall
Begge modellene støtter agent-arbeidsflyter, men resonnementskontroller og krav til verktøykall varierer. Terras dokumenterte støtte for verktøykall bruker Responses API. DeepSeeks modelldokument beskriver numerisk resonnementinnsats fra 1 til 100; hostede API-kontroller bør sjekkes separat. Ved bytte av modell bør resonnementparametre og verktøydefinisjoner tilpasses valgt endepunkt.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Ytelse
Sammenligningen nedenfor dekker resonnement, koding, visjon og oppgaver med lang kontekst. Uavhengige evalueringer og leverandørrapporterte benchmarks identifiseres separat, med resultater tolket sammen med deres modellkonfigurasjoner og agentrammeverk.
Resonnering og kunnskap
Artificial Analysis rapporterer en Intelligence Index v5.0-score på 51 for GPT-6.1 Terra (Max) og 32 for DeepSeek Flash-1017 (Max) i de siterte konfigurasjonene per 28. oktober 2026. Indeksen kombinerer ni evalueringer.
Terras høyere samlede score støtter å teste den først for krevende resonnement. For smalere arbeidslaster kan DeepSeek fortsatt være det bedre valget hvis den oppnår nødvendig nøyaktighet til lavere kostnad per vellykket oppgave.
Offisielle referansetester for koding og agenter
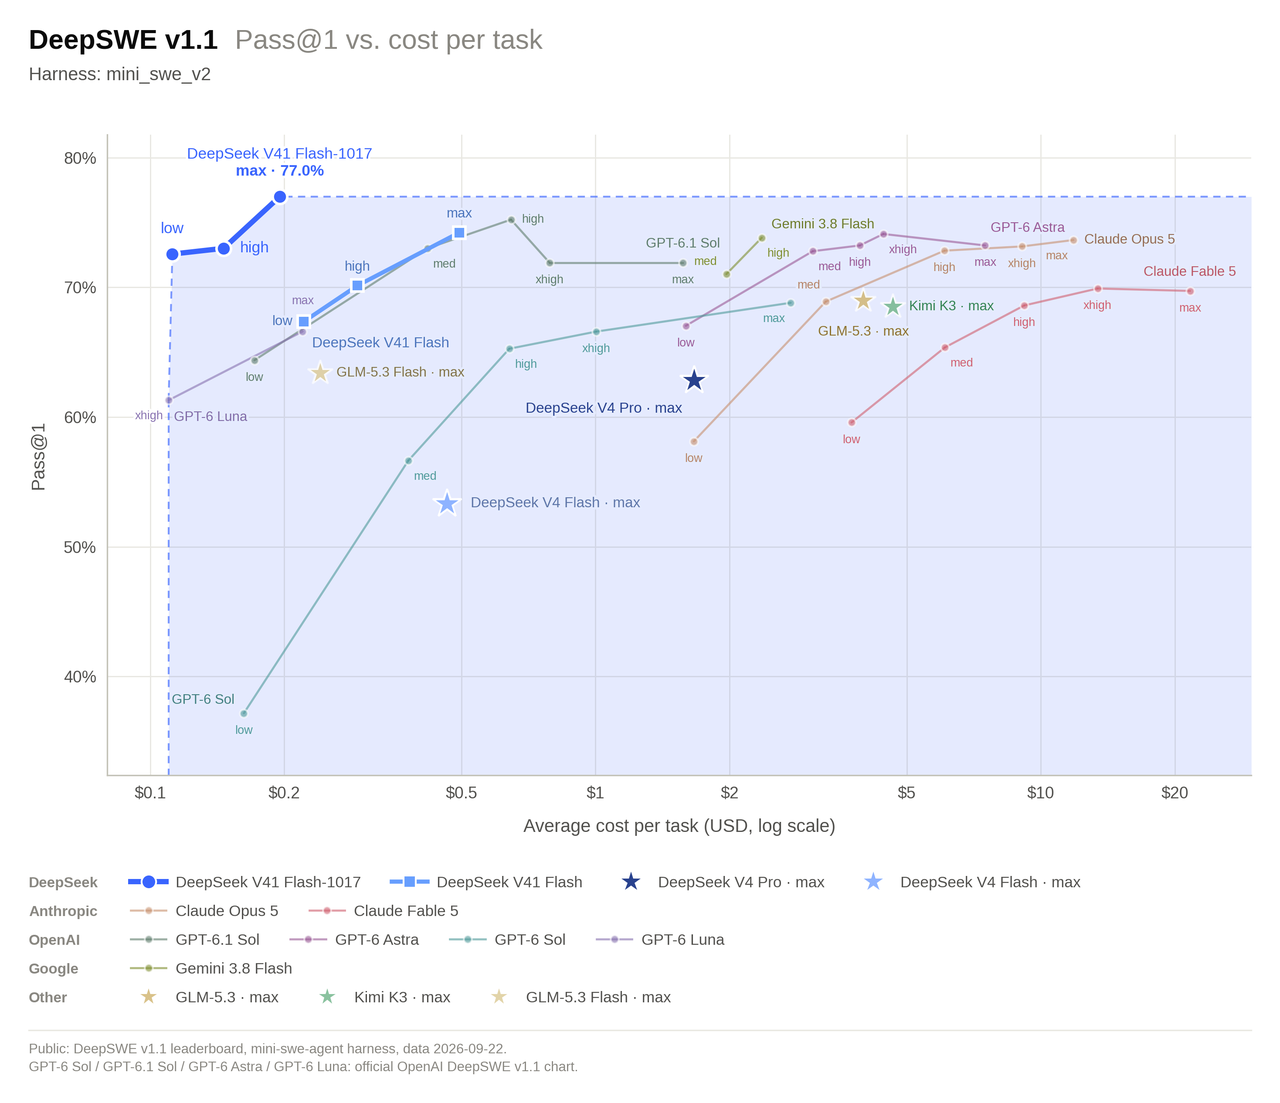
Terminal-Bench 4.0 og DeepSWE v1.1 gir evidens om kode- og agentytelse. Når du sammenligner leverandørresultater, identifiser nøyaktig modellversjon, resonnementsinnstilling, agentrammeverk og scoringsmetode; forskjeller her kan ha vesentlig innvirkning på poeng.
For praktisk kodearbeid bør du sammenligne om hver modell produserer patcher som består eksisterende tester, bevarer offentlige grensesnitt, håndterer kanttilfeller og unngår uvedkommende endringer. Pålitelighet ved verktøykall og gjenoppretting etter kjørefeil påvirker også hvor mye arbeid en agent kan fullføre.
DeepSeeks lavere oppgitte token-priser gjør den nyttig for repetitiv vedlikehold av repositorier med klare akseptkriterier. For komplekse endringer bør du sammenligne begge modellene på godkjente patcher, total oppgavekostnad og menneskelig korrekturtid.
Visjon og datamaskinbruk
Begge modellene aksepterer bildeinndata, men bildeforståelse og skrivebordsinteraksjon krever ulike kapabiliteter. OpenAIs Terra-lanseringsmateriale omtaler MMMU-Pro og OSWorld 2.1, mens DeepSeeks modelldokument rapporterer visuelle oppgaver inkludert Chartography og BabyVision, med verktøyassisterte innstillinger.
For dokumentuttrekk bør du sammenligne feltnøyaktighet, utelatt tekst og tabellstruktur. For skrivebordsautomatisering bør du sammenligne fullførte arbeidsflyter, feilaktige handlinger og gjenoppretting etter grensesnittendringer. En modell som beskriver et skjermbilde nøyaktig kan likevel slite med å operere applikasjonen som vises.
Velg etter arbeidsflyt: uttrekksnøyaktighet betyr mest for dokumentbehandling, mens pålitelige handlinger og gjenoppretting betyr mer for datamaskin-brukende agenter. Sammenlign kostnad først etter at begge modellene møter det nødvendige kvalitetsnivået.
Langkontekst-resonnering og gjenfinning
Begge modellene støtter arbeidsflyter med lange dokumenter, men kontekstkapasitet alene avgjør ikke gjenfinningskvalitet. Sammenlign dem på samme dokumentsett, plasser viktig evidens nær begynnelsen, midten og slutten.
Evaluer svarnøyaktighet, støttende avsnitt, konsistens på tvers av dokumenter og fullstendighet i responsen. For forskning og dokumentanalyse, foretrekk modellen som pålitelig henter og kobler relevant evidens innenfor dine krav til latens og kostnad.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Hastighet
Utdata-gjennomstrømning og oppgavens fullføringstid
Latens fortjener separat behandling fra resonnementskvalitet.
På Artificial Analysis-sidene 28. oktober er Flash-1017 (Max) utdatahastighet 173,4 tokens per sekund, mens Terra (Max) utdatahastighet er 90,9. Disse målingene beskriver evaluatorens servert konfigurasjon, ikke garanterte rater hos alle tilbydere.
En modell som genererer tokens raskere kan likevel bruke lengre tid på å bli ferdig hvis den produserer mer resonnement, venter på verktøy eller prøver på nytt. Mål tid til første token, total fullføringstid og latens for aksepterte oppgaver separat.
Interaktiv latens på din API-rute
For et interaktivt produkt, test korte og lange prompt ved realistisk samtidighet og registrer median- og 95-prosentil-latens. Behold region, API-rute, prompt-caching, resonnementsinnstillinger og policy for forsøk på nytt i resultatene. Den loggen vil fortelle mer om brukeropplevelsen enn én enkelt tokens-per-sekund-figur.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Kostnad
Prising er en av de tydeligste forskjellene mellom disse modellene.
Terras prisark og DeepSeeks prispolicy gir følgende førstegangsrater per 28. oktober 2026. Alle priser er amerikanske dollar per million tokens.
Offisielle API-priser
Tokengruppe
GPT-6.1 Terra Standard
DeepSeek Flash utenom rush
DeepSeek Flash rush
Inndata, cache-miss
$1.00
$0.15
$0.30
Inndata, cache-hit
$0.05
$0.003
$0.006
Utdata
$5.00
$0.60
$1.20
DeepSeeks rush-priser gjelder mandag–fredag, 01:00–04:00 og 06:00–10:00 UTC, unntatt kinesiske helligdager. Det tilsvarer 09:00–12:00 og 14:00–18:00 i kinesisk standardtid (UTC+8). Andre perioder bruker prisene utenom rush.
For Terra-forespørsler over 272,000 inndatatokens spesifiserer OpenAI 2× priser for inndata og hurtigbufrede inndata og 1,5× for utdata for hele forespørselen. Sammenlign disse vilkårene med dine faktiske promptstørrelser før du antar at basisprisen er din effektive pris.
CometAPI-priser
CometAPI basispris per 1M tokens
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Inndata uten cache
$0.80
$0.12
Utdata
$4.00
$0.48
Hurtigbufrede inndata
Ikke spesifisert separat
$0.0024
Tidsbasert multiplikator
Ikke spesifisert i basispris
2× i oppgitte rush-vinduer
CometAPI lister DeepSeeks rush-vinduer som mandag–fredag, 01:00–04:00 og 06:00–10:00 UTC. Den oppførte timeplanen etablerer ikke samme unntak for helligdager som DeepSeeks førstegangspolicy. Sjekk den valgte rutens faktureringsvilkår for din planlagte kjøretid.
Eksempel på fast token-kostnad
Tenk deg en forespørsel som bruker 100,000 ukhurtigbufrede inndatatokens og genererer 10,000 utdata-tokens.
Hvis dette er de fullstendige fakturerte tokentotalene, er token-kostnaden $0.150 for Terra, $0.021 for DeepSeek utenom rush, eller $0.042 for DeepSeek i rush. Reduksjonen utenom rush er 86 %. Eksemplet ekskluderer ekstra verktøygebyrer, infrastruktur og forsøk på nytt; eventuelle separat tellende resonnementstokens må også tas med i beregningen.
Med CometAPIs oppgitte basispriser vil de samme 100,000 inndata- og 10,000 utdata-tokens koste $0.120 for Terra eller $0.0168 for Flash. Anvendes den oppgitte 2× rush-multiplikatoren blir det $0.0336 for Flash. Dette er kun token-beregninger med oppgitte antall, ikke målinger av en faktisk oppgave.
Når ekstra utdata visker ut token-prisfordelen
Hold ukhurtigbufrede inndata på 100,000 tokens og Terras totale fakturerte utdata på 10,000 tokens. Terras standard token-regning er da $0.150. Flash når samme regning ved 225,000 fakturerte utdata-tokens utenom rush, eller 100,000 i rush. Denne aritmetikken isolerer utdatavolum; caching, gjentatte inndata, verktøygebyrer og forsøk på nytt endrer sammenligningen.
Kostnad per vellykket oppgave
Evaluer en fast batch med oppgaver og del alle fakturerte API- og verktøykostnader på antall oppgaver som består dine akseptkontroller. Ta med utgiftene for mislykkede forsøk også. Rapporter suksessraten ved siden av denne kostnaden, slik at en modell ikke belønnes for kun å fullføre de enkleste jobbene.
Kostnad per vellykket oppgave = Total API- og verktøykostnad / Vellykket fullførte oppgaver
Hvilken bør du velge: GPT-6.1 Terra eller DeepSeek-V4.1-Flash?
Velg etter oppgavens kvalitetskrav, kostnadsmål og distribusjonsbehov. Bruk benchmark-resultatene over for å bestemme hvilken modell du skal teste først.
Brukstilfelle
Startkandidat
Hva bør avgjøre valget
Krevende resonnement
GPT-6.1 Terra
Nøyaktighet og korrekturarbeid på representative, vanskelige oppgaver
Koding med agenter
Test begge
Godkjente patcher, regresjonstester, verktøyfeil og totalkostnad
Komplekse visuelle arbeidsflyter
GPT-6.1 Terra
Fullførte arbeidsflyter og gjenoppretting etter grensesnittfeil
Høyvolum tekst- eller bildeuttrekk
DeepSeek Flash-1017
Om uttrekksnøyaktighet møter nødvendig terskel
Henting fra lange dokumenter
Test begge
Evidensgjenfinning og svarnøyaktighet på tvers av inputposisjoner
Egenhosting
DeepSeek Flash-1017
Tilgjengelig maskinvare, driftskostnader og kontroll over vekter
Interaktive applikasjoner
Test begge
Median- og hale-latens på valgt leverandørrute
Når bør du velge GPT-6.1 Terra
Prioriter Terra i evalueringen når komplekst resonnement er sentralt i oppgaven. For krevende visuelle eller datamaskin-bruks-arbeidsflyter bør den inkluderes i testsettet; mål fullførte oppgaver, feil og gjenoppretting.
Kjernespørsmålet er om Terra reduserer mislykkede forsøk og manuelt korrekturarbeid nok til å rettferdiggjøre høyere token-pris.
Når bør du velge DeepSeek-V4.1-Flash
Start med DeepSeek-V4.1-Flash for repetitive, høyvolumsoppgaver med klare akseptkriterier og stramme kostnadsmål. Velg den hvis utdataene møter dine kvalitetskrav til lavere kostnad per vellykket oppgave.
DeepSeeks MIT-lisensierte vekter gjør den også relevant når egenhosting er et krav. Inkluder maskinvare- og driftskostnader i den vurderingen.
Når bør du teste begge modellene
Test begge når kodekvalitet, verktøypålitelighet, latens eller langdokument-nøyaktighet er kritisk. Bruk representative oppgaver med samme inndata, verktøy, kjøretidsgrenser og akseptkriterier.
Sammenlign suksessrate, total kostnad per vellykket oppgave, ende-til-ende-latens og menneskelig korrekturtid. Registrer modellversjon og resonnementsinnstillinger slik at resultatene kan reproduseres.
Et hybridooppsett kan starte rutineoppgaver med DeepSeek og eskalere utvalgte feil til Terra. Mål kostnaden og fullføringsraten for hele arbeidsflyten for å bekrefte at det ekstra modellkallet lønner seg.
Hvor kan du få tilgang til GPT-6.1 Terra og DeepSeek V4.1 Flash?
Bruk OpenAIs hostede API for Terra eller DeepSeeks hostede API for Flash. Bekreft gjeldende modellidentifikator, kontogrenser og støttet endepunkt før integrasjon. Flash-1017s nedlastbare vekter gir et separat alternativ for egenhosting.
Tilgang via CometAPI
CometAPI gir et OpenAI-kompatibelt grensesnitt som kan forenkle flermodell-applikasjonsutvikling.
Bruk GPT-6.1 Terra API og DeepSeek V4.1 Flash API med en delt tekstklient, og legg deretter til modellspecifikke kontroller først etter å ha sjekket rutens støtte.
Sammenlign tekstsvar via CometAPI
For å prøve begge modellene via én tekstklient, bruk OpenAI Python SDK med din CometAPI-nøkkel og endepunktet https://api.cometapi.com/v1. Hold nøkkelen i en miljøvariabel, send deretter samme prompt til rutene gpt-6.1-terra og deepseek-v4.1-flash og sammenlign de returnerte svarene og token-bruken.
Be for eksempel hver modell om å gjennomgå en betalingsarbeidsflyt som prøver på nytt forespørsler som tidsavbrytes uten en idempotency key og logger hele forespørselskropper. Sammenlign hvor tydelig svarene identifiserer pålitelighets- og personvernrisikoer og forklarer praktiske utbedringer. En delt prompt gjør svarene enklere å inspisere, men en standard tekstforespørsel utligner ikke resonnementbudsjetter eller etablerer en ytelsesrangering. Bekreft sjekkpunktet som serveres av hver rute før du behandler et resultat som evidens om Flash-1017.
Konklusjon
GPT-6.1 Terra tilbyr den sterkere samlede resonnementsytelsen, mens DeepSeek Flash-1017 kombinerer lavere token-priser, raskere målt utdatagenerering og distribusjon med åpne vekter. Det nyttige valget er modellen som møter dine kvalitets- og latenskrav til lavest total kostnad.
Start med en representativ arbeidslast, hold verktøy-miljøet og akseptkriteriene konstante, og sammenlign kostnaden for vellykkede fullføringer. En delt CometAPI-tekstintegrasjon kan gjøre den evalueringen enklere, mens modellspecifikke funksjoner fortsatt trenger egen konfigurasjon.
FAQ
Hvorfor kan den samme oppgaven gi ulike token-kostnader med Terra og Flash-1017?
En tekstprompt blir ikke nødvendigvis samme antall tokens i to modeller. Genererte svar og resonnementslengde kan også variere. Sammenlign bruken rapportert av hver rute for identiske oppgaver, inkludert cachede og fakturerbare resonnementstokens der det rapporteres, i stedet for å anvende begge prislister på ett estimert tokenantall.
Kan GPT-6.1 Terra og DeepSeek V4.1 Flash dele en prompt-cache?
Du kan gjenbruke prompt-teksten i applikasjonen din, men ikke anta at en cache opprettet for én modell eller leverandør reduserer den andres regning. Cache-berettigelse og regnskap er rutespesifikke. Sjekk hver respons’ bruksfelter og test gjentatte forespørsler før du legger inn besparelser i et estimat.
Hvordan bør jeg validere strukturert utdata fra Terra og Flash-1017?
Definer nødvendige felt og typer i applikasjonen før du velger modell. Hvis en rute tilbyr JSON eller skjemabegrenset utdata, verifiser nøyaktig modus den støtter, parse deretter responsen og valider den mot skjemaet ditt. Behandle manglende felt, ugyldige verdier, avkuttet utdata og avslag som separate utfall. Gyldig JSON i seg selv etablerer ikke at de utdragne fakta er korrekte.