Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Er Grok 4.7 tilgjengelig? 2.1T-modell, SpaceX-trening og lanseringsvinduet
Grok 4.7 ble lansert 21. september 2026. Utforsk benchmarkene for koding, forbedringer sammenlignet med Grok 4.6, API-priser og hvordan du får tilgang til den lanserte modellen.
Grok 4.7-utgivelsesoppdatering: fra prognoser til offisiell tilgjengelighet
Informasjon kontrollert: 16. oktober 2026.
Grok 4.7 ble offisielt lansert 21. september 2026. Tidligere henvisninger til lansering 12. september var forhåndsanslag og skal ikke regnes som den faktiske lanseringsdatoen.
Den offisielle lanseringskunngjøringen beskriver forbedringer innen koding, kunnskapsarbeid, langvarige oppgaver og verifisering av modellens egne resultater. Den bekrefter tilgjengelighet via Grok API, Cursor og Grok Build. For nøyaktig API-modell-ID, støttede funksjoner, kontekstgrenser og gjeldende prising, se den offisielle dokumentasjonen for Grok 4.7.
Offisielle resultater viser målbar fremgang over Grok 4.6. For eksempel rapporterer lanseringssammenligningen en Terminal-Bench 4.0-poengsum på 37.6% for Grok 4.7 ved xhigh effort, sammenlignet med 20.3% for Grok 4.6 ved high effort. Dette er leverandørrapporterte resultater under angitte evalueringsinnstillinger; applikasjonsytelse vil avhenge av prompter, verktøy, resonneringsinnsats og oppgavens vanskelighetsgrad.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
Er Grok 4.7 tilgjengelig? 2.1T-modell, SpaceX-trening og lanseringsvinduet - CometAPI
For utviklere er det nyttige spørsmålet nå om Grok 4.7 fullfører arbeidslastene deres mer pålitelig og økonomisk. Test den på endringer i kodebaser, dokumentoppretting og flertrinns verktøyarbeidsflyter, og mål vellykket fullføring, ventetid, antall forsøk og total oppgavekostnad.
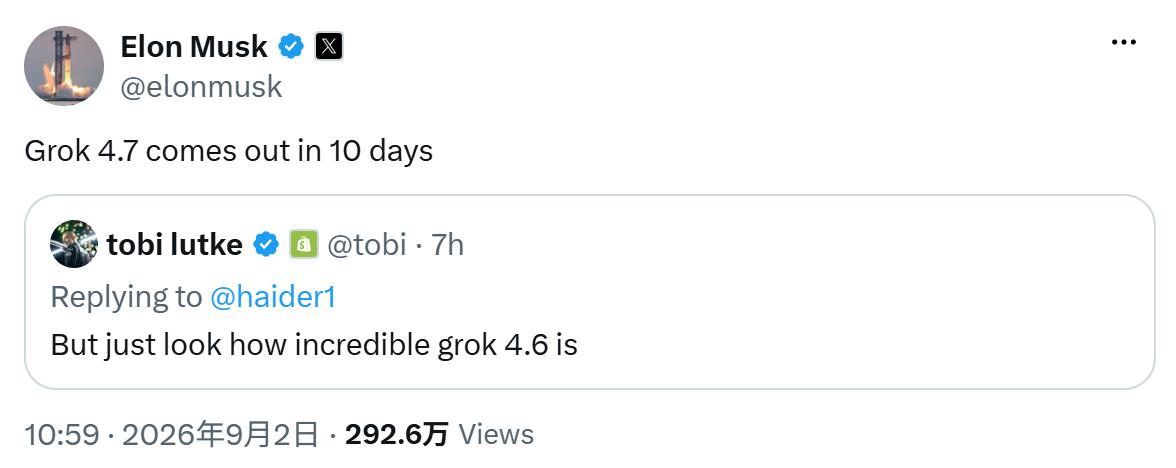
Den forventede datoen 12. september er utledet fra Musks ti-dagers nedtelling, ikke en separat publisert xAI-kalenderkunngjøring.
Påstandene om 2.1T skala og SpaceX-data er forhåndsinformasjon; aktive parametere, ruting, arkitektur og treningsmetodikk er ikke publisert.
Grok 4.6 viser allerede sterke resultater innen kunnskapsarbeid og agent-oppgaver, inkludert 61.3% på FrontierCode v1.1 (Extended), men ligger etter den sterkeste sammenligningsmodellen på flere vanskelige kodeevalueringer.
Grok 4.7 bør vurderes på akseptgrad for oppgaver, langsiktig pålitelighet, token-effektivitet, ventetid og kostnad per vellykket utfall—ikke bare antall parametere.
CometAPI vil integrere Grok 4.7 så snart xAI offisielt slipper modellen og produksjonsendepunktet blir tilgjengelig; utviklere bør likevel validere live modell-ID, pris og responsatferd før migrering.
Hva er Grok 4.7?
Grok 4.7 er annonsert som etterfølgeren til Grok 4.6, og forventes å videreføre xAIs fokus på koding, ingeniørarbeid, langvarige agenter og profesjonelt kunnskapsarbeid. Offentlige bevis består foreløpig av grunnleggeruttalelser og en lanseringsnedtelling snarere enn en komplett teknisk lanseringspakke.
Den viktigste distinksjonen er mellom tre objekter: den annonserte Grok 4.7-modellen, forhåndssignalene som beskriver mulig skala og trening, og den live Grok 4.6-produksjonsbaselinen. Utviklere bør behandle Grok 4.7 som en kommende evalueringskandidat inntil xAI publiserer endelig dokumentasjon og en produksjonsforespørsel lykkes mot det utgitte endepunktet.
Grok 4.7 utgivelsesdato og tidslinje
Når forventes Grok 4.7 å bli lansert?
Musks uttalelse 2. september om at modellen ville komme om ti dager peker på omtrent 12. september 2026
Musk beskrev en modell på omtrent 2.1T, forbedret token-effektivitet og noe tregere serving.
Grunnlegger-oppgitte forventninger om modellskala og effektivitet.
12. august 2026
Innledende trening ble beskrevet som fullført; supplerende trening skal ha inkludert betydelige SpaceX-selskapsdata.
En oppdatering om treningsfremdrift, ikke en lanseringsbekreftelse.
2. september 2026
“Grok 4.7 kommer om 10 dager.”
Den tydeligste offentlige lanseringsnedtellingen så langt.
12. september 2026
Kalenderdato avledet fra nedtellingen.
Forventet mål; endelig tilgjengelighet krever fortsatt en xAI-lanseringsmelding og et fungerende endepunkt.
Grok 4.7-spesifikasjoner: bekreftet vs. ubekreftet informasjon
Den mest nyttige måten å lese nåværende Grok 4.7-informasjon på er å skille direkte grunnleggeruttalelser fra spesifikasjoner som xAI ikke har publisert. Den nye posten bekrefter kun modellnavnet og en lanseringsnedtelling; den tilfører ikke tekniske parametere eller benchmarkresultater.
Spesifikasjon
Nåværende status for Grok 4.7
Bevisnivå
Lanseringstidspunkt
Rundt 12. september, utledet fra ti-dagers nedtellingen 2. september
Grunnlegger-annonsert mål
Modellskala
Omtrent 2.1T parametere
Oppgitt av grunnlegger
Innledende trening
Beskrevet som fullført innen 12. august
Oppgitt av grunnlegger
Supplerende trening
Inkluderer betydelige SpaceX-selskapsdata
Oppgitt av grunnlegger
Relativ kvalitet
Påstås å være vesentlig bedre enn Grok 4.6
Uverifisert påstand
Token-effektivitet
Påstått forbedring over Grok 4.6
Uverifisert påstand
Servingshastighet
Forventes å være noe tregere
Oppgitt av grunnlegger
Kontekstvindu
Ikke publisert av xAI
Ukjent
Inn-/utgangsmodaliteter
Ikke publisert av xAI
Ukjent
Endelig API-modell-ID
Ikke bekreftet i xAI-dokumentasjonen
Ukjent
Offisiell prising
Ikke publisert av xAI
Ukjent
Offisielle benchmarks
Ingen publisert for Grok 4.7
Den omtrent 2.1T-parameterpåstanden oppgir ikke aktive parametere, sparsitet, ekspertruting, inferenskostnad eller effektiv treningscompute. Antall parametere alene kan ikke fastslå produksjonskvalitet.
Hvorfor SpaceX-treningssignalet kan bety mer enn 2.1T
Den mer betydningsfulle opplysningen kan være SpaceX-selskapsdatasuplementet. Et høykvalitets ingeniørkorpus kan forbedre teknisk resonnering, design, feilsøking, optimalisering og langhorisont agentarbeid, der oppgavedistribusjon og kvalitet etter trening ofte betyr mer enn rå skala.
Denne retningen er konsistent med xAIs strategi for utgitte modeller. Grok 4.6-treningsrapporten beskriver en lengre supplerende treningskjøring med høykvalitets ingeniørdata, etterfulgt av veiledet finjustering og forsterkningslæring på tvers av koding, STEM, webutvikling, kjerneoptimalisering og dataassistert design.
Det gjør Grok 4.7-påstanden teknisk plausibel, ikke bevist. En reell fordel bør bli synlig etter lansering i reproduserbare ingeniørtester, oppgavefullføringsrater, ventetid og kostnad per vellykket utfall.
Grok 4.7 vs Grok 4.6 ytelse: hva basislinjen viser
Ingen offisielle Grok 4.7-poeng finnes ennå. Det ansvarlige sammenligningspunktet er xAIs utgitte Grok 4.6 evaluering. Den fulle modelloversikten finnes i CometAPIs Grok 4.6-dypdykk; tabellen nedenfor beholder kun de mest beslutningsrelevante benchmark-radene.
Offisiell evaluering
Grok 4.6 High
Grok 4.5 High
GPT-5.6 Sol Max
Claude Fable 5 Max
AA Intelligence Index
61
56
61
62
GDPVal-AA v2
1753
1526
1728
1741
CursorBench v3.2
69.9%
66.7%
67.2%
70.5%
DeepSWE v1.1
65.9%
54.0%
73.0%
70.0%
FrontierCode v1.1 (Extended)
61.3%
56.6%
60.6%
63.6%
Terminal-Bench v3.0
26.0%
15.7%
34.6%
34.1%
Basisresultat: Grok 4.6 viser en reell fordel over Grok 4.5 på hver rad som vises. Den matcher GPT-5.6 Sol på den overordnede intelligensindeksen, leder denne gruppen på GDPVal-AA v2, og ligger så vidt foran GPT-5.6 Sol på FrontierCode. De viktigste publiserte gapene er fortsatt DeepSWE og Terminal-Bench.
Disse resultatene setter en konkret standard for Grok 4.7. Hvis den større modellen og den ingeniørorienterte supplerende treningen slår ut i produksjon, vil det forventede gjennombruddet være sterkere koding på repositorienivå og terminaloppgave-fullføring uten å miste Grok 4.6s styrke i kunnskapsarbeid. Et troverdig ambisjonsnivå er å bli konkurransedyktig med den utgitte Claude Fable 5.1 på koding og langvarige agentarbeidsflyter. Det er en prognose som må testes, ikke en nåværende benchmarkpåstand.
Grok 4.7 vs Grok 4.6: forventede gjennombrudd og oppgraderingsveiledning
De lekkede og grunnlegger-oppgitte signalene antyder fem områder der Grok 4.7 kan forbedres. Siden xAI ikke har publisert endelige evalueringsdata, bør hver forventning oversettes til en målbar aksepttest.
Koding på repositorienivå
Grok 4.6 er allerede sterk på CursorBench og FrontierCode, men resultatene på DeepSWE og Terminal-Bench gir tydelig rom for forbedring. Grok 4.7 bør demonstrere høyere patch-aksept, færre regresjoner og bedre kommandolinjegjenoppretting på de samme repoene før den erstatter 4.6.
Langhorisont agentpålitelighet
SpaceX-datasignalet og xAIs eksisterende agenttreningsretning tyder på fokus på flertrinns ingeniørarbeid. Mål fullførte arbeidsflyter, mislykkede verktøykall, antall forsøk, menneskelige inngrep og gjenoppretting etter feil—ikke bare kvaliteten på den endelige teksten.
Kunnskapsarbeid og teknisk resonnering
Grok 4.6 leder allerede sammenligningssettet på GDPVal-AA v2. Grok 4.7 bør bevare den fordelen samtidig som den forbedrer overføring til designgjennomganger, forskningssyntese, feilsøking, optimalisering og andre komplekse tekniske oppgaver.
Token-effektivitet
En større modell kan likevel være billigere per vellykket oppgave hvis den når riktig resultat i færre steg. Sammenlign totale inndata, bufrede inndata, utdata-tokens, antall forsøk og kostnad for samme aksepterte resultat.
Serving-avveininger
Hvis Grok 4.7 er tregere, må kvalitetsgevinster veie opp for ventetiden. Registrer tid til første token, vedvarende gjennomstrømning, veggklokketid for fullført oppgave, feilrate og kostnad under realistisk samtidighet.
Grok 4.7-benchmarks: 5 tester for å verifisere en reell oppgradering over Grok 4.6
Programvareingeniør-suksess: Mål løste issues, beståtte tester, regresjonsrate og patch-aksept på representative repositorier.
Langhorisont agentpålitelighet: Spor fullførte arbeidsflyter, verktøykall-feil, antall forsøk, gjenoppretting og menneskelige inngrep i flertrinnskjøringer.
Reell ingeniøroversetting: Test design, feilsøking, optimalisering, vitenskapelig resonnering og CAD-relaterte oppgaver med offentliggjorte vurderingskriterier.
Token-effektivitet per vellykket oppgave: Sammenlign totale tokens og forbruk som kreves for å nå samme aksepterte utfall.
Ventetid og kostnad under produksjonslast: Evaluer tid til første token, gjennomstrømning, veggklokketid, feilrate og kostnad ved realistisk samtidighet.
Hva utviklere bør gjøre før 12. september—og hvordan CometAPI passer inn
Sjekkliste for utviklere før lansering
Bygg et fast evalueringssett fra reelle koding-, forsknings-, ingeniør- og agentarbeidsflyter.
Kjør det mot Grok 4.6 og registrer suksessrate, antall forsøk, verktøykall, ventetid, tokens og total kostnad.
Hold modellvalg konfigurerbart og unngå å hardkode en foreløpig Grok 4.7-identifikator.
Følg med på xAI-utgivelsesnotater og CometAPI-modellsiden for bekreftet tilgjengelighet.
Etter lansering, verifiser kontekst, modaliteter, resonneringskontroller, prising, ratebegrensninger og utrullingsomfang.
Reproduser det samme evalueringssettet før du flytter produksjonstrafikk.
CometAPI tilbyr et samlet API-lag for tilgang til flere AI-modellleverandører via én konto og integrasjonsmåte. En Grok 4.7-sporingsside er allerede tilgjengelig. CometAPI vil integrere Grok 4.7 så snart xAI offisielt slipper den og produksjonstilgang blir tilgjengelig.
Fram til det, behandle enhver forhåndsidentifikator, pris eller kapabilitetsfelt som foreløpig. Før du sender produksjonstrafikk, bekreft at ruten er live, at en ekte forespørsel lykkes, at den returnerte modellen er den tiltenkte versjonen, og at gjeldende prising er synlig i konsollen.
Utsikter for Grok 4.7-prising vs Grok 4.6
Den publiserte standardprisen for Grok 4.6 er $2 per 1 million input-tokens og $6 per 1 million output-tokens under terskelen for lang kontekst. xAIs utgivelsesnotater lister høyere priser for forespørsler over 200,000 prompt-tokens. Grok 4.7-prising er ikke offisielt annonsert.
Publisert prisgrunnlag
Input / 1M
Output / 1M
Status
Grok 4.6, prompt under 200K
$2
$6
Publisert
Grok 4.6, prompt over 200K
$4
$12
Publisert lang-kontekst-nivå
Grok 4.7
Ikke annonsert
Ikke annonsert
Bekreft etter offisiell lansering
Tre prisretninger er fortsatt plausible: paritet med Grok 4.6 for å akselerere adopsjon, et premium-nivå hvis serving-kostnaden er vesentlig høyere, eller separate satser etter konteksts-lengde og hastighet. Dette er planleggingsscenarioer, ikke en xAI-prognose.
Sjekkliste for utviklere før lansering
Bygg et fast evalueringssett fra reelle koding-, forsknings-, ingeniør- og agentarbeidsflyter.
Kjør det mot Grok 4.6 og registrer suksessrate, antall forsøk, verktøykall, ventetid, tokens og total kostnad.
Hold modellvalg konfigurerbart og unngå å hardkode en foreløpig Grok 4.7-identifikator.
Følg med på xAI-utgivelsesnotater og CometAPI-modellsiden for bekreftet tilgjengelighet.
Etter lansering, verifiser kontekst, modaliteter, resonneringskontroller, prising, ratebegrensninger og utrullingsomfang.
Reproduser det samme evalueringssettet før du flytter produksjonstrafikk.
Grok 4.7: hva du bør følge med på videre
Fire hendelser vil gjøre den nåværende nedtellingen om til en verifiserbar produktlansering: en offisiell xAI-lanseringspost; modelldokumentasjon som dekker kontekst, modaliteter og resonneringskontroller; endelig API-prising og modellidentifikatorer; og reproduserbare benchmarks eller produksjonsevalueringer.
Det mest nyttige lanseringsspørsmålet er ikke om 2.1T høres stort ut. Det er om Grok 4.7 fullfører vanskelige ingeniør- og agentoppgaver mer pålitelig—og til en bedre kostnad per vellykket utfall—enn den utgitte baselinen.
FAQ
Når forventes Grok 4.7 å bli lansert?
Musks ti-dagers nedtelling 2. september peker på omtrent 12. september 2026. Dette er et utledet mål, ikke en separat publisert kalenderdato fra xAI.
Har Grok 4.7 allerede blitt lansert?
Grok 4.7 er offentlig ertet/annonsert, men har ennå ikke fått en komplett offisiell API-/modelldokumentasjonsutgivelse.
Er Grok 4.7 en modell med 2.1 billioner parametere?
Musk har beskrevet den som omtrent 2.1T parametere. xAI har ennå ikke publisert et arkitekturdokument som bekrefter aktive parametere eller rutingsdetaljer.
Vil Grok 4.7 være bedre enn Grok 4.6?
Musk har hevdet en betydelig forbedring, men ingen offisiell Grok 4.7-benchmarktabell finnes. Behandle påstanden som uverifisert inntil reproduserbare resultater er tilgjengelige.
Vil Grok 4.7 være tilgjengelig gjennom CometAPI?
En CometAPI-sporingsside finnes allerede, men endelig tilgjengelighet, identifikator, prising og støttede formater bør bekreftes etter den offisielle lanseringen.
Konklusjon
Historien om Grok 4.7 har beveget seg fra et bredt anslag tidlig i september til en konkret nedtelling. Musks siste uttalelse peker på omtrent 12. september 2026, mens tidligere innlegg beskriver en modell på omtrent 2.1T og supplerende trening med betydelige SpaceX-selskapsdata.
Dette er uvanlig spesifikke forhåndssignaler, men de er ikke et modellkort, et benchmarksuite eller en API-kontrakt. Utviklere bør beholde Grok 4.6 som målbar baseline, forberede en kontrollert evaluering nå, og vente på at xAI og CometAPI bekrefter produksjonstilgang før de tar migrerings- eller budsjetteringsbeslutninger.