Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Kort svar: Et 511 GB-checkpoint er ekstremt stort. For FP16/BF16 krever dette typisk 8×80 GB GPUer (eller flere) med tensor-parallellisering. Med 4-bit kvantisering kan du komme ned til ~120–140 GB (modellvekt), som fortsatt krever minst 2×80 GB GPUer når du tar høyde for KV-cache. Enkeltmaskin med forbruker-GPU er i praksis ikke realistisk uten kraftig kvantisering og betydelige begrensninger.
Nedenfor finner du praktiske steg for vLLM, SGLang, Ollama og API-alternativer.
- Maskinvare- og systemkrav
- GPU:
- FP16/BF16: mål 8×80 GB (A100/H100/H800/A800) eller bedre. 6×80 GB er som regel ikke nok for 511 GB vektfil + overhead.
- 4-bit kvantisering: minst 2×80 GB (avhenger av sekvenslengde og batch).
- Driver/CUDA:
- NVIDIA-driver som matcher CUDA 12.x.
- cuDNN installert via pip-hjulene til valgt rammeverk eller systembibliotek.
- Disk/IO:
- NVMe SSD (PCIe 4.0/5.0) anbefales. 511 GB checkpoint + cache krever >1 TB ledig lagringsplass.
- Nettverk:
- For multi-GPU/multi-node: høykapasitets interconnect (NVLink/IB). Sett opp NCCL korrekt.
- Last ned modellen
- Sørg for nok plass i Hugging Face-cache (HF_HOME eller huggingface_hub cache).
- Eksempel:
- HF_HOME=/data/hf-cache
- huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash --local-dir /models/deepseek-v4.1-flash --exclude "*.pt.tar"
- Merk: Bytt ut modellnavn med den faktiske repo-stien dersom den avviker.
- vLLM: installasjon og kjøring
- Installér:
- pip install "vllm[all]>=0.5.4"
- For spesifikk CUDA: pip install vllm-cu121 eller vllm-cu122 (tilpass din CUDA).
- Miljø for multi-GPU:
- Eks: export VLLM_WORKER_USE_NCCL_COMM=1
- For IB/NVLink: sørg for at NCCL kan finne interconnect (NCCL_IB_DISABLE=0 etc. etter behov).
- Kjøring (FP16/BF16, 8×80 GB):
- python -m vllm.entrypoints.openai.api_server --model /models/deepseek-v4.1-flash --dtype bfloat16 --tensor-parallel-size 8 --max-model-len 8192 --gpu-memory-utilization 0.90 --trust-remote-code
- Kvantisert kjøring (4-bit/8-bit):
- 4-bit (AWQ): legg til --quantization awq og bruk en AWQ-kvantisert variant av modellen.
- 4-bit (GPTQ): --quantization gptq med GPTQ-vektfilene.
- 8-bit (bitsandbytes): --quantization bitsandbytes --load-format torch.
- Eksempel (2×80 GB, AWQ):
- python -m vllm.entrypoints.openai.api_server --model /models/deepseek-v4.1-flash-awq --quantization awq --tensor-parallel-size 2 --max-model-len 8192 --gpu-memory-utilization 0.95 --trust-remote-code
- Tips for minne:
- --max-model-len påvirker KV-cache kraftig. Reduser for å passe VRAM.
- --enforce-eager kan hjelpe ved enkelte drivere, men koster ytelse.
- --swap-space 16 kan hjelpe ved KV-cache-trykk (host-minne), men har ytelseskost.
- Klient (OpenAI-kompatibel):
- curl http://localhost:8000/v1/chat/completions -H "Content-Type: application/json" -d '{"model":"deepseek","messages":[{"role":"user","content":"Hei!"}]}'
- vLLM: multi-node (avansert)
- vLLM har distribuert kjøring via Ray.
- Start Ray på hver node, og bruk --distributed-executor-backend ray samt --tensor-parallel-size som matcher antall GPUer totalt.
- Nettverks- og NCCL-oppsett er kritisk; test med en mindre modell før 511 GB.
- SGLang: installasjon og kjøring
- Installér:
- pip install "sglang>=0.2.6"
- Enkeltoppsett (FP16/BF16):
- sglang serve --model /models/deepseek-v4.1-flash --dtype bf16 --tp 8 --max-seq-len 8192 --trust-remote-code
- Kvantisering:
- Bruk kvantiserte vektfiler (AWQ/GPTQ) og legg til tilsvarende flagg hvis støttet i din SGLang-versjon.
- Klient (OpenAI-kompatibel modus dersom aktivert):
- curl http://localhost:30000/v1/chat/completions -H "Content-Type: application/json" -d '{"model":"deepseek","messages":[{"role":"user","content":"Hei!"}]}'
- SGLang kan gi bedre latens via CUDA Graphs, men kravene til VRAM er tilsvarende vLLM.
- Ollama: status og anbefaling
- Ollama er primært rettet mot kvantiserte GGUF-modeller og forbruker-GPUer.
- Et 511 GB FP16-checkpoint er ikke praktisk i Ollama. Selv tungt kvantisert vil modellen som regel ikke konverteres og kjøres effektivt.
- Hvis det finnes en offisiell GGUF/quant-publisering fra leverandør, kan du lage en Modelfile:
- FROM <gguf-URL-eller-lokal-fil>
- PARAMETER temperature 0.7
- SYSTEM Du er en hjelpsom assistent.
- Bygg og kjør:
- ollama create deepseek-v41-flash -f Modelfile
- ollama run deepseek-v41-flash
- For denne størrelsesklassen anbefales vLLM/SGLang over Ollama.
- API-alternativer (sky)
- DeepSeek sin offisielle API (OpenAI-kompatibel) eller tredjepart som Together AI, Fireworks, Anyscale m.fl. kan være mer praktisk for så store modeller.
- Eksempel (OpenAI-klientstil):
- export OPENAI_API_KEY=<din_nøkkel>
- curl https://api.deepseek.com/v1/chat/completions -H "Authorization: Bearer $OPENAI_API_KEY" -H "Content-Type: application/json" -d '{"model":"DeepSeek-V4.1-Flash","messages":[{"role":"user","content":"Hei!"}]}'
- Fordeler: ingen lokal VRAM-begrensning; Ulemper: kostnad og datalagringshensyn.
- Ytelses- og stabilitetstips
- Bruk NVMe og sørg for at modellkatalogen ligger på rask disk.
- Pinnen host-minne for raskere overføringer: sett riktig ulimit og bruk standard praksis for datalasting.
- Juster batch size, max-model-len og logit-parallel parametere for å holde VRAM under kontroll.
- Start med en kvantisert variant for å validere oppsett før du forsøker full presisjon.
- Oppsummering av realistiske scenarier
- Full presisjon (511 GB): mål 8×80 GB GPUer, vLLM/SGLang med --tensor-parallel-size 8.
- 4-bit kvantisering: 2×80 GB kan være nok for moderate sekvenslengder; bruk AWQ/GPTQ og passende flagg.
- For utvikling/test: bruk en mindre distillert/quant-modell lokalt; bruk sky-API for produksjon hvis modellen må være “V4.1-Flash”.
Merk: Bytt modellnavn/stier til nøyaktig det repoet/artefaktet du faktisk har. Funksjonsflagg for kvantisering varierer litt mellom vLLM/SGLang-versjoner; sjekk versjonsnotater hvis et flagg ikke gjenkjennes.
DeepSeek-V4.1-Flash har åpne vekter og kan egenhostes, men “lokalt” betyr ikke “på en gaming-PC.” DeepSeek beskriver den som en 552B-parameter Mixture-of-Experts-backbone med en kausal encoder–decoder-arkitektur, der kun 8B parametere er aktive under promptbehandling og 16B under generering. Den fullstendige modellen er fortsatt et mål på frontier-skala for utrulling.
Den nåværende vLLM-oppskriften plasserer sjekkpunktet på omtrent 511 GB på disk og rundt 614 GB minimum VRAM, noe som gjør en server i 8×H200-klassen eller et tilsvarende system med svært mye minne langt mer realistisk enn en konsumentarbeidsstasjon.
For team som bare trenger tilgang og ikke kontroll på vektnivå, er DeepSeek V4.1 Flash-API-et i CometAPI betydelig enklere enn å drifte en fler-GPU inferanseserver.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
Bruk denne oppsummeringen for et raskt svar, og les deretter guiden for kontekst, eksempler og implementeringsdetaljer.
Viktige punkter
DeepSeek-V4.1-Flash bruker en 552B MoE-backbone med 8B aktive parametere under prefill og 16B under dekoding; aktive parametere representerer ikke kravet til resident-minne.
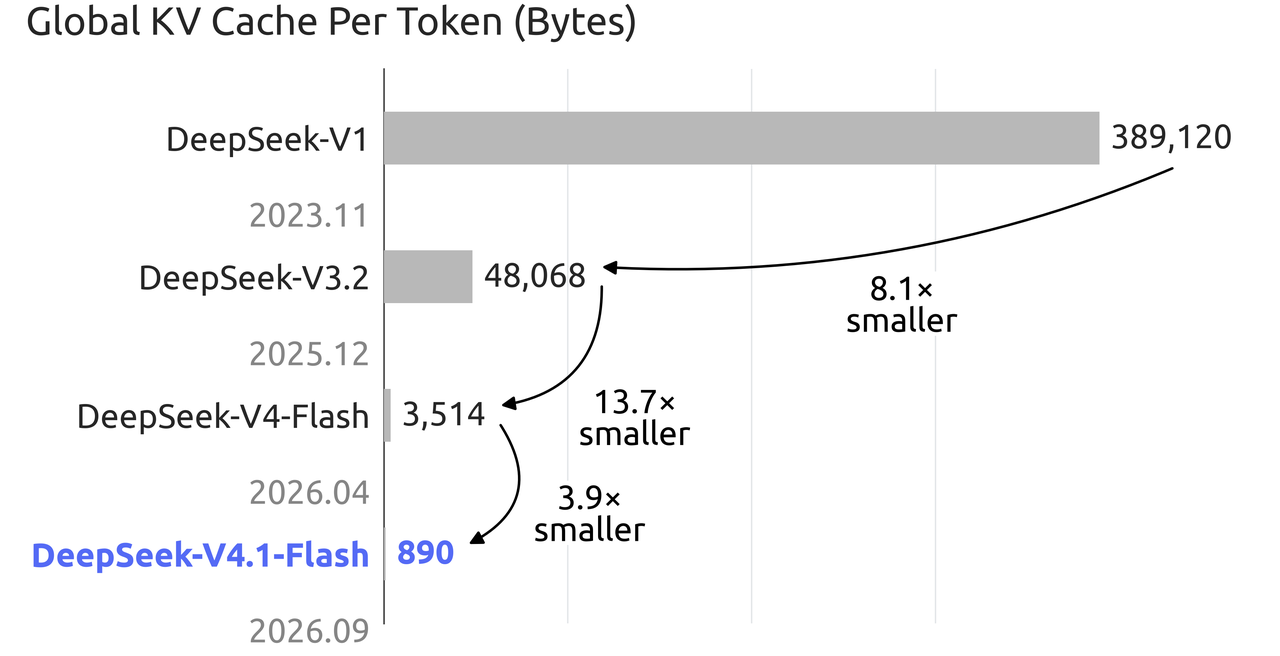
Kontekstvinduet på 1 048 576 tokens og en global KV-cache på 890 byte per token reduserer cache-press, men modellvektene dominerer fortsatt kapasitetsplanleggingen.
Det offisielle sjekkpunktet er omtrent 511 GB på disk. vLLM-oppskriften anslår rundt 614 GB aggregert brukbart VRAM som minimumsbudsjett for å laste modellen og kjøretidsoverhead; dette er et grunnlinjeestimat, ikke en garanti for alle batch-størrelser, kontekster eller multimodale konfigurasjoner.
vLLM er den tydeligste veien for produksjonsserving, mens SGLang retter seg mot avansert distribuert inferanse; Ollamas nåværende rute er skyhostet snarere enn full lokal inferanse.
Egenhosting er mest attraktivt for personvern, air-gappede miljøer, forskning på vektnivå eller vedvarende klyngeutnyttelse; de fleste utviklere vil finne et hostet API enklere.
Hva er DeepSeek-V4.1-Flash? Arkitektur, parametere og modellstørrelse
DeepSeek lanserte offisielt V4.1-Flash 10. september 2026 som den minste modellen i den nye arkitekturfamilien, med innebygd visuell forståelse. Til tross for navnet “Flash” er det ikke en liten, tett modell.
Den viktigste arkitektoniske endringen er Causal Encoder-Decoder (CED)-designet. Modellen fordeler beregning asymmetrisk mellom promptinntak og tokengenerering, noe som reduserer aktiv beregning samtidig som den beholder en svært stor ekspertpool.
Spesifikasjon
DeepSeek-V4.1-Flash
Arkitektur
Multimodal MoE med Causal Encoder-Decoder
Backbone-parametere
552B
Aktive parametere, input
8B
Aktive parametere, output
16B
Transformer-lag
40: 20 encoder + 20 decoder
Kontekstvindu
1,048,576 tokens
Global KV-cache
890 bytes/token
Modaliteter
Tekst + bildeinput, tekstoutput
Vektlisens
MIT
Anbefalt sampling
Temperature 1.0; top_p 0.95 eller 1.0
Offisielle vekter
Hugging Face
Primære lokale serving-alternativer
vLLM, SGLang, DeepSeek referanseinferanse
Distinksjonen mellom aktive og residente parametere er avgjørende. MoE-ruting reduserer mengden beregning brukt per token, men serveren må fortsatt ha tilgang til ekspertvektene som kan bli valgt. Derfor kan en “8B aktiv” modell likevel kreve hundrevis av gigabyte lagring og akseleratorminne.
DeepSeeks offisielle KV-cache-graf viser at den globale cachen faller fra 3 514 byte per token i V4 Flash til 890 byte per token i V4.1 Flash, en reduksjon på omtrent 3,9×. Det betyr mye for inferanse med milliontokens, men eliminerer ikke det langt større minnekravet fra selve modellvektene.
Hvor god er DeepSeek-V4.1-Flash før du ruller den ut?
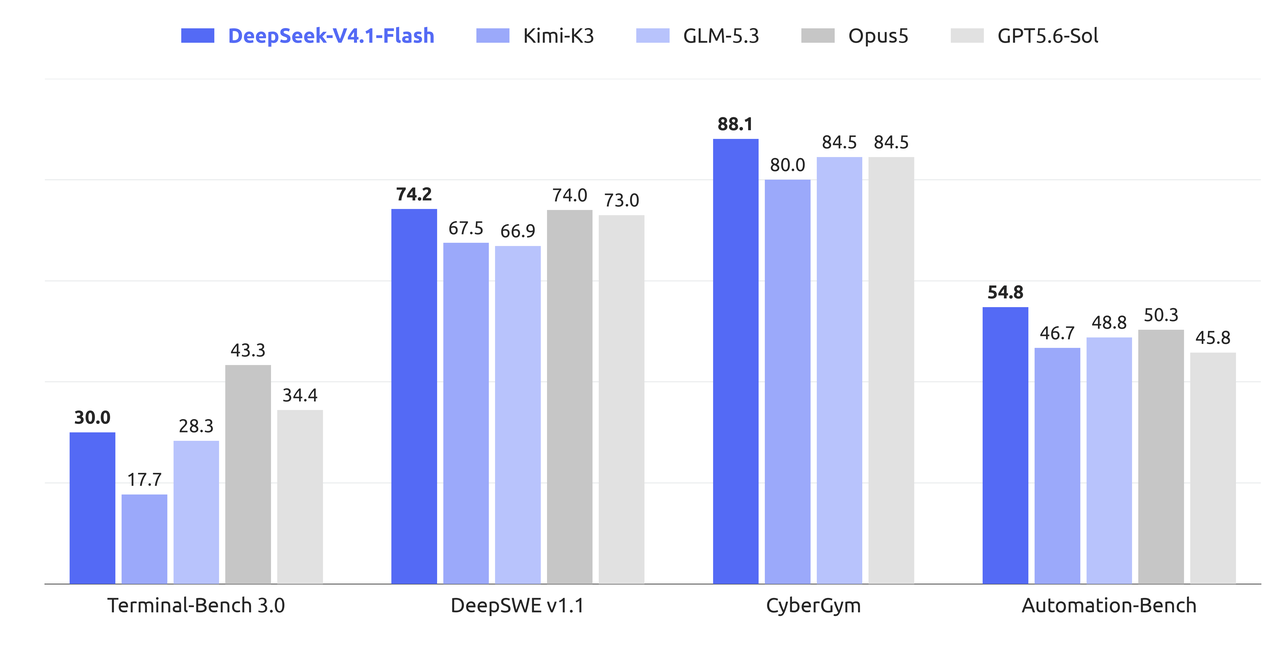
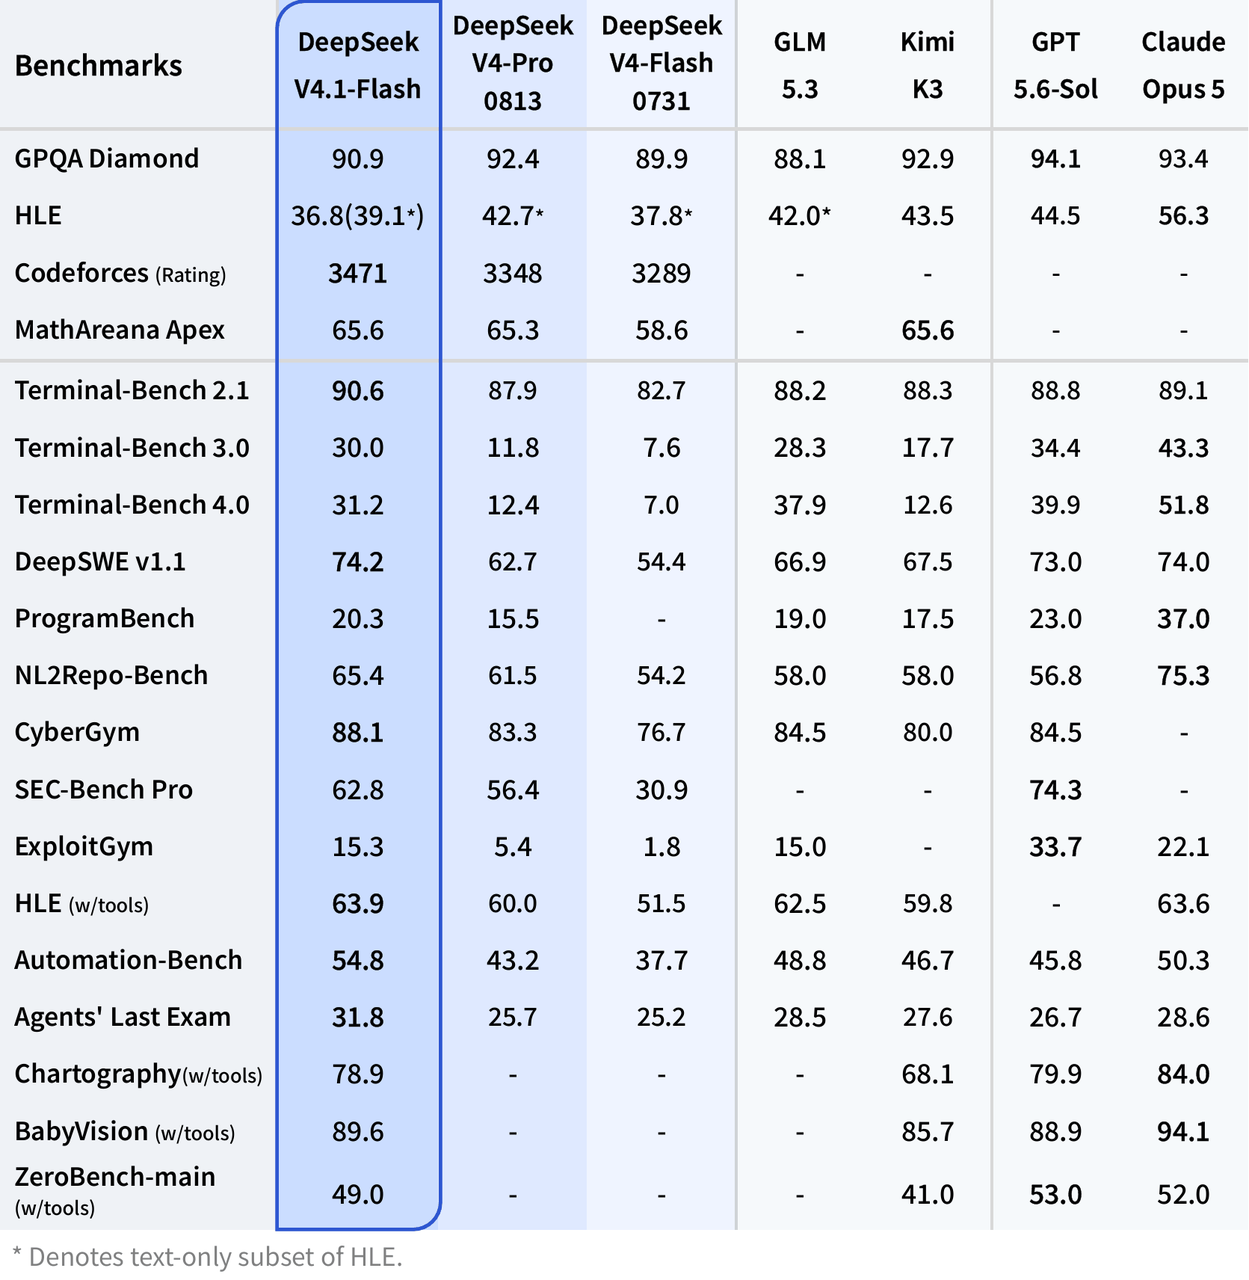
DeepSeeks publiserte benchmark-tabell posisjonerer V4.1-Flash primært som et stort løft i agentisk koding, terminaloperasjon, automatisering og programvareingeniør-arbeidslaster. Dette er leverandørrapporterte benchmark-resultater, så de bør behandles som referansemålinger heller enn garantert applikasjonsytelse.
For reproduserbarhet anbefaler den offisielle modellkortet temperature 1.0 og top_p 0.95, mens resonneringsinnsats og tokenbudsjetter varierer per evaluering. Tallene nedenfor er leverandørkjørte referanseresultater, ikke maskinvare-nøytrale ytelsesgarantier; benchmark-spesifikke rammeverksdetaljer bør konsulteres før reproduksjon.
Benchmark
DeepSeek V4.1 Flash
DeepSeek V4 Pro 0813
DeepSeek V4 Flash 0731
GPQA Diamond
90.9
92.4
89.9
Codeforces Rating
3471
3348
3289
MathArena Apex
65.6
65.3
58.6
Terminal-Bench 2.1
90.6
87.9
82.7
Terminal-Bench 3.0
30.0
11.8
7.6
Terminal-Bench 4.0
31.2
12.4
7.0
DeepSWE v1.1
74.2
62.7
54.4
NL2Repo-Bench
65.4
61.5
54.2
CyberGym
88.1
83.3
76.7
Automation-Bench
54.8
43.2
37.7
Agents' Last Exam
31.8
25.7
25.2
Mønsteret er viktigere enn én enkelt score. V4.1-Flash leder ikke hver benchmark, men hoppet fra V4 Flash 0731 er spesielt stort på Terminal-Bench, DeepSWE, automatisering og cybersikkerhet. Dette gjør lokal utrulling særlig relevant for private kodeagenter, repositorie-skala analyse, intern automatisering og air-gappet agentinfrastruktur.
Kan du virkelig kjøre DeepSeek-V4.1-Flash lokalt?
Ja, men ordet “lokalt” må kvalifiseres. Den siste vLLM-oppskriften for DeepSeek-V4.1-Flash bryter ned sjekkpunktet til omtrent et halvt terabyte og anbefaler et langt større VRAM-budsjett når kjøretidsoverhead tas med.
Komponent
Omtrentlig lagret størrelse
Ruted + DSpark-eksperter
259.5 GiB
Engram-tabeller
183.1 GiB
Attention, tette projeksjoner og rutere
6.9 GiB
Embeddings, LM-head og normer
3.9 GiB
UE8M0 block scales
21.9 GiB
Fullt sjekkpunkt
~476 GiB / ~511 GB
vLLM anbefalt minimum VRAM-budsjett
~614 GB
Den viktige overraskelsen er at V4.1-Flash allerede er kraftig komprimert internt. Ruted ekspertvekter bruker lavpresisjonsformater, så det offisielle sjekkpunktet er ikke bare en stor BF16-modell som venter på en enkel 4-bit-konvertering.
DeepSeek-V4.1-Flash maskinvarekrav
Maskinvarekonfigurasjon
Praktisk status
Kommentarer
1× RTX 4090 / 5090
Nei
Langt under modellens minnefotavtrykk
2–4 konsument-GPU-er
Nei for det offisielle fulle sjekkpunktet
Aggregert VRAM er fortsatt utilstrekkelig
128 GB arbeidsstasjon
Nei
Aktive parametere bestemmer ikke resident vektminne
256 GB arbeidsstasjon
Nei for offisiell serving-path
Fortsatt godt under det offisielle sjekkpunktfotavtrykket
512 GB system-RAM + GPU-offload
Eksperimentelt
Community/offload-område, ikke ekvivalent med verifisert produksjonsserving
4× high-memory datasenter-GPU
Maskinvareavhengig
Mulig med tilstrekkelig store moderne akseleratorer; sjekk kjøretidsoppskriften
8× H200
Ja, dokumentert klasse
Rundt 1,128 GB aggregert HBM
GB200 NVL4-klasse system
Ja
vLLM sier at et 768 GB-brett passer modellen
Viktig: 8B aktive parametere betyr ikke 8 GB VRAM. “Aktive” beskriver hvor mye av MoE-nettverket som deltar i en tokens beregning. Hele ekspertsettet må fortsatt lagres et tilgjengelig sted for inferansemotoren.
Hvilken runtime bør du bruke for DeepSeek-V4.1-Flash?
Støttet via nåværende DeepSeek-V4.1-distribusjonsbuilds
Høyytelses distribuert inferanse
DeepSeek referanseinferanse
Offisiell TP8-referanseimplementasjon
Arkitekturforskning og validering
Transformers
Modellintegrasjon eksponert på Hugging Face
Utvikling og eksperimentering; maskinvare kreves fortsatt
Ollama
Offisiell biblioteksrute bruker for tiden :cloud
Praktisk skykall, ikke ekvivalent med egenhosting
For produksjons-egenhosting er vLLM for tiden det tydeligste startpunktet. SGLang-distribusjonsveiledning gir en annen støttet vei for avansert distribuert inferanse.
Hvordan kjøre DeepSeek-V4.1-Flash lokalt med vLLM
Dette er den praktiske veien for en fler-GPU Linux-server. Alle kommandoeksempler nedenfor er reformattet som språkspesifikke kodeblokker med konsise engelske beskrivelser.
Trinn 1: Sjekk miljøet ditt
Linux.
Docker.
NVIDIA Container Toolkit.
Flere hundre gigabyte ledig SSD-plass.
En støttet fler-GPU-konfigurasjon.
Omtrent 614 GB aggregert brukbart akseleratorminne for den nåværende offisielle vektprofilen.
Et raskt nettverk hvis modellen ikke allerede er bufret lokalt.
Trinn 2: Last ned DeepSeek-V4.1-Flash-vektene
De offisielle vektene ligger i DeepSeek-V4.1-Flash-repositoriet på Hugging Face under MIT-lisensen.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Sørg for at filsystemet som holder ~/.cache/huggingface har betydelig mer enn 511 GB ledig. Midlertidige filer og ekstra motorartefakter kan øke topp diskbruk.
Trinn 3: Start DeepSeek-V4.1-Flash med vLLM
Per dagens vLLM-oppskrift krever DeepSeek-V4.1-støtte et tilstrekkelig ferskt vLLM-image. En tekst-only åtte-GPU startkonfigurasjon kan se slik ut:
Det er to bevisste valg her. For det første deaktiverer --language-model-only visjonsencoderen for rene tekstarbeidslaster. For det andre er det tryggere å starte på 131 072 tokens enn å aktivere hele én-millioners konteksten med en gang. Når serveren er stabil, kan du øke den:
--max-model-len 1048576
Riktig tensor-parallell-innstilling avhenger av akseleratortopologien, så ikke kopier --tensor-parallel-size 8 blindt til hver server.
Trinn 4: Test den lokale DeepSeek-V4.1-Flash-endepunktet
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "What is 17 * 19? Return only the integer."
      }
    ]
  }'
323
Trinn 5: Kall den lokale DeepSeek-V4.1-Flash-serveren med Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explain the difference between TCP and UDP in three bullets."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Hvordan aktivere DeepSeek-V4.1-Flash tenkemodus lokalt?
V4.1-Flash støtter eksplisitte resonneringskontroller gjennom sin chat-mal. Ett eksempel er:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Find the most efficient algorithm for this scheduling problem."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Hvis modellen ser ut til å returnere lite eller ingen sluttinnhold med en liten max_tokens-verdi, sjekk om tenkemodus spiser opp genereringsbudsjettet før du antar at utrullingen er ødelagt.
Hvordan kjøre DeepSeek-V4.1-Flash med referansekode?
DeepSeek inkluderer også en minimal TP8-inferanseimplementasjon i modellrepositoriet. Den er først og fremst ment som lesbar referansekode, ikke en høy-gjennomstrømmende produksjonsserver.
cd inference
python -m pip install -r requirements.txt
Denne veien er nyttig for å inspisere CED, MoE-ruting, Engram-minne, spekulativ dekoding og relaterte implementasjonsdetaljer. For normal produksjonsserving er vLLM eller SGLang enklere å drifte.
Kan du kjøre DeepSeek-V4.1-Flash lokalt med Ollama?
Ikke i samme forstand som å kjøre en vanlig 7B- eller 32B-Ollama-modell. Ollama eksponerer for tiden V4.1-Flash gjennom:
ollama run deepseek-v4.1-flash:cloud
Det viktige er :cloud. Den nåværende Ollama-biblioteksoppføringen bruker en skyroute, så denne kommandoen er ikke det samme som å laste ned komplette vekter og kjøre inferanse utelukkende på din egen maskin.
DeepSeek-V4.1-Flash lokal utrulling vs API: Hva gir mest mening?
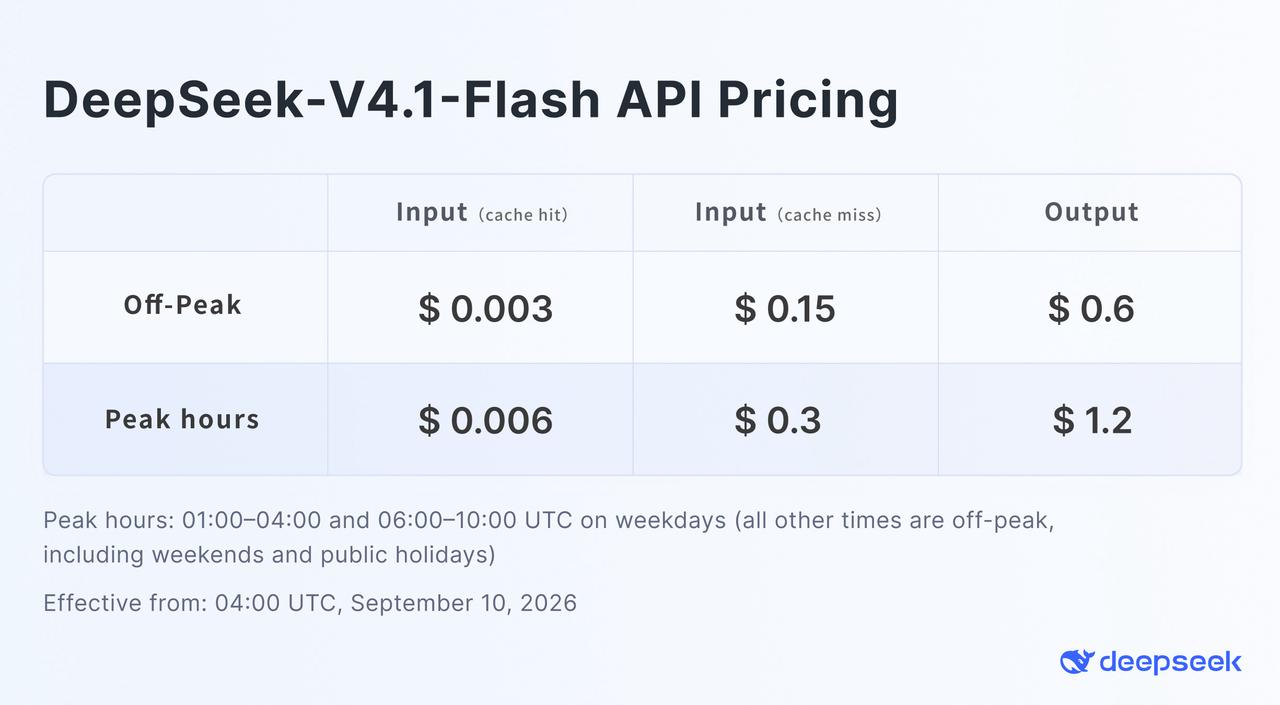
DeepSeeks offisielle off-peak-priser vises i V4.1-Flash-prisgrafikken. For utviklere som ikke trenger fysisk besittelse av vektene, tilbyr DeepSeek V4.1 Flash-API i CometAPI et OpenAI-kompatibelt alternativ.
Eksemplet under bruker CometAPIs modellidentifikator. Det er ikke identifikatoren brukt av DeepSeeks offisielle API.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Review this Python function and identify possible race conditions."
        }
    ]
)

print(response.choices[0].message.content)
Det praktiske valget er rett fram: lokal utrulling blir attraktiv når personvern, air-gappet drift, eksperimentering på vektnivå, forutsigbar tung utnyttelse eller regulatoriske krav veier tyngre enn infrastrukturkostnad. For ordinær applikasjonsutvikling unngår et hostet endepunkt hundrevis av gigabyte modellhåndtering og fler-GPU-orkestrering.
Hvilke problemer kan du støte på når du kjører DeepSeek-V4.1-Flash lokalt?
Serveren går tom for minne før generering starter
Det fulle sjekkpunktet, ikke 8B/16B aktive parametere, bestemmer mesteparten av minnekravet. Sjekk tensor-parallellisme, GPU-minneutnyttelse, visjonslasting og tilgjengelig HBM.
DeepSeek-V4.1-Flash bruker lang tid på å starte
Et halvt terabyte sjekkpunkt tar tid å laste ned, mappe, initialisere og shard-e. Lange engine-ready-timeouts er normale for denne klassen modell.
Responsen er tom eller slutter med finish_reason=length
Tenkemodus kan konsumere genereringsbudsjettet. Øk max_tokens, senk resonneringsinnsatsen, eller deaktiver tenking for enkle forespørsler.
Verktøykall parseres ikke riktig
Sørg for at serveren bruker DeepSeek V4.1-tokenizer, tool-call parser, reasoning parser og auto-tool-choice-flaggene.
Visjonsinput fungerer ikke
Hvis du startet med --language-model-only, deaktiverte du bevisst visjonsencoderen. Start på nytt med multimodal støtte aktivert før du tester bilder.
Bør du kjøre DeepSeek-V4.1-Flash lokalt?
DeepSeek-V4.1-Flash er uvanlig interessant fra et egenhostingsperspektiv fordi arkitekturen vesentlig reduserer per-token-beregning og KV-cache-kost, men den gjør ikke en modell med åpne vekter på frontier-skala om til en desktop-modell.
For et forskningslaboratorium, en enterprise AI-plattform, en privat kodeagent-stakk eller et air-gappet miljø gjør vLLM og SGLang egenhosting teknisk realistisk. For en utvikler med én eller to GPU-er er det ikke et praktisk mål å kjøre hele modellen. I så fall gir DeepSeek V4.1 Flash gjennom CometAPI tilgang til modellen uten å gjøre serving til et stort infrastrukturprosjekt.
FAQ
Er DeepSeek-V4.1-Flash åpen kildekode?
Modellvekter og repositorium er utgitt under MIT-lisensen, som tillater bred bruk, modifikasjon og redistribusjon under lisensvilkårene.
Kan jeg kjøre DeepSeek-V4.1-Flash på en RTX 4090 eller RTX 5090?
Ikke den offisielle fulle modellen. En enkelt konsument-GPU har bare en liten brøkdel av minnet som kreves av det fulle sjekkpunktet.
Betyr 8B aktive parametere at DeepSeek-V4.1-Flash bare trenger 8 GB VRAM?
Nei. 8B-tallet beskriver parameterne som deltar under promptbehandling. Hele ekspertnettverket og støtte-tilstanden må fortsatt lagres og være tilgjengelig.
Hvor mye VRAM trenger DeepSeek-V4.1-Flash?
Den nåværende vLLM-oppskriften bruker omtrent 614 GB som planfigur for det offisielle sjekkpunktet pluss kjøretidsoverhead. Faktisk behov varierer med maskinvare, batch-størrelse, kontekst, visjonsstøtte og serving-konfigurasjon.
Hvor stor er DeepSeek-V4.1-Flash på disk?
Den nåværende vLLM-nedbrytingen plasserer sjekkpunktet på omtrent 476 GiB, eller omtrent 511 GB.
Kan DeepSeek-V4.1-Flash kjøre et kontekstvindu på 1M tokens lokalt?
Arkitekturen støtter opp til 1 048 576 tokens, men praktisk minnebruk avhenger også av batch-størrelse, kjøretidsbuffere, visjonsstate og annen overhead.
Kan jeg kjøre DeepSeek-V4.1-Flash lokalt med Ollama?
Den nåværende Ollama-oppføringen bruker en :cloud-rute, som ikke er det samme som å kjøre komplette vekter utelukkende på din egen maskin.
Er vLLM eller SGLang bedre for DeepSeek-V4.1-Flash?
Begge retter seg mot høyytelses serving. vLLM har for tiden en spesielt detaljert V4.1-spesifikk oppskrift, mens SGLang også er egnet for avanserte distribuerte utrullinger.
Hva er den enkleste måten å bruke DeepSeek-V4.1-Flash uten lokal maskinvare?
Bruk et hostet API. DeepSeek tilbyr sitt eget API, mens CometAPI tilbyr et OpenAI-kompatibelt DeepSeek-V4.1-Flash-endepunkt sammen med andre AI-modeller.