Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Hva er Kimi K3.1: lanseringsdato, lekkasjer og forventede funksjoner
Utforsk rapporter om lanseringsdato for Kimi K3.1, lekkede resonneringsnivåer, 1M-kontekst og indikasjoner om Agent Swarm, samt K3-sammenligninger og API-forberedelser.
Per 9. oktober 2026 antyder rapporter at Kimi K3.1 kan komme denne måneden, men de gjennomgåtte kildene fastslår ikke en offisiell lanseringsdato, endelig pris eller K3.1-spesifikke benchmark-resultater. Rapporterte Low / High / Max, Extra Long, Agent og Swarm-flagg overlapper med eksisterende K3-funksjoner. En potensiell oppgradering betyr noe hvis den forbedrer resonneringseffektivitet, langkontekst-pålitelighet og kostnad per fullført oppgave; konfigurasjonsbetegnelser alene kan ikke demonstrere disse gevinstene.
Hovedpunkter
Lanseringstidspunkt: Oktober er en mulighet rapportert i media, uten at de siterte kildene etablerer en offisiell lanseringsforpliktelse.
Tekniske hint: Low / High / Max og en rapportert 1M-token-opsjon overlapper med K3-kapasiteter; K3.1-arkitektur og endelige grenser er ikke bekreftet.
Agent-arbeidsflyter: Agent-, Swarm-, søk- og batch-flagg indikerer mulig integrasjonsarbeid heller enn målte forbedringer.
Ytelse og prising: Publiserte K3-resultater og -satser er referansebaser, ikke K3.1-benchmarks eller -tariffer.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
API-beredskap: Bekreft aktiverte modell-ID-er, dokumenterte parametere og kontotilgang før du distribuerer K3.1 via CometAPI.
Hva er Kimi K3.1?
Kimi K3.1 er en rapportert neste iterasjon av Moonshot AIs Kimi-modellfamilie. Lekkede konfigurasjonsidentifikatorer antyder arbeid med resonnering, lang kontekst og agent-arbeidsflyter. Dens endelige spesifikasjoner, lanseringsdato og prising er ikke fastslått av de gjennomgåtte kildene, så den bør behandles som en prospektiv modell snarere enn en bekreftet offentlig utgivelse.
Hva vet vi om Kimi K3.1?
(Seneste rapporter fra fellesskapet per 23. oktober 2026)
Kimi K3.1 er den forventede etterfølgeren til Moonshot AIs Kimi K3 (lansert 16. juli 2026 — en 2.8T-parameter open-weight MoE-modell med 1M kontekst). Ingen offisielle spesifikasjoner, priser, benchmarks eller lanseringsdato er annonsert av Moonshot. Alt nedenfor er fellesskapsbasert bevis og spekulasjon.
Stilletesting på Arena under kodenavn «Kibitz»
En anonym modell ved navn Kibitz dukket opp i LMSYS / Arena.ai coding kamper rundt 21.–22. oktober 2026.
Fellesskapsbevis peker sterkt på at det er en Moonshot/Kimi-modell:
Den identifiserer seg selv som Kimi når den blir spurt.
Tester av tokeniserings-fingeravtrykk viser at den feiler alle 11 Moonshot-only testtokens (akkurat som tidligere Kimi-modeller); modeller fra andre laboratorier består dem.
Navnemønsteret matcher tidligere stealth-tester: K2.5 → Kiwido, K2.6 → Kiwire, K3 → Kivine, og nå Kibitz.
Kimi Code sin interne konfig viste kort en modellbytte-målsetning kalt “k3.1” (og en migrasjonsregel fra K3-økter).
Tidlige brukertester (særlig 3D/voxel-generering, SVG, Three.js-scener og komplekse frontend-oppgaver) er beskrevet som svært sterke — noen ganger nær Claude Opus 5.5 Medium eller konkurransedyktige med Fable 5.1 / GPT-6 Astra, med merkbart raskere generering i noen tilfeller.
Arena.ai postet selv: “En ny modell fra @Kimi_Moonshot kommer. Følg med for hvor den lander i Arena.”
Offisiell 24-sekunders teaser-video (23. oktober 2026)
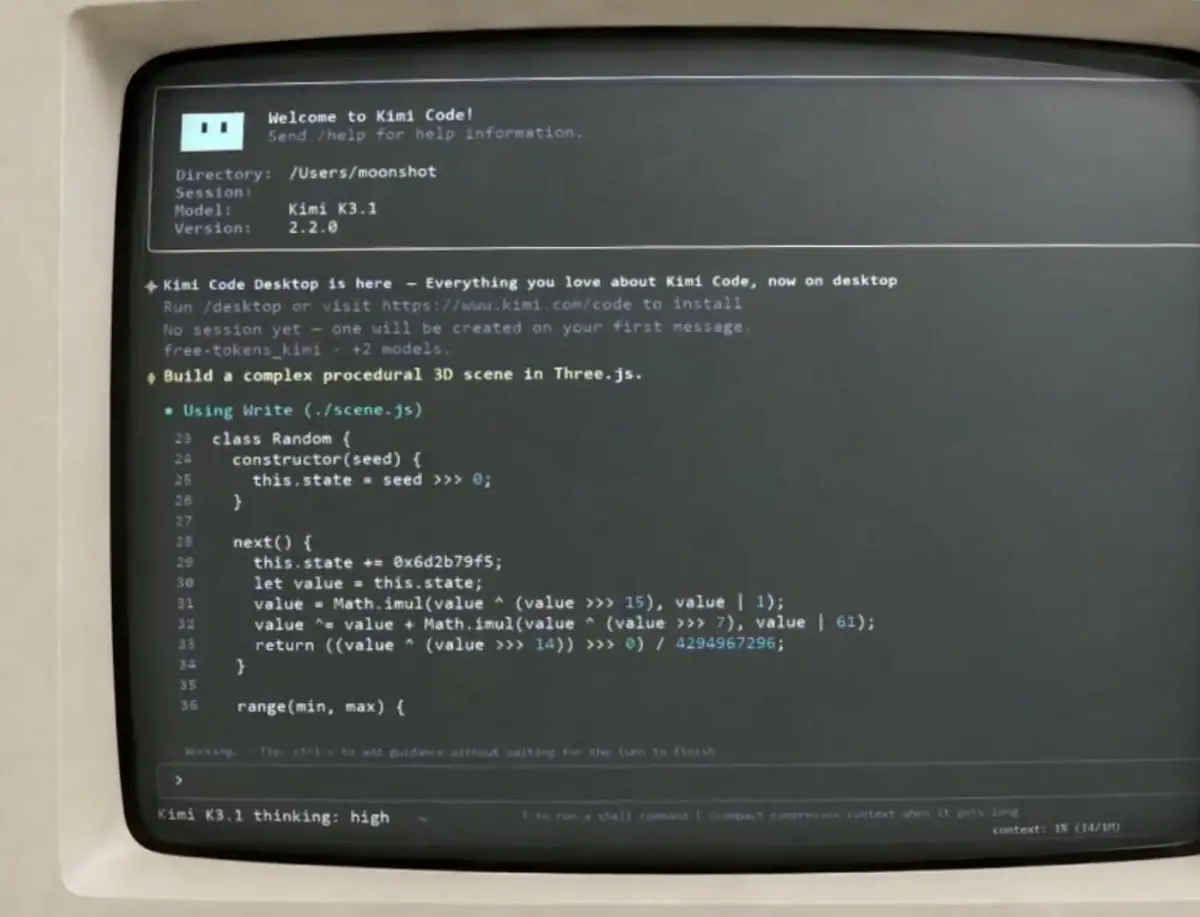
Den 23. oktober 2026 postet den offisielle @Kimi_Moonshot kontoen en 24 sekunder lang video uten bildetekst i retrostil.
Den viser en vintage CRT-skjerm som kjører Kimi Code (versjon 2.2.0). Modellvelgeren leser tydelig “Kimi K3.1”, med thinking satt til “high” og en 1M kontekstindikator. Modellen blir bedt om å generere en kompleks prosedyrell 3D-scene i Three.js.
Dette er første gang Moonshot offentlig har vist navnet “Kimi K3.1.” Ingen ytterligere detaljer (lanseringsdato, størrelse, pris eller vekter) ble gitt. Innlegget fikk raskt høy engasjement.
Andre støttende indikasjoner
Sent i september 2026: Utviklere oppdaget en “kimi-k3-1”-identifikator på Moonshots API-backend.
En kortvarig SGLang pull request (lukket i løpet av minutter) refererte til en live DeepInfra Kimi-K3.1-distribusjon, inkludert et nytt “medium” thinking-innsatsnivå og bildeinput.
Lekkasjer i fellesskapet (f.eks. @ChrisGPT) hevder at det vil være en rimelig, topp moderne open-source-modell og kan slippes før neste tirsdag (dvs. svært snart). En mye delt Minecraft selvportrett-test hevdet dramatisk bedre kostnadseffektivitet enn GPT-6 Astra, selv om disse tallene er uoffisielle.
Statusoppsummering
Ikke lansert — ingen model card, API-endepunkt, prising, vekter eller offisiell kunngjøring ennå.
Sterkeste signaler: Kibitz Arena-testing + offisiell teaser-video som viser navnet.
Forventet fokus (basert på K3-presedens og fellesskapsprat): forbedret lang-horisont agentisk koding, 3D/kreativ generering, effektivitet og muligens lavere kost enn K3.
Historisk mønster: K3 dukket selv opp anonymt på Arena (~30 timer) før sin offisielle lansering.
Fellesskapets konsensus er at en full lansering er nært forestående (dager heller enn uker), men ingenting er bekreftet før Moonshot sier det.
Når blir Kimi K3.1 lansert?
De gjennomgåtte kildene fastslår ikke en offisiell lanseringsdato for Kimi K3.1. IT Home rapporterer oktober 2026, mens Wccftechs tidligere dekning sier før oktober. Dette er ulike medieprognoser, ikke en verifisert utviklingsplan. Et skjermbilde kan ikke fastslå utrullingsdatoer, kontoberettigelse eller distribusjonsberedskap.
Se etter en datert Moonshot-kunngjøring, støttede modell-ID-er, utviklerdokumentasjon og tilgangsvilkår før du behandler en lanseringsdato som bekreftet. Prising og reproduserbare K3.1-spesifikke evalueringer er separat bevis som trengs for distribusjonsbeslutninger.
Hvilke spesifikasjoner kan Kimi K3.1 tilby?
Det sterkeste tekniske baseline er den eksisterende Kimi K3, en utgivelse fra juli 2026 med en 2,8-billioners-parameter sparsom MoE-arkitektur, native visuell input og et kontekstvindu ofte beskrevet som 1M tokens. De siterte kildene fastslår ikke K3.1-arkitektur, parameterantall eller modellspesifikke evalueringsresultater.
Low / High / Max in current Kimi Code documentation
Low / High / Max flags
Vision
Native visual input
Not confirmed
Swarm
Existing Kimi Swarm capability
Swarm flag reportedly appears
API price
Published K3 tariff
No final pricing
Weights
K3 weights released
Unknown
Hvilke funksjoner er rapportert for Kimi K3.1?
De tre temaene nedenfor kombinerer de rapporterte K3.1-hintene med dokumenterte K3-kapasiteter. De forklarer hva innstillingene kan bety uten å presentere ryktede K3.1-funksjoner som bekreftede spesifikasjoner.
Low kan passe til ekstraksjon, enkel Q&A og rutineklassifisering når lavere latens betyr noe. High kan tilby en praktisk balanse for flertrinnsutvikling og dokumentarbeid. Max kan tildele mer resonneringsbudsjett til vanskelig koding eller forskning, med høyere latens og mulig kostnad. Disse oppgavemappingene er tolkninger som bør testes, ikke verifiserte K3.1-garantier.
Disse arbeidslasteksemplene er analytiske tolkninger, ikke verifiserte K3.1-tjenestegarantier. Utviklere bør sammenligne kvalitet per enhet forbruk: en kjøring med høy innsats kan koste mer per forsøk, men færre omstarter kan redusere den totale arbeidsflytkostnaden. Den meningsfulle oppgraderingen ville være forbedret oppgavesuksess ved et sammenlignbart token- og verktøybudsjett.
En 1M-token-opsjon utvider langkontekst-baselinen
Et million-token-vindu kan romme betydelige kodearkiver, lange tekniske dokumenter, prosjekthistorikk og omfattende verktøyspor. Men maksimal kontekstlengde er ikke det samme som nøyaktig bruk av fjern informasjon. En produktiv modell må fortsatt hente de riktige faktaene, opprettholde tverrdokument-konsistens og holde prefill-latens håndterbar.
Evaluer lang kontekst ved å teste gjenfinning på ulike promptposisjoner, konsistens på tvers av dokumenter og tid til første token. Mål cache-gjenbruk og kostnaden ved å beholde eller komprimere agenthistorikk også. En nominell 1M-token-grense er nyttig bare hvis modellen kan hente fjern evidens nøyaktig innenfor akseptabel latens og budsjett.
Agent- og Swarm-flagg antyder koordinert oppgaveutførelse
De agentrelaterte identifikatorene og Swarm-flaggene er kanskje mer interessante enn kontekstattallet. Kimi støtter allerede multi-agent-arbeid; derfor må den ryktede oppgraderingen forbedre ruting, delegering, resultataggregasjon og kostnadskontroll snarere enn bare å legge til en Swarm-betegnelse.
I en plausibel orkestrert arbeidsflyt bryter én koordinator en kompleks forespørsel ned i forskning, koding, testing og syntese-deloppgaver. Spesialiserte arbeidere kjører parallelt, returnerer evidens og forenes av koordinatoren. Slik parallellisering kan redusere forløpt tid samtidig som totalmodellantall øker, så veggklokkehastighet og kostnader må rapporteres hver for seg.
Kimis offisielle Agent Swarm-dokumentasjon beskriver eksisterende parallell agent-utførelse. Eksemplet nedenfor illustrerer hvordan slik orkestrering kan dele arbeidet; det fastslår ikke K3.1s endelige konfigurasjon eller en påkrevd Swarm-topologi.
En forskningsarbeider kan hente kilder og verifisere sitater; en kodearbeider kan endre moduler og returnere kjørebevis; en analysearbeider kan sammenligne alternativer med reproducerbare beregninger. En koordinator tildeler oppgaver, forener uenigheter og begrenser budsjettet. Hver arbeiders output trenger verifikasjon før det kombinerte resultatet aksepteres.
For K3.1 bør utviklere se etter reproduserbare benchmarks for vellykkede ende-til-ende agentoppgaver, feilhåndtering, uenighet mellom agenter, antall verktøyanrop og totalforbruk. Konfigurasjonsflagg alene kan ikke fastslå forbedring.
Hvordan sammenlignes Kimi K3.1 med K3 på benchmarks?
Ingen verifisert, K3.1-spesifikk benchmark-tabell er tilgjengelig. Tallene nedenfor er fra Moonshots offisielle K3-evalueringer, vist utelukkende som sammenligningsbaseline. Ulike modellrammeverk og vurderingsoppsett begrenser strengt eple-til-eple-inferens.
Evalueringsnotatene spesifiserer K3 max effort, temperatur 1,0 og top-p 1,0. DeepSWE v1.1 bruker Kimi Code her; det separat siterte mini-SWE-agent-resultatet er 67,3. Terminal-Bench bruker Kimi Code for K3, Terminus 2 for Fable 5 og Codex for Sol. FrontierSWE bruker Kimi Code/Codex og 16. juli dominansscore; ProgramBench bruker Kimi Code for K3. KCB 2.0 bruker Kimi Code/Claude Code for K3 og Claude Code/Codex for Fable/Sol. SWE Marathon bruker en H20-kalibrert v1.1-branch med Claude Code/Codex; Fable traff fallbacks på 35% av oppgavene. Dette er leverandørrapporterte resultater under ulike rammeverk.
Se de offisielle evalueringsnotatene for hver benchmarks komplette protokoll; tallene fastslår ikke en kontrollert K3.1-sammenligning.
K3 er særlig konkurransedyktig på Program Bench og SWE Marathon i dette settet, mens de komparative lederne varierer per test. K3.1 kan ikke erklæres raskere eller mer nøyaktig før tester med et dokumentert agentrammeverk, resonneringsbudsjett og evalueringsdato er publisert.
Kimi K3 API i CometAPI (offisiell lanseringstariffreferanse)
Kimi K3.1 API i CometAPI (ubekreftet tariff)
Cached input
US$0.30 / 1M tokens
Unconfirmed
Uncached input
US$3.00 / 1M tokens
Unconfirmed
Output
US$15.00 / 1M tokens
Unconfirmed
Agent orchestration
Depends on actual usage
Unconfirmed
Med disse K3-referansesatsene vil 100 000 ikke-cachede inputtokens pluss 10 000 outputtokens koste US$0,45. Dette er et illustrativt K3-regneeksempel, ikke K3.1-prising. Enterprise-planlegging bør bruke kostnad per verifisert oppgave snarere enn tokens alene.
Hvordan kan utviklere forberede seg på Kimi K3.1 API-tilgang?
Tilgangssjekker kommer før integrasjon
Utviklere kan følge Kimi K3.1 API i CometAPI for tilgangsoppdateringer. Den 9. oktober 2026 sier seksjonen for tilgjengelighet på siden fortsatt Coming Soon, sammen med generisk endpoint- og health-tekst. Behandle den inkonsistente siden som en oppdagelseslenke; bekreft en aktivert modell-ID og en vellykket test på kontonivå før du antar produksjonstilgang.
En lanseringssjekkliste veileder distribusjonsbeslutningen
Spørsmål
Bevis tilgjengelig nå
Bekreftelse nødvendig
Release?
September-lekkasjer
Moonshot-lanseringskunngjøring
Ny arkitektur?
Ingen K3.1 model card
Teknisk rapport og parametere
Bedre resonnering?
Tre kjente innsatsnivåer
Kvalitet/kost vs K3 på hvert nivå
Bedre lang kontekst?
Rapportert 1M-opsjon
Nøyaktighet og latens ved 1M
Bedre multi-agent?
Agent/Swarm-konfigurasjonsflagg
Agent-suksess og kost-benchmarks
API-produksjonstilgang?
Coming Soon-indikator
Støttede ID-er, docs, prising
Forberedelse kan starte med portable evalueringer og et avgrenset testbudsjett. Migrasjon bør vente på dokumentert tilgang og repeterbare gevinstnivåer på arbeidslast. Beslutningen er om K3.1 produserer aksepterte resultater mer pålitelig og økonomisk, snarere enn om en katalogside eller en konfigurasjonsbetegnelse finnes.
Vanlige spørsmål
Hvordan kan utviklere verifisere Kimi K3.1-tilgang?
Bekreft leverandørens støttede modell-ID og kontoentitlement, kjør så en liten forespørsel og inspiser returnert modellidentifikator, bruk og feil. En vellykket kall verifiserer tilgang for den kontoen og ruten på det tidspunktet; en katalogoppføring eller health-etikett alene fastslår ikke en offentlig lansering eller stabil kvote.
Kan Kimi K3.1 erstatte K3 i en eksisterende agent?
Behandle migrasjon som en kompatibilitetsendring. Sjekk verktøyskjemaer, håndtering av resonneringshistorikk, outputformater og timeout-atferd før du rekjører representative oppgaver. Bruk en fastsatt baseline og behold rollback-routing. Et lignende modellnavn eller kontekstgrense er utilstrekkelig bevis for at langvarige økter vil oppføre seg identisk.
Hvordan bør team budsjettere for en Kimi K3.1-pilot?
Start med et avgrenset oppgavesett i stedet for å ekstrapolere en ryktet tokenpris. Spor ikke-cachet input, cache-treff, resonnerings-/outputtokens, verktøyanrop, omstarter og menneskelig korreksjonstid. Avsett et fast evalueringsbudsjett og sammenlign kostnad per akseptert resultat etter at endelige satser er dokumentert.
Hva vil telle som en meningsfull Kimi K3.1-oppgradering?
Krev repeterbare gevinster på din arbeidslast ved sammenlignbare resonnerings- og verktøybudsjett. Test fjern-evidens-gjenfinning, motstridende dokumenter, agentgjenoppretting og ende-til-ende oppgaveaksept. Registrer feilrate, latens og totalforbruk sammen; et større nominelt vindu eller ekstra konfigurasjonsflagg alene er utilstrekkelig.
Konklusjon
Kimi K3.1 bør behandles som en rapportert, prospektiv utgivelse. Bevisene som er gjennomgått identifiserer mulig konfigurasjonsarbeid, mens K3 allerede leverer lang kontekst, justerbar innsats og Swarm-utførelse. Den praktiske muligheten er bedre oppgavekvalitet til bærekraftig kost. Forbered portable evalueringer nå, og ta migrasjonsbeslutninger etter at offisielle spesifikasjoner, tilgangsvilkår, prising og reproduserbare K3.1-resultater er tilgjengelige.