Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Kimi K3.1 Pro vs. Kimi K3: Ytelsestester, funksjoner, priser og hvilken er best?
Sammenlign Kimi K3.1 Pro og Kimi K3 på benchmarktester, koding, resonnering, kontekst, API-priser og hastighet. Finn ut hvilken modell som er bedre og når du bør oppgradere.
Kimi K3.1 Pro er Moonshot AIs oppgradering av Kimi K3 den 24. oktober 2026. Ytterligere ettertrening forbedrer autonom koding, finansiell forskning og utvidede verktøybruk-arbeidsflyter, samtidig som den beholder omtrent én million token i kontekstkapasitet.
Uavhengige evalueringer viser sterkere totalytelse, og ordinære offisielle inn-/utdata-tokensatser faller med en tredjedel. Oppgraderingen krever fortsatt arbeidsbelastningstesting: dypere resonnering kan øke oppgavelatens og totalforbruk, mens K3 beholder en liten ledelse på AA-LCR og har tilgjengelige vekter for egenhosting per nå.
Viktige punkter
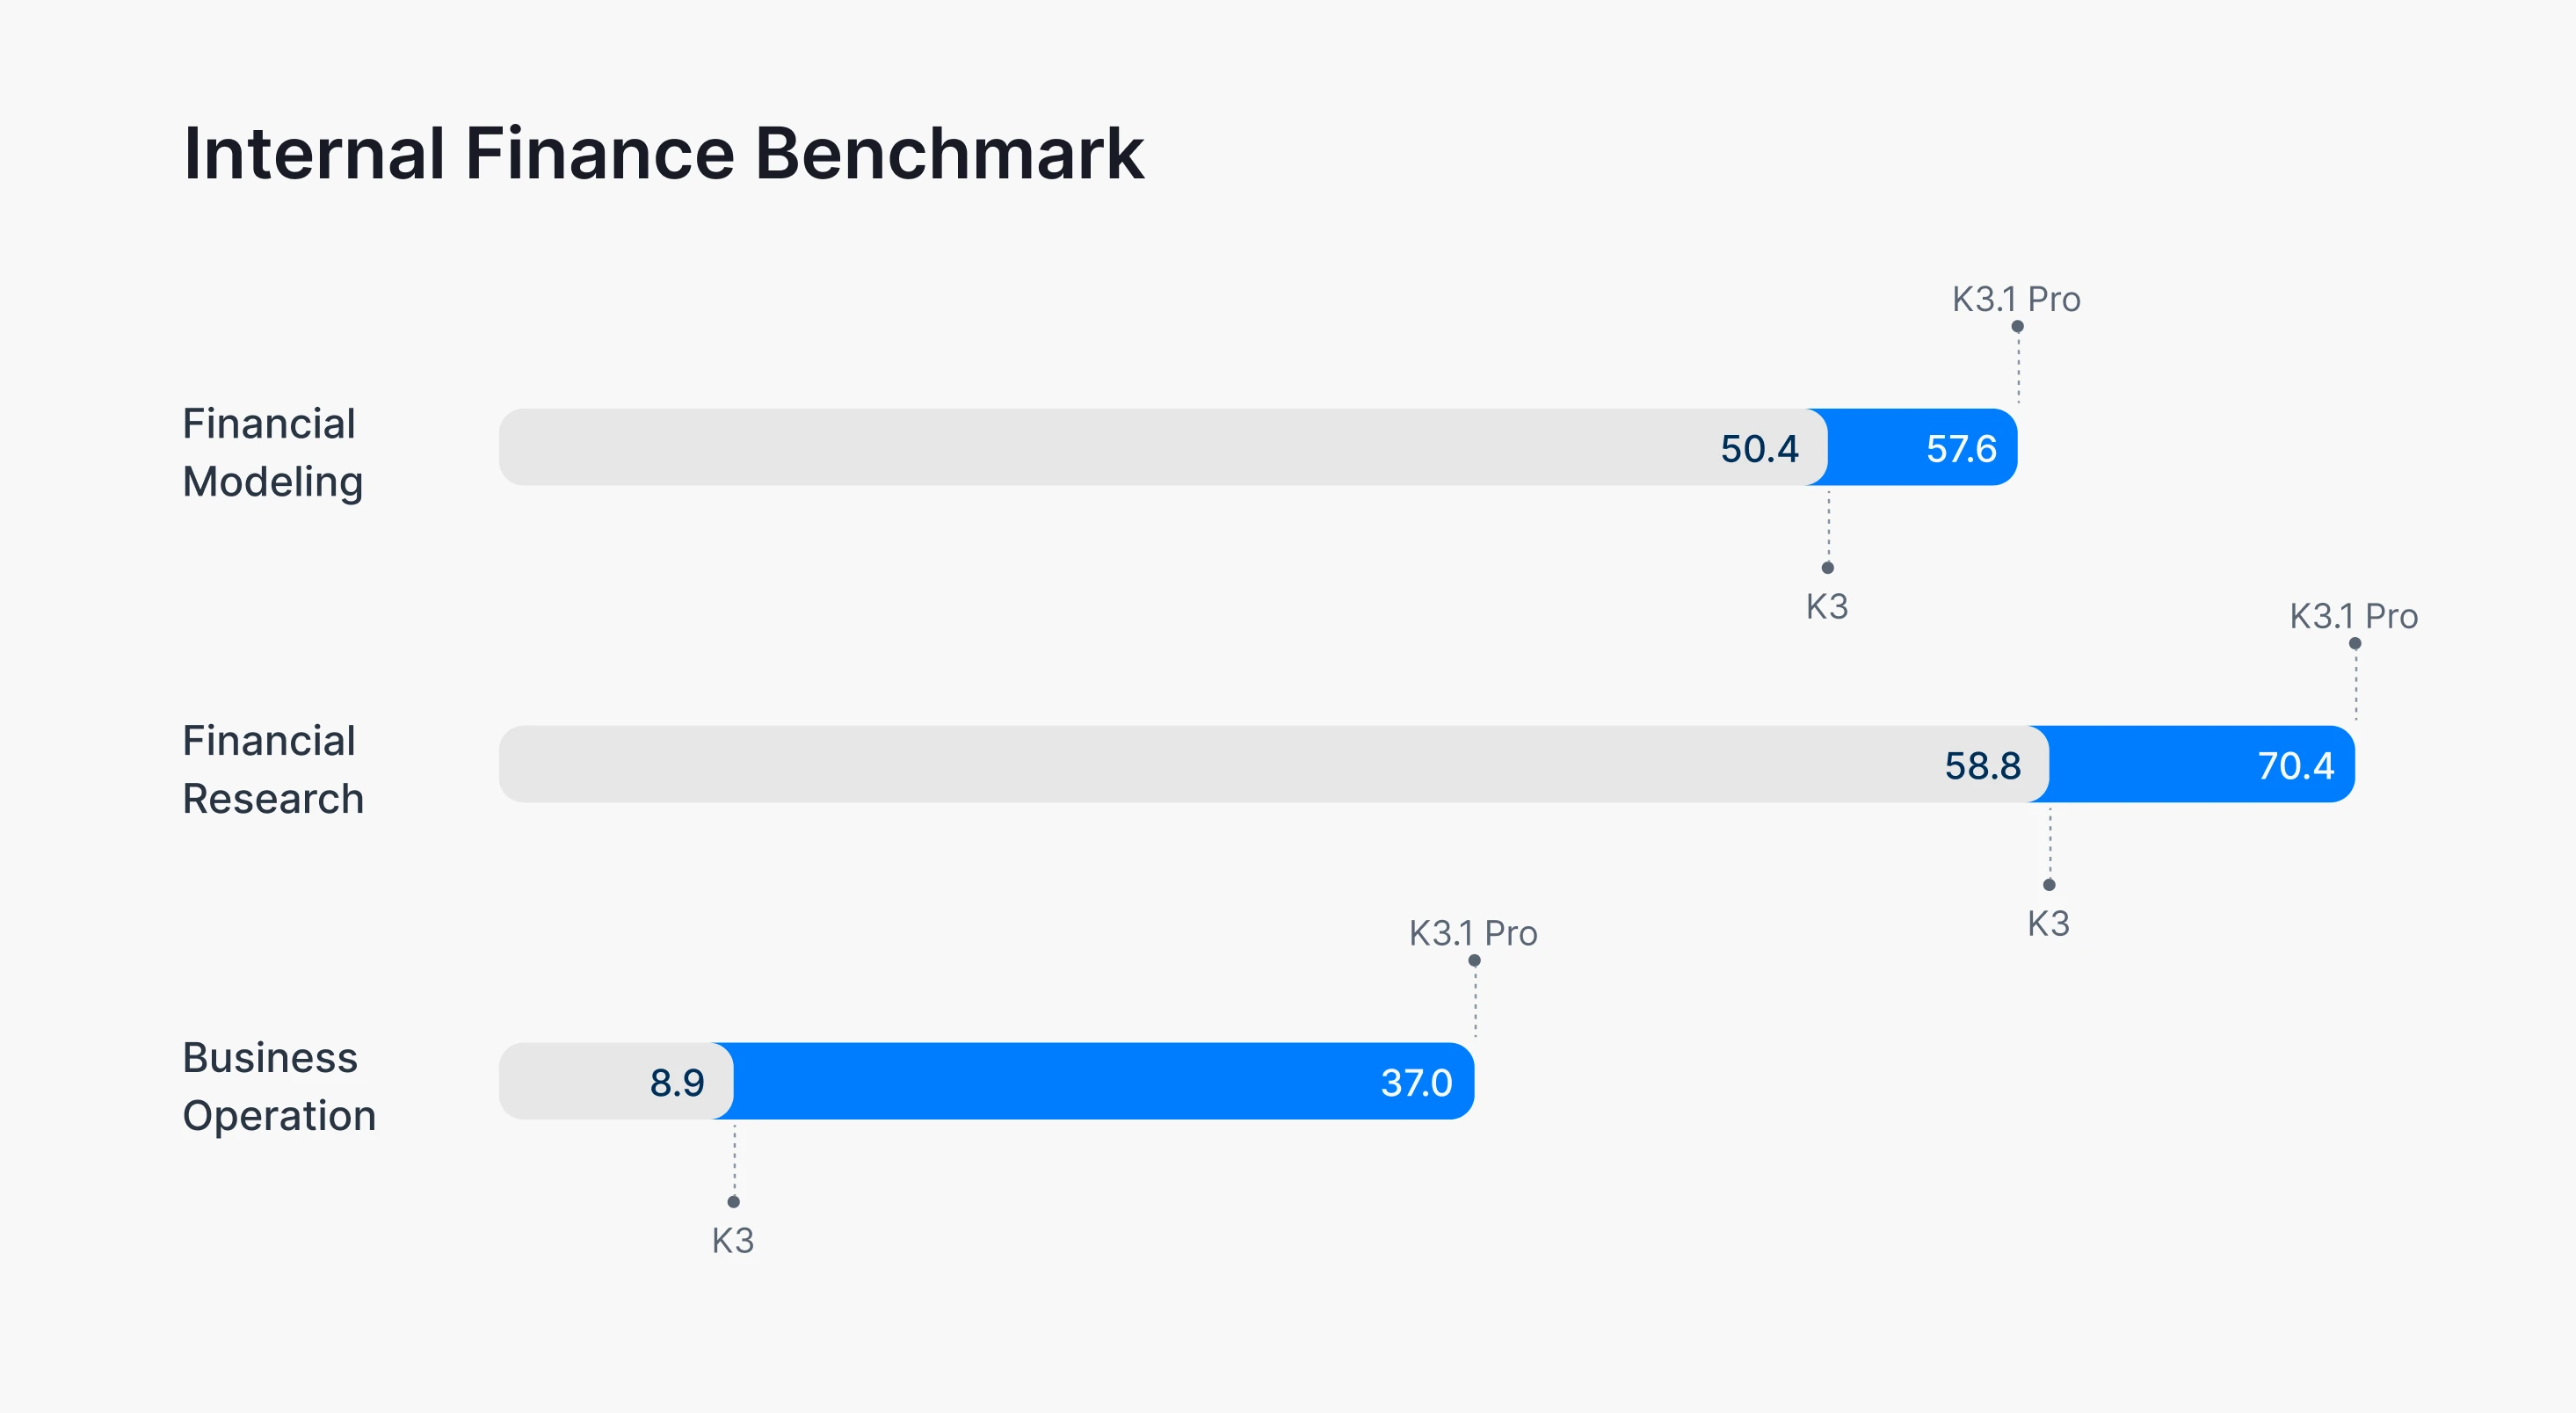
Det tydeligste løftet er i agentisk utførelse. Artificial Analysis rapporterer Terminal-Bench 4.0-scorer på omtrent 67 % for K3.1 Pro mot 13 % for K3; Moonshots interne Financial Research-scorer stiger fra 58.8 til 70.4.
Lavere tokenpriser garanterer ikke lavere oppgavekostnader. Standard offisielle inn-/utdata-satser faller fra $3/$15 til $2/$10 per million tokens, men ekstra resonnering, verktøykall og retrier kan oppveie besparelsen.
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
Kontekstvinduet er uendret. Begge modeller støtter opptil 1,048,576 tokens. K3 ligger fortsatt litt foran i den refererte AA-LCR v1.1-evalueringen, så test langkontekst-nøyaktighet på dine egne dokumenter.
Tilgjengelighet av vekter kan avgjøre valget. Per 24. oktober 2026 er K3-vekter tilgjengelige; K3.1 Pro-vekter er planlagt utgitt innen 4. november. Team som trenger umiddelbar egenhosting bør ta høyde for denne forskjellen.
Kimi K3.1 Pro vs Kimi K3: Oversikt og spesifikasjoner
Kimi K3.1 Pro bygger på K3 gjennom ekstra ettertrening, med forbedringer fokusert på koding, finansiell forskning og utvidede agent-arbeidsflyter. Begge beholder omtrent én million tokens med kontekst. De viktigste forskjellene er oppgaveytelse, tokenpriser, serving-alternativer og vekttilgjengelighet.
Spesifikasjon
Kimi K3.1 Pro
Kimi K3
Utvikler
Moonshot AI
Moonshot AI
Utgivelsesdato
24. oktober 2026
16. juli 2026
Arkitektur
K3-avledet MoE, videre ettertrent
MoE med KDA, AttnRes
Modellstørrelse
3T-klasse og 104B aktive parametere
2.8T total og 104B aktive parametere
Kontekstvindu
Opptil 1,048,576 tokens
Opptil 1,048,576 tokens
Standard API inn-/utdatapris
$2 / $10 per million tokens
$3 / $15 per million tokens
Highspeed-versjon
Tilgjengelig
Ingen separat K3 Highspeed-variant oppført
Vekttilgjengelighet
Planlagt utgivelse innen 4. nov. 2026
Tilgjengelig under Kimi K3-lisensen
Vekttilgjengelighet reflekterer informasjon tilgjengelig per 24. oktober 2026. API-priser er i USD for ordinær inn- og utdata, ekskludert cache-skrivekostnader, skatter og andre gjeldende gebyrer.
Arkitektur og ettertrening
K3 introduserte en arkitektur med 2.8 billioner parametere som kombinerer Kimi Delta Attention, Attention Residuals og Stable LatentMoE. Den aktiverer omtrent 104 milliarder parametere per token.
Moonshot beskriver K3.1 Pro som en ettertrent versjon av K3 utviklet med vesentlig høyere ettertreningscompute. Oppgraderingen fokuserer på å anvende modellens kapabiliteter på flertrinnsoppgaver, inkludert verktøybruk, debugging og resultatsjekk. Kunngjøringen introduserer ikke en separat navngitt basearkitektur.
Delte kapabiliteter og API-krav
Begge modeller støtter multimodale inndata, verktøykall, strukturerte utdata og kontekstcaching. Bilde- og videoformat for inndata avhenger av valgt API-rute. Begge resonerer alltid og støtter low, high og max resonneringsinnsats, med max som standard.
For fleromgangssamtaler og verktøykall må integrasjoner bevare komplette assistentmeldinger, inkludert resonnementinnhold og verktøykall, som krevd av API-et. Faktiske kontekstgrenser og funksjonstilgjengelighet bør også sjekkes for valgt leverandør, produkt og abonnement.
Kimi K3.1 Pro vs Kimi K3: Ytelse
Bevisgrunnlaget kommer fra Moonshots interne tester og rapporterte sammenligninger, samt uavhengige tredjeparts-evalueringer.
Disse bør tolkes separat fordi benchmark-harness, testsett, resonneringsinnstillinger og scoringskriterier kan variere.
Artificial Analysis’ lanseringsevaluering rapporterer en økning på 11 poeng på sin sammensatte Intelligence Index, med særlig store forbedringer i terminalbasert koding og agentiske arbeidsflyter.
Uavhengig benchmark (Artificial Analysis)
Kimi K3
Kimi K3.1 Pro
Forskjell
Intelligence Index
44
55
+11
Terminal-Bench 4.0
~13%
~67%
+54 prosentpoeng
AutomationBench-AA
58%
73%
+15 pp
GDPval-AA Elo
1,534
1,846
+312
AA-Omniscience Index
20
30
+10
Humanity's Last Exam
~47%
~52%
+5 pp
AA-Omniscience hallusinasjonsrate
53%
44%
−9 pp
AA-LCR v1.1
88.7%
86.3%
−2.4 pp
Dette er uavhengige evalueringsresultater. Avrundede verdier brukes der evaluator rapporterer avrundede scorer. Lavere hallusinasjonsrater er bedre.
Den største forbedringen skjer i terminalbasert koding. K3.1 Pro presterer betydelig bedre på oppgaver som krever kommandoeksekvering, miljøinteraksjon, debugging og gjentatt validering.
AutomationBench-AA viser også en betydelig gevinst, noe som antyder sterkere utførelse i programvare-som-en-tjeneste-arbeidsflyter.
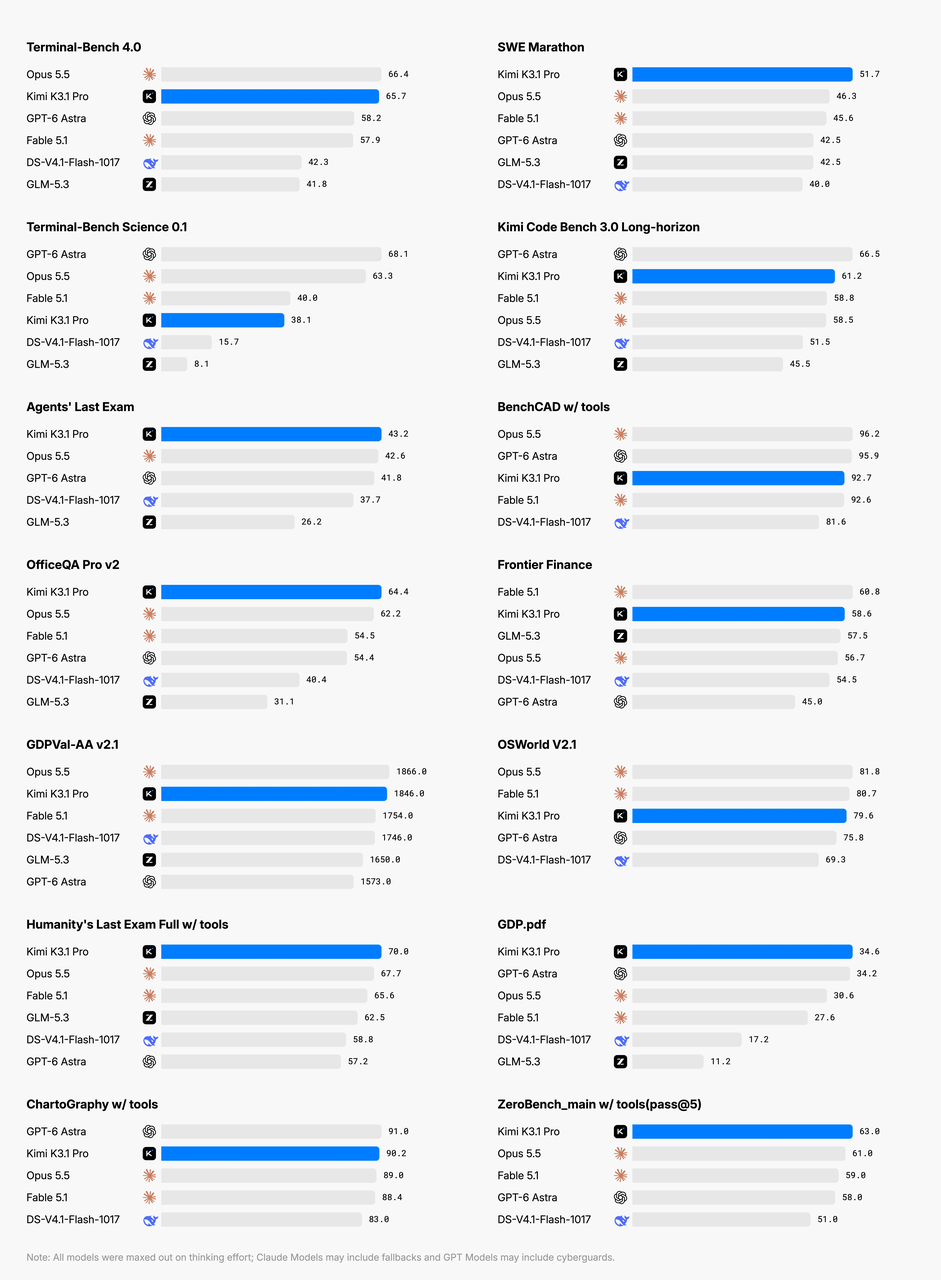
Moonshots lanseringsbenchmarker fokuserer på koding, vitenskap, 3D-rekonstruksjon, finans, kunnskapsarbeid og autonome agenter.
De utvalgte sammenligningene inkluderer Claude Opus 5.5 og GPT-6 Astra. Sammenlign hvert resultat innenfor den navngitte benchmarken og oppgitt konfigurasjon.
Benchmark (Moonshot AI)
Kimi K3.1 Pro
Annen modell
Sammenligningsmodell-score
Terminal-Bench 4.0
65.7%
Claude Opus 5.5
66.4%
Terminal-Bench 4.0
65.7%
GPT-6 Astra
58.2%
SWE-Marathon
51.7%
Claude Opus 5.5
46.3%
Kimi Code Bench 3.0
61.2%
GPT-6 Astra
66.5%
BenchCAD with tools
92.7%
Claude Opus 5.5
96.2%
OfficeQA Pro v2
64.4
Claude Opus 5.5
62.2
Frontier Finance
58.6
Claude Opus 5.5
56.7
OSWorld 2.1
79.6%
Claude Opus 5.5
81.8%
K3.1 Pro nærmer seg eller overgår flere ledende proprietære modeller i utvalgte oppgaver. Men den dominerer ikke alle kategorier.
For eksempel ligger den bak Claude Opus 5.5 i leverandørrapporterte BenchCAD og OSWorld-sammenligninger, og den offisielle grafen viser en større svakhet i Terminal-Bench Science.
Evalueringsoppsett varierer: Artificial Analysis bruker mini-swe-agent-harness for Terminal-Bench 4.0, mens Moonshot bruker Claude Code. Sammenlign scorer innen samme testoppsett; harness, resonneringsinnsats og kjøretidsgrenser kan påvirke resultatene.
Koding og programvareutvikling
For kompleks autonom koding er K3.1 Pro generelt det sterkere valget.
Moonshots interne Kimi Code Bench 3.0 Long-horizon-resultater øker fra 55.95 % for K3 til 61.2 % for K3.1 Pro, en gevinst på omtrent 5.25 prosentpoeng.
Uavhengige Terminal-Bench-resultater viser også en betydelig gevinst. Disse testene vurderer flertrinnsutførelse: forstå et repository, endre filer, kjøre kommandoer, diagnostisere feil og verifisere resultatet.
K3.1 Pro er den sterkere kandidaten for utvikling på tvers av flere filer, autonomt terminalarbeid og utvidet debugging. For enkel kodegenerering, sammenlign begge modellene på dine egne oppgaver; K3 er fortsatt det umiddelbare alternativet når egenhosting kreves.
En viktig distinksjon er at kodingsbenchmarker er sterkt avhengige av agentrammeverket. Verktøy, promter, kjøretidsgrenser og testmiljøer påvirker utfallet.
For produksjonsutvikling er den beste evalueringen fortsatt en matchet sammenligning på dine egne repositories.
Finansiell forskning og forretningsdrift
Finansiell modellering gir noen av de tydeligste direkte sammenligningene mellom de to modellene.
Moonshot testet både K3 og K3.1 Pro på interne evalueringer som dekker regnearkbygging, forskningskvalitet og simulerte forretningsoperasjoner.
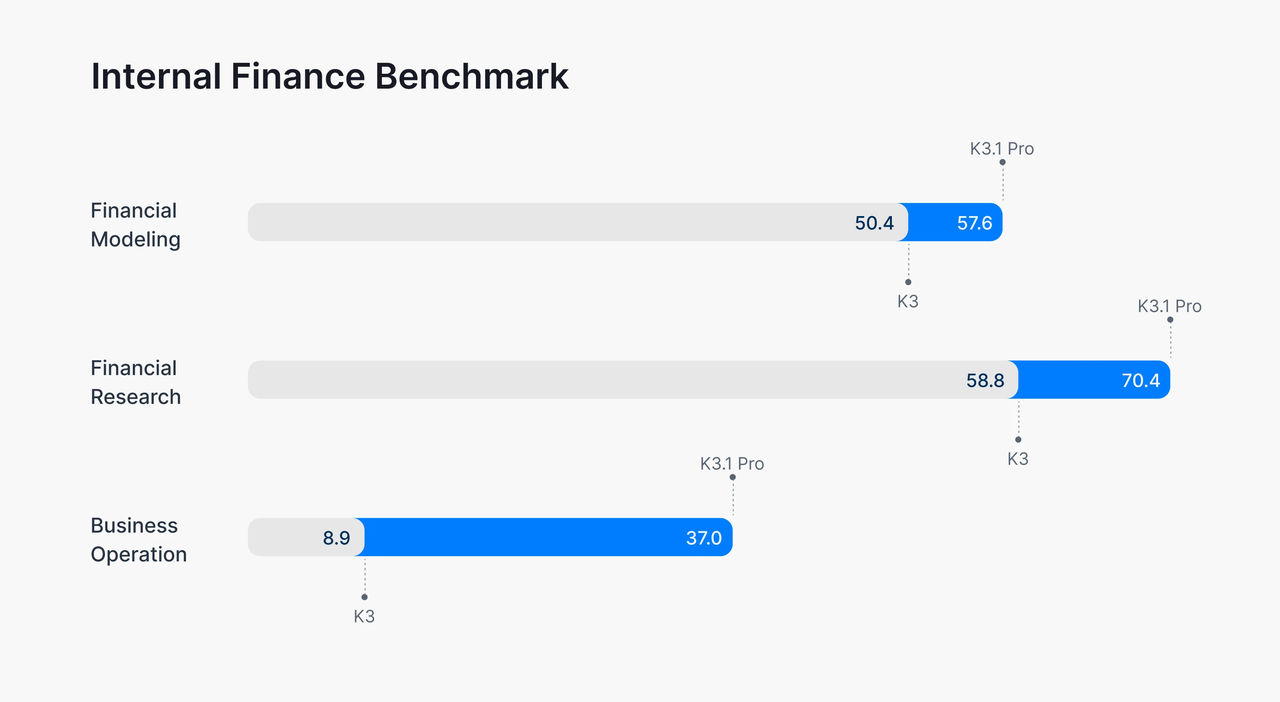
Moonshots interne finansresultater dekker finansiell modellering, forskning og simulerte forretningsoperasjoner. Disse leverandørrapporterte oppgavescorene er ikke mål på investeringsavkastning. Innstillinger per oppgave bør ikke antas å være identiske med ikke-relaterte benchmarker.
I Moonshots interne tester øker Financial Modeling fra 50.4 til 57.6, en gevinst på 7.2 poeng, og Financial Research stiger fra 58.8 til 70.4, en gevinst på 11.6 poeng. Business Operation øker fra 8.9 til 37.0, omtrent 4.2 ganger K3-scoren.
Denne benchmarken evaluerer langhorisont-ledelse og beslutningstaking i et simulert forretningsmiljø. Den er derfor nærmere agentisk planlegging enn enkel finansiell spørsmål/svar.
Financial Research måler evnen til å produsere evidensbasert forskning samtidig som kildekrav og informasjonsavgrensninger respekteres. Financial Modeling fokuserer på matematiske relasjoner, regnearklogikk og arbeidsbok-kvalitet.
Mønsteret antyder at K3.1 Pro er særlig verdifull når finansoppgaver krever vedvarende resonnering, verifisering og strukturerte leveranser.
For investorer, analytikere og forretningsbrukere er den praktiske fordelen potensielt bedre håndtering av arbeidsflyter med flere dokumenter. Ingen av modellene bør brukes som uomtvistelig autoritet for finansielle beslutninger.
Langkontekst-resonnering og faktuell pålitelighet
AA-LCR langkontekst-resultatene viser imidlertid at K3 ligger litt foran. Dette er en nyttig påminnelse om at en nyere modell kan forbedres betydelig totalt sett uten å vinne hver spesialiserte oppgave.
De rapporterte evalueringene viser færre faktuelle feil på sine respektive testsett.
På Kimi Hallu Bench Hard med verktøy rapporterer Moonshot at feilraten på påstandsnivå falt fra 23.4 % for K3 til 8.3 % for K3.1 Pro.
Det er omtrent en relativ reduksjon på 65 % på Moonshots bevisst vanskelige stresstest, snarere enn et estimat av daglige feilrater. Separat rapporterer Artificial Analysis en nedgang i AA-Omniscience hallusinasjonsrate fra 53 % til 44 %. De to evalueringene bruker ulike metoder, så prosentene er ikke direkte sammenlignbare.
Den praktiske lærdommen er at K3.1 Pro ser ut til å være mer pålitelig på de evaluerte oppgavene, men faktuelle forbedringer eliminerer ikke behovet for retrieval, sitater, kontroll av beregninger og menneskelig gjennomgang i konsekvensielle arbeidsflyter.
Dataanalyse: Evidens fra Plotlys evaluering
Plotly evaluerte standard K3.1 Pro via OpenRouter ved å bruke en privat test med 43 spørsmål over et syntetisk vindenergi-datalager. Highspeed ble ikke testet. Resultatene illustrerer avveiningen mellom svarkvalitet, fullføringstid og kostnad i den spesifikke SQL-baserte analytiske arbeidsflyten.
Plotly dataanalytikk-mål
Kimi K3
Kimi K3.1 Pro
Riktige svar
35/43
42/43
Nøyaktighet
81.4%
97.7%
Skjulte mønstre oppdaget
0/5
5/5
Identifiserte datakvalitetsproblemer
1/3
3/3
Full evalueringskostnad
$5.01
$13.47
Median tid per spørsmål
43 sek
2.5 minutter
I denne evalueringen besvarte K3.1 Pro flere spørsmål korrekt og identifiserte flere skjulte mønstre og datakvalitetsproblemer, men pådro høyere kostnader og lengre median fullføringstid.
De rapporterte gebyrene er observerte evalueringskostnader, ikke estimater beregnet fra Moonshots standard API-priser. Oppsettet som er publisert fastslår ikke at alle leverandørinnstillinger var identiske mellom de to modellkjøringene, så forskjellene kan ikke tilskrives modellen alene.
Disse resultatene støtter å evaluere K3.1 Pro for analytiske oppgaver der ekstra funn kan rettferdiggjøre mer tid og forbruk. De fastslår ikke den samme nøyaktigheten eller kostnads advantag
Er Kimi K3.1 Pro raskere enn Kimi K3?
Skill mellom gjennomstrømning av utgående token og ende-til-ende oppgavelatens.
Artificial Analysis rapporterer 73.5 utgående tokens per sekund for K3.1 Pro, sammenlignet med 38.5 for K3 ved maksimal resonneringsinnsats, via Kimis API. Dette er målinger av token-generering, sjekket 24. oktober 2026; total oppgavelatens avhenger også av resonnementslengde og verktøykjøring.
Raskere tokengenerering garanterer imidlertid ikke raskere oppgavefullføring.
Moonshot tilbyr også K3.1 Pro Highspeed, som markedsføres som å levere omtrent to til tre ganger raskere utdata enn standardvarianten. Dette er en forbedring i serving-hastighet, ikke en separat verifisert intelligensoppgradering.
K3.1 Pro har høyere rapportert gjennomstrømning for utgående token, men fullfører ikke nødvendigvis oppgaver raskere. Skill hastigheten på generering av token fra tiden som kreves for å resonere, kalle verktøy og fullføre jobben.
Utdatahastighet vs. oppgavefullføringstid
Artificial Analysis rapporterer utdatahastigheter på 73.5 tokens per sekund for K3.1 Pro og 38.5 for K3 ved maksimal resonneringsinnsats, via Kimis API. Disse målingene ble sjekket 24. oktober 2026 og beskriver gjennomstrømning for tokengenerering snarere enn ende-til-ende oppgavelatens.
En modell kan generere token raskere samtidig som den bruker lengre tid totalt hvis den produserer flere resonnementstoken eller utfører flere verktøykall. I Plotly-evalueringen diskutert ovenfor var K3.1 Pros median fullføringstid 2.5 minutter per spørsmål, sammenlignet med 43 sekunder for K3, samtidig med høyere nøyaktighet.
For interaktive applikasjoner, mål tid til første token og total oppgavefullføringstid på den faktiske leverandørruten. Gjennomstrømning alene er ikke nok til å forutsi responsivitet.
Vurder K3.1 Pro Highspeed
Moonshot markedsfører K3.1 Pro Highspeed som å levere omtrent to til tre ganger utdatahastigheten til standard K3.1 Pro. Det kravet gjelder serving-hastighet; det bør ikke tolkes som en to–tre ganger reduksjon i total oppgavefullføringstid.
Vurder Highspeed for interaktiv koding eller assistenter der brukere venter på svar. Sammenlign ende-til-ende latens, oppgavesuksess og total fakturert kostnad mot standard endepunkt før du velger det. Highspeed har høyere ordinære inn- og utdata-tokensatser, mens cachet inndata har samme sats.
Kimi K3.1 Pro vs Kimi K3: Kostnad
Offisielle API- og CometAPI-satser
Standard K3.1 Pros offisielle inn-, ut- og cache-treff-satser er en tredjedel lavere enn K3s. De oppførte CometAPI-inn- og utdata-satsene er ytterligere 20 % under de tilsvarende offisielle satsene.
Modell
Offisiell inn / 1M
Offisiell ut / 1M
Offisiell cachet inn / 1M
CometAPI inn / 1M
CometAPI ut / 1M
Kimi K3.1 Pro
$2.00
$10.00
$0.20
$1.60
$8.00
Kimi K3
$3.00
$15.00
$0.30
$2.40
$12.00
Kimi K3.1 Pro Highspeed
$4.00
$20.00
$0.20
Sjekk gjeldende pris
Sjekk gjeldende pris
USD per million tokens; satser sjekket 24. oktober 2026. Kolonner for inndata viser ordinære ukachet inndata-satser. Skatter og separat fakturerte gebyrer er ekskludert.
Offisiell Kimi-prising lister også cache-skrivekostnader: $2/$4 per million tokens for standard Pro med 5-minutters/1-times retention, og $4/$8 for Highspeed. Cache-treff, cache-skriving og ordinær inndata er separate, gjensidig utelukkende faktureringskategorier.
Offisiell Kimi og CometAPI er separate leverandørruter. Bekreft gjeldende priser og cache-støtte for valgt rute, inkludert Highspeed-tilgjengelighet. Sammenlign total fakturert oppgavekostnad så vel som token-satser.
Eksempel på faste token-kostnader
Tenk på en arbeidsbelastning som bruker 100,000 ukachede inndata-token og 20,000 utdata-token.
For denne faste arbeidsmengden er den offisielle API-kostnaden $0.60 med K3 og $0.40 med K3.1 Pro. Med de oppførte CometAPI-satsene koster samme tokenmengder henholdsvis $0.48 og $0.32. Disse totalene inkluderer kun de oppgitte inn- og utdata-tokenene.
Men dette er en sammenligning med faste token. Komplekse agent-arbeidsflyter kan bruke ulike mengder resonnementstoken og verktøykall avhengig av modellen.
Token-besparelser forsvinner
La I være identisk ukachet inndata-token-antall, O være Kimi K3s fakturerte utdata-token-antall, og P være Kimi K3.1 Pros fakturerte utdata-token-antall, alle målt i millioner. Til de standard offisielle satsene i pristabellen er gebyrene 3I + 15O og 2I + 10P dollar. De er like når P = 1.5O + 0.1I.
For utdata-tunge forespørsler kan K3.1 Pro derfor bruke omtrent 50 % flere fakturerte utdata-token før den mister prisfordelen. Denne beregningen forutsetter uendrede satser og ekskluderer caching, verktøygebyrer og annen separat fakturert bruk. Bruk faktiske fakturerte token-kategorier snarere enn synlig svarlengde.
Kostnad per vellykket fullført oppgave
Beregn kostnad per vellykket oppgave som total fakturert kostnad for alle evalueringsforsøk delt på antallet unike oppgaver som oppfyller et forhåndsdefinert akseptkriterium. Inkluder kostnader fra mislykkede forsøk, retrier og timeouts når leverandøren fakturerer dem; å dele kun kostnaden for vellykkede kjøringer på antallet kan undervurdere kostnad per vellykket oppgave.
Hold oppgavesett, akseptkriterier, retry-grense og timeout-policy identisk mellom Kimi K3 og K3.1 Pro. Rapporter suksessrate sammen med kostnad per suksess slik at fjerning av vanskelige oppgaver ikke kan få en modell til å fremstå kunstig økonomisk. Hvis ingen oppgave lykkes, er kostnad per suksess udefinert, ikke null.
Kimi K3.1 Pro vs Kimi K3: Sammenligning og valg
For de fleste hostede agentiske arbeidsbelastninger er K3.1 Pro et sterkere utgangspunkt. Likevel bør beslutningen gjenspeile oppgavekompleksitet og distribusjonskrav.
Bruksområde
Anbefalt modell
Begrunnelse
Autonom koding
Kimi K3.1 Pro
Evaluer endringer på tvers av flere filer, terminalarbeid, debugging og endelige testutfall.
Finansiell forskning med flere dokumenter
Kimi K3.1 Pro
Forbedrede forsknings- og forretningsdrifts-benchmarker
Sammenlign rutine-tekst og enkel koding i begge modeller; ekstra resonnering kan øke latens uten å forbedre et akseptabelt resultat.
Langkontekst-hentingsnøyaktighet
Benchmark begge
K3 ligger litt foran på AA-LCR
Umiddelbar egenhosting
Kimi K3
Nedlastbare vekter allerede tilgjengelige
Interaktive høy-kapasitets agenter
K3.1 Pro Highspeed
Raskere serving, underlagt kostnadsvalidering
Kostnadssensitive produksjonsarbeidsflyter
Benchmark begge
Lavere tokenpriser betyr ikke nødvendigvis lavere oppgavekostnad
Hosted automasjon og profesjonelle arbeidsflyter
For hostede kodeagenter og analytiske arbeidsflyter, evaluer K3.1 Pro på de vanskelige delene av den faktiske jobben: endringer på tvers av flere filer, innsamling av kilder, kontroll av beregninger og gjenoppretting etter mislykket verktøykall. Foretrekk målbare reduksjoner i mislykkede oppgaver eller korrigeringsarbeid fremfor en høyere overskriftsscore alene.
For etablerte K3-applikasjoner, behold eksisterende rute som sammenligningsbaseline. Rutineoppgaver kan allerede møte akseptterskelen, mens spesialiserte langkontekst-oppgaver kan oppføre seg annerledes enn samlede benchmarker. Prioriter de arbeidssegmentene der en oppgradering har en målbar fordel.
Egenhosting og distribusjonsbegrensninger
Per 24. oktober 2026 er K3s fulle vekter tilgjengelige for distribusjon under modellens lisens og maskinvarekrav. K3.1 Pros fulle vekter er ennå ikke publisert.
Moonshot planlegger å slippe K3.1 Pro-vekter innen 4. november 2026. Dette er en annonsert utgivelsesplan, ikke en tilgjengelig sjekkpunkt; bekreft publiserte vekter og gjeldende vilkår før du planlegger egenhosting.
Kriterier for produksjonsevaluering
Sammenlign K3 og K3.1 Pro på representative oppgaver med samme promter, verktøy, akseptkriterier, retry-grenser og tidsavbrudd. Registrer leverandør- og resonneringsinnstillinger, og bevar komplette assistentmeldinger som krevd av API-et.
Mål oppgavesuksess, latens, tokenbruk og kostnad per vellykket oppgave, inkludert fakturerte feil og retrier. Gjennomgå saker der K3 lykkes men K3.1 Pro feiler. For menneskelig evaluering, skjul modelletiketter og randomiser rekkefølgen på utdata.
Hvis K3.1 Pro møter dine terskler for kvalitet, latens og kostnad, rull den gradvis ut med en testet K3-tilbakefall.
Kontrollert migrering og tilbakefall
En praktisk tilnærming er å starte med en liten andel av produksjonstrafikken på K3.1 Pro.
Hold K3 tilgjengelig som tilbakefall under validering. Sammenlign oppgavekvalitet, latens, feilrater og forbruk før du øker bruken av K3.1 Pro.
Vær særlig oppmerksom på verktøykall-skjemaer, resonnement-relaterte meldingsfelt, multimodale inndata og parsing av utdata. API-kompatibilitet garanterer ikke automatisk identisk applikasjonsatferd.
Benchmark-gevinster og regresjoner
Hvis begge modellene besvarte de samme 43 spørsmålene og scoret 35 og 42, kan K3.1 Pro ha korrigert sju K3-feil uten regresjoner, eller åtte feil mens den mistet ett tidligere korrekt svar. Totalscoren alene kan ikke skille disse utfallene.
Undersøk parede svar og klassifiser dem som begge korrekte, kun K3 korrekt, kun K3.1 Pro korrekt, eller begge feil. Gjennomgå K3-only-suksesser opp mot dine mest påvirkningsfulle oppgaver før migrering. 42/43-resultatet beskriver det testsettet; det garanterer ikke 97.7 % suksessrate på en annen arbeidslast.
Blind evaluering av modellutdata
Skjul modellemerker og randomiser rekkefølgen anmelderne ser utdata i. Definer akseptrubrikken før gjennomgang: for kode, bruk kjørbare tester og regresjonssjekker; for forskning, sjekk kildeunderbygging, beregninger og om etterspurt leveranse er komplett. Score korrekthet før du vurderer presentasjon eller skrivestil.
Avdekk modellidentitet, latens og fakturert kostnad først etter at kvalitetsvurderingen er registrert. Dette skiller utdatakvalitet fra forventninger om den nyere modellen. Løs anmelderuenighet opp mot de samme testene eller kildematerialet, og behold beslutningene slik at en senere modell- eller promptendring kan evalueres konsistent.
Hvor kan du få tilgang til Kimi K3.1 Pro og Kimi K3?
Offisiell tilgang via leverandør
Bruk Moonshots dokumenterte Kimi K3 API eller Kimi K3.1 Pro API for direkte integrasjon mot leverandøren. Sjekk valgt endepunkts modellidentifikator, støttede forespørselsfelt og kontobegrensninger. Offentlig API-tilgang og nedlastbare modellvekter er separate distribusjonsalternativer.
Tilgang via CometAPI
Utviklere kan få tilgang til Kimi K3.1 Pro API og Kimi K3 API via CometAPIs enhetlige grensesnitt og sammenligne begge ruter med samme applikasjonsarbeidslast.
Dette gjør K3-til-K3.1 Pro-migrering relativt rett frem, særlig for applikasjoner som allerede bruker et OpenAI-kompatibelt chatgrensesnitt.
For å bruke CometAPI, opprett en konto og API-nøkkel, og konfigurer deretter applikasjonen med endepunkt og modellidentifikator i integrasjonsdokumentasjonen. Velg kimi-k3 for K3, kimi-k3.1-pro for standard K3.1 Pro, eller kimi-k3.1-pro-highspeed for Highspeed-ruten der den støttes. Start med en liten forespørsel, og sammenlign deretter samme arbeidslast på tvers av modeller mens du sjekker returnerte resultater, latens og fakturert bruk.
Konklusjon
Kimi K3.1 Pro er den sterkere kandidaten for krevende autonom koding, finansiell forskning og utvidede agent-arbeidsflyter i evalueringene gjennomgått her. Kimi K3 er fortsatt relevant for umiddelbar egenhosting og arbeidslaster der eksisterende nøyaktighet eller latenprofil allerede møter kravene.
Velg ved hjelp av representative oppgaver og den faktiske leverandørruten. Sammenlign vellykkede utfall, latens og totalforbruk, og migrer deretter gradvis. Lavere tokenpriser og høyere samlede benchmark-scorer er nyttige startpunkt, men de etablerer ikke den beste konfigurasjonen for hver applikasjon.