Bygg med CometAPITrenger du ett API for flere modeller?Test arbeidsflyten i Playground, og opprett deretter en API-nøkkel når modellen og kostnaden passer bruksområdet ditt.
Gemini 4 Carbon er Google DeepMind sin frontier-modell for krevende ingeniørarbeid og defensiv cybersikkerhet. Kunngjort 28. oktober 2026, den forbedrer Argon i publiserte evalueringer for koding, sikkerhet og lang kontekst. Introduksjonsprisene er $2 per million input-tokens og $10 per million output-tokens, men tilgangen er i starten begrenset til utvalgte cyberforsvarere og betrodde partnere. For utviklere er muligheten sterkere autonomt arbeid; den umiddelbare begrensningen er tilgang.
Key Takeaways
Gemini 4 Carbon er Googles neste frontier-modell etter Argon, optimalisert for vedvarende, fler-dagers agentbasert ingeniørarbeid og cybersikkerhetsforsvar.
Gemini 4 Carbon rangerer #1 på Artificial Analysis Intelligence Index v5.0 (score 59), foran Claude Opus 5.5 (58) og GPT-6 Astra (57). Sterke løft innen koding, fullstack webutvikling (+89 Elo på WebDev Arena til #4), vitenskapelig resonnering, multimodal forståelse og tilpasning (0,0 % suksess på Gray Swan Indirect Prompt Injection Benchmark).
Gjennomgått for klarhet, kildeangivelse og gjeldende API-terminologi.
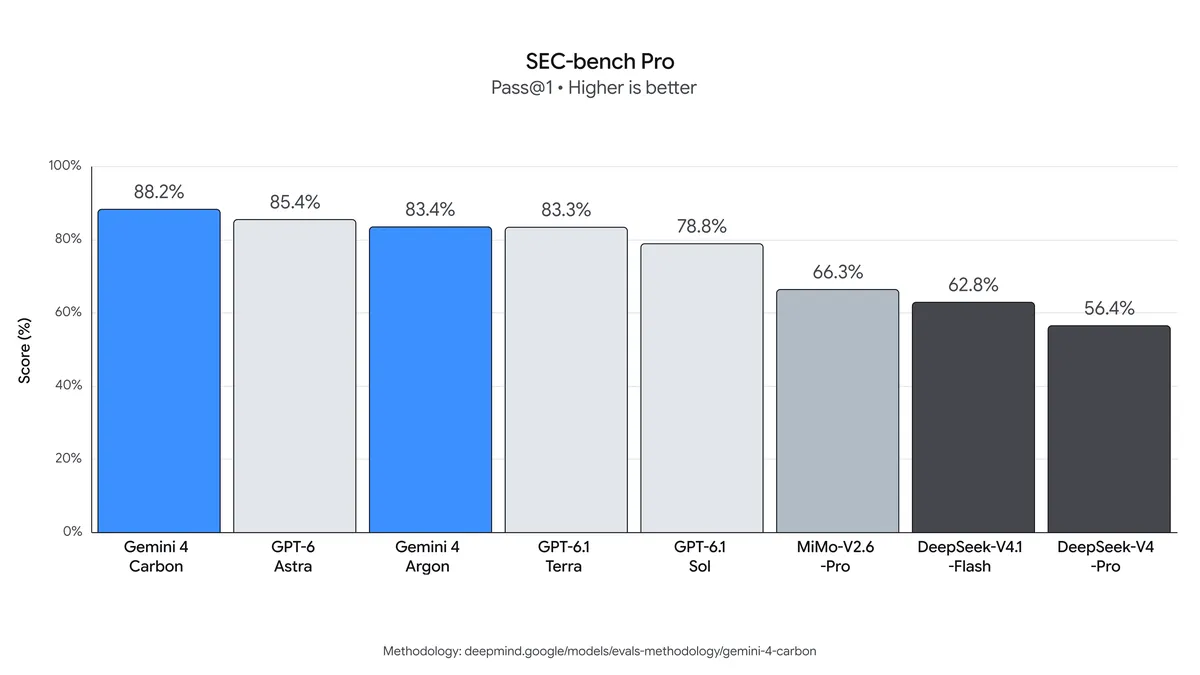
Fremragende cybersikkerhetsresultater (uten guardrails): 88,2 % på SEC-bench Pro (finne sårbarheter), 54,8 % på ExploitGym (utnyttelse) og 71,0 % på CWE-bench (patching).
Begrenset innledende tilgang via Fairwind Program for cyberforsvarere; offentlig API og bredere utrulling kommer senere.
Samme introduksjonspriser som Argon; etter introduksjonsperioden gjelder standardpriser.
Plattformar som CometAPI støtter allerede den bredere Gemini-familien (inkludert Argon) via et samlet OpenAI-kompatibelt API, noe som gjør det enkelt å bytte modeller og forberede seg på Carbons bredere lansering. Offentlige API-detaljer og en bred lanseringsdato er ikke kunngjort per 29. oktober 2026.
What Is Gemini 4 Carbon?
Gemini 4 Carbon er Googles nyeste flaggskip-frontier AI-modell, designet for å håndtere kompleks programvareutvikling, cybersikkerhetsforskning og autonome arbeidsflyter.
Ifølge den offisielle kunngjøringen bygger Carbon på fundamentet fra Gemini 4 Argon, med betydelige forbedringer innen koding, agentbasert resonnering og sikkerhetsfokuserte oppgaver.
Carbon er designet for arbeid som involverer undersøkelse, utførelse og verifikasjon over flere steg. En defensiv ingeniøragent kan inspisere et repository, validere en mistenkt sårbarhet i et isolert miljø, utvikle en patch og teste om endringen adresserer den opprinnelige feilen.
Google rapporterer at interne team har observert at Carbon arbeider gjennom komplekse ingeniøroppgaver over flere dager. Dette er interne observasjoner, ikke en publisert garanti for en bestemt autonom kjøretid. Google har ikke utgitt en full teknisk rapport, parameterantall eller detaljer om arkitektur. Kontekstvindu og output-begrensninger forventes å være lik eller forbedret i forhold til Argon (rapportert i området for flere millioner tokens med høy output-kapasitet), og den støtter multimodale input inkludert tekst, bilder, video, lyd og PDF-er.
What Are the Key Features of Gemini 4 Carbon?
Long-Horizon Software Engineering
Carbon er designet for ingeniørproblemer som ikke kan fullføres pålitelig i ett enkelt resonnementssteg.
Eksempler inkluderer rotårsaksanalyse i store repositories, avhengighetsrelaterte feil, lavnivå systemdebugging og kompleks refaktorering.
Forbedringene retter seg mot evnen til å fortsette å arbeide etter et mislykket forsøk.
En effektiv kodeagent må gjenkjenne når den første løsningen mislykkes, inspisere nye bevis og revidere tilnærmingen uten å drive bort fra den opprinnelige oppgaven.
Defensive Cybersecurity Workflows
Carbons sikkerhetsresultater spenner over å finne sårbarheter, validere utnyttbarhet og patching av feil. Det nyttige spørsmålet for et sikkerhetsteam er om en agent kan gå fra et mistenkt problem til et reproduserbart funn og en testet fiks, samtidig som den respekterer tillatelsene og miljøet den er tildelt.
Long-Context and Multimodal Understanding
Carbon registrerer en GraphWalks BFS F1-score på 96,2 % i 256K–1M-token-deldelen, opp fra Argons 84,2 %. Dette er bevis på langkontekst grafresonnering, snarere enn en garanti for korrekt gjenfinning fra et hvilket som helst dokument på en million tokens.
De publiserte Chartography- og Blueprint-Bench 2-resultatene dekker også visuell forståelse. Disse testene kan bidra til å identifisere lovende dokument- og diagramarbeidsflyter, men de fastslår ikke den komplette modalitetsskjemaet til et fremtidig offentlig API.
How Does Gemini 4 Carbon Perform on Benchmarks?
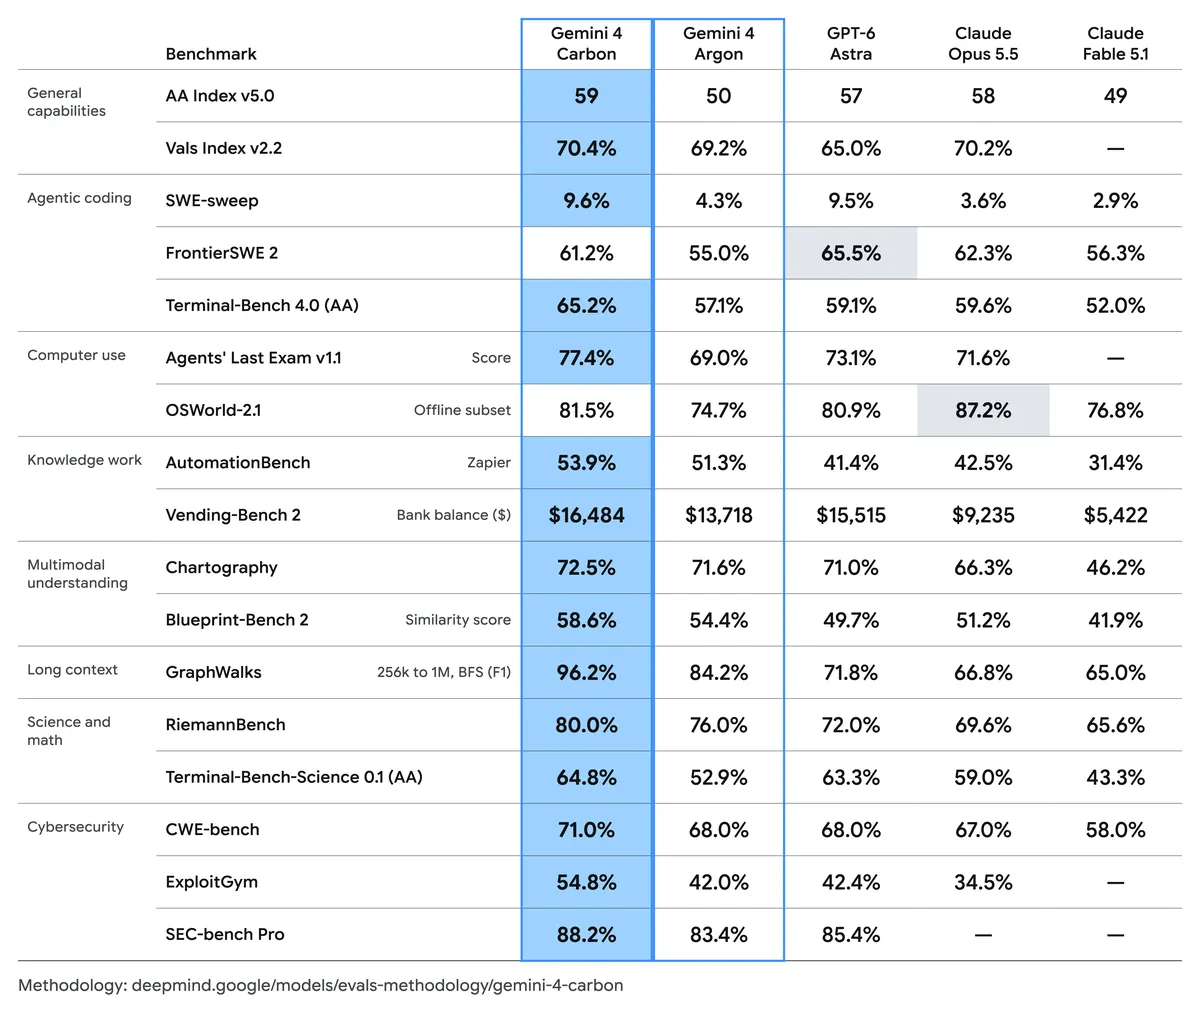
De publiserte resultatene fremhever tre grunner til å evaluere Carbon: sterkere kodeytelse, bedre langkontekstresonnering og forbedringer på tvers av cybersikkerhetsarbeidsflyten. Den offisielle kunngjøringen inkluderer det opprinnelige sammenligningsdiagrammet nedenfor; hovedresultatene oppsummeres i følgende seksjon.
Velg benchmarks som ligner din egen arbeidsmengde. En modell som leder en generell intelligensindeks kan likevel ligge etter en annen modell på en bestemt ingeniøroppgave.
Benchmark Results and Test Conditions
Overordnet resonnering: Carbon scorer 59 på AA Intelligence Index v5.0, sammenlignet med 50 for Argon, 57 for GPT-6 Astra og 58 for Claude Opus 5.5.
Koding: Terminal-Bench 4.0 øker fra 57,1 % til 65,2 %, en forbedring på 8,1 prosentpoeng over Argon. SWE-sweep øker fra 4,3 % til 9,6 %.
Langkontekstresonnering: Carbon scorer 96,2 % på GraphWalks 256K–1M-token BFS F1-deldelen, opp fra Argons 84,2 %.
Hvor alternativer leder: GPT-6 Astra scorer 65,5 % på FrontierSWE 2 mot Carbons 61,2 %; Claude Opus 5.5 scorer 87,2 % på OSWorld offline-deldelen mot Carbons 81,5 %. Disse sammenligningene refererer til modellene og evalueringsoppsettene i det publiserte diagrammet.
På tvers av de 17 utvalgte resultatene i den opprinnelige sammenligningen leder Carbon 15. Den bredden gjør den til en lovende kandidat for komplekse arbeidsflyter, men de to unntakene viser hvorfor din egen oppgave-miks betyr noe. Sammenlign modeller på aksepterte resultater, fullføringstid og kostnad i stedet for å gjennomsnittliggjøre ubeslektede benchmark-poeng.
Evalueringsmetodikken bruker generelt den høyeste tenkeinnstillingen og pass@1 med mindre annet er angitt. Den kombinerer Google-kjørte resultater med eksterne evaluatorer og leverandør-rapporterte poeng, så agent-rammeverk og resonnementbudsjetter er ikke identiske i hver oppføring.
GraphWalks: Den siterte delmengden bruker 200 problemer og rapporterer BFS F1.
Agents’ Last Exam: Evalueringen bruker et 122-oppgave v1.1-sett, ALE-Claw-harness, et femtimers vindu og aktiverte sikkerhetsfiltre.
OSWorld: Det rapporterte resultatet dekker en 82-oppgave offline-deldel og tar maksimum over tre enkeltforsøk.
Coding Performance in Practice
Carbon forbedrer Terminal-Bench 4.0 fra 57,1 % til 65,2 %, en økning på 8,1 prosentpoeng. SWE-sweep stiger fra 4,3 % til 9,6 %, mer enn en dobling av poengsummen, samtidig som den forblir under 10 % i absolutte termer. Disse resultatene støtter evaluering av vanskelig repository-arbeid, samtidig som de viser hvorfor uavhengige tester og gjennomgang fortsatt er nødvendige.
How Strong Is Gemini 4 Carbon at Cybersecurity?
Benchmark og sikkerhetsoppgave
Gemini 4 Carbon
Gemini 4 Argon
Forskjell
SEC-bench Pro — sårbarhetsfunn
88,2%
83,4%
+4,8 prosentpoeng
ExploitGym — utnyttelsesvalidering
54,8%
42,0%
+12,8 prosentpoeng
CWE-bench — sårbarhetsutbedring
71,0%
68,0%
+3,0 prosentpoeng
Den største økningen er i utnyttelsesvalidering. For et autorisert defensivt team kan reproduserbare bevis på at en sårbarhet er utnyttbar forbedre prioriteringen; et plausibelt funn alene er ikke nok. Patcher trenger fortsatt tester som bekrefter at den opprinnelige feilen er rettet og at eksisterende funksjonalitet bevares.
Google rapporterer de eksterne sikkerhetsevalueringene uten implementerte guardrails. SEC-bench Pro bruker en spesifikk 183-oppgave JavaScript-motor-deling; ExploitGym bruker et enkeltforsøk offline-oppsett med mitigeringer av. Disse betingelsene etablerer ikke ubegrenset produksjonsatferd eller en deteksjonsrate for vilkårlig programvare i den virkelige verden.
Is Gemini 4 Carbon Safer and More Reliable Than Argon?
Ikke-underbygde påstander ble redusert med omtrent 50 % relativt til Argon i interne tester.
Agent-overtramp ble redusert med 26 %.
Underlevering ble redusert med 29 %.
Varsler om høygradig feiljustering ble redusert med nesten 80 % i interne kode-miljøer.
Vellykket juks på Terminal-Bench 4.0 falt til 0,0 % i Googles evaluering.
På det evaluerte Gray Swan-indirekte prompt-injection-benchmarket er Carbons angrepssuksessrate 0,0 % versus Argons 0,7 %. Dette betyr at de evaluerte angrepene ikke lyktes under det oppsettet; det etablerer ikke immunitet mot nye angrep eller andre verktøymiljøer.
Disse tallene kommer fra ulike evalueringer og bør ikke kombineres til en enkelt pålitelighetsscore.
For en produksjonsagent bør du beholde uavhengige tillatelseskontroller, kjørelogger og validering av påståtte resultater. En modells forbedrede atferd hjelper, men applikasjonen må fortsatt kontrollere hvilke filer, tjenester og handlinger den kan få tilgang til.
How Much Does the Gemini 4 Carbon API Cost?
Google har kunngjort Carbons introduksjons- og etterfølgende token-satser. Tallene for bufrede input er nedenfor beregnet fra den kunngjorte 95 %-rabatten; implementeringen av offentlig API og kvalifikasjonsdetaljer gjenstår.
Fakturakategori, USD per 1M tokens
Introduksjonspris
Etterfølgende pris
Input-tokens
$2.00
$4.00
Output-tokens
$10.00
$20.00
Kvalifiserte bufrede input-tokens
$0.10
$0.20
Carbons introduksjonsperiode har ingen annonsert sluttdato. Argons publiserte introduksjonspriser slutter 30. november 2026; den fristen skal ikke anvendes på Carbon. Batch-priser, ekstra verktøygebyrer og en gratisnivå har ikke blitt annonsert for Carbon.
Example Request Cost
Anta at en forespørsel bruker 200,000 ubufrede input-tokens og 10,000 totale fakturerbare output-tokens. Med de kunngjorte introduksjonsprisene koster input $0.40 og output $0.10, for en total på $0.50. Den samme token-bruken ville koste $1.00 med de etterfølgende prisene.
Hvis alle 200,000 input-tokens kvalifiserer for den kunngjorte rabatt for bufret input, blir introduksjonsestimatet $0.12 inkludert output. Dette er en betinget illustrasjon, ikke et løfte om at hver gjentatt input kvalifiserer.
Output-kvoten må inkludere eventuelle tenke-tokens som faktureres som output under de endelige gjeldende reglene. Hvis 10,000 kun refererer til det synlige svaret, vil ytterligere fakturerbare tenke-tokens øke estimatet. Verktøy, nye forsøk og andre tjenester er utelatt.
How Can Developers Prepare for the Gemini 4 Carbon API?
Current Gemini 4 Carbon API Availability
Per 29. oktober 2026 starter tilgangen med utvalgte cybersikkerhetsforsvarere og utvides gradvis til betrodde partnere. Googles Fairwind Program beskriver en kontrollert tilgangsvei. En bred utviklerlansering og offentlig Carbon-modellidentifikator er ikke kunngjort.
Kunngjorte priser betyr derfor ikke at en applikasjon kan kalle et allment tilgjengelig Carbon-API i dag. Dets endelige offentlige kontektsgrense, maks output, modalitetsskjema, verktøykompatibilitet og operasjonelle grenser trenger fortsatt dokumenterte produksjonsspesifikasjoner.
Per 29. oktober 2026 har ikke Google lansert et allment tilgjengelig Carbon-API, så Carbon er ennå ikke tilgjengelig via CometAPI. Mens du venter, kan du bruke Gemini 4 Argon for en første evaluering. Sjekk CometAPI Carbon-siden for tilgjengelighet og leverandørpriser når tilgangen åpner.
Alternatives While You Wait for the Carbon API
Du kan begynne å evaluere kodearbeidsflyten din før Carbon blir bredt tilgjengelig. Bygg en baseline med en modell du kan få tilgang til i dag, og sammenlign Carbon på de samme oppgavene når API-et åpner. Tre alternativer å vurdere er Gemini 4 Argon, GPT-6.1 Astra og Claude Opus 5.5; bekreft nøyaktig modellnavn, tilgang og pris hos leverandøren før du velger.
Gemini 4 Argon: Start her hvis du allerede bruker Gemini eller vil ha en direkte baseline for Carbon. Prøv representative repository-endringer, kodereview og feilrettinger, og registrer hvilke output som passerer akseptansetester.
**GPT-6.1 Astra:** Inkluder den som en tverrleverandør-sammenligning for de samme ingeniøroppgavene. Mål aksepterte fiks, fullføringstid og totale kostnader. GPT-6 Astra-resultatene som ble diskutert tidligere gjelder den benchmarkede versjonen og bør ikke behandles som GPT-6.1 Astra-poeng.
**Claude Opus 5.5:** Legg den til som en annen kandidat for repository-analyse, refaktorering og review. Bruk de samme oppgavebeskrivelsene og valideringskriteriene slik at du kan sammenligne den praktiske verdien av hvert resultat.
Hold modellvalget konfigurerbart og lagre promptene, testene og resultatene fra hver kjøring. Det gir et nyttig utgangspunkt for å evaluere Carbon uten å binde arbeidsflyten din til et ukunngjort API-format.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Prepare a Model Evaluation Workflow
Et praktisk evalueringsrammeverk bør måle mer enn generell svarkvalitet.
For kode- og sikkerhetsarbeidsflyter er nyttige måleparametere:
Oppgavefullføringsrate: Hvor ofte tilfredsstiller agenten forhåndsdefinerte akseptansetester?
Patch-korrekthet: Adresserer det foreslåtte endringen den opprinnelige feilen uten å bryte eksisterende atferd?
Falsk-positiv-rate: Hvor ofte feiler et rapportert problem i validering?
Ende-til-ende-latens: Hvor lang tid tar hele arbeidsflyten, inkludert verktøykjøring?
Total oppgavekostnad: Hvor mye koster hvert aksepterte resultat etter nye forsøk og verktøybruk?
Instruksjonsetterlevelse: Holder agenten seg innenfor autoriserte filer, verktøy og handlinger?
Bruk et fast sett med reelle oppgaver og før opp hver modell, dens innstillinger, token-bruk og testresultater. Inkluder nye forsøk og manuelle korrigeringer i kostnaden. Når Carbon blir tilgjengelig, kjør den samme evalueringen for å se om den leverer mer akseptert arbeid for tiden og budsjettet ditt.
Conclusion
Gemini 4 Carbon er en lovende oppgradering for krevende koding, langkontekstresonnering og defensivt sikkerhetsarbeid. De publiserte resultatene viser klare gevinster over Argon, mens tilgangen fortsatt er begrenset per 29. oktober 2026. For nå, etabler en baseline med en tilgjengelig modell og hold integrasjonen fleksibel. Når Carbons offentlige API åpner, sammenlign kvaliteten på fullført arbeid, spart tid og totalkostnad før du avgjør om du skal bytte.
FAQ
Can Gemini 4 Carbon run without human supervision?
Rapporter om fler-dagers internt ingeniørarbeid etablerer ikke ubemannet pålitelighet for vilkårlige oppgaver. Et team som vurderer autonom kjøring bør definere tillatte handlinger, stoppbetingelser og akseptansetester, og deretter måle hvor ofte agenten fullfører arbeidet uten korrigering. Kjøretid alene viser ikke at agentens output er korrekt.
Can an existing Argon integration switch directly to Carbon?
Ikke basert på bevisene som er tilgjengelige her. Hold leverandørvalg konfigurerbart, men verifiser Carbons faktiske modellidentifikator, støttet skjema, verktøy, grenser og kontotilgang før du endrer en distribusjon. Gjenbruk av en prompt kan hjelpe med en kontrollert sammenligning; det beviser ikke API-kompatibilitet.
Which Gemini 4 Carbon tests matter for a private codebase?
Inkluder representative feil, repository-endringer og sikkerhetsfunn med kjente akseptansekriterier. Sjekk om patcher består relevante tester, om funn reproduseres, og om uvedkommende atferdsendringer oppstår. Inkluder mislykkede forsøk og manuell korreksjon i kostnadsanalysen slik at en sterk offentlig benchmark-score ikke skjuler operasjonelt arbeid.
Hva er Gemini 4 Carbon? Ytelsestester, funksjoner & priser - CometAPI