
TL;DR: Którą alternatywę dla API GPT-6 Astra wybrać?
Dobierz model do obciążenia: Claude Opus 5 jako najbliższy premium substytut, Claude Fable 5.1 do najtrudniejszego, długotrwałego rozumowania, GPT-5.6 Sol dla najmniej frakcyjnej migracji z OpenAI, Claude Sonnet 5 do produkcji na dużą skalę, Gemini 3.8 Flash do tanich zadań multimodalnych, a DeepSeek V4.1 Flash, gdy głównym ograniczeniem jest koszt tokenów.
Zachowaj GPT-6 Astra dla obciążeń, w których jego silniejsza obsługa komputera, autonomiczne wykonywanie, rozumowanie naukowe lub bezpieczeństwo cybernetyczne istotnie redukują ponowne próby i ingerencję człowieka.
Najważniejsze wnioski: Co ma znaczenie przy zastępowaniu GPT-6 Astra?
- GPT-6 Astra trudno zastąpić w jego najmocniejszych zadaniach agentowych. Oficjalna tabela benchmarków GPT-6 Astra odnotowuje 57,9% w Terminal-Bench 4.0, 97,6% w FrontierMath Tier 4 i 96,0% w GPQA Diamond.
- Claude Opus 5 to najbardziej zbalansowana bezpośrednia alternatywa do przetestowania jako pierwsza. Anthropic wycenia Opus 5 na $5/$25 za milion tokenów wejścia/wyjścia, czyli połowę bazowych stawek Astra.
- Claude Fable 5.1 nie jest budżetową alternatywą. Jego cennik $10/$50 za wejście/wyjście odpowiada stawkom Astra, a wybrane ewaluacje wiedzy i długohoryzontowego rozumowania faworyzują Fable 5.1.
- GPT-5.6 Sol to najłatwiejsze „obniżenie” zamiast prawdziwej zmiany platformy. Okno kontekstu 1,05M, maksymalne wyjście 128K i ceny $4/$20 zmniejszają tarcie migracji dla aplikacji OpenAI.
- Gemini 3.8 Flash oferuje korzystny stosunek ceny do wydajności w usłudze hostowanej. Jego stawka wprowadzająca na 2026 rok to $0.75/$3.75 za milion tokenów wejścia/wyjścia.
- DeepSeek V4 Flash jest w innej klasie kosztowej. Oficjalne stawki szczytowe i poza szczytem są znacznie poniżej cen modeli premium, ale niższy koszt tokenów nie gwarantuje równoważnych wskaźników sukcesu agentów.
- Najlepszą metryką produkcyjną jest zwykle koszt na zaakceptowane ukończone zadanie. Uwzględnij ponowne próby, awarie narzędzi, opóźnienia, zużycie tokenów wyjściowych i poprawki ręczne.
Czym jest API GPT-6 Astra?
OpenAI pozycjonuje GPT-6 Astra jako swój flagowy model do złożonej pracy end-to-end. Specyfikacja API obejmuje okno kontekstu 1 050 000 tokenów i maksymalne wyjście 128 000 tokenów, wejście tekstowe i obrazowe, wsparcie dla tokenów rozumowania oraz pięć ustawień poziomu wysiłku wnioskowania: low, medium, high, xhigh i max.
Astra różni się od konwencjonalnego chatbota, ponieważ jest zaprojektowana do długotrwałego wykonywania zadań. Oficjalny przegląd możliwości podkreśla obsługę komputera i pracę profesjonalną, a także inżynierię oprogramowania, przeglądanie, naukę, cyberbezpieczeństwo i złożone rozumowanie.
| Specyfikacja GPT-6 Astra | Wartość |
|---|---|
| Identyfikator modelu API | gpt-6-astra |
| Dostawca | OpenAI |
| Okno kontekstu | 1 050 000 tokenów |
| Maksymalna długość wyjścia | 128 000 tokenów |
| Wejście | Tekst, obrazy |
| Wyjście | Tekst |
| Data odcięcia wiedzy | 30 kwietnia 2026 |
| Poziom wysiłku wnioskowania | Low, medium, high, xhigh, max |
| Standardowa cena wejścia | $10 / 1M tokenów |
| Wejście z cache | $1 / 1M tokenów |
| Standardowa cena wyjścia | $50 / 1M tokenów |
| Próg długiego kontekstu | Powyżej 272K tokenów wejścia |
Uwaga dotycząca cen dla długich kontekstów:
żądania powyżej 272K tokenów wejścia
są przeliczane dla całego żądania na $20/M wejścia i $75/M wyjścia. Budżetuj te żądania osobno.
Dlaczego zespoły rozglądają się poza GPT-6 Astra
Astra jest najbardziej przekonująca, gdy jej dodatkowe możliwości eliminują nieudane próby, błędy narzędzi, ręczną interwencję lub powtarzane wywołania słabszych modeli. Jej cena premium jest trudniejsza do uzasadnienia przy streszczeniach, ekstrakcji, klasyfikacji, rutynowym RAG, zwykłej rozmowie i standardowym generowaniu kodu.
Zespoły zatem oceniają alternatywy, aby obniżyć koszty, pozostać w istniejącym ekosystemie dostawcy, poprawić ekonomię cache, dodać wsparcie multimodalne lub użyć szybszego modelu do ruchu rutynowego, rezerwując Astrę do eskalacji.
Porównanie benchmarków i ograniczenia
Uwaga dotycząca dowodów: tabela wykorzystuje opublikowane przez OpenAI ramy porównawcze, aby umieścić kilka alternatyw w wspólnej konfiguracji. Wyniki raportowane przez dostawców mogą się zmieniać wraz ze snapshotami modeli, promptami, narzędziami i metodologią ewaluacji; używaj ich do skrócenia listy kandydatów, a finalistów weryfikuj na reprezentatywnych zadaniach produkcyjnych.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 57.9% | 37.3% | 55.8% | 52.6% | 19.1% |
| DeepSWE v1.1 | 74.1% | 72.7% | 67.4% | 73.7% | 73.8% |
| FrontierCode 1.1 Extended | 64.5% | 60.6% | 63.6% | 63.6% | 56.3% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% | 95.3% |
| FrontierMath Tier 4 | 97.6% | 83.0% | 87.8% | 73.2% | — |
| Humanity’s Last Exam, with tools | 57.2% | — | 65.0% | 63.6% | — |
Wyniki pokazują, dlaczego nazywanie jakiegokolwiek modelu uniwersalnym „zamiennikiem Astry” jest mylące. Astra ma wyraźną przewagę w kilku ewaluacjach agentowych i naukowych, podczas gdy Fable 5.1 wypada lepiej na Humanity’s Last Exam, a kilka alternatyw pozostaje bardzo blisko w DeepSWE.
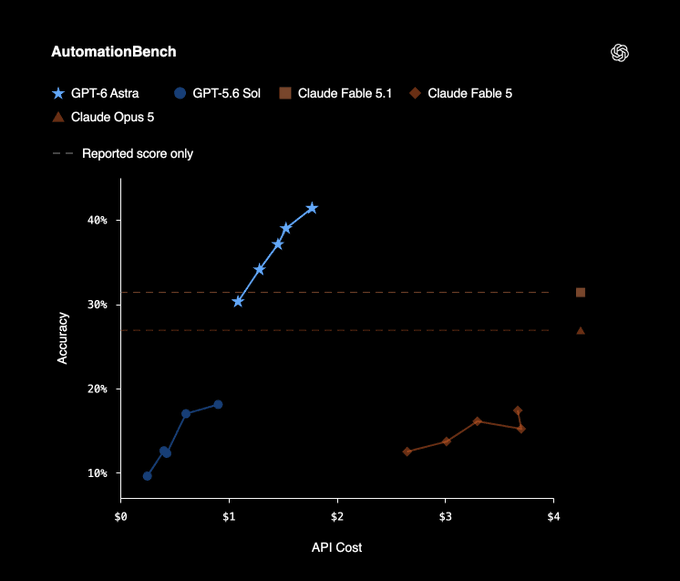
Oficjalna grafika benchmarku OpenAI AutomationBench.
Publiczne indeksy benchmarków również mogą się zmieniać wraz z rewizjami metodologii i snapshotów modeli. Wykorzystuj je do tworzenia shortlisty, a nie jako substytut ewaluacji specyficznej dla danego obciążenia.
Alternatywy dla GPT-6 Astra
Żaden pojedynczy model nie zastąpi Astry we wszystkich obciążeniach. Najbardziej praktyczny wybór zależy od potrzebnych możliwości, ekosystemu dostawcy, którego już używasz, oraz kosztu nieudanych lub powtarzanych uruchomień.
| Alternatywa | Oficjalna cena za 1M tokenów wejścia/wyjścia | Kontekst | Najlepszy powód, by wybrać |
|---|---|---|---|
| Claude Opus 5 | $5 / $25 | 1M | Najbliższy ogólny substytut premium |
| Claude Fable 5.1 | $10 / $50 | 1M | Najtrudniejsze rozumowanie i długotrwali agenci |
| GPT-5.6 Sol | $4 / $20 | 1.05M | Najmniej tarcia przy migracji z OpenAI |
| Claude Sonnet 5 | $2 / $10 | 1M | Produkcja na dużą skalę |
| Gemini 3.8 Flash | $0.75 / $3.75 promocyjnie | 1M | Tanie obciążenia multimodalne i wsadowe |
| DeepSeek V4.1 Flash | $0.22–$0.44 / $0.66–$1.32 | 1M | Najniższy koszt tokenów i przetwarzanie masowe |
Claude Opus 5
Dlaczego warto rozważyć
Claude Opus 5 to pierwsza alternatywa do przetestowania, gdy potrzebujesz premium rozumowania, kodowania lub pracy profesjonalnej w cenie niższej niż Astra.
Cena, kontekst i cache
Anthropic podaje dla Claude Opus 5 $5/M wejścia i $25/M wyjścia przy oknie kontekstu 1M tokenów. Potwierdź aktualne warunki cache przed budżetowaniem produkcji.
Gdzie sprawdza się dobrze
Jest konkurencyjny w kodowaniu, analizie, profesjonalnym pisaniu i przepływach agentowych; przytoczona tabela benchmarków plasuje go blisko Astry w DeepSWE i FrontierCode.
Ograniczenia
Nie przewyższa Astry w sposób konsekwentny. Astra pozostaje silniejszym kandydatem, gdy kluczowa jest obsługa komputera, zaawansowane autonomiczne wykonywanie, cyberbezpieczeństwo lub narzędzia natywne OpenAI.
Najlepsze do / Unikaj, gdy
Najlepsze do: premium agentów kodujących, złożonej analizy i profesjonalnego pisania. Unikaj, gdy: przepływ silnie zależy od narzędzi specyficznych dla Astry lub jej możliwości obsługi komputera.
Claude Fable 5.1
Dlaczego warto rozważyć
Claude Fable 5.1 to konkurencyjny flagowiec do najtrudniejszego rozumowania, badań, kodowania i długotrwałych zadań agentowych, a nie tani zamiennik.
Cena, kontekst i cache
Jego stawki $10/M wejścia i $50/M wyjścia odpowiadają nagłówkowym cenom Astry. Okno kontekstu 1M tokenów i cena odczytu z cache $0.25/M mogą poprawić ekonomikę przy częstym ponownym użyciu dużych promptów.
Gdzie sprawdza się dobrze
Szczególnie atrakcyjny do długotrwałego rozumowania i agentów intensywnie korzystających z cache; w przytoczonym porównaniu prowadzi nad Astrą na Humanity’s Last Exam z narzędziami.
Ograniczenia
Nie obniża nagłówkowej stawki za tokeny, a Astra zachowuje przewagi w kilku benchmarkach agentowych i naukowych oraz w narzędziach natywnych OpenAI.
Najlepsze do / Unikaj, gdy
Najlepsze do: maksymalnej jakości rozumowania i powtarzalnych przepływów z długim kontekstem. Unikaj, gdy: głównym celem jest duża redukcja standardowych cen tokenów.
GPT-5.6 Sol
Dlaczego warto rozważyć
GPT-5.6 Sol oferuje najmniej tarcia przy migracji dla aplikacji już opartych na zachowaniu i narzędziach kompatybilnych z OpenAI.
Cena, kontekst i cache
Wskazana specyfikacja modelu podaje $4/M wejścia i $20/M wyjścia, okno kontekstu 1,05M tokenów oraz maksymalne wyjście 128K. Zweryfikuj bieżące warunki cache’owania wejścia przed finalnym budżetowaniem.
Gdzie sprawdza się dobrze
Pozostaje blisko Astry w DeepSWE i GPQA Diamond, jednocześnie kosztując znacząco mniej w standardowym progu krótkiego kontekstu.
Ograniczenia
Różnica rośnie w zadaniach reprezentowanych przez Terminal-Bench i FrontierMath, więc oszczędności mogą zniknąć, jeśli słabsze ukończenie zadań generuje ponowne próby lub ręczne poprawki.
Najlepsze do / Unikaj, gdy
Najlepsze do: istniejących aplikacji OpenAI i ogólnych obciążeń, które nie potrzebują najmocniejszych możliwości agentowych Astry. Unikaj, gdy: przepływ wielokrotnie korzysta z dużych przewag Astry w benchmarkach.
Claude Sonnet 5
Dlaczego warto rozważyć
Claude Sonnet 5 to praktyczny domyślny model produkcyjny do kompetentnej, powtarzalnej pracy z wiedzą, która nie wymaga flagowego modelu z czołówki przy każdym żądaniu.
Cena, kontekst i cache
Jego stała stawka to $2/M wejścia i $10/M wyjścia przy oknie kontekstu 1M tokenów. Potwierdź bieżące warunki cache dla wdrożeń z dużym ponownym użyciem promptów.
Gdzie sprawdza się dobrze
Nadaje się do klasyfikacji zgłoszeń, ekstrakcji dokumentów, standardowego RAG, transformacji treści, wyjaśniania kodu, rutynowego wywoływania funkcji i ustrukturyzowanego generowania.
Ograniczenia
Nie zastąpi niezawodnie Astry w każdym długohoryzontowym lub czołowym problemie rozumowania.
Najlepsze do / Unikaj, gdy
Najlepsze do: ruchu produkcyjnego na dużą skalę i rutynowej automatyzacji biznesu. Unikaj, gdy: porażka w trudnym zadaniu agentowym jest droższa niż dopłata do flagowego modelu.
Gemini 3.8 Flash
Dlaczego warto rozważyć
Gemini 3.8 Flash łączy wejście multimodalne, duży kontekst i niski koszt hostowanego API dla dokumentów, mediów, kodowania i potoków wsadowych.
Cena, kontekst i cache
Wskazana stawka wprowadzająca to $0.75/M wejścia i $3.75/M wyjścia do 31 grudnia 2026, z oknem kontekstu 1M tokenów oraz rabatami na cache w okresie promocyjnym.
Gdzie sprawdza się dobrze
Dobrze nadaje się do ekstrakcji multimodalnej, PDF-ów, audio, wideo, obrazów, dużych kolekcji dokumentów, analizy wsadowej i kosztowo wrażliwych zadań kodowania.
Ograniczenia
Ceny promocyjne są ograniczone czasowo, a najtrudniejsze zadania autonomicznych agentów lub obsługi komputera nadal wymagają walidacji specyficznej dla danego obciążenia względem Astry.
Najlepsze do / Unikaj, gdy
Najlepsze do: taniego przetwarzania multimodalnego i wsadowego na dużą skalę. Unikaj, gdy: aplikacja wymaga najsilniejszego wykonania autonomicznego niezależnie od kosztu tokenów.
DeepSeek V4.1 Flash
Dlaczego warto rozważyć
DeepSeek V4.1 Flash to opcja stawiająca koszty na pierwszym miejscu dla wysokoprzepustowego rozumowania, kodowania, streszczeń, ekstrakcji, klasyfikacji i przetwarzania offline.
Cena, kontekst i cache
Wskazany harmonogram szczyt/poza szczytem podaje wejście z trafieniem w cache $0.007–$0.014/M, wejście bez trafienia $0.22–$0.44/M oraz wyjście $0.66–$1.32/M, z oknem kontekstu 1M tokenów. Przed publikacją ponownie sprawdź aktualną stronę cen V4.1.
Gdzie sprawdza się dobrze
Atrakcyjny, gdy koszt tokenów dominuje, a aplikacja może użyć routowania, walidacji lub offline’owych kontroli jakości do zarządzania zmiennością.
Ograniczenia
Znacznie niższa cena tokenów nie gwarantuje równoważnego sukcesu w zadaniach autonomicznych. Należy mierzyć niezawodność, zachowanie narzędzi, opóźnienia i wskaźnik akceptacji na docelowym obciążeniu.
Najlepsze do / Unikaj, gdy
Najlepsze do: przetwarzania na dużą skalę, wrażliwego na koszty, z walidacją. Unikaj, gdy: nieudane, wysokowartościowe uruchomienie autonomiczne przeważyłoby oszczędności na tokenach.
GPT-6 Astra vs alternatywy: Który model wygrywa w danej kategorii?
Zestawienie cen, architektury, kontekstu i dowodów z benchmarków daje bardziej użyteczną tabelę decyzji niż proste uszeregowanie modeli od pierwszego do szóstego.
| Kategoria | Najlepszy wybór | Dlaczego |
|---|---|---|
| Ogólna alternatywa dla Astry | Claude Opus 5 | Silna, bliska czołówce jakość za połowę ceny listowej Astry |
| Maksymalne rozumowanie | Claude Fable 5.1 | Flagowe rozumowanie i silna wydajność długohoryzontowa |
| Pozostanie w ekosystemie OpenAI | GPT-5.6 Sol | Podobny ekosystem API z 60% niższymi cenami tokenów |
| Produkcja na dużą skalę | Claude Sonnet 5 | Wysoka jakość przy $2/$10 |
| Multimodalny stosunek ceny do wydajności | Gemini 3.8 Flash | Kontekst 1M plus bardzo niskie ceny wprowadzające w 2026 |
| Najniższy koszt API | DeepSeek V4.1 Flash | $0.22–$0.44 za wejście i $0.66–$1.32 za wyjście |
| Agenci silnie wykorzystujący obsługę komputera | GPT-6 Astra | Jedno z najjaśniejszych wyróżników Astry |
| Naukowe i trudne zadania matematyczne | GPT-6 Astra | Bardzo silne wyniki w FrontierMath i zadaniach naukowych |
| Agenci długotrwali intensywnie korzystający z cache | Claude Fable 5.1 | Odczyty z cache po $0.25/M |
Najważniejszy wniosek jest taki, że GPT-6 Astra wciąż wygrywa w niektórych kategoriach. Artykuł o alternatywach nie powinien sugerować, że tańszy model zastępuje ją uniwersalnie. Astra staje się droga, gdy jest wdrożona wszędzie; nadal może być ekonomiczna, gdy jej wyższy wskaźnik ukończenia zadania zastępuje kilka prób słabszych modeli.
Ile realnie można zaoszczędzić, zastępując API GPT-6 Astra?
Rozważ obciążenie zużywające 1 milion niebuforowanych tokenów wejścia i 200 000 tokenów wyjścia. Pomijając rabaty cache, opłaty za narzędzia, ponowne próby, ceny wsadowe i dopłaty za bardzo długi kontekst:
| Model | Przybliżony koszt API |
|---|---|
| GPT-6 Astra | $20.00 |
| Claude Fable 5.1 | $20.00 |
| Claude Opus 5 | $10.00 |
| GPT-5.6 Sol | $8.00 |
| Claude Sonnet 5 | $4.00 |
| Stawka promocyjna Gemini 3.8 Flash | $1.50 |
| DeepSeek V4.1 Flash (poza szczytem) | $0.35 |
Podstawowe obliczenie to:
total_cost =
(input_tokens / 1,000,000 * input_rate)
+
(output_tokens / 1,000,000 * output_rate)
Ten prosty przykład pokazuje też, dlaczego cena tokenów nie może być jedyną metryką. Jeśli żądanie Astry za $20 powiedzie się za pierwszym razem, a model za $4 wymaga sześciu prób, wielokrotnych wywołań narzędzi i napraw ręcznych, to Astra była w rzeczywistości tańsza.
Lepsza metryka produkcyjna to:
cost_per_accepted_task =
total_model_and_tool_cost
/
number_of_tasks_accepted_without_rework
Śledź tę wartość wraz z opóźnieniem, sukcesem zadań, tempem ponownych prób, błędami wywołań narzędzi i odsetkiem eskalacji do człowieka.
Jak testować alternatywy GPT-6 Astra przez CometAPI?
Praktyczną zaletą warstwy API wielomodelowej jest to, że ewaluacja nie musi stać się projektem integracji z dostawcą. CometAPI udostępnia API GPT-6 Astra, GPT-5.6, Claude Fable 5.1, Claude Sonnet 5, Gemini 3.8 Flash i DeepSeek V4.1 Flash w jednym katalogu modeli.
Z klientem kompatybilnym z OpenAI model można uczynić konfigurowalnym zamiast zakodowanego „na sztywno”:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

model = "claude-fable-5-1"

response = client.chat.completions.create(
    model=model,
    messages=[
        {
            "role": "user",
            "content": "Review this migration plan and identify the three highest-risk assumptions.",
        }
    ],
)

print(response.choices[0].message.content)
Możesz uruchomić ten sam zestaw ewaluacyjny ponownie, używając identyfikatorów modeli takich jak:
gpt-6-astra
gpt-5.6
claude-fable-5-1
claude-sonnet-5
gemini-3.8-flash
deepseek-v4-flash
Jest to zazwyczaj bardziej pouczające niż wybór alternatywy wyłącznie z tabeli liderów benchmarków. Weź 100–500 reprezentatywnych promptów produkcyjnych i rejestruj sukces zadania, akceptację przez człowieka, ponowne próby, błędy narzędzi, łączne tokeny, opóźnienie i całkowity koszt API.
Czy zastąpić GPT-6 Astra jednym modelem, czy użyć routowania modeli?
Dla wielu aplikacji zastępowanie Astry jednym uniwersalnym modelem jest błędną optymalizacją. Bardziej efektywna architektura wygląda tak:
- Ruch rutynowy → Claude Sonnet 5, Gemini 3.8 Flash lub DeepSeek V4.1 Flash
- Trudne rozumowanie → Claude Opus 5 lub GPT-5.6 Sol
- Bardzo trudne zadania długohoryzontowe → Claude Fable 5.1 lub GPT-6 Astra
- Przepływy agentowe z obsługą komputera lub specyficzne dla Astry → GPT-6 Astra
To zamienia Astrę w model eskalacyjny, a nie model domyślny. Jeśli tylko 10% żądań naprawdę wymaga wydajności agenta z czołówki, kierowanie 100% ruchu przez Astrę oznacza płacenie jej premii za pozostałe 90%.
Którą alternatywę dla API GPT-6 Astra wybrać?
Wybierz Claude Opus 5, jeśli chcesz najbliższego ogólnego balansu jakości i ceny.
Wybierz Claude Fable 5.1, jeśli maksymalna jakość rozumowania jest ważniejsza niż obniżenie nagłówkowych stawek za tokeny.
Wybierz GPT-5.6 Sol, jeśli już korzystasz z OpenAI i chcesz najmniejszej zmiany integracyjnej.
Wybierz Claude Sonnet 5, jeśli większość Twojego ruchu produkcyjnego to kompetentna, lecz zwyczajna praca z wiedzą.
Wybierz Gemini 3.8 Flash, jeśli liczą się multimodalność, skala i niski koszt hostowanego API.
Wybierz DeepSeek V4.1 Flash, jeśli koszt tokenów jest dominującym ograniczeniem, a Twoje obciążenie może tolerować więcej ewaluacji i walidacji.
A wybierz GPT-6 Astra, gdy Twoja aplikacja rzeczywiście korzysta na silniejszej obsłudze komputera, trudnej autonomicznej pracy programistycznej, rozumowaniu naukowemu lub innych możliwościach agentowych.
Głównym błędem nie jest wybór „złego” modelu z czołówki. Jest nim płacenie cen modeli z czołówki za żądania, które nigdy takiego modelu nie potrzebowały.
FAQ
Jaka jest najlepsza ogólna alternatywa dla API GPT-6 Astra?
Claude Opus 5 to jeden z najsilniejszych uniwersalnych substytutów. Oferuje okno kontekstu 1M, mocne możliwości kodowania i agentów oraz ceny listowe $5/$25 — połowę standardowych stawek tokenów Astry.
Jaka jest najtańsza alternatywa dla GPT-6 Astra?
Wśród modeli omówionych tutaj, DeepSeek V4.1 Flash ma najniższe ceny tokenów u dostawcy. Jego obecna stawka poza szczytem to $0.22/M niebuforowanego wejścia i $0.66/M wyjścia. Nie należy jednak zakładać równoważnego sukcesu zadań autonomicznych tylko dlatego, że jest tańszy.
Czy Claude Fable 5.1 jest lepszy niż GPT-6 Astra?
Żaden model nie wygrywa w każdym obciążeniu. Porównanie OpenAI daje Astrze znaczące przewagi w FrontierMath Tier 4 i Terminal-Bench 4.0, podczas gdy Fable 5.1 uzyskuje wyższy wynik w Humanity’s Last Exam z narzędziami.
Czy GPT-5.6 Sol nadal warto używać po GPT-6 Astra?
Tak. Jego standardowe ceny API $4/$20 są znacząco poniżej $10/$50 Astry, przy zachowaniu okna kontekstu 1,05M. Może więc być lepszym domyślnym wyborem dla obciążeń, w których przewagi Astry nie poprawiają materialnie ukończenia zadań.
Czy Gemini 3.8 Flash wystarczy, by zastąpić GPT-6 Astra?
Dla niektórych zadań kodowania, multimodalnych, dokumentowych i wsadowych — tak. Jest dramatycznie tańszy i ma okno kontekstu 1M. Dla najtrudniejszych autonomicznych agentów i obsługi komputera Astra pozostaje silniejszym wyborem.
Czy GPT-6 Astra ma niekorzystne ceny dla bardzo długich promptów?
Tak. OpenAI stosuje wyższy próg cenowy, gdy wejście przekracza 272K tokenów, więc żądania z długim kontekstem należy budżetować osobno.
Czy porównywać modele według ceny tokenów czy wyników benchmarków?
Używaj obu tylko jako metryk wstępnego screeningu. Najważniejszą metryką produkcyjną jest zwykle koszt na zaakceptowane ukończone zadanie, uwzględniający tokeny rozumowania, ponowne próby, wywołania narzędzi, opóźnienia i poprawki ręczne.
Czy można używać kilku alternatyw GPT-6 Astra w jednej aplikacji?
Tak. W wielu aplikacjach routowanie modeli jest lepsze niż przypisywanie każdego żądania jednemu modelowi. Tani model może obsługiwać żądania rutynowe, podczas gdy silniejsze modele przejmują coraz trudniejsze eskalacje.