
TL;DR
Zacznij od GPT-6.1 Sol, jeśli już używasz narzędzi OpenAI Responses lub potrzebujesz jawnej drabinki poziomów wysiłku rozumowania; przetestuj Claude Sonnet 5.5 pod kątem dobrze zdefiniowanej iteracji kodu i profesjonalnych materiałów opartych na szablonach. To priorytety ewaluacji, a nie potwierdzony ranking jakości. Oba startują od $2/M wejścia i $10/M wyjścia oraz pobierają $0.10/M za bazowe odczyty z cache. Przy ok. 1M kontekstu i 128K standardowego maksymalnego wyjścia praktyczne różnice dotyczą integracji, zachowania w zadaniach, retencji cache oraz rozliczania długiego kontekstu, a nie rabatu na bazowe odczyty cache.
Kluczowy kompromis dotyczy zachowania w zadaniach i warunków rozliczeń. GPT-6.1 Sol używa pięciu poziomów wysiłku i wymaga Responses do wywoływania narzędzi; Sonnet 5.5 stosuje adaptacyjne myślenie. Powyżej 272K tokenów wejściowych GPT-6.1 Sol stosuje wyższe stawki do całego żądania. Źródła przejrzane tutaj nie ustanawiają zwycięzcy w dopasowanym teście wersja-do-wersji, więc wybierz model, który spełnia Twoje kryteria akceptacji przy najniższym całkowitym koszcie przepływu pracy.
Najważniejsze wnioski
- Równe ceny bazowe: oba modele pobierają $2/M wejścia, $10/M wyjścia i $0.10/M odczytów cache. Porównuj zapisy cache, retencję, progi dla długiego kontekstu i faktyczne rozliczone użycie.
- Kontekst jest zbliżony: 1.05M vs 1M tokenów; oba obsługują 128K standardowego maksymalnego wyjścia.
- Różnice w integracji: GPT-6.1 Sol wymaga Responses do wywoływania narzędzi i nie akceptuje none lub minimal; Sonnet 5.5 stosuje adaptacyjne myślenie i specyficzne ograniczenia narzędziowe modelu.
- Zachowaj wersyjność dowodów: wyniki GPT-6 Sol nie mogą być relabelowane jako wyniki GPT-6.1 Sol.
- Wybieraj po wykonanej pracy: mierz jakość, opóźnienie, ponowienia, zapisy i odczyty cache, opłaty za narzędzia oraz korektę ludzką.
GPT-6.1 Sol vs Claude Sonnet 5.5 w skrócie
| Czynnik decyzyjny / specyfikacja | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Dostawca | OpenAI | Anthropic |
| Data wydania | September 29, 2026 | September 28, 2026 |
| ID modelu | gpt-6.1-sol | claude-sonnet-5-5 |
| Kontekst / standardowe maksymalne wyjście | 1,050,000 / 128,000 tokenów | 1,000,000 / 128,000 tokenów |
| Wejście → wyjście | Tekst i obrazy → tekst | Tekst i obrazy → tekst |
| Sterowanie rozumowaniem | low, medium, high, xhigh, max; domyślnie medium | Adaptacyjne myślenie; domyślnie high na Claude Platform |
| Domyślny wysiłek | medium | high na Claude Platform |
| Data odcięcia wiedzy | April 30, 2026 | June 2026 |
| Oficjalne stawki bazowe wejście/wyjście na 1M tokenów | $2 / $10; standardowe żądania do 272K tokenów wejściowych | $2 / $10 |
| Oficjalne bazowe odczyty cache na 1M tokenów | $0.10 | $0.10 |
| Oficjalne bazowe zapisy cache na 1M tokenów | $2.50 | $2.50 przez 5 minut; $4.00 przez 1 godzinę |
| Rozliczanie długiego kontekstu | Powyżej 272K wejścia: $4 wejście, $0.20 odczyt cache, $5 zapis cache, $15 wyjście za 1M; dotyczy całego standardowego żądania | Brak równoważnej dopłaty podanej w cytowanym przeglądzie modelu |
| Główne przeznaczenie | Złożone kodowanie, użycie komputera i praca profesjonalna | Szybka iteracja kodu i profesjonalne przepływy pracy |
| Najpierw testuj, gdy | Już używasz narzędzi Responses lub potrzebujesz jawnej kontroli wysiłku | Twoja praca koncentruje się na kodzie, dokumentach, slajdach lub arkuszach |
| Granice dowodów i decyzji | Udokumentowane możliwości; brak tu ustalonego zwycięzcy w dopasowanym teście wersja-do-wersji | Opublikowane wyniki dla kodu i pracy wiedzowej; brak kontrolowanego zwycięstwa nad GPT-6.1 Sol |
Przegląd GPT-6.1 Sol
GPT-6.1 Sol to wydanie OpenAI z 29 września 2026 dla złożonego kodowania, użycia komputera i pracy profesjonalnej. OpenAI opisuje je jako near-Astra performance przy niższym koszcie (https://developers.openai.com/api/docs/models/gpt-6.1-sol); to pozycjonowanie należy zweryfikować na Twoich zadaniach. Duży kontekst i regulowany poziom rozumowania czynią je kandydatem dla agentów repozytoryjnych i wieloetapowych przepływów profesjonalnych.
Ograniczenia operacyjne są równie ważne jak pozycjonowanie: domyślny wysiłek to medium, najniższy to low, a wywoływanie narzędzi wymaga Responses. Przepływ oparty na ścieżce bez rozumowania lub narzędziach Chat Completions wymaga migracji, zanim model będzie używalny niezawodnie.
Przegląd Claude Sonnet 5.5
Claude Sonnet 5.5 to wydanie Anthropic z 28 września 2026 dla codziennego, dobrze zdefiniowanego kodowania, agentów i pracy profesjonalnej. Jego przegląd modelu (https://platform.claude.com/docs/en/models/sonnet-5-5/overview) dokumentuje adaptacyjne myślenie, wysoki domyślny wysiłek na Claude Platform, wejście tekst-obraz i 128K standardowego maksymalnego wyjścia. Anthropic podkreśla poprawę błędów, klarowne dokumenty, dopracowane slajdy i wydajną iterację.
Dla zespołu deweloperskiego czyni to Sonnet użytecznym kandydatem do powtarzalnej implementacji i cykli przeglądów. Dla biura oceń jakość pierwszego szkicu i zgodność z szablonami. Deklaracja szybkości dostawcy porównuje Sonnet 5.5 z Sonnet 5; nie ustanawia przewagi prędkości nad GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Wydajność
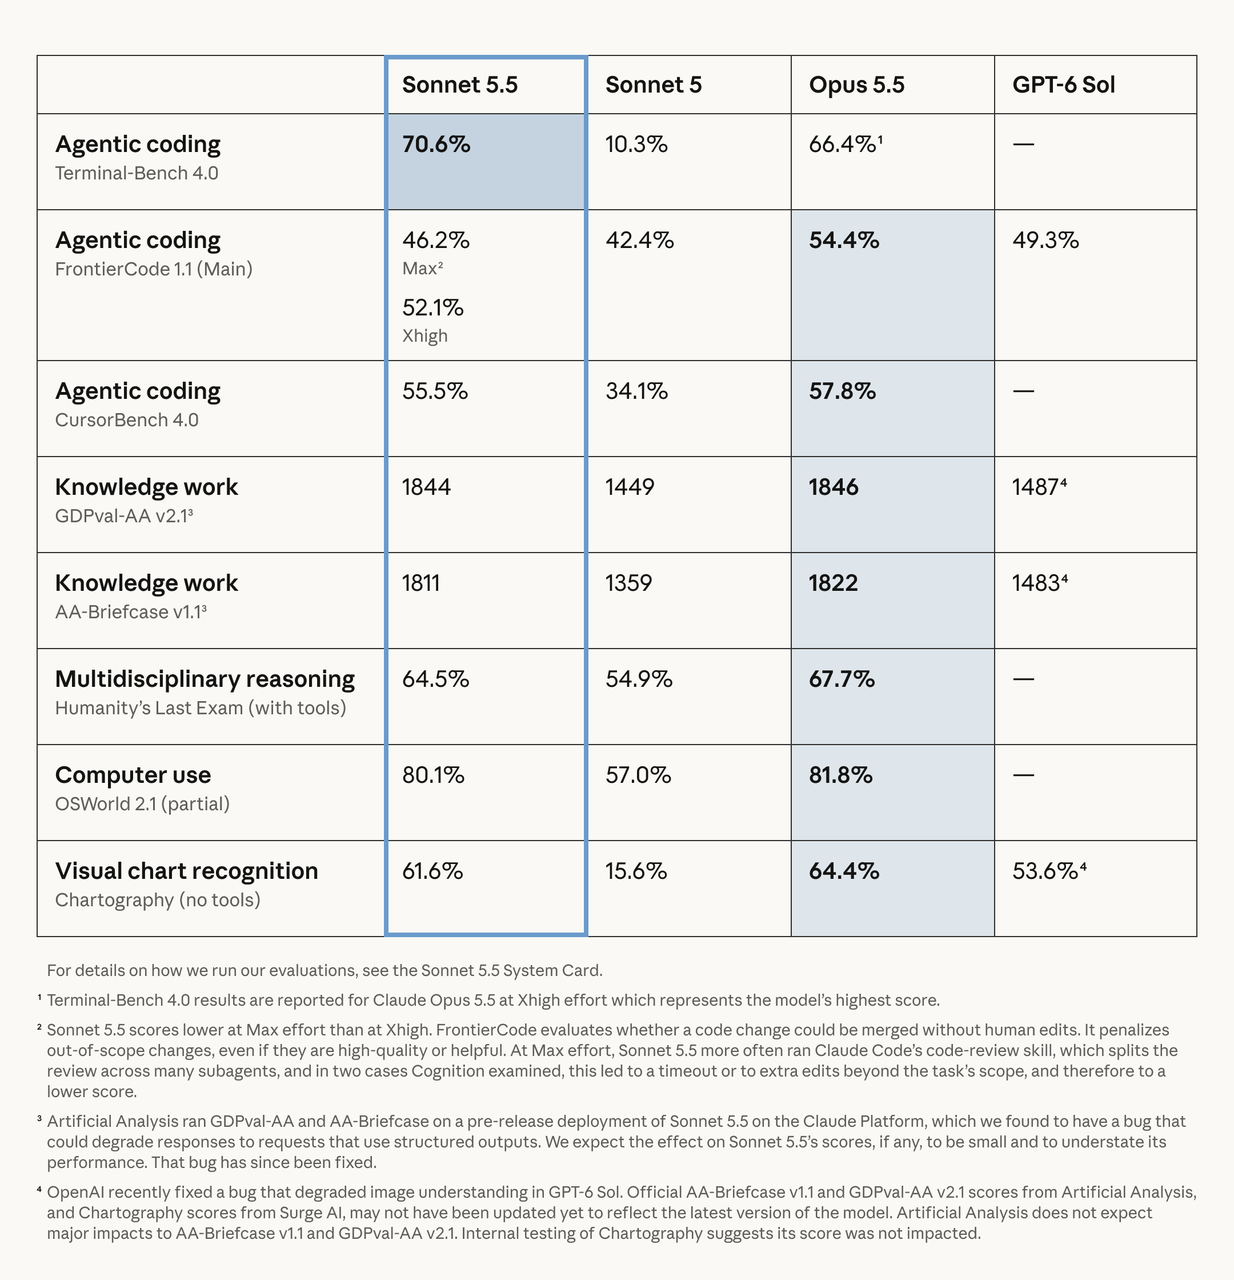
Wyniki premiery Sonnet 5.5 Anthropic (https://www.anthropic.com/claude-sonnet-5-5) dostarczają użytecznych sygnałów obciążeniowych. Porównanie obejmuje starszy GPT-6 Sol, więc te wartości w kolumnie OpenAI są wyłączone z poniższej tabeli obecnych modeli. „Nie ustalono tutaj” oznacza, że cytowane źródła nie wspierają dokładnie dopasowanego wyniku dla tego porównania; nie oznacza to zerowej wydajności.
| Benchmark / warunki | GPT-6.1 Sol | Claude Sonnet 5.5 | Co mierzy |
|---|---|---|---|
| Terminal-Bench 4.0 | Nie ustalono tutaj | 70.6% | Zadania terminalowe |
| FrontierCode 1.1 Main | Nie ustalono tutaj | 52.1% Xhigh; 46.2% Max | Scalalne zmiany w repozytorium |
| CursorBench 4.0 | Nie ustalono tutaj | 55.5% | Agentowe programowanie w zadaniach Cursor |
| GDPval-AA v2.1 | Nie ustalono tutaj | 1844 | Profesjonalna praca z wiedzą |
| AA-Briefcase v1.1 | Nie ustalono tutaj | 1811 | Długohoryzontowa praca z wiedzą |
| Humanity’s Last Exam, narzędzia | Nie ustalono tutaj | 64.5% | Wielodziedzinowe rozumowanie |
| OSWorld 2.1, częściowe | Nie ustalono tutaj | 80.1% | Częściowa nagroda za użycie komputera |
| Chartography, bez narzędzi | Nie ustalono tutaj | 61.6% | Rozpoznawanie wykresów |
Warunki testu: poziom wysiłku i harness agenta wpływają na wyniki kodowania. GDPval-AA i AA-Briefcase to ewaluacje Artificial Analysis, a wyniki Chartography pochodzą z Surge AI. Anthropic zauważa później naprawiony błąd strukturalnego wyjścia w przedpremierowym wdrożeniu Sonnet, który mógł nieznacznie zaniżyć wyniki pracy profesjonalnej. Użyj linku System Card z ogłoszenia dla środowisk testowych i pełnej metodologii; nie łącz niejednorodnych metryk w jeden ogólny ranking.
Oryginalna grafika Anthropic poniżej zawiera przypisy do ewaluacji. Kolumna GPT-6 Sol stanowi jedynie kontekst historyczny i nie raportuje wydajności GPT-6.1 Sol.
Agentowe programowanie i inżynieria oprogramowania
Sonnet 5.5 ma zgłoszone dowody dla kodowania terminalowego, scalalnych zmian kodu i zadań agentowych w stylu IDE. GPT-6.1 Sol jest udokumentowany dla złożonego kodowania i integruje się z ekosystemem narzędzi OpenAI. Ani pozycjonowanie produktu, ani wynik poprzednika nie ustanawiają obecnego zwycięzcy w kodowaniu. Dla użytecznej ewaluacji wybierz rzeczywiste zmiany z testami regresji i poproś recenzentów o ocenę zakresu, utrzymywalności i gotowości do scalenia.
Praca z wiedzą, rozumowanie, matematyka i nauka
Wyniki Sonnet w GDPval-AA i AA-Briefcase czynią raporty, analizy i biurowe materiały sensownymi celami ewaluacji. GPT-6.1 Sol również celuje w pracę profesjonalną, ale użyte tu źródła nie dostarczają dopasowanego porównania między tymi modelami. Używaj własnych szablonów dokumentów, arkuszy i prezentacji. Zaawansowana matematyka i twierdzenia naukowe wymagają dowodów specyficznych dla zadań, a nie ekstrapolacji z ogólnych kontrolek rozumowania.
Użycie komputera, automatyzacja przeglądarki i przepływy multimodalne
Oba modele przyjmują obrazy, co wspiera debugowanie zrzutów ekranu i analizę wizualną. Wyniki Sonnet w OSWorld i Chartography są dowodami dla tych konkretnych ewaluacji. GPT-6.1 Sol dokumentuje użycie komputera przez narzędzia Responses. Przetestuj cały przepływ: dokładność nawigacji, odzyskiwanie po nieudanym wywołaniu narzędzia, poprawność wyjścia i czas do ukończenia. Wejście tekst-obraz samo w sobie nie gwarantuje identycznej integracji użycia komputera.
Niezależna ewaluacja i jakość dowodów
Tabela publikowana przez dostawcę może zawierać wyniki stron trzecich, nie stając się pojedynczym kontrolowanym eksperymentem. Dla każdej niezależnej analizy zapisuj dokładne ID modeli, daty wdrożenia, wysiłek, narzędzia, zabezpieczenia, timeout, politykę ponowień i reguły zatrzymywania. Zbiorczy indeks inteligencji, wskaźnik sukcesu kodowania i częściowa nagroda za użycie komputera odpowiadają na różne pytania. Przejrzane źródła nie ustanawiają kompletnego dopasowanego zestawu niezależnych wyników dla tej pary.
GPT-6.1 Sol vs Claude Sonnet 5.5: Koszt
Oficjalne ceny API
| Metryka cenowa | Oficjalne stawki GPT-6.1 Sol | Oficjalne stawki Claude Sonnet 5.5 |
|---|---|---|
| Wejście / 1M tokenów, baza Standard | $2.00 | $2.00 |
| Wyjście / 1M tokenów, baza Standard | $10.00 | $10.00 |
| Odczyt cache / 1M tokenów, baza | $0.10 | $0.10 |
| Zapis cache / 1M tokenów, baza | $2.50 | $2.50 przez 5m; $4.00 przez 1h |
| Przetwarzanie wsadowe | 50% poniżej Standard | 50% rabatu na wejście/wyjście |
| Wejście powyżej 272K, całe żądanie Standard | $4 wejście / $0.20 odczyt cache / $5 zapis cache / $15 wyjście | Brak równoważnej dopłaty w cytowanym przeglądzie |
Wszystkie stawki to USD za milion tokenów. Bazowe odczyty cache GPT-6.1 Sol kosztują $0.10/M (https://developers.openai.com/api/docs/models/gpt-6.1-sol), a odczyty cache Sonnet 5.5 również $0.10/M (https://platform.claude.com/docs/en/models/sonnet-5-5/overview). Warunek Sol powyżej 272K wejścia podnosi stawki dla całego żądania Standard, a nie tylko nadwyżki tokenów. Porównuj zapisy cache, retencję, progi długiego kontekstu, przetwarzanie regionalne i poziomy usług; sama bazowa cena odczytu nie daje przewagi żadnemu modelowi.
Koszt na ukończone zadanie
Koszt na zaakceptowany wynik = całkowity koszt wszystkich podjętych zadań / liczba zaakceptowanych wyników. Całkowity koszt obejmuje rozliczone świeże wejście, odczyty i zapisy cache, wyjście (w tym rozliczane tokeny rozumowania, gdy dotyczy), płatne wywołania narzędzi oraz ludzką recenzję lub korektę. Koszty ponowień liczone są według faktycznego użycia, a nie dodawane ponownie jako duplikat.
Dla jednego miliona tokenów odczytu cache w całości rozliczonych w stawce bazowej, koszt wynosi $0.10 dla obu modeli; różnica w cenie bazowego odczytu to $0.00. To ilustracja stawki, a nie wycena żądania Sol o milionie tokenów wejścia w bazowym progu. Rzeczywisty koszt sesji obejmuje też świeże wejście, zapisy do cache, wyjście, narzędzia i ponowienia. Porównuj zimne i ciepłe sesje w odpowiednim progu kontekstu i raportuj wskaźnik akceptacji obok rozliczonego użycia.
Cennik CometAPI
| Opublikowany poziom CometAPI | GPT-6.1 Sol API w CometAPI | Claude Sonnet 5.5 API w CometAPI |
|---|---|---|
| Baza wejście / wyjście na 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Rabat vs dostawca | 20% | 20% |
| Wejście/wyjście GPT dla długiego kontekstu | $3.20 / $12.00 | Sprawdź bieżące warunki specyficzne dla trasy |
| Odczyty cache GPT, baza / długi | $0.08 / $0.16 | Nie określono w cytowanej podstawowej tabeli cen |
To opublikowane ceny dla tras modelowych sprawdzone dla tej rewizji, oddzielnie od stawek dostawców. Cennik CometAPI dla GPT-6.1 Sol rozróżnia krótki i długi kontekst. Cytowana podstawowa tabela Sonnet wymienia wejście i wyjście, więc nie uzasadnia założenia identycznej polityki cache bramki. Sprawdź bieżące warunki rozliczeń trasy przed estymacją sesji produkcyjnej.
Jak wypadają okna kontekstu, szybkość i specyfikacje techniczne?
GPT-6.1 Sol obsługuje 1.05M tokenów, a Claude Sonnet 5.5 — 1M tokenów. Różnica nominalna to ok. 5%, więc pojemność kontekstu sama w sobie rzadko zdecyduje o wdrożeniu.
Drabinka wysiłku GPT-6.1 Sol to low, medium, high, xhigh i max; domyślnie medium. Sonnet 5.5 stosuje adaptacyjne myślenie, a domyślnie high na Claude Platform. Te nazwy nie implikują równych budżetów rozumowania. Przy równych wymaganiach jakościowych osobno mierz czas do pierwszego tokena, przepustowość wyjścia, opóźnienie pętli narzędziowej i czas ukończenia end-to-end.
Anthropic raportuje ponad 30% szybszą generację wyjścia dla Sonnet 5.5 względem Sonnet 5. Traktuj to jako porównanie do poprzednika. Dowody w tym artykule nie ustanawiają uniwersalnego czasu opóźnienia dla GPT-6.1 Sol ani bezpośredniego zwycięzcy prędkości między obecnymi modelami. Dla obciążeń interaktywnych testuj niższe ustawienia wysiłku względem tej samej rubryki akceptacji zamiast zakładać, że max to najlepsze ustawienie wdrożeniowe.
Co ma znaczenie dla bezpieczeństwa, alignmentu i wdrożenia?
Decyzje wdrożeniowe powinny odróżniać udokumentowane zachowanie modelu od kontroli aplikacyjnych. Porównanie modeli nie ustanawia, które wdrożenie spełnia wymagania Twojej organizacji w zakresie obsługi danych lub dostępu. Oceń faktycznie używanego dostawcę lub bramkę, w tym rejestrowanie żądań, rezydencję danych, uprawnienia narzędzi i obsługę awarii.
- Migracja rozumowania: GPT-6.1 Sol nie obsługuje none ani minimal. Przewodnik migracji OpenAI (https://developers.openai.com/api/docs/guides/latest-model) kieruje przepływy z wywoływaniem narzędzi do Responses.
- Zachowanie narzędzi Claude: udokumentowane zmiany kompatybilności Sonnet 5.5 (https://platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5) obejmują nieobsługiwane wymuszone tryby narzędzi i blokady myślenia związane z konwersacją. Przetestuj te ścieżki przed wdrożeniem.
- Kontrole operacyjne: dawaj agentom tylko narzędzia potrzebne do zadania, zapisuj nieudane wywołania i utrzymuj ludzką recenzję dla konsekwentnych działań zewnętrznych. To wybory projektowe aplikacji, a nie zmierzone przewagi któregokolwiek modelu.
GPT-6.1 Sol vs Claude Sonnet 5.5: Który wybrać?
Testuj najpierw GPT-6.1 Sol, gdy już używasz narzędzi Responses lub potrzebujesz przewidywalnej drabinki wysiłku. Testuj Sonnet 5.5 dla dobrze zdefiniowanej iteracji kodu, slajdów, arkuszy i dokumentów, gdzie zgłoszone dowody odpowiadają Twoim zadaniom. Dla sesji z keszowanym prefiksem przetestuj oba: ich bazowe stawki odczytu cache są równe, podczas gdy koszty zapisu, retencji, długiego kontekstu i sukces zadania mogą zmienić całkowity rachunek. Kieruj pracę dopiero po reprezentatywnych ewaluacjach, które ustanowią użyteczną różnicę w jakości, koszcie lub opóźnieniu.
Wybór wg obciążenia
| Obciążenie | Punkt wyjścia | Co zweryfikować |
|---|---|---|
| Istniejący agent OpenAI Responses | GPT-6.1 Sol | Zgodność narzędzi i zmiany poziomu wysiłku |
| Iteracja kodu / naprawa błędów | Sonnet 5.5, potem porównaj z Sol | Gotowość do scalenia, opóźnienie i ponowienia |
| Slajdy / arkusze / raporty | Sonnet 5.5, potem porównaj z Sol | Zgodność z szablonem i czas edycji przez człowieka |
| Stabilne sesje z keszowanym prefiksem | Oba; równe bazowe odczyty cache | Trafienia, zapisy, próg kontekstu i akceptowana jakość |
| Pełne żądania powyżej 272K wejścia | Oba | Rzeczywisty koszt długiego kontekstu i jakość retrieval |
| Automatyzacja komputera/przeglądarki | Oba | Odzyskiwanie po błędach, ukończenie zadania i uprawnienia |
| Matematyka / analiza naukowa | Oba w testach specyficznych dla zadań | Poprawność z weryfikowalnymi odpowiedziami |
| Produkcja wrażliwa na koszty | Oba | Całkowity koszt na zaakceptowany wynik |
Porównanie produkcyjne powinno utrzymywać stały system otaczający. Używaj tych samych promptów, repozytoriów lub dokumentów, uprawnień do narzędzi, timeoutu, polityki ponowień i rubryki akceptacji wyjścia.
Zapisuj świeże wejście, zapisy i odczyty cache, zużycie wyjścia, płatne wywołania narzędzi, ponowienia, czas recenzji ludzkiej, sukces zadania i opóźnienie end-to-end. Tańsza pierwsza odpowiedź może nadal prowadzić do droższego zaakceptowanego wyniku.
Jak uzyskać dostęp do GPT-6.1 Sol i Claude Sonnet 5.5?
Deweloperzy mogą uzyskać dostęp do GPT-6.1 Sol API w CometAPI (https://www.cometapi.com/models/openai/gpt-6-1-sol/) i Claude Sonnet 5.5 API w CometAPI (https://www.cometapi.com/models/anthropic/claude-sonnet-5-5/) przez udokumentowane trasy modelu. Utwórz klucz API, przechowuj go bezpiecznie i zweryfikuj dostęp do modelu oraz specyficzne dla trasy warunki rozliczeń przed produkcją.
Dostęp do GPT-6.1 Sol
Dla Sol użyj udokumentowanej trasy Responses, gdy wymagane jest wywoływanie narzędzi. Wybierz gpt-6.1-sol i wspierany poziom wysiłku, domyślnie medium. Przekaż wejście zadania, skonfiguruj tylko potrzebne narzędzia i waliduj zwracany tekst, wywołania narzędzi, błędy i użycie. Potwierdź obsługę funkcji specyficznych dla dostawcy przez bramkę, zamiast zakładać, że każda opcja OpenAI jest dostępna.
Dostęp do Claude Sonnet 5.5
Dla Sonnet wybierz claude-sonnet-5-5 na udokumentowanym kompatybilnym interfejsie i wyślij zadanie jako wiadomości konwersacji z odpowiednim budżetem wyjścia. Potwierdź, jak ta trasa obsługuje natywne myślenie i parametry narzędzi; pola rozumowania OpenAI nie są automatycznie zamienne z opcjami Claude. Zweryfikuj kontynuację konwersacji i obsługę błędów przed wdrożeniem agenta.
Sprawdzenie endpointu weryfikuje łączność, a nie porównawczą wydajność. Do ewaluacji wyrównaj prompty, efektywne budżety wyjścia i rozumowania, narzędzia, ponowienia, timeouty i kryteria akceptacji, a następnie porównaj zaakceptowaną pracę, opóźnienie i całkowity rozliczony koszt.
Wnioski
GPT-6.1 Sol i Claude Sonnet 5.5 mają te same bazowe stawki wejścia, wyjścia i odczytu cache, z podobną pojemnością kontekstu. Sol to naturalny kandydat dla istniejących agentów Responses i jawnych kontrolek wysiłku. Adaptacyjne myślenie Sonnet oraz zgłoszone wyniki w kodowaniu i pracy profesjonalnej czynią go użytecznym kandydatem dla codziennych materiałów. Przepływy intensywnie korzystające z cache wymagają porównania całej sesji: równe bazowe stawki odczytu nie gwarantują równych kosztów zapisu, retencji, długiego kontekstu czy ukończonych zadań.
Wybierz model, który wykonuje Twoją rzeczywistą pracę w ramach wymagań jakości, opóźnienia i kosztu. Oddzielaj wyniki poprzedników od dowodów dla obecnych modeli, wyceniaj próg kontekstu, którego używa Twój przepływ pracy, i porównaj obie trasy przed przyjęciem domyślnej.
FAQ
Czy GPT-6.1 Sol i Sonnet 5.5 mogą współdzielić jeden schemat narzędzia?
Wspólna definicja narzędzia JSON może być punktem wyjścia, ale wsparcie endpointu, wymuszone zachowania narzędzi, bloki myślenia i obsługa odpowiedzi różnią się. Waliduj wywołania narzędzi każdego modelu testami kontraktowymi dla argumentów, ścieżek błędów i kontynuacji konwersacji. Utrzymuj adaptery specyficzne dla modelu dla nieobsługiwanych opcji zamiast zakładać, że udane żądanie tekstowe dowodzi kompatybilności agenta.
Jak dopasować poziom wysiłku rozumowania w obu modelach?
Nie traktuj identycznie nazwanych ustawień jako równych budżetów obliczeniowych. Zdefiniuj rubrykę akceptacji oraz limit kosztu lub cel opóźnienia, a następnie przeszukaj ustawienia wysiłku dla każdego modelu. Porównuj najlepszą konfigurację, która spełnia to samo ograniczenie operacyjne, w tym ponowienia i korektę ludzką, zamiast porównywać wyłącznie najwyższe ustawienia obu modeli.
Kiedy przepływ pracy z kontekstem 1M powinien zamiast tego użyć wyszukiwania?
Użyj wyszukiwania, gdy zadanie potrzebuje małej, identyfikowalnej części dużego korpusu i Twoje testy wyszukiwania pokazują, że istotny materiał jest konsekwentnie odzyskiwany. Testuj pełnokontekstowe żądania, gdy dowody są rozproszone lub liczą się relacje między plikami. Porównuj poprawność odpowiedzi, pokrycie cytatów, koszt wejścia i opóźnienie; duży limit kontekstu sam nie ustanawia, że zapełnienie całego okna jest ekonomiczne lub niezawodne.
Jak zespoły mogą uniknąć mylącego porównania kosztów cache?
Mierz oddzielnie przebiegi na zimnym i ciepłym cache, zapisuj zarówno zapisy, jak i odczyty cache, i stosuj właściwe okno retencji oraz próg długiego kontekstu. Utrzymuj stabilne współdzielone prefiksy i porównuj powtarzalne realistyczne sesje, a nie tylko jedno zniżkowe żądanie. Raportuj wskaźnik trafień i całkowite rozliczone użycie, aby pozorne oszczędności były replikowalne.
Co powinno wywołać nową ewaluację GPT-6.1 Sol vs Sonnet 5.5?
Uruchom ponownie dotknięty zestaw zadań po aktualizacji wdrożenia, poprawce błędu dostawcy, zmianie routingu, narzędzia lub promptu, albo istotnej rewizji cen. Zapisz datę ewaluacji, ID modelu, endpoint, wysiłek i wersję harnessu. Zachowaj wcześniejszy przebieg jako punkt odniesienia, aby zmiany jakości lub opóźnień nie zostały pomylone ze zmianami w otaczającym systemie.