Specyfikacje techniczne MiniMax M3.1-Flash-Preview
| Pozycja | MiniMax M3.1-Flash-Preview |
|---|---|
| ID modelu | MiniMax-M3.1-Flash-Preview |
| Rodzina modelu | Seria MiniMax M3.1, model do kodowania w wersji zapoznawczej |
| Status wydania | Wersja zapoznawcza; zapowiedziano 27 września 2026 r. |
| Główny obszar | Codzienny rozwój oprogramowania, od poprawek błędów po pełną realizację funkcji |
| Okno kontekstu | 1,000,000 tokenów |
| Tryby wejścia | Tekst, obraz i wideo |
| Tryb wyjścia | Tekst |
| Sterowanie rozumowaniem | reasoning_effort: low, medium, high, xhigh, max |
| Zachowanie procesu myślowego | Wymagane jest adaptacyjne myślenie; przeglądana publiczna dokumentacja nie przewiduje możliwości wyłączenia myślenia |
| Maksymalne wyjście | Nie opublikowano odrębnie w przeglądanych publicznych materiałach |
| Liczba parametrów | Nie ujawniono publicznie |
| Otwarte wagi | Nie zidentyfikowano publicznego punktu kontrolnego/repozytorium modelu |
MiniMax ogłosił M3.1-Flash-Preview dla MiniMax Code 27 września 2026 r., pozycjonując go wokół codziennych zadań rozwojowych, takich jak poprawianie błędów i pełna realizacja funkcji. Aktualne publiczne materiały konsekwentnie wskazują okno kontekstu 1M tokenów oraz regulowany wysiłek rozumowania, jednocześnie odnotowując, że nie opublikowano samodzielnej tabeli benchmarków ani ceny za token.
Czym jest MiniMax M3.1-Flash?
MiniMax M3.1-Flash-Preview to tekstowy model w wersji zapoznawczej ukierunkowany na kodowanie, zaprojektowany z myślą o iteracyjnych przepływach pracy związanych z rozwojem oprogramowania, a nie wyłącznie o generowaniu kodu. MiniMax opisuje ten przepływ pracy jako obejmujący rozumienie wymagań, lokalizację problemu, implementację, testy regresyjne oraz weryfikację zmian względem istniejącej funkcjonalności.
Jego wyróżniającymi, udokumentowanymi kontrolami są długie okno kontekstu oraz pięciopoziomowa skala wysiłku rozumowania. Dostępne poziomy to low, medium, high, xhigh i max, umożliwiające deweloperom wymianę głębokości rozumowania na opóźnienie w zależności od złożoności zadania.
Główne funkcje MiniMax M3.1-Flash-Preview
- Kontekst 1M tokenów: Opublikowany opis modelu przypisuje wersji zapoznawczej okno kontekstu o wielkości miliona tokenów, co czyni ją odpowiednią dla dużych repozytoriów, długich specyfikacji oraz wydłużonych sesji agentów kodujących.
- Natywne wejście multimodalne: Publiczne opisy modelu wskazują tekst, obraz i wideo jako wejścia, podczas gdy model zwraca tekst.
- Pięć poziomów wysiłku rozumowania:
low,medium,high,xhighimaxzapewniają bardziej precyzyjną kontrolę nad głębokością rozumowania niż proste przełączanie myślenia w tryb włącz/wyłącz. - Pełny przepływ prac programistycznych end-to-end: MiniMax pozycjonuje model konkretnie do lokalizacji błędów, implementacji, obsługi przypadków brzegowych, uzupełniania testów regresyjnych oraz walidacji zmian.
- Wdrożenie ukierunkowane na wersję zapoznawczą: Początkowe publiczne udostępnienie odbywa się przez MiniMax Code i Token Plan, zamiast w pełni udokumentowanej, samodzielnej oferty modelu w modelu płatności pay-as-you-go.
- Dopasowanie do agentów kodujących: Model jest przeznaczony do powtarzających się interakcji rozwojowych, w których kontekst repozytorium, wyniki narzędzi, testy i iteracyjne poprawki mają większe znaczenie niż jednorazowe generowanie kodu.
MiniMax M3.1-Flash-Preview w porównaniu z innymi modelami kodującymi MiniMax
| Model | Skupienie | Kontekst | Publiczne dane z benchmarków | Dostęp/status |
|---|---|---|---|---|
| M3.1-Flash-Preview | Codzienne kodowanie, iteracyjny rozwój | 1M | Jeszcze nie opublikowane | Wersja zapoznawcza; MiniMax Code / Token Plan |
| M3 | Zaawansowane kodowanie + praca z agentami, natywna multimodalność | Do 1M | Opublikowane przez MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Inżynieria oprogramowania + szeroka praca agentowa/produktywność | Nie użyto tutaj jako skopiowanej specyfikacji M3.1 | Opublikowane przez MiniMax | API, Token Plan, Agent |
M3 jest bardziej szczegółowo udokumentowanym punktem odniesienia: MiniMax publikuje jego architekturę, metodologię ewaluacji kodowania/agentów oraz dostępność API. M2.7 również ma publiczny rekord benchmarków i integrację z API. M3.1-Flash-Preview jest nowszy i obecnie ma węższy ślad w dokumentacji publicznej, dlatego porównania powinny koncentrować się na udokumentowanym pozycjonowaniu, zamiast wskazywać zwycięzcę benchmarków. 4
Reprezentatywne przypadki użycia
- Naprawa błędów w skali repozytorium: Przekaż modelowi dużą bazę kodu, opis zgłoszenia, logi i testy oraz wykorzystaj jego długie okno kontekstu, aby zachować istotny kontekst projektu.
- Implementacja funkcji: Użyj modelu, aby przejść od wymagania w języku naturalnym przez zmiany w kodzie i testy regresyjne.
- Przegląd i naprawa kodu: Poproś o identyfikację przypadków brzegowych, zaproponowanie poprawek oraz weryfikację, że zmiany nie naruszają istniejącego zachowania.
- Debugowanie multimodalne: Dostarcz zrzuty ekranu, diagramy lub wideo obok wymagań tekstowych, gdy kontekst wizualny jest częścią problemu inżynierskiego.
- Długotrwałe sesje agentów kodujących: Wykorzystaj duże okno kontekstu dla specyfikacji, plików repozytorium, danych wyjściowych terminala oraz iteracyjnych wyników testów.
- Rozwój wrażliwy na szybkość: Wybierz niższy poziom wysiłku rozumowania dla rutynowych edycji i zwiększ wysiłek dla bardziej złożonych, wieloetapowych zmian.
Jak uzyskać dostęp do API MiniMax M3.1-Flash-Preview
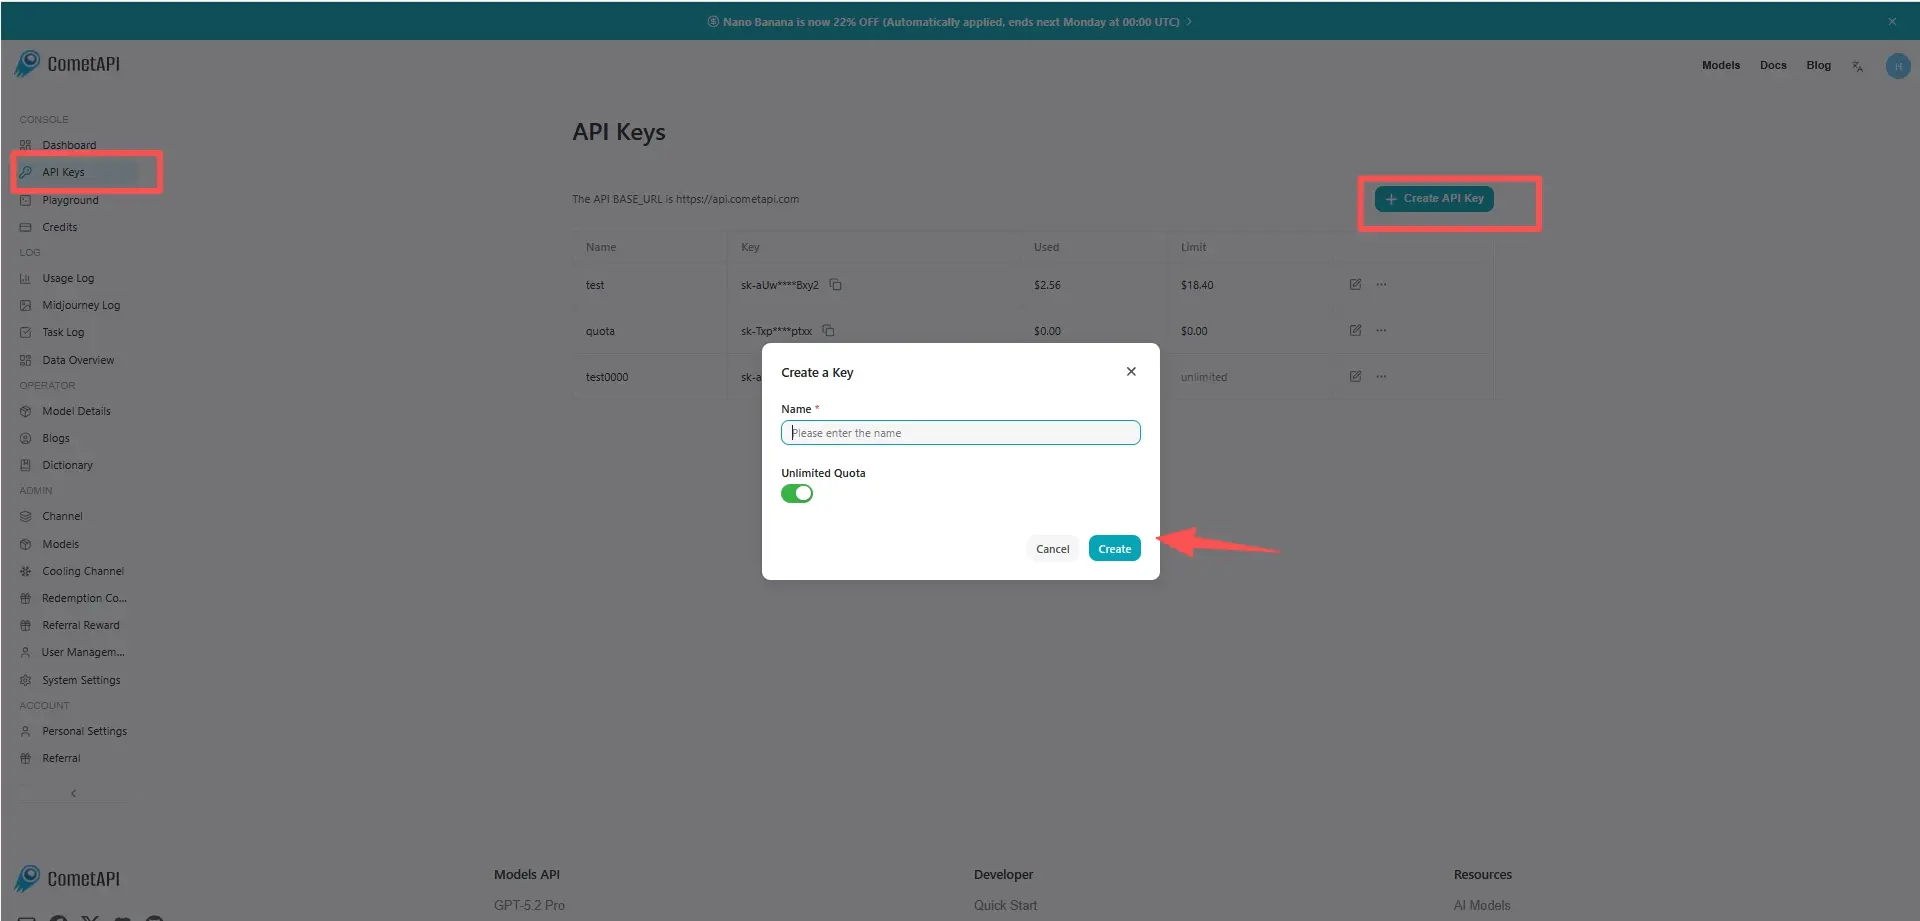
Krok 1: Zarejestruj się, aby uzyskać klucz API
Zaloguj się na cometapi.com. Jeśli nie jesteś jeszcze naszym użytkownikiem, prosimy najpierw o rejestrację. Zaloguj się do konsoli CometAPI. Uzyskaj klucz API będący poświadczeniem dostępu do interfejsu. Kliknij “Add Token” przy tokenie API w centrum osobistym, pobierz klucz tokenu: sk-xxxxx i zatwierdź.
Krok 2: Wyślij żądania do API MiniMax M3.1-Flash-Preview
Wybierz punkt końcowy “minimax-m3.1-flash-preview”, aby wysłać żądanie API i ustawić treść żądania. Metodę żądania i treść żądania znajdziesz w dokumentacji API na naszej stronie. Nasza strona udostępnia również test w Apifox dla Twojej wygody. Zastąp <YOUR_API_KEY> rzeczywistym kluczem CometAPI ze swojego konta. base url is Chat Completions .
Wstaw swoje pytanie lub prośbę do pola content—na to model odpowie . Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź.
Krok 3: Odbierz i zweryfikuj wyniki
Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź. Po przetworzeniu API zwraca status zadania i dane wyjściowe.