
TL;DR
GPT-Image-2.5 nie ma jednej stałej „ceny za obraz”. OpenAI rozlicza korzystanie z API według tokenów. Zarówno GPT-Image-2.5 Flare jak i GPT-Image-2.5 Sunburst korzystają z tych samych oficjalnych stawek za tokeny: 5 USD za milion tokenów wejścia tekstowego, 8 USD za milion tokenów wejścia obrazowego oraz 30 USD za milion tokenów wyjścia obrazowego. Buforowane wejścia tekstowe i obrazowe kosztują odpowiednio 1,25 USD i 2 USD za milion tokenów.
Dla obrazu 1024×1024 obserwacje z kalkulatorów stron trzecich sugerują, że samo generowanie wyjścia może kosztować od ok. 0,006 USD przy jakości low do ok. 0,211 USD przy jakości max. Jakość high to ok. 0,053 USD w tym modelu planowania. Rzeczywiste rachunki zależą od tokenów promptu, obrazów referencyjnych, ponowień, wejść edycyjnych i faktycznego zużycia tokenów wyjściowych.
Key Takeaways
- OpenAI rozlicza API GPT-Image-2.5 według tokenów, a nie według uniwersalnej stałej ceny za obraz.
- Flare i Sunburst mają te same stawki za tokeny; Sunburst nie jest droższym modelem w przeliczeniu na token.
- Oficjalne stawki to 5 USD za milion tokenów wejścia tekstowego, 8 USD za milion tokenów wejścia obrazowego i 30 USD za milion tokenów wyjścia obrazowego.
- GPT-Image-2.5 wprowadza tryby jakości: low, medium, high, xhigh, max i auto.
- Szacunek planistyczny dla obrazu 1024×1024 to w przybliżeniu 0,0059 USD przy low, 0,0527 USD przy high i 0,2107 USD przy max, przed doliczeniem kosztów tokenów wejściowych.
- Flare to lepszy domyślny wybór do generowania na dużą skalę i z niską latencją, natomiast Sunburst celuje w precyzyjną edycję i zaawansowane kreatywne workflow.
- CometAPI reklamuje 20% zniżki na swoje API modeli GPT-Image-2.5, z cenami nagłówkowymi 4 USD za milion tokenów wejścia i 24 USD za milion tokenów wyjścia wobec odpowiednio 5 USD i 30 USD w cenniku oficjalnym.
What Is GPT-Image-2.5 and What Are You Paying For?
OpenAI released ChatGPT Images 2.5 8 września 2026 r. Aktualizacja koncentruje się na ostrzejszych detalach, bardziej naturalnym oświetleniu i teksturach, lepszym zachowaniu referencyjnych obiektów, bardziej niezawodnej edycji w wielu turach oraz niższej latencji generowania. OpenAI podaje, że latencja generowania może być do 50% niższa niż w Images 2.0.
Rodzina API ma dwie odmiany. GPT-Image-2.5 Flare jest zoptymalizowany pod szybkie, wysokiej jakości codzienne generowanie i jest zalecanym domyślnym wyborem OpenAI dla większości aplikacji. GPT-Image-2.5 Sunburst kładzie nacisk na precyzję edycji i premiumowe workflow kreatywne, gdzie ważniejsze od minimalnej latencji jest zachowanie istniejącego obiektu lub kompozycji.
| Specification | GPT-Image-2.5 Flare | GPT-Image-2.5 Sunburst |
|---|---|---|
| API model ID | gpt-image-2.5-flare | gpt-image-2.5-sunburst |
| Positioning | Fast everyday generation | Precision generation and editing |
| Input | Text and images | Text and images |
| Output | Images | Images |
| Image generation | Yes | Yes |
| Image editing | Yes | Yes |
| Quality settings | low, medium, high, xhigh, max, auto | low, medium, high, xhigh, max, auto |
| Recommended square size | 1024×1024 | 1024×1024 |
| Recommended landscape size | 1536×1024 | 1536×1024 |
| Recommended portrait size | 1024×1536 | 1024×1536 |
| Transparent output | PNG / WebP | PNG / WebP |
| Best fit | High-volume generation, rapid iteration | Product imagery, campaign creative, precise edits |
| Official image-output rate | $30/M tokens | $30/M tokens |
Dokumentacja modelu podstawowego potwierdza, że obie odmiany przyjmują wejścia tekstowe i obrazowe oraz produkują wyjście obrazowe, podczas gdy wywoływanie funkcji, ustrukturyzowane wyjścia i dostrajanie nie są częścią interfejsu modelu obrazowego.
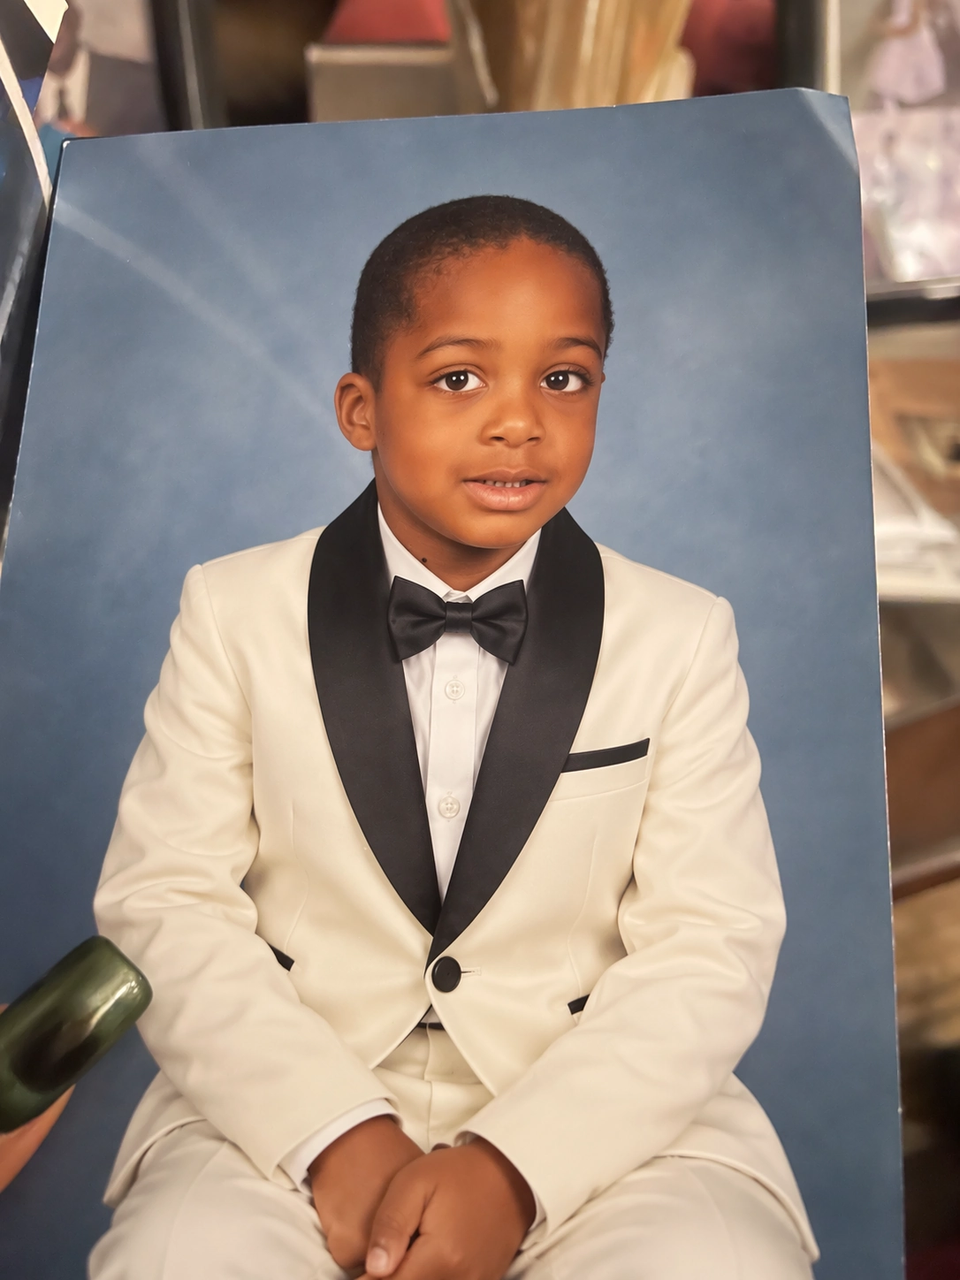
Oficjalny przykład precyzyjnej edycji GPT-Image-2.5 opublikowany przez OpenAI; edytowany portret zachowuje pozę i tło, zmieniając jedynie ubranie dziecka.
GPT-Image-2.5 Flare jest dostępny jako
gpt-image-2.5-flare, z datowaną migawką
gpt-image-2.5-flare-2026-09-08. Sunburst analogicznie udostępnia
gpt-image-2.5-sunburstoraz
gpt-image-2.5-sunburst-2026-09-08. Deweloperzy, którzy potrzebują bardziej przewidywalnego zachowania modelu między wdrożeniami, powinni rozważyć, czy przypięcie datowanej migawki jest właściwe dla ich workflow.
How Much Does the GPT-Image-2.5 API Cost?
Najprościej zrozumieć ceny GPT-Image-2.5, rozdzielając koszt wejścia od kosztu wygenerowanego obrazu.
Oficjalna dokumentacja modeli OpenAI podaje następujące stawki za tokeny dla Flare i Sunburst.
| Token type | Standard price per 1M tokens | Cached price per 1M tokens |
|---|---|---|
| Text input | $5.00 | $1.25 |
| Image input | $8.00 | $2.00 |
| Image output | $30.00 | — |
| Text output | Not billed | — |
Najważniejszą liczbą dla większości zadań tekst-do-obrazu jest 30 USD za milion tokenów wyjścia obrazowego. Krótki prompt tekstowy zazwyczaj stanowi relatywnie niewielki udział w porównaniu z samym wygenerowanym obrazem. Workflow edycyjny może kosztować więcej, bo obrazy referencyjne także zużywają tokeny wejścia obrazowego.
Łączny koszt API = koszt wejścia tekstowego + koszt wejścia obrazowego + koszt wyjścia obrazowego.
Dla prostego wywołania tekst-do-obrazu bez obrazu referencyjnego komponent wyjścia obrazowego zwykle dominuje. W workflow edycji obrazów z kilkoma wysokorozdzielczymi zasobami referencyjnymi koszt wejścia staje się bardziej istotny.
How Much Does One GPT-Image-2.5 Image Cost?
Tu sprawa robi się mniej jednoznaczna.
Dokumentacje Flare i Sunburst podają, że kalkulator GPT Image 2 nie szacuje zużycia tokenów GPT Image 2.5. Niezależnie od tego, APIdog zarejestrował wspólną pozycję kalkulatora GPT Image 2.5 9 września 2026 r. ze wstępnymi budżetami tokenów wyjściowych dla Flare i Sunburst. Są to szacunki budżetowe, a nie gwarantowane oficjalne ceny za obraz.
| Quality | 1024×1024 output tokens | Estimated output cost | 1536×1024 output tokens | Estimated output cost |
|---|---|---|---|---|
| low | 196 | $0.00588 | 158 | $0.00474 |
| medium | 439 | $0.01317 | 343 | $0.01029 |
| high | 1,756 | $0.05268 | 1,372 | $0.04116 |
| xhigh | 3,122 | $0.09366 | 2,459 | $0.07377 |
| max | 7,024 | $0.21072 | 5,488 | $0.16464 |
Te liczby obejmują wyłącznie wyjście obrazowe. Rzeczywiste żądanie może też obejmować tokeny wejścia tekstowego, tokeny wejścia obrazowego, ponowienia, wariacje, przebiegi edycji lub inne wykorzystanie.
Bardziej trafnym stwierdzeniem niż „GPT-Image-2.5 kosztuje 0,053 USD za obraz” jest: generowanie 1024×1024 w jakości high można budżetować na ok. 0,053 USD w koszcie tokenów wyjścia według obserwowanego szacunku tokenów, przed kosztami wejścia i ponowieniami.
Is GPT-Image-2.5 High Quality Four Times Cheaper Than GPT Image 2 High?
Na pierwszy rzut oka tak: etykiety sugerują drastyczne obniżenie.
Zarejestrowane budżety tokenów APIdog pokazują, że GPT-Image-2.5 high to ok. 1 756 tokenów wyjściowych, czyli ok. 0,05268 USD dla obrazu 1024×1024. GPT Image 2 high wynosił ok. 0,211 USD dla tego samego rozmiaru kwadratowego.
To jednak nie jest porównanie „jabłko do jabłka” w sensie „ta sama jakość za jedną czwartą ceny”. Zmieniła się drabinka jakości.
| GPT-Image-2.5 setting | Approx. 1024×1024 output cost | Rough GPT Image 2 token-budget equivalent |
|---|---|---|
| low | $0.00588 | old low |
| medium | $0.01317 | below old medium |
| high | $0.05268 | old medium |
| xhigh | $0.09366 | between old medium and high |
| max | $0.21072 | old high |
Deweloperzy migrujący istniejącą linię przetwarzania nie powinni po prostu użyć ustawienia high i wnioskować, że nowy model jest cztery razy tańszy. Jeśli celem jest zbliżony budżet tokenów wyjściowych do poprzedniego ustawienia GPT Image 2 high, bliższym odpowiednikiem w GPT-Image-2.5 jest max, a nie high.
Does GPT-Image-2.5 Sunburst Cost More Than Flare?
Nie — nie w przeliczeniu na token. Obie odmiany korzystają z tego samego oficjalnego cennika. Sunburst nie ma wyższej stawki za token tylko dlatego, że jest pozycjonowany jako model o wyższej precyzji.
| Cost factor | Flare | Sunburst |
|---|---|---|
| Text input | $5/M | $5/M |
| Cached text input | $1.25/M | $1.25/M |
| Image input | $8/M | $8/M |
| Cached image input | $2/M | $2/M |
| Image output | $30/M | $30/M |
| Primary trade-off | Lower latency | More editing precision |
Różnica polega głównie na czasie i dopasowaniu do workflow, a nie na cenie tokena. OpenAI pozycjonuje Flare jako domyślny wybór dla większości zastosowań i podaje, że dostarcza obrazy wyższej jakości niż GPT Image 2 przy do 50% niższej latencji. Sunburst jest przeznaczony do bardziej kontrolowanej edycji i produkcyjnej pracy kreatywnej i może generować dłużej.
Jeśli Sunburst dostarczy użyteczny zasób kampanijny za pierwszym podejściem, a Flare wymaga dwóch–trzech ponowień, Sunburst może mieć niższy koszt na zaakceptowany obraz, mimo że nominalna cena za token jest taka sama.
How Good Is GPT-Image-2.5 for Its Price?
Cena ma znaczenie tylko wtedy, gdy jakość wyjścia jest konkurencyjna.
Aktualny ranking preferencji Arena plasuje obie odmiany GPT-Image-2.5 przed GPT Image 2 w generowaniu tekst-do-obrazu i edycji pojedynczego obrazu. To wyniki preferencji stron trzecich, a nie kontrolowane przez OpenAI benchmarki jakości, a wyniki GPT-Image-2.5 są oznaczone jako wstępne.
| Model | Text-to-Image Arena score | Single-Image Edit score |
|---|---|---|
| GPT-Image-2.5 Sunburst | 1421 ± 13 | 1520 ± 9 |
| GPT-Image-2.5 Flare | 1399 ± 13 | 1491 ± 9 |
| GPT Image 2 (medium) | 1381 ± 4 | 1461 ± 3 |
| Grok Imagine Image 2.0 (low) | 1315 ± 12 | 1439 ± 8 |
Zestaw benchmarków obejmuje także Grok Imagine Image 2.0 API w CometAPI.
Najbardziej zauważalny wynik dotyczy edycji. Sunburst wyprzedza Flare o ok. 29 punktów w rankingu edycji pojedynczego obrazu, a oba pozostają przed GPT Image 2. To jest zgodne z pozycjonowaniem Sunburst przez OpenAI jako opcji zorientowanej na precyzję. Zobacz ranking edycji obrazów.
Materiał ewaluacyjny OpenAI koncentruje się silniej na bezpieczeństwie niż preferencjach estetycznych. W swojej karcie systemowej firma raportuje końcowe wskaźniki prezentacji niebezpiecznych generacji na poziomie 1,09% dla Sunburst, 1,41% dla Flare i 1,64% dla bazowego Images 2.0 na adwersarialnym zestawie ewaluacyjnym bezpieczeństwa. To są pomiary bezpieczeństwa, a nie oceny jakości obrazu.
What Does GPT-Image-2.5 Cost in CometAPI?
Dla deweloperów, którzy chcą modelu przez bramę API wielu modeli, obie odmiany są dostępne w CometAPI. API GPT-Image-2.5 Flare w CometAPI pokazuje 4 USD za milion tokenów wejścia i 24 USD za milion tokenów wyjścia, wobec odpowiednich 5 USD i 30 USD w oficjalnym cenniku, co stanowi 20% zniżki. API GPT-Image-2.5 Sunburst w CometAPI publikuje tę samą porównawczą cenę nagłówkową.
| Pricing route | Input headline | Image-output headline | Discount shown |
|---|---|---|---|
| OpenAI official | $5/M text input | $30/M image output | — |
| CometAPI | $4/M input | $24/M output | 20% |
Szczegół cenowy do weryfikacji przed budżetowaniem produkcyjnym: OpenAI rozróżnia wejście tekstowe po 5 USD/M od wejścia obrazowego po 8 USD/M, podczas gdy CometAPI syntetyzuje cennik parą „wejście/wyjście”. Workflow-y oparte mocno na obrazach referencyjnych powinny sprawdzić żywy pulpit rozliczeń, zanim założą, że każdy token wejścia obrazowego otrzymuje wyświetlaną stawkę wejściową.
| Quality | Approx. OpenAI output cost | Approx. CometAPI output cost |
|---|---|---|
| low | $0.00588 | $0.00470 |
| medium | $0.01317 | $0.01054 |
| high | $0.05268 | $0.04214 |
| xhigh | $0.09366 | $0.07493 |
| max | $0.21072 | $0.16858 |
Ponownie, są to szacunkowe koszty wyjścia, a nie pełne ceny żądania.
How Much Would 10,000 GPT-Image-2.5 Images Cost?
Wysokie wolumeny lepiej uwidaczniają różnice cenowe. Załóżmy, że platforma treści generuje 10,000 obrazów kwadratowych, a każde wyjście zużywa ok. obserwowanego budżetu tokenów dla wybranego poziomu jakości.
| Quality | Approx. OpenAI output spend for 10,000 images | Approx. CometAPI output spend |
|---|---|---|
| low | $58.80 | $47.04 |
| medium | $131.70 | $105.36 |
| high | $526.80 | $421.44 |
| xhigh | $936.60 | $749.28 |
| max | $2,107.20 | $1,685.76 |
Tabela jest użyteczna do budżetowania infrastruktury, ale w rzeczywistej produkcji warto śledzić coś bardziej znaczącego niż koszt na wygenerowany obraz: koszt na zaakceptowany obraz.
Korzystając z szacunku dla jakości high 1024×1024, dziesięć generacji kosztuje ok. 0,5268 USD w tokenach wyjścia. Jeśli zaakceptowanych zostanie sześć, efektywny koszt tokenów wyjściowych to 0,5268 ÷ 6 = 0,0878 USD na zaakceptowany zasób.
Bardziej zdolny model, który ogranicza ponowienia, może więc być ekonomicznie lepszy, nawet jeśli pojedyncze żądanie zużywa nieco więcej tokenów.
Which GPT-Image-2.5 Quality Setting Gives the Best Value?
Dla większości zastosowań produkcyjnych rozsądnym punktem wyjścia jest high, a nie max. Low najlepiej sprawdza się przy podglądach i tanich eksperymentach. Medium działa dobrze przy generowaniu wielu koncepcji, które będą później filtrowane. High zapewnia silną równowagę jakości produkcyjnej przy dramatycznie niższym budżecie tokenów niż maksimum. Xhigh staje się atrakcyjny, gdy zasoby potrzebują dodatkowego szlifu, ale nie uzasadniają pełnego budżetu max. Max warto zazwyczaj zarezerwować dla finalnych zasobów, gdzie wierność ma większe znaczenie niż koszt generowania.
Ekonomiczna zaleta sześciostopniowej drabinki polega na tym, że nie trzeba płacić za maksymalną jakość na każdym etapie workflow kreatywnego. Praktyczna linia może generować koncepcje w medium, wybrać kandydatów, dopracować ocalałych w high i tylko finalne „hero assets” robić w xhigh lub max.
How Can You Calculate GPT-Image-2.5 Cost From API Usage?
Najbezpieczniejszym sposobem szacowania wydatków produkcyjnych jest rejestrowanie rzeczywistego zużycia tokenów, zamiast na stałe polegać na statycznej tabeli „ceny za obraz”. Dla oficjalnych stawek OpenAI obliczenia są proste:
Oszacuj każde żądanie słownie: pomnóż tokeny wejścia tekstowego przez 5 USD za milion, tokeny wejścia obrazowego przez 8 USD za milion, a tokeny wyjścia obrazowego przez 30 USD za milion, a następnie zsumuj te kwoty. Na przykład 120 tokenów wejścia tekstowego plus 1,756 tokenów wyjścia obrazowego kosztuje ok. 0,0006 USD + 0,05268 USD = 0,05328 USD przed doliczeniem ewentualnego kosztu wejścia obrazowego. Przy żądaniach edycyjnych dodaj tokeny wejścia obrazowego raportowane przez API, zwłaszcza gdy dostarczane są liczne obrazy referencyjne.
Dla prostego generowania z 120 tokenami wejścia tekstowego i 1,756 tokenami wyjścia obrazowego część wyjściowa to ok. 0,05268 USD, podczas gdy krótki prompt tekstowy dodaje jedynie bardzo małą kwotę. Przy edycji dodaj tokeny wejścia obrazowego zwrócone przez faktyczne żądanie. To szczególnie ważne, gdy dostarczanych jest wiele obrazów referencyjnych.
Is GPT-Image-2.5 Worth the Price?
Dla większości nowych integracji obrazowych OpenAI Flare jest oczywistym punktem startowym. Ma tę samą stawkę za token co GPT Image 2, a OpenAI raportuje wyższą jakość obrazów i do 50% niższą latencję. Rozszerzona drabinka jakości pozwala też mniej wydawać na szkice bez rezygnacji z opcji znacznie większego budżetu tokenów dla obrazów finalnych.
Sunburst ma większy sens, gdy koszt nieudanych edycji jest wysoki. Fotografia e-commerce, kampanie brandingowe, powtarzalne poprawki obrazów, workflow zachowania obiektu i inne produkcyjne prace kreatywne mogą uzasadniać dłuższy czas generowania, ponieważ prawdziwym celem nie jest minimalny koszt pojedynczego żądania — lecz minimalny koszt na zaakceptowany zasób.
Dla wrażliwych cenowo zadań o dużym wolumenie najsilniejszą strategią nie jest więc „zawsze używaj najtańszej jakości”. Jest nią inteligentne kierowanie zadań: Flare do generowania i eksploracji, Sunburst tam, gdzie precyzja edycji materialnie ogranicza poprawki, oraz wyższe poziomy jakości dopiero wtedy, gdy zasób zasłużył na dodatkowy budżet tokenów.
FAQ
Czy subskrypcja ChatGPT obejmuje kredyty API GPT-Image-2.5?
Nie. Dostęp do ChatGPT i rozliczenia deweloperskiego API są oddzielne. Zużycie API jest rozliczane na koncie API zgodnie z przetworzonymi tokenami.
Jakie dane o użyciu zespół powinien przechowywać do audytów kosztów?
Przechowuj: model, ustawienie jakości, wymiary obrazu, tokeny wejścia tekstowego, tokeny wejścia obrazowego, tokeny wyjścia obrazowego, liczbę ponowień oraz informację, czy wynik został zaakceptowany. Te pola umożliwiają uzgadnianie faktur i obliczanie kosztu na zaakceptowany zasób.
Jak zespoły powinny szacować koszt produkcyjny przed skalowaniem?
Uruchom reprezentatywną partię w docelowej jakości i rozmiarach, zarejestruj rzeczywiste zużycie tokenów i podziel całkowity koszt partii przez liczbę zaakceptowanych zasobów. To uwzględnia ponowienia i wskaźniki odrzuceń, których statyczny szacunek „za obraz” nie wychwyci.