
Uruchamianie Qwen3.8-Max lokalnie jest teraz możliwe, ale sformułowanie „Qwen 3.8 Max lokalnie” wymaga ważnego doprecyzowania. Hostowany produkt Max od Alibaba i pobieralny checkpoint są ze sobą ściśle powiązane, jednak nie są identycznymi produktami.
Qwen najpierw uruchomił hostowaną usługę Max na początku sierpnia 2026 r., a 12 sierpnia 2026 r. opublikował Qwen3.8-2.4T-A95B jako otwarte wagi (link). To właśnie ten checkpoint wdrażasz na swojej infrastrukturze.
To nie jest zwykły poradnik „Ollama na komputerze do gier”. Nieskwantyzowany checkpoint to model Mixture-of-Experts z 2,4 biliona parametrów, a obecna receptura vLLM wycenia jego wagi BF16 na 4,45 TiB. Nawet warianty produkcyjne z 4-bitową precyzją zmiennoprzecinkową zajmują wciąż około 1,3–1,5 TiB wag.
Szybka odpowiedź: pełne self‑hosting klasy Qwen 3.8 Max to wdrożenie w centrum danych. Praktyczny punkt startowy produkcji to checkpoint FP4 na 8× B300 lub 8× MI355X; wdrożenia na H200 wymagają większej liczby GPU. Dla zwykłej stacji roboczej użyj zamiast tego Qwen3.8-27B.
Qwen 3.8 Max vs. open model, który faktycznie wdrażasz
Pobieralny checkpoint Qwen3.8-2.4T-A95B jest oficjalnie opisany jako przyczynowy model językowy z 2,4T parametrów i około 95B parametrów aktywowanych na token. Hostowana usługa Max dodaje funkcje warstwy produktowej, które nie są obecne w aktualnym otwartym checkpointcie.
| Specyfikacja | Usługa hostowana Qwen3.8-Max | Otwarty checkpoint Qwen3.8-2.4T-A95B |
|---|---|---|
| Łączna liczba parametrów | 2,4T | 2,4T |
| Aktywne parametry | ~95B | ~95B |
| Architektura | Rzadkie MoE | Rzadkie MoE |
| Wejście | Tekst, obraz, wideo | Tekst |
| Kontekst | Zarządzany kontekst 1M | 262 144 natywnie; rozszerzalny do ~1,01M |
| Zachowanie „thinking” | Zarządzane thinking / opcje non‑thinking | Wymagane thinking; wysiłek rozumowania konfigurowalny |
| Wbudowane narzędzia | Dostępne w usłudze zarządzanej | Aplikacja musi dostarczyć narzędzia |
| Self‑hosting | Brak wymaganego zarządzania wagami | Tak; otwarty checkpoint |
Hostowany produkt obsługuje wejście tekstowe, obraz i wideo z kontekstem 1 000 000 tokenów. Dla kontrastu, otwarty checkpoint jest wyłącznie tekstowy i ma natywny kontekst 262 144 tokeny. Ta różnica ma znaczenie, jeśli Twoja aplikacja zależy od wejścia multimodalnego lub zarządzanych wbudowanych narzędzi.
Architektura i specyfikacje Qwen 3.8
CometAPI omówiło już tło modelu w What is Qwen3.8 Max, więc ten przewodnik wdrożeniowy skupia dyskusję o architekturze na szczegółach wpływających na pamięć, równoległość i serwowanie.
| Specyfikacja istotna przy wdrożeniu | Qwen3.8-2.4T-A95B |
|---|---|
| Łączne / aktywowane parametry | 2,4T / ~95B na token |
| Układ warstw | 92 warstwy: 69 Gated DeltaNet + 23 pełnej uwagi |
| Routing MoE | 512 kierowanych ekspertów; aktywne 10 kierowanych + 1 współdzielony |
| Głowy pełnej uwagi | 64 zapytań / 4 klucz‑wartość |
| Natywny kontekst | 262 144 tokeny |
| Rozszerzony kontekst | Do około 1 010 000 tokenów |
| Multi‑Token Prediction | Obsługiwane |
| Modalność otwartego checkpointu | Tylko tekst |

Oficjalna hybrydowa architektura modelu Qwen użyta w przewodniku wdrożeniowym SGLang dla Qwen3.8.
Nie interpretuj „95B aktywnych parametrów” jako śladu pamięciowego modelu 95B. Rzadka aktywacja zmniejsza obliczenia na token, ale system serwujący wciąż musi mieć dostęp do pełnego zestawu wag ekspertów.
Migawka benchmarków Qwen 3.8 Max
Ponieważ istniejący przegląd Qwen3.8 Max na CometAPI szczegółowo omawia benchmarki, ten artykuł używa jedynie podzbioru istotnego dla wdrażania z oficjalnej tabeli benchmarków w karcie modelu Qwen.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86,6 | 74,5 | 88,8 |
| SWE-bench Pro | 67,7 | 60,6 | 64,6 |
| PaperBench | 93,0 | 64,8 | 90,5 |
| FrontierSWE | 73,5 | 40,7 | — |
| CoWorkBench | 74,8 | 64,6 | 71,5 |
| GPQA Diamond | 92,6 | 92,4 | 94,1 |
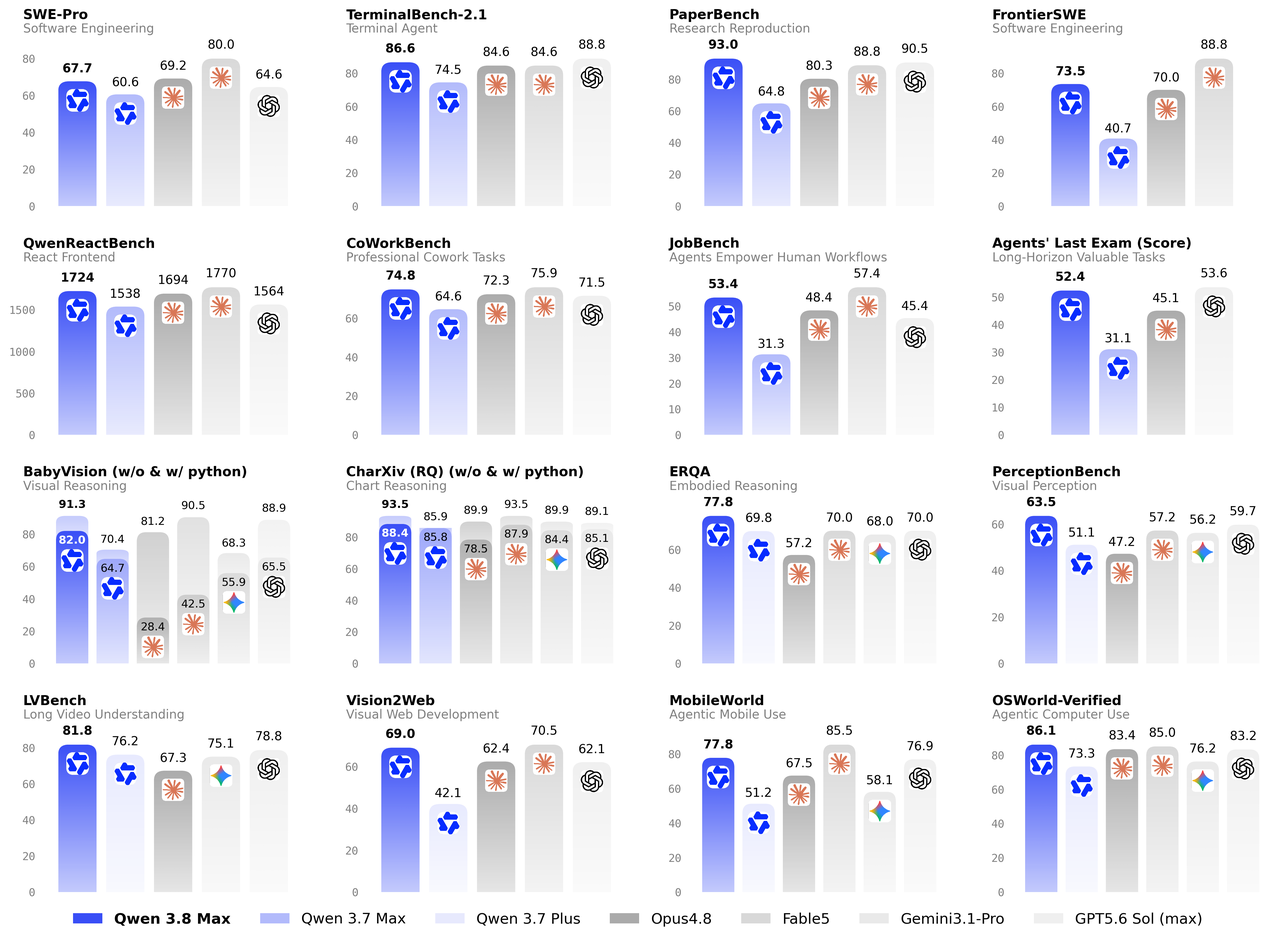
Oficjalna grafika wydajności Qwen3.8 opublikowana przez zespół Qwen.
Największe zgłoszone zyski względem Qwen3.7-Max w tym podzbiorze to PaperBench i FrontierSWE. Qwen3.8-Max przewyższa również GPT-5.6 Sol w SWE-bench Pro i PaperBench, podczas gdy GPT-5.6 Sol pozostaje z przodu w Terminal Bench 2.1. Dla decyzji wdrożeniowych traktuj je jako kontekst możliwości; poniższe pomiary pamięci i przepustowości serwowania są bardziej operacyjnie relewantne.
Tabele benchmarków nie są uniwersalnymi rankingami. Harnessy, limity czasu, limity kontekstu, dostęp do narzędzi i kwantyzacja mogą zmieniać wyniki. Benchmarkuj dokładny checkpoint, precyzję, silnik serwujący i dystrybucję promptów, których planujesz używać.
Jakiego sprzętu potrzebuje Qwen3.8 do lokalnego wdrożenia?
Wymagania GPU dla Qwen3.8-2.4T-A95B
To kluczowe pytanie wdrożeniowe. Aktualna receptura vLLM dla Qwen3.8 publikuje rozmiary checkpointów i realistyczne liczby GPU z marginesem w czasie działania, co jest bardziej użyteczne niż szacowanie VRAM tylko z liczby parametrów.
| Precyzja | Rozmiar wag | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Najlepsze dopasowanie |
|---|---|---|---|---|---|
| BF16 | 4,45 TiB | 24 GPU | 24 GPU | 48 GPU | Maksymalna wierność / badania |
| FP8 | 2,27 TiB | 16 GPU | 16 GPU | 32 GPU | Wysoka wierność w produkcji |
| MXFP4 | 1,45 TiB | — | 8 GPU | 16 GPU | Praktyczne wdrożenie na AMD |
| NVFP4 W4A4 | 1,32 TiB | 8 GPU | — | 16 GPU | Praktyczne wdrożenie na NVIDIA |
Dla większości organizacji, które rzeczywiście potrzebują self‑hostowanego Qwen3.8, FP4 to praktyczny punkt startowy. Wyróżniająca się konfiguracja NVIDIA to NVFP4 W4A4 na 8× B300; odpowiadająca ścieżka AMD to MXFP4 na 8× MI355X.
Serwer 8× H200 nie wystarcza dla tych rekomendowanych, pełnych wdrożeń modelu. Oficjalna receptura przewiduje dla H200 16 GPU dla FP4, 32 dla FP8 i 48 dla BF16.
Wymagania VRAM dla Qwen3.8-27B
Qwen3.8-27B to praktyczna alternatywa klasy stacji roboczej. Pamięć wag to około 54 GB w BF16, 27 GB w FP8 i 13,5 GB przy 4-bitowej precyzji. Narzut czasu działania i pamięć KV zwiększają rzeczywiste wymagania, zwłaszcza przy długich długościach kontekstu.
| Precyzja | Przybliżona pamięć wag | Praktyczne wskazówki wdrożeniowe |
|---|---|---|
| BF16 | ~54 GB | Użyj GPU 64–80 GB, zależnie od kontekstu i narzutu serwowania. |
| FP8 / INT8 | ~27 GB | GPU 40–48 GB zapewnia bardziej praktyczny margines w runtime. |
| 4-bit | ~13,5 GB | Konsumenckie GPU 20–24 GB mogą się sprawdzić przy umiarkowanym kontekście. |
Te liczby to szacunki planistyczne wyprowadzone z liczby parametrów. Potwierdź dokładny checkpoint, format kwantyzacji, silnik serwujący, długość kontekstu i ustawienia pamięci KV przed wymiarowaniem sprzętu produkcyjnego.
Czy Qwen3.8 da się uruchomić na konsumenckich GPU?
Pełny model Qwen3.8-2.4T-A95B nie jest praktyczny na zwykłych konsumenckich GPU, nawet przy agresywnej kwantyzacji. Projekt społecznościowy zademonstrował agresywnie skompresowaną kompilację 397 GB UD-Q1_0 na czterech systemach DGX Spark, ale to podejście to eksperymentalna, ekstremalna kwantyzacja, a nie baza dla serwowania wrażliwego na jakość.
Dla stacji roboczej lub domowego labu bardziej odpowiednim modelem jest Qwen3.8-27B, którego otwarte wagi wydano 14 sierpnia 2026 r. Model jest o rzędy wielkości łatwiejszy do hostowania i jest właściwym wyborem, jeśli „lokalnie” oznacza jedną stację roboczą, a nie klaster GPU.
Zanim zainstalujesz Qwen 3.8 Max
Zaplanuj infrastrukturę przed uruchomieniem komendy instalacyjnej. Potrzebujesz Linuksa, kompatybilnego stosu akceleratorów, wystarczającej lokalnej lub współdzielonej pamięci masowej na checkpoint, łączy GPU o wysokiej przepustowości i — w przypadku przekraczania węzłów — sieci zaprojektowanej do rozproszonego inferencjonowania. Receptura vLLM obecnie rekomenduje vLLM nightly i Transformers 5.4.0 lub nowsze.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Jak wdrożyć Qwen 3.8 w FP8 z vLLM
FP8 to sensowny wybór, gdy chcesz checkpoint dostarczony przez Qwen i możesz pozwolić sobie na infrastrukturę wielowęzłową. Oficjalny checkpoint to Qwen/Qwen3.8-2.4T-A95B-FP8.
Dla dwuwęzłowego wdrożenia 16‑GPU klasy B300 uruchom węzeł główny:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Na węźle roboczym użyj tej samej topologii z inną rangą węzła i bez serwera API:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Nie kopiuj przykładu 16‑GPU na serwery H200 bez zmiany topologii. Ten sam wariant FP8 jest obecnie wyceniany na 32× H200 w recepturze vLLM.
Jak uruchomić Qwen 3.8 na jednym serwerze 8× B300
Dla NVIDIA Blackwell najbardziej praktyczna pełna konfiguracja modelu to NVFP4. vLLM aktualnie weryfikuje NVFP4 W4A4 z równoległością tensorową na ośmiu GPU B300.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Inferact NVFP4 to checkpoint skwantyzowany, a nie oryginalny artefakt BF16 Qwen. Zweryfikuj jakość modelu na własnym zbiorze akceptacyjnym, zanim potraktujesz go jako zamiennik 1:1 dla BF16 lub FP8.
Jak wdrożyć Qwen 3.8 z SGLang
SGLang dodał wsparcie Day‑0 dla Qwen3.8 12 sierpnia i jest szczególnie atrakcyjny dla serwowania o wysokiej przepustowości, cache’owania prefiksów, równoległości ekspertów, dekodowania spekulatywnego oraz rozdzielenia prefill/decode.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang raportuje 346 tok/s wyjścia przy rozmiarze wsadu 1 na TP8 B300 z MTP oraz istotnie wyższą łączną przepustowość w rozdzielonych układach serwujących. Traktuj te liczby jako pomiary stosu serwującego, a nie benchmarki jakości modelu.
Przetestuj lokalny endpoint zgodny z OpenAI
Zarówno vLLM, jak i SGLang udostępniają API zgodne z OpenAI, co upraszcza integrację aplikacji.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Oficjalna karta modelu zaleca temperature=1.0, top_p=0.95 i top_k=20 jako bazowe parametry próbkowania. Dla pracy agentowej zostaw wystarczający budżet wyjściowy na rozumowanie, zamiast ustawiać max_tokens tylko pod finalną, widoczną odpowiedź.
Włącz okno kontekstu 1M
Otwarty checkpoint Qwen3.8-2.4T-A95B ma natywny kontekst 262 144 tokeny i można go rozszerzyć do około 1,01M. Receptura vLLM dokumentuje następujący wzorzec:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Nie ustawiaj domyślnie 1M tylko dlatego, że jest wspierane. Większe maksymalne konteksty rezerwują więcej pojemności cache i mogą gwałtownie ograniczyć współbieżność. Dobierz --max-model-len do realnego obciążenia.
Jak poprawić wydajność inferencji Qwen3.8?
Użyj MTP‑3, aby zmniejszyć opóźnienia pojedynczego użytkownika
Qwen3.8 obejmuje Multi‑Token Prediction. W opublikowanych pomiarach vLLM MTP‑3 przesuwa wyjście na użytkownika z 130 do 307 tok/s dla FP8 TP16 i z 133 do 304 tok/s dla NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Użyj fastsafetensors dla szybszego startu
Dla modeli o skali terabajtowej czas startu ma znaczenie. W jednym pomiarze vLLM ładowanie wag spadło z 545 s do 306 s dzięki fastsafetensors i leniwemu ładowaniu.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Użyj równoległości ekspertów, aby zwiększyć współbieżną przepustowość
Dla wysokiej współbieżności Qwen3.8 korzysta na układach z równoległością ekspertów, ponieważ ma 512 kierowanych ekspertów. vLLM raportuje do 3 200 łącznych tok/s/GPU dla FP8 EP i do 4 300 łącznych tok/s/GPU dla zoptymalizowanej konfiguracji NVFP4 DEP16.
Ustaw --max-model-len, aby zbalansować VRAM i współbieżność
Ustaw --max-model-len na najdłuższą sekwencję, której realnie potrzebuje obciążenie. Większa wartość rezerwuje więcej pojemności pamięci KV, zwiększa presję na pamięć i może zmniejszyć liczbę równoczesnych żądań nawet wtedy, gdy wagi modelu już się mieszczą.
Zacznij od reprezentatywnego percentyla produkcyjnego zamiast maksymalnego reklamowanego kontekstu modelu. Przeprowadź testy obciążeniowe dla wybranego limitu z tą samą precyzją, wzorcem wsadów i silnikiem serwującym, którego używasz w produkcji, a następnie podnoś limit tylko wtedy, gdy realne żądania potrzebują więcej kontekstu.
Lokalna instalacja Qwen 3.8 Max vs. API
Otwarte wagi nie czynią automatycznie lokalnej inferencji ekonomiczną. Właściwa decyzja zależy od wykorzystania, rezydencji danych, zasobów kadrowych, celów dostępności oraz od tego, czy faktycznie potrzebujesz funkcji multimodalnych zarządzanego modelu.
| Wymiar | Self‑hosting Qwen3.8-2.4T-A95B | Qwen3.8-Max przez CometAPI |
|---|---|---|
| Infrastruktura | Serwer wielo‑GPU lub klaster | Brak infrastruktury GPU |
| Modalność wejścia | Tekst | Tekst, obraz, wideo |
| Kontekst | 262K natywnie; ~1,01M rozszerzony | Zarządzane 1M |
| Kontrola danych | Maksymalna | Cloud API |
| Operacje | Ty odpowiadasz za monitoring, aktualizacje i HA | Zarządzane przez dostawcę |
| Najlepsze dopasowanie | Rezydencja danych, stałe wykorzystanie, zespół infrastruktury | Większość zespołów aplikacyjnych i zmienne obciążenia |
Jeśli już posiadasz odpowiednie akceleratory i masz konsekwentnie wysokie wykorzystanie, self‑hosting może być uzasadniony. Jeśli kupowałbyś klaster wyłącznie pod ten model, Qwen3.8-Max na CometAPI jest zwykle mniej kłopotliwą ścieżką. Istniejący przewodnik API obejmuje integrację hostowaną, a przewodnik cenowy omawia modelowanie kosztów; ten artykuł pozostaje więc skoncentrowany na lokalnym wdrożeniu.
Częste problemy przy lokalnym wdrożeniu Qwen 3.8
Serwer kończy pamięć GPU podczas startu
Najpierw zmniejsz --max-model-len, jeśli problemem jest cache. Jeśli same wagi się nie mieszczą, redukcja kontekstu nie rozwiąże problemu u podstaw; przejdź na zweryfikowany checkpoint o niższej precyzji albo dodaj GPU.
Równoległość tensorowa kończy się błędem nieprawidłowego rozmiaru
Qwen3.8 ma 64 głowy uwagi w warstwach pełnej uwagi, więc vLLM wymaga, aby TP dzieliło 64. Proste rozmiary TP to 1, 2, 4, 8, 16 i 32. Sama łączna VRAM nie wystarcza więc do wyboru topologii.
Serwer długo się uruchamia
Załadowanie jednego do kilku terabajtów wag plus JIT jąder może zająć minuty. Zwiększ VLLM_ENGINE_READY_TIMEOUT_S i sprawdzaj realny endpoint inferencji zamiast zakładać krótki czas startu.
Lokalny model nie przetwarza obrazu
To oczekiwane. Otwarty checkpoint Qwen3.8-2.4T-A95B jest tylko tekstowy. To ograniczenie dotyczy Qwen3.8-2.4T-A95B. Qwen3.8-27B obsługuje wejście wizualne, gdy załadowane są jego osobne pliki projekcji wizji.
Kontekst 1M dramatycznie redukuje przepustowość
Zredukuj --max-model-len do najdłuższej sekwencji, której faktycznie potrzebuje obciążenie. Największe wspierane okno kontekstu nie jest koniecznie najlepszym ustawieniem produkcyjnym; wybierz limit kontekstu równoważący wymagania obciążenia, użycie pamięci KV i współbieżność.
Czy Ollama lub LM Studio mogą uruchomić Qwen 3.8 Max?
Ekosystem może pakować mocno skwantyzowane wagi Qwen3.8 do inferencji w stylu llama.cpp, ale nie należy tego mylić z normalnym, desktopowym workflow w Ollama. Skwantyzowana kompilacja zajmująca setki gigabajtów wciąż wymaga setek gigabajtów dostępnej pamięci i wiąże się ze znacznymi kompromisami jakości i wydajności.
Dla zwykłego lokalnego developmentu odpowiednim celem jest Qwen3.8-27B. Pełny model 2,4T należy traktować jako model serwerowy/klastrowy nawet wtedy, gdy ekstremalne kwantyzacje społecznościowe czynią go technicznie uruchamialnym na nietypowym sprzęcie.
Którą metodę wdrożenia wybrać?
Dla NVIDIA Blackwell najbardziej „czysty” punkt startowy pełnego modelu to obecnie wdrożenie NVFP4 na 8× B300. Dla AMD odpowiadająca praktyczna konfiguracja to 8× MI355X z MXFP4. Używaj FP8, gdy priorytetem są pochodzenie checkpointu i jakość ponad wielkość infrastruktury, a BF16 tylko wtedy, gdy maksymalna wierność uzasadnia wymagania pamięci na skalę wielu szaf.
Dla stacji roboczej użyj Qwen3.8-27B. Dla zespołów aplikacyjnych, które potrzebują możliwości Max bez operowania klastrem GPU, użyj hostowanego modelu Qwen3.8-Max na CometAPI.
Konkluzja
Qwen3.8-Max przekroczył ważną granicę od czasu początkowego uruchomienia API: rodzina Qwen klasy Max ma teraz otwarty checkpoint 2,4T, który organizacje mogą w pełni obsługiwać na własnej infrastrukturze.
Ale otwarte wagi nie oznaczają sprzętu konsumenckiego. Ślad 4,45 TiB w BF16, checkpoint 2,27 TiB w FP8 i warianty FP4 o rozmiarze 1,3–1,5 TiB czynią Qwen3.8-2.4T-A95B jednym z najbardziej zasobożernych otwartych modeli dostępnych. Praktyczną zaletą jest to, że vLLM i SGLang już wspierają tę architekturę, a FP4 umożliwia wdrożenie na jednym węźle 8× B300 lub 8× MI355X.
Hostuj samodzielnie, gdy kontrola danych, stałe wykorzystanie i posiadanie infrastruktury uzasadniają klaster. W przeciwnym razie użyj zarządzanego API Max — lub Qwen3.8-27B, gdy tak naprawdę chcesz mocnego modelu Qwen na jednej stacji roboczej.