
TLDR Claude Haiku 5.5 jest określany jako najtańszy, najszybszy i najbardziej wydajny mały model, jaki kiedykolwiek wydano. Zaprojektowany do obciążeń o dużej skali i wrażliwych na opóźnienia, takich jak klasyfikacja, ekstrakcja, routing, streszczanie i zadania subagentów, oferuje 1-million-token context window, do 128K output tokens oraz adaptacyjne myślenie z regulowanymi poziomami wysiłku.
Średnio jego koszt działania jest o około 75% niższy niż w przypadku Haiku 4.5, przy jednoczesnych dużych wzrostach wyników na benchmarkach z zakresu agentów i obsługi komputera. Deweloperzy mają do niego dostęp przez oficjalne Claude API (claude-haiku-5-5), Amazon Bedrock, Google Cloud, Microsoft Foundry lub zoptymalizowane kosztowo bramy, takie jak CometAPI (od $0.08 / $0.40).
Key Takeaways
- Release & Positioning: Wydany 7 października 2026 r. jako mały, wysokoprzepustowy model w rodzinie Claude 5.5 — idealny do wsparcia w czasie rzeczywistym, przetwarzania dokumentów i delegowanych kroków agentów.
- Core Specs: 1M-token context, 128K max output (300K przez Batch API w wersji beta), adaptive thinking (domyślnie medium effort), wejście tekst + obraz → wyjście tekst, knowledge cutoff czerwiec 2026.
- Pricing Advantage: $0.10 input / $0.50 output per million tokens dla promptów do 100K (≈90% taniej niż Haiku 4.5 dla większości żądań); wyższy próg powyżej 100K. Cache reads już od $0.01. CometAPI oferuje ≈20% niższe stawki Standard.
- Performance Leap: Duże skoki vs Haiku 4.5 (np. OSWorld 72.4% vs 15.7%, Terminal-Bench 39.2% vs 0%, GDPval-AA 1620 vs 735 Elo), przy konkurencyjności lub przewadze nad GPT-6 Luna w wielu testach.
- Developer Features: Parametr effort (low–max), prompt caching, Batch API (50% taniej), computer/browser use (beta SDK). Parametry temperature/top_p/top_k muszą być pominięte, w przeciwnym razie wystąpi błąd 400.
What Is Claude Haiku 5.5 and Why It Matters in 2026
Claude Haiku 5.5 to najnowsza propozycja Anthropic w lekkim segmencie rodziny Claude. W odróżnieniu od droższych modeli Opus 5.5 i Sonnet 5.5, zoptymalizowanych pod kątem złożonego rozumowania i długohoryzontowych agentów, Haiku 5.5 jest zaprojektowany z myślą o obciążeniach na dużą skalę, wrażliwych na koszt i opóźnienia. Anthropic opisuje go jako „najtańszy, najszybszy i najbardziej zdolny mały model, jaki kiedykolwiek wydaliśmy”.
Typowe zastosowania produkcyjne obejmują:
- Klasyfikację zgłoszeń i routing w obsłudze klienta
- Ekstrakcję pól i streszczanie długich dokumentów
- Kompaktowanie historii rozmów dla większych modeli
- Zapytania w stylu baz danych i zadania na danych strukturalnych
- Szybkie subagenty obsługujące wąskie zadania kodowe, użycie narzędzi lub przeglądarki, podczas gdy silniejszy model orkiestruje
Ponieważ jest dramatycznie tańszy i szybszy niż jego poprzednik, a jednocześnie w dużej mierze zamyka lukę jakościową w praktycznych zadaniach agentowych, wiele zespołów przeprojektowuje pipeline’y tak, aby Haiku 5.5 obsługiwał większość żądań, a trudniejsze przypadki były eskalowane do Sonnet lub Opus. Wczesne opinie klientów z Asana, HubSpot, Box i innych wskazują na ponad 30% redukcję opóźnień i mierzalne wzrosty dokładności w wewnętrznych ewaluacjach o dużej skali.
Technical Specifications of Claude Haiku 5.5
| Specification | Value | Notes |
|---|---|---|
| Model ID (Claude API) | claude-haiku-5-5 | No date suffix |
| Amazon Bedrock | anthropic.claude-haiku-5-5 (or global/us/eu/au/jp profiles) | |
| Context window | 1,000,000 tokens | ≈555k words with new tokenizer |
| Max output (Messages API) | 128,000 tokens | 300K with Batch API + beta header |
| Input modalities | Text + images | |
| Output modality | Text | |
| Thinking | Adaptive (on by default) | Controlled via effort |
| Default effort | medium | Options: low, medium, high, xhigh, max |
| Knowledge cutoff | June 2026 | |
| Retirement commitment | Not before October 7, 2027 | |
| Tokenizer | Newer (same family as Claude 4.7+) | Same text ≈30% more tokens than Haiku 4.5 |
Source: Anthropic model overview and platform documentation.
Większe limity kontekstu i wyjścia, w połączeniu z adaptacyjnym rozumowaniem, sprawiają, że Haiku 5.5 jest znacznie bardziej użyteczny w realnych systemach produkcyjnych niż wcześniejsze małe modele, które wymagały agresywnego przycinania lub stałych budżetów myślenia.
Responses and completion checks
Czytaj bloki treści według typów, zamiast zakładać, że content[0] to widoczna odpowiedź. Sprawdź stop_reason przed zaakceptowaniem wyniku: max_tokens wskazuje na uciętą generację, a refusal wymaga jawnej odpowiedzi aplikacji. Dla żądań z narzędziami przetwarzaj bloki tool-use i zwracaj wyniki narzędzi w natywnym formacie, zamiast traktować je jako ukończoną odpowiedź tekstową.
What Changed Compared With Claude Haiku 4.5 API?
Capacity, behavior and pricing changes
| Dimension | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Context window | 200K | 1M | 1M |
| Maximum output | 64K | 128K | 128K |
| Adaptive effort | No | Yes | Yes |
| Anthropic input / MTok | $1.00 | $0.10 | $2.00 |
| Anthropic output / MTok | $5.00 | $0.50 | $10.00 |
| Positioning | Legacy fast model | Routine work at scale | Harder complex tasks |
Ceny Haiku 5.5 w tym porównaniu dotyczą promptów do 100,000 tokenów; większe prompty kosztują więcej. To stawki Anthropic Standard, a nie stawki CometAPI. Porównanie stanowi punkt wyjścia do routingu, a nie twierdzenie, że modele działają identycznie.
Dla integracji Haiku 4.5 kluczowe zmiany implementacyjne to adaptacyjne myślenie zamiast ręcznego budżetu, kontrola effort, selektywne parsowanie bloków treści i zaktualizowane liczenie tokenów. Ten sam tekst może zużywać około 30% więcej tokenów wejściowych. Przelicz reprezentatywne prompty zamiast ponownie używać szacunków Haiku 4.5. Sekcja migracji zamienia te zmiany w listę kontrolną wdrożenia.
Reported benchmark improvements
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| OSWorld 2.1 (offline subset; partial credit) | 15.7% | 72.4% | 83.9% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Humanity’s Last Exam (no tools) | 10.2% | 45.9% | 56.9% |
| Chartography (no tools) | 6.4% | 46.4% | 61.6% |
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
Anthropic raportuje powyższe wyniki w podsumowaniu benchmarków wydania. To wyniki ewaluacji, a nie testy na żywo przykładów CometAPI z tego przewodnika. OSWorld 72.4% to częściowy kredyt, a nie ścisły wskaźnik ukończenia zadań.
Haiku 5.5 system card opisuje warunki ewaluacji. Standardowe ewaluacje Haiku 5.5 używają adaptacyjnego myślenia na max effort i domyślnych ustawień próbkowania, chyba że zaznaczono inaczej; domyślny poziom produktu to medium. OSWorld używa 82 zadań offline, bez dostępu do internetu, rozdzielczość 1080p i limit 500 akcji. Terminal-Bench 4.0 używa Claude Code w trybie bare, bez wyjścia do internetu i 10 prób na zadanie dla Haiku 5.5; konfiguracja Sonnet jest inna. Wiersze HLE i Chartography powyżej są bez narzędzi. GDPval-AA raportuje ranking Elo z ewaluacji Artificial Analysis. Dopasuj odpowiednie harnessy, effort i ustawienia narzędzi podczas porównywania wyników.
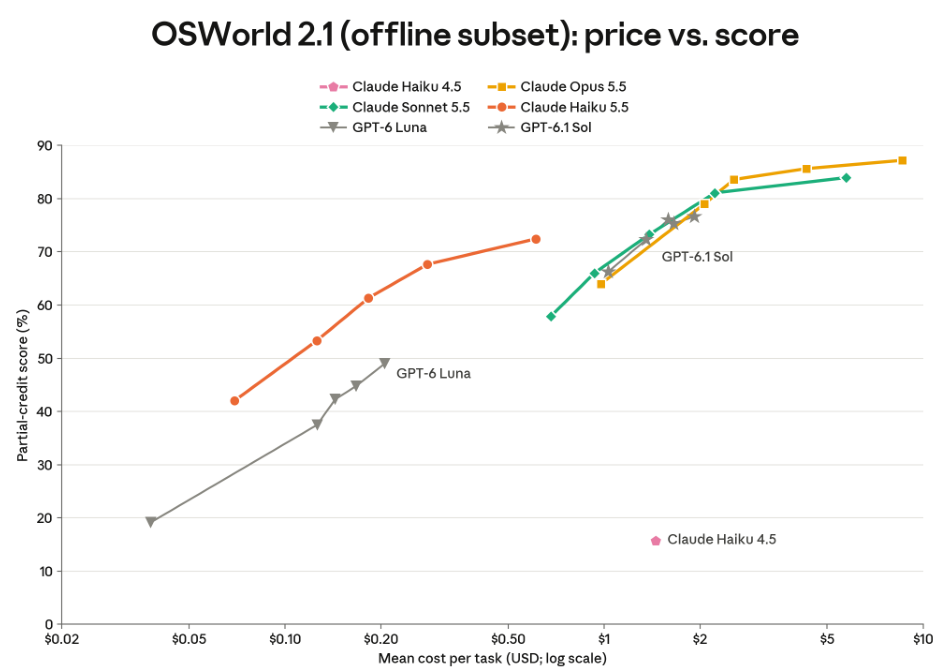
Oryginalna grafika OSWorld od Anthropic pokazuje relację między effort, kosztem na zadanie i wynikiem z częściowym kredytem. Nie mierzy opóźnień API ani nie gwarantuje tej samej wydajności w Twoim obciążeniu.
Wyniki wskazują na znacznie lepszą obsługę komputera i ogólną wydajność zadań niż w Haiku 4.5, ale nie gwarantują tych samych rezultatów w Twojej aplikacji. Uruchom reprezentatywny zestaw ewaluacji przed skierowaniem ruchu produkcyjnego.
Tabela benchmarków i dostarczona grafika są zachowane jako porównania modeli. To raportowane ewaluacje, a nie testy na żywo przykładów CometAPI. Używaj tej samej dystrybucji zadań, effort i ustawień narzędzi podczas ewaluacji aplikacji; wynik benchmarku nie wyznacza opóźnienia bramy ani Twojego wskaźnika sukcesu.
How to Use Claude Haiku 5.5 API Through CometAPI
Create a key and choose the native route
Utwórz konto CometAPI, potwierdź dostęp do claude-haiku-5-5 i wygeneruj serwerowy klucz API. Ustaw COMETAPI_KEY w środowisku. Przechowuj klucz poza systemem kontroli wersji i kodem w przeglądarce. Klucze Anthropic i CometAPI należą do różnych dostawców; w tym zaktualizowanym przewodniku używaj klucza CometAPI we wszystkich przykładach.
export COMETAPI_KEY="your_cometapi_api_key"
pip install --upgrade anthropic
$env:COMETAPI_KEY="your_cometapi_api_key"
| Integration | SDK base URL | Request path | Credential |
|---|---|---|---|
| Anthropic-compatible Messages | https://api.cometapi.com | /v1/messages | COMETAPI_KEY |
| OpenAI-compatible Chat Completions | https://api.cometapi.com/v1 | /chat/completions | COMETAPI_KEY |
CometAPI supports Claude’s native Messages and content-block format. Użyj SDK Anthropic z bazowym adresem URL CometAPI. Native Messages to preferowana ścieżka w tym przewodniku dla specyficznego dla Claude „thinking” i bloków treści. Zgodny route Chat Completions jest opcją dla istniejącej aplikacji w stylu OpenAI. Potwierdź wsparcie pól zaawansowanych na dokładnie tej trasie bramy.
Send a minimal request and verify the result
curl https://api.cometapi.com/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $COMETAPI_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-haiku-5-5",
    "max_tokens": 2048,
    "output_config": {"effort": "low"},
    "messages": [{"role": "user", "content": "Summarize three AI uses in customer support."}]
  }'
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",
    timeout=60.0,
    max_retries=2,
)

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{"role": "user", "content": "Classify this ticket: I cannot log in."}],
)
if response.stop_reason != "end_turn":
    raise RuntimeError(f"Unaccepted completion: {response.stop_reason}")
print("".join(block.text for block in response.content if block.type == "text"))
print(response.usage)
Zapisz przykład w Pythonie jako example.py i uruchom python example.py. Pomyślny checkpoint to ukończona odpowiedź z widocznym tekstem i polami usage. Błąd uwierzytelnienia oznacza konieczność sprawdzenia klucza; błąd model/route oznacza konieczność sprawdzenia identyfikatora modelu, endpointu lub dostępu konta.
Use the same native format from JavaScript
npm install @anthropic-ai/sdk
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com",
  timeout: 60_000,
  maxRetries: 2,
});
const response = await client.messages.create({
  model: "claude-haiku-5-5",
  max_tokens: 2048,
  output_config: {effort: "low"},
  messages: [{role: "user", content: "Extract product, quantity and price: 3 laptops at $900 each."}],
});
if (response.stop_reason !== "end_turn") {
  throw new Error("Unaccepted completion: " + response.stop_reason);
}
for (const block of response.content) {
  if (block.type === "text") console.log(block.text);
}
Użyj wspieranej wersji Node.js. Zapisz plik jako example.mjs, ustaw COMETAPI_KEY i uruchom node example.mjs. Zapisz wersję SDK, którą weryfikujesz do wdrożenia.
Adapt an existing OpenAI-compatible application
Jeśli Twoja aplikacja używa już Chat Completions, zainstaluj pakiet openai i skonfiguruj osobnego klienta poniżej. Ta trasa zwraca choices zamiast natywnych bloków treści. Zachowaj oddzielne parsowanie specyficzne dla trasy i przetestuj thinking, obrazy i narzędzia, zanim polegniesz na tłumaczeniu bramy.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    messages=[
        {"role": "system", "content": "Be concise and helpful."},
        {"role": "user", "content": "Explain API rate limits."},
    ],
)
print(response.choices[0].message.content)
Sending images to Claude Haiku 5.5 API
Użyj obrazu wraz z instrukcją, która precyzuje oczekiwane dowody i wynik. Oficjalny interfejs vision akceptuje bloki treści z obrazem z danymi base64, adresem URL obrazu lub wspieranym odwołaniem do przesłanego pliku. Ten przykład czyta lokalny plik PNG, umieszcza obraz przed pytaniem i prosi o wartości, które można sprawdzić względem źródła.
Przeanalizuj realny lokalny PNG przez natywne Anthropic Messages API.
import os
import base64
from pathlib import Path
import anthropic

# Replace dashboard.png with a real PNG file you are authorized to analyze.
image_data = base64.b64encode(Path("dashboard.png").read_bytes()).decode("ascii")
anthropic_client = anthropic.Anthropic(api_key=os.environ["ANTHROPIC_API_KEY"])
response = anthropic_client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=2048,
    output_config={"effort": "low"},
    messages=[{
        "role": "user",
        "content": [
            {"type": "image", "source": {
                "type": "base64", "media_type": "image/png", "data": image_data
            }},
            {"type": "text", "text": (
                "Read the visible dashboard metrics. List anomalies with their "
                "labels and values, and state when text is unreadable."
            )},
        ],
    }],
)
for block in response.content:
    if block.type == "text":
        print(block.text)
Użyj typu MIME, który odpowiada rzeczywistemu plikowi. Sprawdź czytelność, wymiary obrazu i limity rozmiaru żądania przed wysyłką; unikaj wysyłania obrazów wysokiej rozdzielczości, które nie pomagają w zadaniu. Dla CometAPI zmień klucz i bazowy adres URL, jak pokazano w przykładzie Messages, i zweryfikuj obsługę obrazów na dokładnie tej trasie.
Controlling Claude Haiku 5.5 reasoning
Haiku 5.5 domyślnie używa adaptacyjnego myślenia. Oficjalna konfiguracja thinking wyjaśnia, kiedy disabled jest akceptowane i jak zwracane są bloki thinking. Ustaw effort przez output_config.effort; nie używaj legacy budget_tokens.
| Effort | Good starting use case | Trade-off |
|---|---|---|
| low | Short classification, simple extraction | Typically lower token use and latency |
| medium | Support responses, routine agent work | Balanced default |
| high | Multi-step document analysis | Potentially more reasoning |
| xhigh | Difficult evaluations | More processing and cost |
| max | Reasoning-intensive cases | Highest potential reasoning expenditure |
Skonfiguruj adaptacyjne myślenie z low effort.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)response = anthropic_client.messages.create( model="claude-haiku-5-5", max_tokens=4096, thinking={"type": "adaptive"}, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Classify as billing, technical, or account: cannot log in."}],)for block in response.content: if block.type == "text": print(block.text)
Deweloperzy mogą wyłączyć thinking na low, medium i high effort, ale nie na xhigh ani max. Thinking zużywa rozliczane tokeny wyjściowe i budżet max_tokens, nawet gdy jego tekst jest ukryty. Pusty blok thinking może nadal zawierać sygnaturę; nie dowodzi to, że rozumowanie nie wystąpiło. Zachowuj zwrócone bloki treści bez zmian podczas kontynuowania rozmów z narzędziami.
Example request with thinking disabled
Wyślij natywne body żądania z wyłączonym thinking.
{ "model": "claude-haiku-5-5", "max_tokens": 1024, "thinking": {"type": "disabled"}, "output_config": {"effort": "low"}, "messages": [ {"role": "user", "content": "Return sentiment only: positive, neutral, negative."} ]}
Streaming Claude Haiku 5.5 responses
Streaming dostarcza widoczny tekst stopniowo i poprawia responsywność w aplikacjach interaktywnych. Traktuj strumieniowany tekst jako prowizoryczny, dopóki żądanie nie zakończy się powodzeniem.
Streamuj widoczny tekst z użyciem Anthropic Python SDK.
import osimport anthropicanthropic_client = anthropic.Anthropic( api_key=os.environ["ANTHROPIC_API_KEY"],)with anthropic_client.messages.stream( model="claude-haiku-5-5", max_tokens=4096, output_config={"effort": "low"}, messages=[{"role": "user", "content": "Explain API caching."}],) as stream: for text in stream.text_stream: print(text, end="", flush=True)
Claude Haiku 5.5 API Pricing
Compare token rates and prompt-length bands
Stawki sprawdzone 8 października 2026 r. Tabela porównuje Anthropic Standard pricing z opublikowanymi stawkami CometAPI, w USD za milion tokenów. Próg określa długość promptu: do 100,000 tokenów versus ponad 100,000. Dłuższe żądania używają odpowiednio wyższych stawek, a nie tylko dopłaty za nadwyżkę tokenów. Rozliczenia kont, użycie cache i opcjonalne narzędzia należy rozliczać osobno.
| Token category | Anthropic ≤100K | CometAPI ≤100K | Anthropic >100K | CometAPI >100K |
|---|---|---|---|---|
| Input | $0.10 | $0.08 | $0.50 | $0.40 |
| Output | $0.50 | $0.40 | $2.50 | $2.00 |
| Cache read | $0.01 | $0.008 | $0.05 | $0.04 |
| 5-min cache write | $0.125 | $0.10 | $0.625 | $0.50 |
| 1-hour cache write | $0.20 | $0.16 | $1.00 | $0.80 |
Zachowano migawkę stawek z oryginalnego artykułu. Sprawdź aktualną listę CometAPI i rozliczenia konta przed zakupem lub wdrożeniem; startowa stawka input na liście nie stanowi pełnej wyceny dla każdego progu długości promptu, operacji cache ani opcjonalnych narzędzi.
Example: Cost of 100,000 support requests
Załóż 100,000 żądań miesięcznie, każde z 2,000 tokenami wejściowymi i 300 rozliczanymi tokenami wyjściowymi, łącznie z wygenerowanym thinking. Każdy prompt kwalifikuje się do progu do 100K. Wyklucz cache, opłaty za narzędzia i ponowienia.
| Component | Usage | Anthropic | CometAPI |
|---|---|---|---|
| Input | 200M tokens | $20.00 | $16.00 |
| Output | 30M tokens | $15.00 | $12.00 |
| Total | 100,000 requests | $35.00 | $28.00 |
Przy tych założeniach ilustracyjna różnica wynosi $7 miesięcznie, czyli 20%. Koszty produkcyjne zależą od długości żądań, ukrytego rozumowania, cache i zachowania ponowień.
Użyj aktualnego licznika tokenów modelu w obliczeniach. Cost = input tokens × applicable input rate / 1,000,000 + billed output tokens × applicable output rate / 1,000,000, plus osobno naliczane opłaty za cache, narzędzia i ponowienia. Tokeny thinking są częścią rozliczanych tokenów wyjściowych.
Reduce cost without losing accepted-task quality
| Optimization | Action | Benefit |
|---|---|---|
| Effort tuning | Use low where quality allows | Lower reasoning overhead |
| Prompt reduction | Remove redundant conversation history | Fewer input tokens |
| Prompt caching | Keep reused context stable | Lower repeated input cost |
| Streaming | Render tokens as they arrive | Better perceived responsiveness |
| Schema validation | Reject malformed records early | Less downstream rework |
| Model routing | Escalate complex tasks | Better cost-quality balance |
| Batch processing | Batch eligible offline requests | Potential additional savings |
Nie wybieraj automatycznie najniższego effort. Tańsze pojedyncze wywołanie może zwiększyć całkowite koszty, jeśli powoduje więcej ponowień. Oceń dokładność, opóźnienia p50/p95, użycie tokenów i koszt na zaakceptowane zadanie.
W przypadku prompt caching utrzymuj stabilny prefiks i sprawdzaj tworzenie cache oraz użycie cache read zamiast zakładać trafienie. Haiku 5.5 ma 512-tokenowe minimalne cacheable prompt w udokumentowanym Claude API. Zmiana effort może unieważnić cache’owane prefiksy; utrzymuj stabilne ustawienia w ramach rozmowy. Okno kontekstu 1M to sufit pojemności, a nie rekomendacja przesyłania każdego dokumentu przy każdej turze.
Zachowaj stabilny, wielokrotnego użytku prefiks do cache, skracaj niepotrzebne wejścia i testuj zmiany effort. Streaming poprawia postrzeganą responsywność, a nie automatycznie zmniejsza rozliczane użycie. Porównuj koszt na zaakceptowane zadanie w całym workflow, łącznie z ponowieniami i wywołaniami narzędzi.
Claude Haiku 4.5 to Haiku 5.5 Migration Guide
Update the integration and request format
| Area | Migration action |
|---|---|
| Model ID | Replace with claude-haiku-5-5 |
| Thinking | Replace manual budget_tokens with adaptive thinking |
| Effort | Use output_config.effort if needed |
| Sampling | Omit temperature, top_p and top_k; any top_k value is unsupported |
| Response parser | Handle multiple content-block types |
| Output budget | Allow sufficient room for reasoning and final output |
| Prefill | Remove unsupported assistant prefilling |
| Caching | Retest prompts when changing effort |
| Tool integrations | Verify supported tool versions |
Dla trasy CometAPI użytej tutaj zachowaj COMETAPI_KEY i natywny bazowy adres URL, jednocześnie zmieniając identyfikator modelu i konfigurację żądania. Zastąp legacy enabled thinking z budżetem adaptacyjnym thinking i effort. Usuń assistant prefilling i pomiń parametry sampling. Zachowaj rozróżnienie między natywną tablicą content Claude a odpowiedzią choices w trasie kompatybilnej.
Preserve state and recalculate budgets
Oficjalny przewodnik migracji Haiku 5.5 raportuje około 30% więcej tokenów wejściowych dla identycznego tekstu niż Haiku 4.5. Przelicz reprezentatywne prompty i dostrój limity przed przeniesieniem ruchu. Zwrócone bloki thinking działają tylko w koncie, które je wygenerowało, lub powiązanym koncie; zmiana konta może po cichu odrzucić te bloki. Zachowuj prefiks rozmowy jako append-only, zamiast modyfikować wcześniejsze wiadomości po generacji. Sprawdzaj stop_reason, w tym max_tokens i refusal, i obsługuj je jawnie przed zaakceptowaniem wyniku.
Przelicz reprezentatywne prompty na docelowym modelu i dostrój max_tokens, limity opóźnień i szacunki kosztów żądań. Testuj zapisane rozmowy względem konta i trasy bramy, na której będą odtwarzane; nie zakładaj, że podpisane bloki thinking są przenośne między niezwiązanymi kontami lub przepisywanymi prefiksami rozmów.
Conclusion
Claude Haiku 5.5 stanowi realny punkt zwrotny dla wydajnych kosztowo, wysokoprzepustowych zastosowań AI. Dostarczając znacznie lepszą wydajność agentową i w użyciu komputera przy około jednej dziesiątej wcześniejszej ceny Haiku w większości żądań, Anthropic uczynił praktycznym wdrożenie na dużą skalę zdolnych małych modeli. Niezależnie od tego, czy korzystasz z oficjalnego API, Amazon Bedrock, czy używasz zunifikowanej bramy, takiej jak CometAPI, dla dodatkowych oszczędności i prostoty operacyjnej, kombinacja szybkości, możliwości i ceny otwiera nowe możliwości produktowe, które wcześniej były nieopłacalne.