
Najszybszym sposobem użycia GLM-5.3 Flash API jest wywołanie modelu przez zgodny z OpenAI endpoint chat-completions w CometAPI. Szczegóły połączenia zebrano w poniższej tabeli specyfikacji API; klucz API trzymaj na serwerze.
Odpowiedz najpierw: utwórz klucz CometAPI, zainstaluj zgodne z OpenAI SDK, wyślij żądanie POST do /v1/chat/completions, a dopiero po powodzeniu podstawowego zapytania dodawaj streaming, wizję, wyjście JSON lub narzędzia.
Czym jest GLM-5.3 Flash API?
GLM-5.3 Flash to natywny, zorientowany na efektywność model multimodalny Z.ai z rodziny GLM-5. Udostępnia rozumowanie, długi kontekst, rozumienie wizualne oraz możliwości ukierunkowane na agenty przez chat API. Model zawiera 320B całkowitych parametrów, ale aktywuje 18B na token; ta architektura ma znaczenie kosztowe, jednak deweloperzy odczuwają to głównie jako model, który potrafi pozostać „aktywny” przy długich promptach i wielokrotnych wywołaniach narzędzi.
Ten przewodnik celowo skraca opis architektury i benchmarków. Towarzyszący artykuł przeglądowy modelu już wyjaśnia hybrydowy projekt uwagi, otwarte wagi, pełną macierz benchmarków startowych, tło cenowe i porównanie rodziny modeli. Tutaj skupiamy się na zachowaniu integracji i decyzjach produkcyjnych.
Specyfikacja API istotna dla integracji
| Specyfikacja API | Wartość | Znaczenie praktyczne |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Skonfiguruj to raz w kliencie po stronie serwera. |
| Endpoint | POST /v1/chat/completions | Używaj trasy chat-completions zgodnej z OpenAI. |
| Compatible SDKs | OpenAI-compatible Python and JavaScript clients | Wykorzystaj znajome wzorce klienta z bazowym adresem CometAPI. |
| Authentication | Bearer API key | Przechowuj klucz po stronie serwera w zmiennej środowiskowej lub menedżerze sekretów. |
| Model code | glm-5.3-flash | Użyj dokładnie tej wartości w treści żądania. |
| Context window | 1,048,576 tokens | Odpowiednie dla dużych repozytoriów, pakietów dokumentów i długiej historii agenta. |
| Maximum output | Up to 131,072 tokens | Ustaw niższy limit specyficzny dla aplikacji, aby kontrolować koszt i opóźnienia. |
| Native inputs | Text, image, video, file | Obsługa hostowanych tras może się różnić; zweryfikuj dokładną trasę CometAPI przed użyciem każdego trybu. |
| Output | Text | Model interpretuje multimedia, ale nie zwraca bezpośrednio generowanych obrazów ani wideo. |
| Reasoning | low, high, max | Używaj poziomów wysiłku, aby wymieniać opóźnienie i zużycie tokenów na głębokość. |
| Thinking | Always enabled | Nie wysyłaj parametru próbującego wyłączyć „thinking”. |
| Developer features | Streaming, function calling, caching, structured output | Przydatne dla aplikacji interaktywnych, agentów i przepływów maszynowo-czytelnych. |
Zdolności modelu i bramy nie są identyczne. Traktuj żywą stronę modelu CometAPI i schemat API jako kontrakt dla trasy, którą faktycznie wywołujesz, szczególnie w kontekście wideo, plików, ścisłego JSON Schema i specyficznych pól „thinking” dostawcy.
Krótki kontekst wydajności
Z.ai raportuje mocne wyniki startowe w zadaniach ważnych dla twórców API: praca w terminalu, inżynieria oprogramowania, użycie narzędzi i automatyzacja. To wyniki raportowane przez dostawcę, uzyskane przy użyciu określonych narzędzi i zasad użycia narzędzi, więc pomagają wskazać prawdopodobne mocne strony, a nie ustanowić uniwersalny ranking.
| Benchmark | GLM-5.3 Flash | Co sugeruje dla obciążeń API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Silne dopasowanie do agentów kodujących w terminalu. |
| DeepSWE v1.1 | 63.4 | Obiecujące możliwości inżynierii na skalę repozytorium. |
| Toolathlon Verified | 78.4 | Silny sygnał doboru i użycia narzędzi. |
| AutomationBench | 48.8 | Lepsza wieloetapowa automatyzacja względem poprzednika. |
Praktyczna implikacja jest węższa niż sama tabela: GLM-5.3 Flash to mocny kandydat, gdy przepływ łączy długi kontekst z narzędziami lub feedbackiem wizualnym. Dla pełnego porównania modeli użyj istniejącego przeglądu modelu zamiast powielać go tutaj.
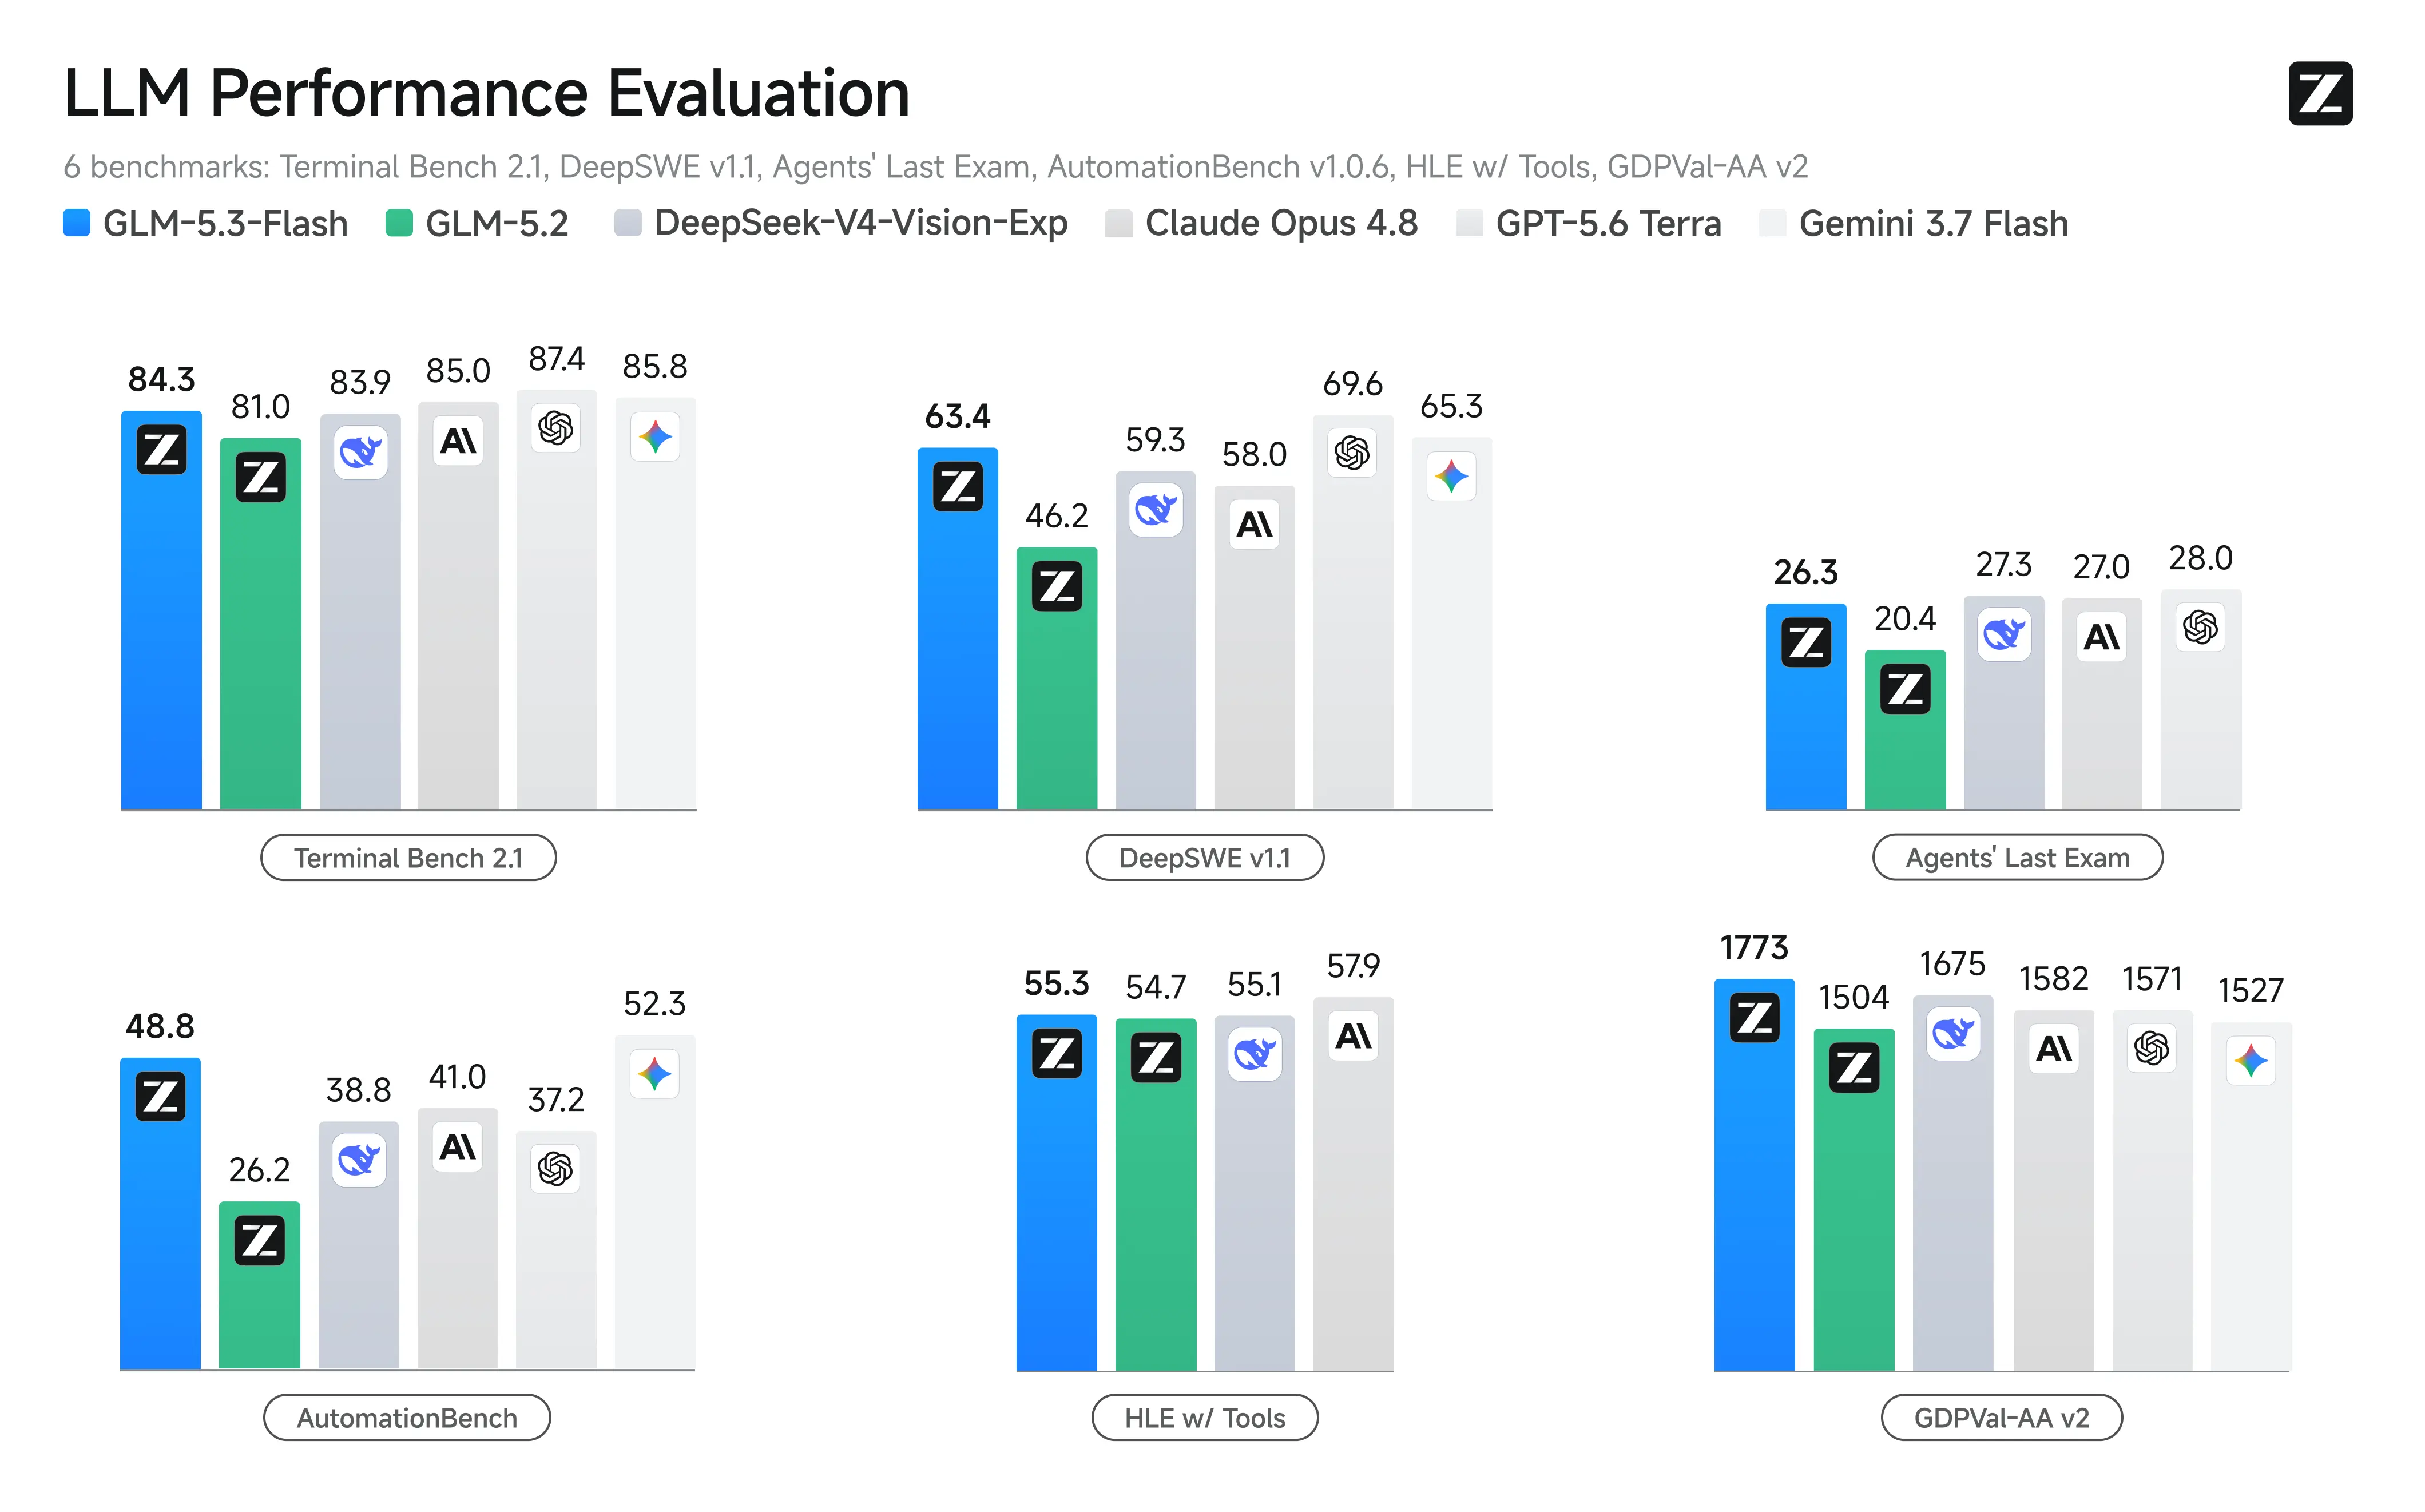
Źródło: Z.ai official benchmark graphic
Oficjalna grafika porównuje wydajność GLM-5.3 Flash w zależności od modelu i ustawień wysiłku. Dla tego przewodnika API stanowi zwięzły kontekst wydajności zamiast powtarzania pełnej macierzy startowej. Aplikacje nadal powinny mierzyć skuteczność zadań, opóźnienie end-to-end i łączną liczbę tokenów na własnych promptach.
Dlaczego używać GLM-5.3 Flash przez CometAPI?
CometAPI udostępnia GLM-5.3 Flash przez interfejs zgodny z OpenAI. Dzięki temu zespół może ponownie wykorzystać znajome wzorce SDK, scentralizować poświadczenia i rozliczenia oraz zmieniać modele bez przebudowy całej warstwy żądania.
• Jeden wzorzec integracji. Ten sam klient bazowy może wywoływać różne obsługiwane modele, zmieniając identyfikator modelu.
• Scentralizowana widoczność użycia. Zespoły mogą przeglądać użycie i koszty bez utrzymywania osobnego panelu dla każdego dostawcy.
• Szybsza ewaluacja. Jedna uprząż żądaniowa może porównywać jakość odpowiedzi, opóźnienia i błędy między kandydatami.
• Prostszy projekt fallbacku. Aplikacje mogą utrzymać logikę ponowień i trasowania w jednej warstwie bramy.
• Niższa cena listowa trasy. Obecna strona modelu podaje $0.06 za milion tokenów wejściowych i $0.20 za milion tokenów wyjściowych; przed budżetowaniem zweryfikuj bieżącą stronę.
Zanim zaczniesz
Potrzebujesz konta CometAPI, klucza API oraz jednego z poniższych środowisk lokalnych:
• Python 3.9 lub nowszy z pip
• Node.js 18 lub nowszy z npm
• cURL do minimalnego testu w wierszu poleceń
Nigdy nie umieszczaj produkcyjnego klucza CometAPI w JavaScript po stronie przeglądarki, aplikacji mobilnej, publicznym repozytorium, zrzucie ekranu ani logach po stronie klienta. Wywołuj CometAPI z zaufanego serwera i trzymaj klucz w zmiennej środowiskowej lub menedżerze sekretów.
Jak używać GLM-5.3 Flash API z CometAPI
Krok 1: Utwórz klucz API CometAPI
Zaloguj się do CometAPI, otwórz konsolę kluczy API, utwórz klucz i jednokrotnie wprowadź go do przepływu zarządzania sekretami. Używaj osobnego klucza dla developmentu i produkcji, aby móc rotować lub odwołać jedno środowisko bez przerywania drugiego.
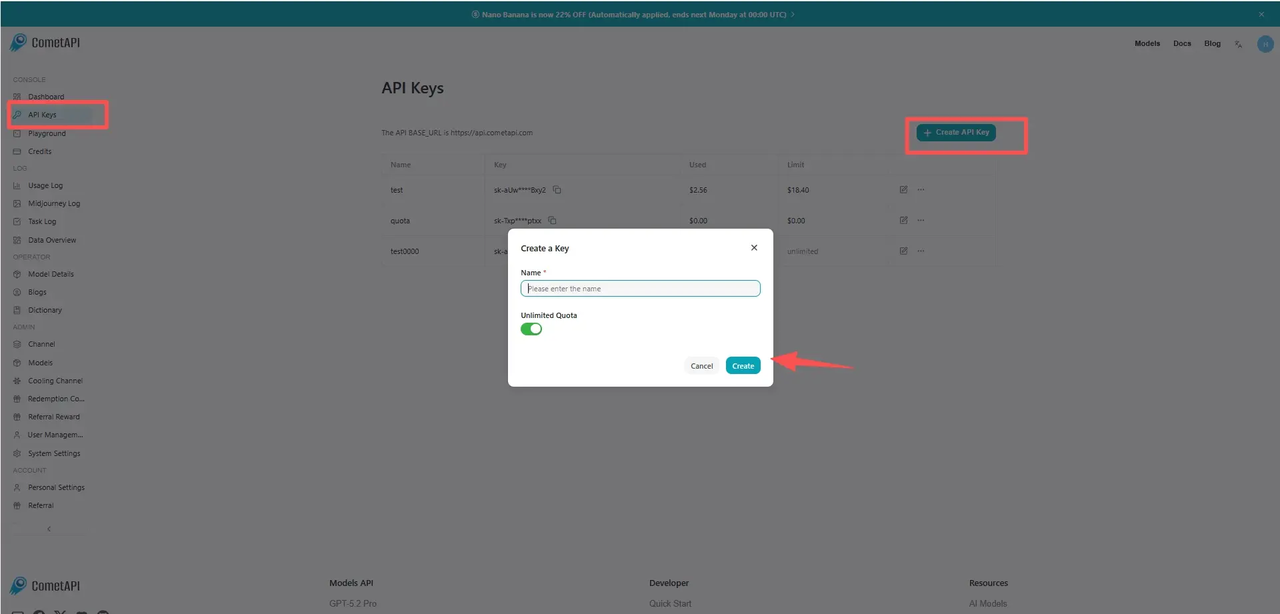
Źródło: CometAPI official API key guide image
Krok 2: Przechowuj klucz jako zmienną środowiskową
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
W produkcji zastąp historię powłoki wdrożeniowym sekretem, sekretem kontenera lub zarządzanym sejfem.

### Krok 3: Zainstaluj zgodne z OpenAI SDK
python -m pip install --upgrade openai
npm install openai
```

### Krok 4: Wykonaj pierwsze żądanie za pomocą cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "You are a precise technical assistant."
      },
      {
        "role": "user",
        "content": "Explain three practical uses of a one-million-token context window."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Prawidłowa odpowiedź zawiera wiadomość asystenta w choices[0].message.content plus metadane usage, jeśli trasa je zwraca. Zacznij od tego małego żądania, zanim dodasz parametry opcjonalne.

### Krok 5: Wywołanie API z Pythona

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "You are a precise technical assistant.",
        },
        {
            "role": "user",
            "content": "Review this migration plan and list the top five risks.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Krok 6: Wywołanie API z JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "You are a precise technical assistant." },
    { role: "user", content: "Draft a safe rollout checklist for this API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Jak kontrolować poziom rozumowania

Oficjalna dokumentacja modelu wspiera low, high i max poziomy wysiłku rozumowania. Thinking pozostaje włączony; ustawienie wysiłku zmienia, jak duży budżet rozumowania model może wykorzystać.

| Poziom wysiłku | Dobre początkowe zastosowania                    | Kompromis                                           |
| -------------- | ------------------------------------------------- | --------------------------------------------------- |
| low            | Klasyfikacja, parafrazy, krótkie ekstrakcje       | Niższe opóźnienie i zużycie tokenów wyjściowych; mniejsza głębia. |
| high           | Przegląd kodu, planowanie, analiza dokumentów     | Zbalansowana wartość domyślna dla wielu zadań produkcyjnych. |
| max            | Złożone debugowanie, agenci narzędziowi, trudne wnioskowanie | Największa głębia; potencjalnie większe opóźnienia i koszt. |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Find hidden failure modes in this distributed rollout plan.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

Jeśli zainstalowane SDK udostępnia reasoning_effort jako pierwszy-class argument, możesz przekazać go bezpośrednio. Jeśli trasa CometAPI odrzuca pole specyficzne dla dostawcy, usuń je i użyj wartości domyślnej trasy. Nie próbuj wyłączać thinking.

## Jak strumieniować odpowiedzi

Streaming jest przydatny dla czatu, asystentów kodowania i długiej analizy, ponieważ pozwala interfejsowi wyświetlać wynik w trakcie generowania. Nie zmniejsza liczby wygenerowanych tokenów, więc utrzymuj te same limity i kontrolę kosztów.

### Streaming w Pythonie

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Create a staged database migration plan."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### Streaming w JavaScript

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Create a staged database migration plan." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Obsługuj anulowanie. Zatrzymaj odczyt strumienia po rozłączeniu klienta i anuluj pracę wyżej, gdy to wspierane.

• Buforuj bezpiecznie. Nie zakładaj, że każda porcja zawiera pełne słowo, token JSON lub obiekt wywołania narzędzia.

• Zapisz końcowe usage. Metryki usage mogą pojawić się dopiero w ostatnim zdarzeniu lub metadanych specyficznych dla trasy.

## Jak wysyłać obrazy

GLM-5.3 Flash akceptuje treści wizualne przez bloki image_url w messages[].content[]. Oficjalna dokumentacja rekomenduje osiągalny URL obrazu lub Base64 Data URL. Strona modelu CometAPI potwierdza zdolność image-to-text, ale aplikacje nadal powinny testować formaty, rozmiary plików i zachowanie trasy przed produkcją.

### Analiza obrazu z URL

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Review this dashboard. Identify usability issues, "
                        "ambiguous metrics, and possible data-quality risks."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Wysłanie lokalnego obrazu jako Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extract the chart title, axes, and main trend.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Przytnij nieistotne białe obszary przed zakodowaniem obrazu.

• Zmniejsz skalę obrazów znacznie większych niż analizowana informacja.

• Zadawaj konkretne pytanie wizualne zamiast prosić o ogólny opis.

• Nie zakładaj, że publiczny URL strony to bezpośredni URL obrazu.

• Przetestuj kolejność wielu obrazów, ponieważ każdy powinien być jednoznacznie referencjonowany w promptcie.

## Jak żądać ustrukturyzowanego JSON

Ustrukturyzowane wyjście jest cenne, gdy kolejnym komponentem jest kod, a nie człowiek. Używaj wąskiego schematu, waliduj wynik i zachowaj fallback dla tras, które nie udostępniają ścisłego JSON Schema w identycznej formie.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

Tryb JSON nie eliminuje potrzeby walidacji. Sprawdzaj wymagane pola, typy, dozwolone wartości i maksymalne długości przed zapisaniem wyniku lub uruchomieniem innego systemu.

## Jak używać „function calling”

Function calling pozwala modelowi decydować, kiedy potrzebuje danych zewnętrznych, podczas gdy kod aplikacji nadal odpowiada za autoryzację i wykonanie. Bezpieczny wzorzec to: model proponuje wywołanie narzędzia, serwer je weryfikuje, serwer wykonuje narzędzie, a model otrzymuje wynik.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Return valid JSON only.",
        },
        {
            "role": "user",
            "content": (
                "Extract equipment, severity, observed symptom, and next action "
                "from this report: Feeder 12 showed repeated zero-sequence current "
                "spikes after rain; inspect insulation and compare adjacent sections."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Waliduj argumenty. Traktuj JSON wywołań narzędzi jako niezaufany.

• Egzekwuj autoryzację. Model nie decyduje, co może zrobić bieżący użytkownik.

• Rozdziel narzędzia odczytu i zapisu. Wymagaj potwierdzenia dla działań destrukcyjnych lub widocznych na zewnątrz.

• Ogranicz inwentarz narzędzi. Udostępniaj tylko narzędzia istotne dla bieżącego przepływu.

• Ogranicz pętlę. Ustaw maksymalną liczbę rund narzędzi, łączną liczbę tokenów, czas i koszt.

## Parametry GLM-5.3 Flash API

| Parameter               | Cel                               | Wskazówki praktyczne                                   |
| ----------------------- | --------------------------------- | ------------------------------------------------------ |
| model                   | Wybór trasy modelu                | Użyj glm-5.3-flash.                                    |
| messages                | Konwersacja i wejście multimodalne| Zachowaj prawidłową kolejność ról; zachowaj wymagane wiadomości narzędzi. |
| max_completion_tokens   | Ogranicza generowane wyjście      | Ustawiaj per workflow zamiast polegać na maksimum modelu. |
| temperature             | Zachowanie próbkowania            | Oficjalne zalecenie to 1.                              |
| top_p                   | Nucleus sampling                  | Oficjalne zalecenie to 0.95.                           |
| reasoning_effort        | Budżet rozumowania                | Użyj low, high lub max; wsparcie trasy należy przetestować. |
| stream                  | Wyjście przyrostowe               | Użyj true dla odpowiedzi interaktywnych.               |
| tools                   | Definicje funkcji                 | Zawężaj schematy i waliduj każde wywołanie.            |
| tool_choice             | Kontrola wyboru narzędzia         | Zacznij od auto, chyba że workflow wymaga narzędzia.   |
| response_format         | Wniosek o wynik maszynowo-czytelny| Waliduj wsparcie i zwrócony JSON.                      |

## Z.ai Direct API vs CometAPI

Obie trasy mogą być właściwe. Decyzja dotyczy głównie własności integracji, szerokości modeli, rozliczeń i szybkości, z jaką aplikacja potrzebuje natywnych funkcji dostawcy.

| Wymiar          | Z.ai Direct API                               | CometAPI                                           | Skutek praktyczny                                              |
| --------------- | --------------------------------------------- | -------------------------------------------------- | --------------------------------------------------------------- |
| Konto i klucz   | Konto i klucz Z.ai                            | Konto i klucz CometAPI                             | Klucze nie są wymienne.                                        |
| Wzorzec SDK     | Zgodny z OpenAI                               | Zgodny z OpenAI                                    | Duża część kodu klienta może być ponownie użyta.               |
| Pokrycie modeli | Rodzina modeli Z.ai                           | Wielu dostawców i rodziny modeli                   | CometAPI jest użyteczne do trasowania i porównań.               |
| Funkcje natywne | Najwcześniejszy dostęp do zachowań specyficznych dla dostawcy | Zależne od ekspozycji i passthrough bramy          | Testuj zaawansowane pola na wybranej trasie.                    |
| Rozliczenia     | Specyficzne dla dostawcy                      | Scentralizowane wśród obsługiwanych modeli         | Ujednolicone rozliczenia upraszczają operacje wielomodelowe.    |
| Fallback        | Wymaga integracji z innym dostawcą            | Może pozostać w jednej warstwie bramy              | CometAPI może zmniejszyć tarcie przy przełączaniu.              |
| Najlepsze dopasowanie | Głębokie zaangażowanie w natywne możliwości Z.ai | Ujednolicony dostęp, ewaluacja i trasowanie produkcyjne | Wybieraj według architektury systemu, nie ogólnego „zwycięzcy”. |

Użyj bezpośredniego API, gdy kluczowa jest najnowsza, natywna funkcja dostawcy. Użyj CometAPI, gdy ważniejsze są jeden klient, ujednolicone rozliczenia oraz możliwość porównań lub zamiany modeli. W produkcji uruchom ten sam reprezentatywny zestaw testów na dokładnej trasie, którą planujesz wdrożyć.

## Szacowanie kosztów i budżetowanie tokenów

Bieżąca strona modelu CometAPI podaje $0.06 za milion tokenów wejściowych i $0.20 za milion tokenów wyjściowych. Przy tych stawkach szacunkowy koszt żądania to:

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Obciążenie              | Tokeny wejściowe | Tokeny wyjściowe | Szacunkowy koszt |
| ----------------------- | ---------------- | ---------------- | ---------------- |
| Krótkie pytanie         | 2,000            | 400              | $0.00020         |
| Przegląd kodu           | 50,000           | 4,000            | $0.00380         |
| Analiza dużego dokumentu| 250,000          | 10,000           | $0.01700         |
| Długi przebieg agenta   | 800,000          | 30,000           | $0.05400         |

Ceny są wrażliwe na czas. Potwierdź bieżące stawki za wejście, wejście z cache i wyjście przed publikacją lub budżetowaniem produkcyjnym. Rozumowanie i pętle narzędzi mogą zwiększyć rozliczane wyjście i powtórzone wejście, więc szacuj kompletne przepływy pracy, a nie jedną widoczną odpowiedź.

## Najlepsze praktyki produkcyjne GLM-5.3 Flash API

### Kontrola kosztów i opóźnień

#### Limity wyjścia

Ustawienia generowania w benchmarkach i produkcyjne limity API różnią się. Cytowana ewaluacja HLE używała maksymalnej długości generacji 163,840 tokenów, podczas gdy niektóre ewaluacje używały 64K wyjść; żadne z nich nie dowodzi, że każda hostowana trasa API może zwrócić ponad 100,000 tokenów. Ustaw limit według żywego schematu trasy i budżetu workflow. Używaj małych limitów dla klasyfikacji i ekstrakcji, średnich dla analizy, a większych tylko dla wyraźnie długich form lub zadań agentowych.

**Kontrola kontekstu**

Okno miliona tokenów to pojemność, a nie cel. Pobieraj istotne pliki, usuwaj zduplikowane logi, umieszczaj stabilne instrukcje blisko początku i mierz, czy dodatkowy kontekst poprawia skuteczność zadania.

### Stan i niezawodność

#### Zachowuj stan

Przechowuj kompletne wiadomości asystenta potrzebne w kolejnej turze, w tym wywołania narzędzi i pola specyficzne dla trasy zweryfikowane przez aplikację. Utrata ustrukturyzowanej historii może przerwać wieloetapową pętlę narzędzi, nawet jeśli widoczny tekst wygląda na pełny.

#### Ponawiaj selektywnie

• Ponawiaj tymczasowe 429, 500, 502, 503 oraz time-outy sieciowe z wykładniczym backoffem i jitterem.

• Nie ponawiaj bezrefleksyjnie błędów autoryzacji, nieprawidłowych parametrów ani zbyt dużych żądań.

• Dołącz identyfikator żądania aplikacji, aby rozpoznać zduplikowaną pracę.

• Używaj kontroli idempotencji wokół operacji zapisu na zewnątrz, nawet jeśli samo żądanie modelu jest ponawiane.

### Bezpieczeństwo i walidacja

#### Waliduj maszynowo-czytelne wyjście

Walidacja schematu, kontrola dozwolonych wartości, limity długości i reguły domenowe powinny stać między modelem a każdą bazą danych, kolejką czy zewnętrznym API. Syntaktycznie poprawny obiekt JSON może nadal być niekompletny lub niebezpieczny.

#### Autoryzuj wywołania narzędzi

Traktuj wywołania narzędzi proponowane przez model jako niezaufane: waliduj argumenty, egzekwuj autoryzację użytkownika, rozdzielaj operacje odczytu i zapisu oraz wymagaj potwierdzenia dla akcji destrukcyjnych.

### Obserwowalność i fallback

#### Mierz workflow

• Skuteczność zadania lub wskaźnik akceptacji przez człowieka

• Czas do pierwszego tokena i całkowite opóźnienie

• Tokeny wejściowe, cache’owane wejściowe, rozumowania i wyjściowe

• Liczba wywołań narzędzi i wskaźnik ich błędów

• Ponowienia, limity szybkości i błędy dostawcy

• Koszt na ukończone zadanie, a nie koszt pojedynczego wywołania API

#### Projektuj fallback

Wybieraj fallback według obciążenia, nie reputacji. Fallback tylko tekstowy może wystarczyć do ekstrakcji dokumentów, ale zawiedzie zadanie oparte na zrzucie ekranu. Zdefiniuj, które wejścia i schematy narzędzi są przenośne, które parametry trzeba usunąć oraz kiedy użytkownik powinien zobaczyć naprawialny błąd zamiast automatycznego przełączenia modelu.

## Typowe błędy i rozwiązywanie problemów

| Objaw                  | Prawdopodobna przyczyna                                              | Co sprawdzić                                                                   |
| ---------------------- | -------------------------------------------------------------------- | ------------------------------------------------------------------------------ |
| 401 Unauthorized       | Brakujący, niepoprawny lub odwołany klucz                            | Potwierdź nagłówek Authorization i zmienną środowiskową po stronie serwera.    |
| 404 lub model not found| Zły identyfikator modelu lub niedostępna trasa                       | Użyj glm-5.3-flash i potwierdź dostępność na żywej stronie modelu.             |
| 429 Rate Limit         | Przekroczony limit żądań lub tokenów                                 | Zmniejsz obciążenie, ogranicz współbieżność, sprawdź limity konta i ponów z jitterem. |
| Unsupported parameter  | Pole natywne dostawcy nieeksponowane przez bramę                     | Usuń opcjonalne pola i dodawaj je ponownie pojedynczo.                         |
| Context length exceeded| Prompt plus żądane wyjście przekraczają limit trasy                  | Przytnij, pobierz, streść lub obniż max_completion_tokens.                     |
| Invalid image          | URL niedostępny, format nieobsługiwany lub błędne Base64             | Przetestuj bezpośredni obraz HTTPS i popraw prefiks MIME.                      |
| Broken streamed JSON   | Parsowanie porcji jako kompletnego obiektu                           | Buforuj strumień i parsuj dopiero po pełnym odebraniu JSON.                    |
| Tool loop never ends   | Brak limitu kroków lub niejednoznaczne wyniki narzędzi               | Ogranicz rundy, popraw opisy narzędzi i zwracaj jawne błędy narzędzi.          |

## Kiedy używać GLM-5.3 Flash API?

### Dobre dopasowania

• Zrozumienie kodu na skalę repozytorium i przegląd wielu plików

• Kodowanie wizualne, analiza zrzutów ekranu i QA interfejsu

• Długie pakiety dokumentów i synteza oparta na dowodach

• Agenci używający narzędzi z powtarzalnym planowaniem i weryfikacją

• Przepływy o dużej skali, gdzie koszt tokenów znacząco wpływa na unit economics

• Aplikacje korzystające na przełączaniu lub porównywaniu modeli przez jedną bramę

### Użyj innej trasy lub modelu, gdy

• Produkt potrzebuje wyjścia obrazowego lub wideo zamiast tekstowego.

• Zadanie to drobna, niskiego ryzyka klasyfikacja, którą mniejszy model wykona niezawodnie.

• Kluczowa jest funkcja natywna dostawcy, lecz nieudostępniona przez trasę bramy.

• Przepływ nie toleruje zawsze włączonego rozumowania ani związanego z nim profilu opóźnień.

• Aplikacja nie przetestowała jeszcze modelu na własnych narzędziach, danych i przypadkach błędów.

## FAQ

###

### Co należy zweryfikować na dokładnej trasie CometAPI przed uruchomieniem?

Zweryfikuj dostępność modelu, akceptowane formaty multimodalne, maksymalne wyjście, pola rozumowania, zachowanie ustrukturyzowanego wyjścia, limity szybkości i bieżące ceny za pomocą reprezentatywnych żądań.

### Jakie metryki powinna śledzić ewaluacja produkcyjna?

Śledź skuteczność zadania, czas do pierwszego tokena, całkowite opóźnienie, tokeny wejściowe i wyjściowe, błędy wywołań narzędzi, wskaźnik ponowień i koszt za ukończony workflow, nie tylko koszt na wywołanie API.

### Jak wybrać między Z.ai direct a CometAPI?

Użyj Z.ai direct, gdy kluczowy jest natychmiastowy dostęp do zachowań natywnych dostawcy. Użyj CometAPI, gdy ważniejsze są ujednolicone uwierzytelnianie, rozliczenia, porównanie modeli i fallback na poziomie bramy.

### Co czyni fallback bezpiecznym?

Bezpieczny fallback akceptuje tę samą modalność wejścia, zachowuje wymagane schematy narzędzi, usuwa nieobsługiwane parametry, pozostaje w granicach autoryzacji zadania i widocznie się niepowoduje, gdy nie da się zachować zachowania.

## Zakończenie

GLM-5.3 Flash jest najprzydatniejszy przez API, gdy długi kontekst, wejście wizualne, rozumowanie i użycie narzędzi stanowią jeden przepływ. Podstawowa integracja z CometAPI jest mała: jeden klucz po stronie serwera, jeden klient zgodny z OpenAI, identyfikator modelu glm-5.3-flash i endpoint chat-completions. Jakość produkcyjna wynika ze wszystkiego wokół tego żądania: zawężonych promptów, limitów wyjścia, walidacji schematu, autoryzacji narzędzi, ponowień, obserwowalności i ewaluacji specyficznej dla obciążenia.

Zacznij od krótkiego wywołania tekstowego, dodawaj po jednej zaawansowanej funkcji naraz i testuj pełną ścieżkę użytkownika przed skalowaniem. Potwierdź na żywo stronę modelu GLM-5.3 Flash pod kątem bieżącej dostępności, obsługi tras i cen.

## SEO Metadata

Meta title: Jak korzystać z GLM-5.3 Flash API: przewodnik dla deweloperów

Meta description: Dowiedz się, jak używać GLM-5.3 Flash API z CometAPI, w tym przykłady dla Pythona i JavaScriptu, wizja, streaming, narzędzia, wyjście JSON oraz najlepsze praktyki.

Keywords: GLM-5.3 Flash API, jak korzystać z GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, samouczek GLM API, multimodalne API, API do rozumowania, wywoływanie funkcji

URL slug: how-to-use-glm-5-3-flash-api