
TL;DR
Stan na 9 października 2026 r.: doniesienia sugerują, że Kimi K3.1 może pojawić się w tym miesiącu, lecz przeanalizowane źródła nie potwierdzają oficjalnej daty premiery, finalnych cen ani wyników benchmarków specyficznych dla K3.1. Zgłaszane flagi Low / High / Max, Extra Long, Agent i Swarm pokrywają się z istniejącymi funkcjami K3. Potencjalna aktualizacja ma znaczenie, jeśli poprawi efektywność rozumowania, niezawodność przy długim kontekście oraz koszt ukończonych zadań; same etykiety konfiguracji nie dowodzą tych korzyści.
Najważniejsze wnioski
- Termin wydania: październik to możliwość wskazywana przez media, bez oficjalnego zobowiązania do startu w cytowanych źródłach.
- Wskazówki techniczne: Low / High / Max oraz zgłaszana opcja 1M tokenów pokrywają się z możliwościami K3; architektura K3.1 i finalne limity pozostają niepotwierdzone.
- Przepływy agentowe: flagi Agent, Swarm, search i batch wskazują raczej na prace integracyjne niż zmierzone ulepszenia.
- Wydajność i ceny: opublikowane wyniki i stawki K3 to punkt odniesienia, a nie benchmarki czy taryfy K3.1.
- Gotowość API: przed wdrożeniem K3.1 przez CometAPI potwierdź obsługiwane identyfikatory modeli, udokumentowane parametry i dostęp konta.
Czym jest Kimi K3.1?
Kimi K3.1 to rzekoma kolejna iteracja rodziny modeli Kimi firmy Moonshot AI. Wycieki identyfikatorów konfiguracji sugerują prace nad rozumowaniem, długim kontekstem i przepływami pracy agentów. Ich finalne specyfikacje, data wydania i ceny nie są ustalone w przeanalizowanych źródłach, dlatego należy traktować go jako model potencjalny, a nie potwierdzoną publiczną premierę.
Co wiemy o Kimi K3.1?
Oryginalny wpis pokazuje identyfikator powiązany z K3.1
23 września 2026 r. @MaxForAI opublikował zrzut konfiguracji z k3d1-agent. To oryginalny obraz powiązany z wpisem; jego wewnętrzne pochodzenie i status produkcyjny nie zostały niezależnie uwierzytelnione.
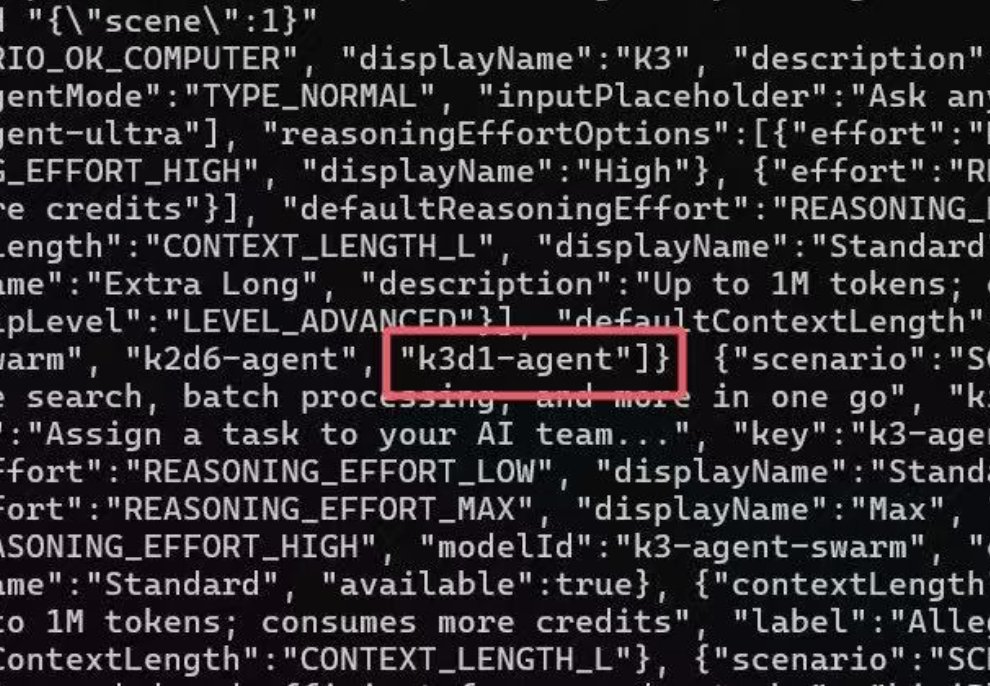
Źródło obrazu: oryginalny wpis @MaxForAI. Obraz zawiera ustawienia wysiłku rozumowania i kontekstu wraz z identyfikatorami agentów. Widoczne ciągi konfiguracyjne nie dowodzą, że każda opcja należy do K3.1.
Raport Wccftech z 23 września interpretuje zrzut jako sygnał rozwoju K3.1. Uzupełnienie IT Home z 24 września powtarza zgłaszane opcje. Są to wtórne interpretacje tego samego wycieku, a nie niezależne potwierdzenie gotowości do premiery.
Zgłaszane opcje wskazują na rozumowanie i przepływy pracy agentów
Relacje opisują ustawienia rozumowania Low / High / Max, opcję Extra Long do 1M tokenów oraz flagi Agent, Swarm, search i batch. Te wskazówki sugerują możliwą integrację przepływów pracy. Nie ujawniają jednak finalnej architektury, zweryfikowanej poprawy wydajności ani obsługiwanego publicznego schematu API.
Relacje medialne różnią się co do okna premiery
Wccftech opisuje możliwy debiut przed październikiem, podczas gdy IT Home wskazuje październik 2026 r. Ta rozbieżność ogranicza użyteczność obu prognoz. Żaden z raportów nie dostarcza datowanego ogłoszenia wydania od Moonshot.
Identyfikator modelu może oznaczać prywatny checkpoint, niedokończoną trasę, wdrożenie etapowe lub podgląd z kontrolą dostępu. Sam w sobie nie stanowi dowodu komercyjnego wydania API. Dokładne znaczenia i dostępność wyciekłych flag pozostają niepewne.
Kiedy zostanie wydany Kimi K3.1?
Przeanalizowane źródła nie ustalają oficjalnej daty wydania Kimi K3.1. IT Home podaje październik 2026 r., podczas gdy wcześniejsze materiały Wccftech mówią o terminie przed październikiem. To różniące się prognozy medialne, a nie zweryfikowany harmonogram rozwoju. Zrzut ekranu nie dowodzi dat wdrożenia, uprawnień konta ani gotowości do produkcji.
Zanim uznasz datę premiery za potwierdzoną, szukaj datowanego ogłoszenia Moonshot, obsługiwanych identyfikatorów modeli, dokumentacji dla deweloperów i warunków dostępu. Ceny i powtarzalne oceny specyficzne dla K3.1 to osobne dowody potrzebne do decyzji o wdrożeniu.
Jakie specyfikacje mógłby oferować Kimi K3.1?
Najmocniejszą bazą techniczną jest istniejący Kimi K3, wydany w lipcu 2026 r., z rzadką architekturą MoE o 2,8 biliona parametrów, natywnym wejściem wizualnym i oknem kontekstu powszechnie opisywanym jako 1M tokenów. Cytowane źródła nie ustalają architektury K3.1, liczby parametrów ani wyników ocen specyficznych dla modelu.
Oficjalne zestawienie modeli Moonshot podaje 104B aktywowanych parametrów i okno kontekstu 1,048,576 tokenów. Ogłoszenie z 27 lipca o udostępnieniu wag potwierdza release wag K3. Te specyfikacje dotyczą K3, a nie rzekomego K3.1.
| Specyfikacja | Kimi K3 | Kimi K3.1 |
|---|---|---|
| Wydanie | Lipiec 2026 | Potencjalnie październik 2026 |
| Liczba parametrów | 2,8 biliona | Nie ujawniono |
| Aktywowane parametry | 104 miliardy (oficjalne zestawienie modelu) | Nie ujawniono |
| Architektura | Sparse MoE, KDA, AttnRes | Nie ujawniono |
| Kontekst | 1,048,576 tokenów (około 1M) | Sugerowane do 1M |
| Rozumowanie | Low / High / Max w bieżącej dokumentacji Kimi Code | Flagi Low / High / Max |
| Wizja | Rodzime wejście wizualne | Nie potwierdzono |
| Swarm | Istniejąca funkcja Kimi Swarm | Flaga Swarm rzekomo się pojawia |
| Cena API | Opublikowana taryfa K3 | Brak finalnych cen |
| Wagi | Udostępnione wagi K3 | Nieznane |
Jakie funkcje są raportowane dla Kimi K3.1?
Poniższe trzy tematy łączą wskazówki dotyczące K3.1 z udokumentowanymi możliwościami K3. Wyjaśniają, co te ustawienia mogą oznaczać, nie przedstawiając plotek o K3.1 jako potwierdzonych specyfikacji.
Trzy poziomy rozumowania oferują kompromis wysiłku
Low, High i Max są raportowanymi etykietami konfiguracji K3.1. Opisują kompromis wysiłku, a nie nową architekturę. Aktualna dokumentacja Kimi Code wspiera low / high / max dla K3, z high jako domyślnym. To ustawienie Kimi Code; nie należy zakładać, że domyślne wartości i uprawnienia są identyczne we wszystkich API lub produktach.
Low może pasować do ekstrakcji, prostego Q&A i rutynowej klasyfikacji, gdy liczy się niższa latencja. High może zapewniać praktyczną równowagę dla wieloetapowego developmentu i pracy z dokumentami. Max może przydzielać większy budżet rozumowania do trudnego kodowania lub badań, z wyższą latencją i potencjalnie większym kosztem. Te mapowania zadań to interpretacje do przetestowania, a nie zweryfikowane gwarancje K3.1.
Te przykłady obciążeń to interpretacje analityczne, a nie potwierdzone gwarancje usług K3.1. Deweloperzy powinni porównywać jakość na jednostkę wydatku: tryb high może kosztować więcej na próbę, ale mniej powtórek może obniżyć całkowity koszt przepływu. Liczy się realna poprawa skuteczności zadań przy porównywalnym budżecie tokenów i narzędzi.
Opcja 1M tokenów rozszerza bazę długiego kontekstu
Milion-tokenowe okno może pomieścić obszerne repozytoria kodu, długie dokumenty techniczne, historie projektów i rozbudowane ślady narzędzi. Ale maksymalna długość kontekstu to nie to samo co dokładne wykorzystanie odległych informacji. Produktywny model musi nadal wydobywać właściwe fakty, zachowywać spójność między dokumentami i utrzymać rozsądny prefill latency.
Oceniaj długi kontekst, testując wyszukiwanie na różnych pozycjach w promptach, spójność między dokumentami oraz time to first token. Mierz ponowne użycie cache i koszt utrzymania lub kompresji historii agenta. Nominalny limit 1M tokenów jest użyteczny tylko wtedy, gdy model potrafi odzyskać odległe dowody dokładnie, w akceptowalnej latencji i budżecie.
Moonshot raportuje wynik K3 BrowseComp 90,4 przy kontekście 1M tokenów i bez zarządzania kontekstem. To konkretne warunki oceny K3, odmienne od wyników z kompresją kontekstu i od wszelkich twierdzeń o wydajności K3.1.
Flagi Agent i Swarm sugerują skoordynowane wykonywanie zadań
Identyfikatory związane z agentami i flagi Swarm są być może ciekawsze niż liczba kontekstu. Kimi już wspiera pracę wieloagentową; zatem rzekomy upgrade musiałby poprawić trasowanie, delegowanie, agregację wyników i kontrolę kosztów, a nie tylko dodać etykietę Swarm.
W wiarygodnym orkiestratorze jeden koordynator dzieli złożone żądanie na podzadania researchu, kodowania, testowania i syntezy. Wyspecjalizowani pracownicy działają równolegle, zwracają dowody i są godzeni przez koordynatora. Taka równoległość może skrócić czas ścienny, ale zwiększyć łączną liczbę wywołań modelu, więc szybkość i koszt należy raportować oddzielnie.
Oficjalna dokumentacja Kimi Agent Swarm opisuje istniejące równoległe wykonywanie agentów. Poniższy przykład ilustruje, jak taka orkiestracja może dzielić pracę; nie ustanawia finalnej konfiguracji K3.1 ani wymaganej topologii Swarm.
Pracownik researchu może pobierać źródła i weryfikować cytowania; pracownik kodowania może modyfikować moduły i zwracać dowody wykonania; pracownik analizy może porównywać alternatywy z powtarzalnymi obliczeniami. Koordynator przydziela zadania, rozstrzyga rozbieżności i ogranicza budżet. Wyniki każdego pracownika wymagają weryfikacji przed akceptacją wyniku łącznego.
Dla K3.1 deweloperzy powinni szukać powtarzalnych benchmarków skutecznych zadań end-to-end agentów, odzyskiwania po błędach, obsługi niezgodności agent–agent, liczby wywołań narzędzi i całkowitego wydatku. Same flagi konfiguracyjne nie dowodzą poprawy.
Jak Kimi K3.1 wypada na benchmarkach względem K3?
Nie ma dostępnej zweryfikowanej tabeli benchmarków specyficznej dla K3.1. Poniższe liczby pochodzą z oficjalnych ocen K3 od Moonshot i służą wyłącznie jako baza porównawcza. Różne harnessy modeli i ustawienia ocen ograniczają ścisłe wnioskowanie 1:1.
| Benchmark | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| DeepSWE | 67.5 | 73.0 | 70.0 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 |
| FrontierSWE | 81.2 | 71.3 | 86.6 |
| Program Bench | 77.8 | 77.6 | 76.8 |
| Kimi Code Bench 2.0 | 72.9 | 64.8 | 76.9 |
| SWE Marathon | 42.0 | 39.0 | 35.0 |
Rozbieżność źródeł: oryginalna grafika pokazuje dla Fable 5 wynik 84,6 na Terminal-Bench 2.1, podczas gdy oficjalna tabela w repozytorium raportuje 88,0. Powyższa tabela podąża za repozytorium; oficjalny obraz jest reprodukowany bez zmian.
Uwagi do oceny określają K3 na max effort, temperaturę 1.0 i top-p 1.0. DeepSWE v1.1 używa tu Kimi Code; osobno cytowany wynik mini-SWE-agent to 67,3. Terminal-Bench używa Kimi Code dla K3, Terminus 2 dla Fable 5 i Codex dla Sol. FrontierSWE używa Kimi Code/Codex i wyników dominacji z 16 lipca; ProgramBench używa Kimi Code dla K3. KCB 2.0 używa Kimi Code/Claude Code dla K3 oraz Claude Code/Codex dla Fable/Sol. SWE Marathon używa skalibrowanej H20 gałęzi v1.1 z Claude Code/Codex; Fable odnotował fallbacki w 35% zadań. To wyniki raportowane przez dostawców w różnych ramach testowych.
Zapoznaj się z oficjalnymi uwagami do ocen dla pełnych protokołów każdego benchmarku; te liczby nie ustanawiają kontrolowanego porównania K3.1.
K3 jest szczególnie konkurencyjny na Program Bench i SWE Marathon w tym zestawie, podczas gdy liderzy porównawczy różnią się w zależności od testu. Nie można ogłosić, że K3.1 jest szybszy lub dokładniejszy, dopóki nie zostaną opublikowane testy z udokumentowanym harnaissem agentów, budżetem rozumowania i datą oceny.
Jak może wyglądać wycena API Kimi K3.1?
Oficjalna taryfa startowa K3 to $0.30 za cache’owany input, $3 za niecache’owany input i $15 za output na milion tokenów. Poniższa tabela zapisuje ten harmonogram referencyjny, nie zaś zweryfikowaną bieżącą taryfę K3.1. Stawki K3.1 i ewentualne opłaty za orkiestrację wymagają osobnego potwierdzenia.
| Pozycja rozliczeniowa | Kimi K3 API w CometAPI (odniesienie do taryfy startowej) | Kimi K3.1 API w CometAPI (niepotwierdzona taryfa) |
|---|---|---|
| Cached input | US$0.30 / 1M tokens | Niepotwierdzone |
| Uncached input | US$3.00 / 1M tokens | Niepotwierdzone |
| Output | US$15.00 / 1M tokens | Niepotwierdzone |
| Agent orchestration | Zależnie od rzeczywistego użycia | Niepotwierdzone |
Przy tych referencyjnych stawkach K3, 100,000 niecache’owanych tokenów wejściowych plus 10,000 tokenów wyjściowych kosztowałoby US$0.45. To ilustracyjna arytmetyka K3, a nie ceny K3.1. Planowanie dla firm powinno opierać się na koszcie za zweryfikowane zadanie, a nie wyłącznie na tokenach.
Jak deweloperzy mogą przygotować się do dostępu do API Kimi K3.1?
Sprawdzenie dostępu przed integracją
Deweloperzy mogą śledzić Kimi K3.1 API in CometAPI dla aktualizacji dostępu. 9 października 2026 r. sekcja dostępności na stronie nadal wskazywała Coming Soon, obok ogólnych informacji o endpoint i health. Traktuj tę niespójną stronę jako link odkrywczy; potwierdź obsługiwany identyfikator modelu i udany test na poziomie konta, zanim założysz dostęp produkcyjny.
Lista kontrolna startu pomaga w decyzji o wdrożeniu
| Pytanie | Dostępne teraz dowody | Wymagana weryfikacja |
|---|---|---|
| Wydanie? | Wrześniowe raporty o wycieku | Ogłoszenie wydania od Moonshot |
| Nowa architektura? | Brak karty modelu K3.1 | Raport techniczny i parametry |
| Lepsze rozumowanie? | Trzy znane tryby wysiłku | Jakość/koszt vs K3 na każdym poziomie |
| Lepszy długi kontekst? | Zgłaszana opcja 1M | Dokładność i latencja przy 1M |
| Lepszy multi-agent? | Flagi konfiguracji Agent/Swarm | Benchmarki sukcesu i kosztów agentów |
| Dostęp produkcyjny API? | Wskaźnik Coming Soon | Obsługiwane ID, dokumentacja, ceny |
Przygotowania można zacząć od przenośnych ocen i ograniczonego budżetu testów. Migrację warto odłożyć do czasu udokumentowanego dostępu i powtarzalnych korzyści na poziomie obciążeń. Decyzja dotyczy tego, czy K3.1 dostarcza akceptowane wyniki bardziej niezawodnie i ekonomicznie, a nie tego, czy istnieje strona katalogowa lub flaga konfiguracji.
FAQ
Jak deweloperzy mogą zweryfikować dostęp do Kimi K3.1?
Potwierdź obsługiwany identyfikator modelu u dostawcy i uprawnienia konta, następnie wykonaj małe żądanie i sprawdź zwrócony identyfikator modelu, zużycie i błędy. Udane wywołanie weryfikuje dostęp dla tego konta i trasy w danym momencie; wpis katalogowy lub etykieta health same w sobie nie stanowią dowodu publicznego uruchomienia ani stabilnego limitu.
Czy Kimi K3.1 może zastąpić K3 w istniejącym agencie?
Traktuj migrację jako zmianę kompatybilności. Sprawdź schematy narzędzi, obsługę historii rozumowania, formaty wyjścia i zachowanie timeoutów, zanim odtworzysz reprezentatywne zadania. Użyj przypiętej bazy porównawczej i zachowaj trasowanie rollback. Podobna nazwa modelu lub limit kontekstu to niewystarczające dowody, że długie sesje będą zachowywać się identycznie.
Jak zespoły powinny budżetować pilotaż Kimi K3.1?
Zacznij od ograniczonego zbioru zadań zamiast ekstrapolować z plotek o cenie tokenów. Śledź niecache’owany input, trafienia cache, tokeny rozumowania/output, wywołania narzędzi, powtórki i czas korekty przez człowieka. Zarezerwuj stały budżet oceny i porównaj koszt na zaakceptowany wynik po udokumentowaniu finalnych stawek.
Co stanowiłoby istotny upgrade Kimi K3.1?
Wymagaj powtarzalnych korzyści w Twoich obciążeniach przy porównywalnych budżetach rozumowania i narzędzi. Testuj odzysk odległych dowodów, sprzeczne dokumenty, odzyskiwanie po błędach agenta i akceptację zadań end-to-end. Rejestruj łącznie wskaźnik błędów, latencję i całkowity wydatek; większe nominalne okno lub dodatkowa flaga konfiguracji same w sobie są niewystarczające.
Wnioski
Kimi K3.1 najlepiej traktować jako zgłaszaną, potencjalną premierę. Przeanalizowane dowody identyfikują możliwe prace nad konfiguracją, podczas gdy K3 już zapewnia długi kontekst, regulowany wysiłek i wykonanie Swarm. Praktyczną szansą jest lepsza jakość zadań przy zrównoważonym koszcie. Przygotuj teraz przenośne oceny, a o migracji decyduj po udostępnieniu oficjalnych specyfikacji, warunków dostępu, cennika i powtarzalnych wyników K3.1.