Czym jest interfejs API GPT-5.2
Interfejs API GPT-5.2 jest tym samym co GPT-5.2 Thinking w ChatGPT. GPT-5.2 Thinking to średni poziom wariantu z rodziny GPT-5.2 firmy OpenAI, zaprojektowany do głębszej pracy: wieloetapowego rozumowania, streszczania długich dokumentów, jakościowego generowania kodu oraz profesjonalnych zadań wymagających wiedzy, w których dokładność i użyteczna struktura są ważniejsze niż czysta przepustowość. W API udostępniany jest jako model gpt-5.2 (Responses API / Chat Completions) i plasuje się pomiędzy niskolatencyjnym wariantem Instant a wyższej jakości, lecz droższym wariantem Pro.
Najważniejsze funkcje
- Bardzo długi kontekst i kompaktowanie: efektywne okno 400K i narzędzia do kompaktowania, aby zarządzać trafnością w długich rozmowach i dokumentach.
- Konfigurowalny wysiłek rozumowania:
none | medium | high | xhigh(xhigh włącza maksymalne wewnętrzne obliczenia dla trudnego rozumowania).xhighjest dostępny w wariantach Thinking/Pro. - Silniejsze wsparcie narzędzi i funkcji: wywoływanie narzędzi jako funkcji pierwszej klasy, gramatyki (CFG/Lark) do ograniczania strukturyzowanych wyników oraz ulepszone zachowania agentowe, które upraszczają złożoną automatyzację wieloetapową.
- Multimodalne rozumienie: bogatsze zrozumienie obrazów + tekstu i integracja w zadaniach wieloetapowych.
- Ulepszone bezpieczeństwo / obsługa treści wrażliwych: ukierunkowane interwencje ograniczające niepożądane odpowiedzi w obszarach takich jak autoagresja i inne wrażliwe konteksty.
Zdolności techniczne i specyfikacje (dla deweloperów)
- Punkty końcowe API i identyfikatory modeli:
gpt-5.2dla Thinking (Responses API),gpt-5.2-chat-latestdla przepływów chat/instant orazgpt-5.2-prodla poziomu Pro; dostępne poprzez Responses API i Chat Completions tam, gdzie wskazano. - Tokeny rozumowania i zarządzanie wysiłkiem: API obsługuje jawne parametry do przydzielania mocy obliczeniowej (reasoning effort) na żądanie; wyższy wysiłek zwiększa opóźnienie i koszt, ale poprawia jakość wyjścia w złożonych zadaniach.
- Narzędzia do strukturyzowanych wyników: wsparcie dla gramatyk (Lark / CFG), aby ograniczyć wyjście modelu do DSL lub dokładnej składni (przydatne dla SQL, JSON, generowania DSL).
- Równoległe wywoływanie narzędzi i koordynacja agentów: lepszy paralelizm i czystsza orkiestracja narzędzi zmniejszają potrzebę rozbudowanych promptów systemowych i rusztowania wieloagentowego.
Wydajność w benchmarkach i dane wspierające
OpenAI opublikowało różnorodne wewnętrzne i zewnętrzne wyniki benchmarków dla GPT-5.2. Wybrane najważniejsze (zgodnie z danymi OpenAI):
- GDPval (44 zawody, praca wiedzo-intensywna) — GPT-5.2 Thinking „pokonuje lub dorównuje czołowym profesjonalistom z branży w 70,9% porównań”; OpenAI podaje, że wyniki zostały uzyskane z prędkością >11× większą i przy <1% kosztu pracy ekspertów na ich zadaniach GDPval (szacunki prędkości i kosztów oparte na danych historycznych). Zadania obejmują modele arkuszy kalkulacyjnych, prezentacje i krótkie wideo.
- SWE-Bench Pro (kodowanie) — GPT-5.2 Thinking osiąga ≈55,6% na SWE-Bench Pro i ~80% na SWE-Bench Verified (tylko Python) według OpenAI, ustanawiając nowy stan sztuki dla oceny generowania kodu/inżynierii w ich testach. Przekłada się to na bardziej niezawodne debugowanie i kompleksowe poprawki w praktyce, zgodnie z przykładami OpenAI.
- GPQA Diamond (pytania i odpowiedzi na poziomie magisterskim) — GPT-5.2 Pro: 93,2%, GPT-5.2 Thinking: 92,4% na GPQA Diamond (bez narzędzi, maksymalne rozumowanie).
- Seria ARC-AGI — Na ARC-AGI-2 (trudniejszy benchmark płynnego rozumowania) GPT-5.2 Thinking uzyskał 52,9%, a GPT-5.2 Pro 54,2% (OpenAI twierdzi, że są to nowe rekordy stanu sztuki dla modeli w stylu łańcucha rozumowania).
- Długi kontekst (OpenAI MRCRv2) — GPT-5.2 Thinking wykazuje niemal 100% dokładności w wariancie 4-needle MRCR do 256k tokenów i znacząco lepsze wyniki względem GPT-5.1 w ustawieniach długiego kontekstu. (OpenAI opublikowało wykresy i tabele MRCRv2.)
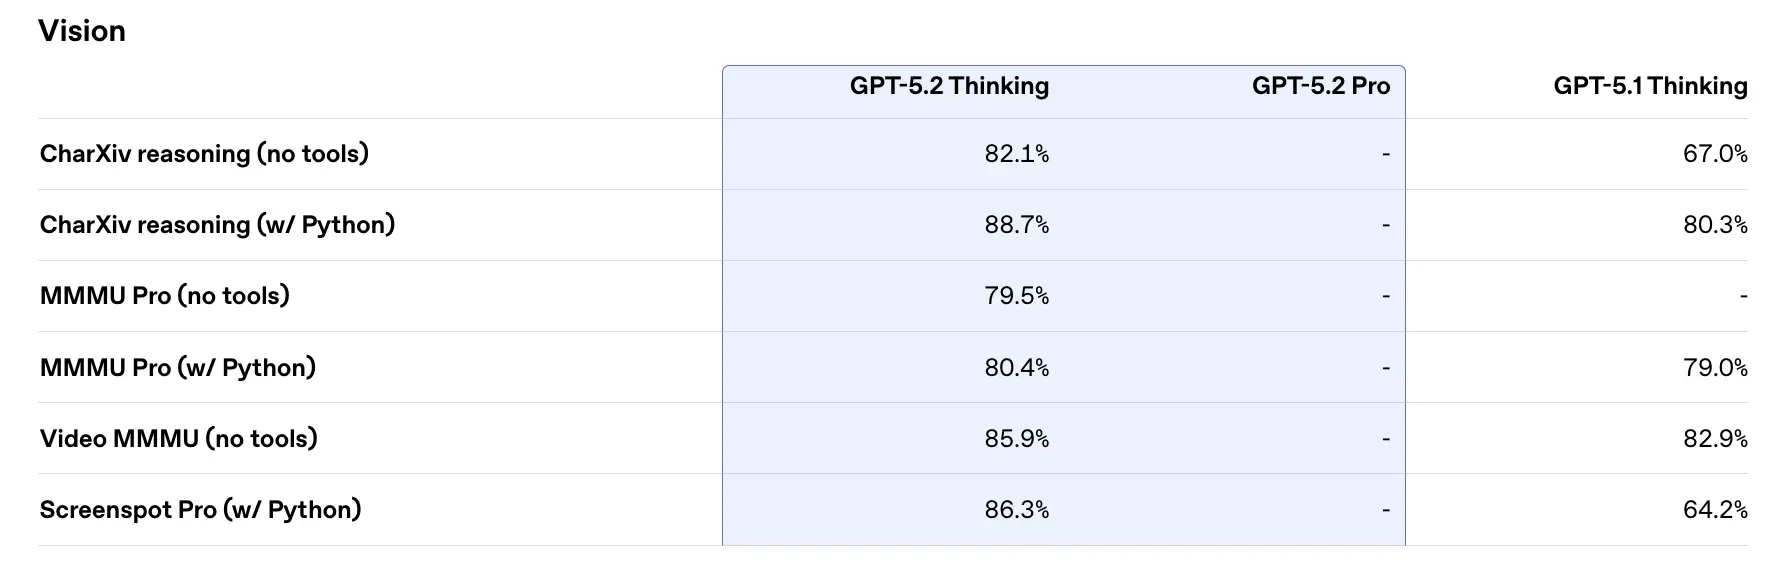
Porównanie z konkurentami
- vs Google Gemini 3 (Gemini 3 Pro / Deep Think): Gemini 3 Pro był promowany jako model z ~1,048,576 (≈1M) tokenowym oknem kontekstu oraz szerokimi multimodalnymi wejściami (tekst, obraz, audio, wideo, PDF-y) i silnymi integracjami agentowymi przez Vertex AI / AI Studio. Na papierze większe okno kontekstu w Gemini 3 stanowi wyróżnik dla ekstremalnie dużych obciążeń w pojedynczej sesji; kompromisy obejmują powierzchnię narzędziową i dopasowanie do ekosystemu.
- vs Anthropic Claude Opus 4.5: Anthropic Opus 4.5 kładzie nacisk na firmowe przepływy kodowania/agentowe i raportuje mocne wyniki w SWE-bench oraz odporność w długich sesjach agentowych; Anthropic pozycjonuje Opus pod kątem automatyzacji i generowania kodu z oknem kontekstu 200k i wyspecjalizowanymi integracjami agent/Excel. Opus 4.5 to silny konkurent w obszarze automatyzacji enterprise i zadań programistycznych.
Praktyczny wniosek: GPT-5.2 celuje w zrównoważony zestaw ulepszeń (kontekst 400k, wysokie wyjścia tokenowe, ulepszone rozumowanie/kodowanie). Gemini 3 celuje w absolutnie największe konteksty pojedynczej sesji (≈1M), podczas gdy Claude Opus koncentruje się na inżynierii korporacyjnej i odporności agentowej. Wybieraj, dopasowując rozmiar kontekstu, potrzeby modalności, dopasowanie funkcji/narzędzi oraz kompromisy koszt/opóźnienie.
Jak uzyskać dostęp i korzystać z API GPT-5.2
Krok 1: Zarejestruj się po klucz API
Zaloguj się do cometapi.com. Jeśli nie jesteś naszym użytkownikiem, najpierw się zarejestruj. Zaloguj się do CometAPI console. Uzyskaj poświadczenie dostępu — klucz API interfejsu. Kliknij „Add Token” przy tokenie API w centrum osobistym, uzyskaj klucz tokenu: sk-xxxxx i zatwierdź.
Krok 2: Wyślij żądania do API GPT-5.2
Wybierz punkt końcowy “gpt-5.2”, aby wysłać żądanie do API i ustaw ciało żądania. Metoda żądania i ciało żądania są dostępne w dokumentacji API na naszej stronie. Nasza strona udostępnia także testy w Apifox dla Twojej wygody. Zastąp <YOUR_API_KEY> swoim rzeczywistym kluczem CometAPI z konta. Programiści wywołują to poprzez Responses API / punkty końcowe Chat.
Wstaw swoje pytanie lub prośbę do pola content — na to model odpowie. Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź.
Krok 3: Pobierz i zweryfikuj wyniki
Przetwórz odpowiedź API, aby uzyskać wygenerowaną odpowiedź. Po przetworzeniu API zwraca status zadania i dane wyjściowe.
Zobacz też Gemini 3 Pro Preview API